
AI-hukommelse: hvad den er, hvordan den fungerer, og hvad den gemmer
En guide til AI-hukommelse: hvordan AI-assistenter gemmer og husker oplysninger fra tidligere samtaler, hvad de gemmer, hvor hukommelsen går galt, og hvordan du ser, redigerer eller slår den fra.
AI-hukommelse er information, som en samtalebaseret AI-assistent gemmer fra dine tidligere samtaler og bringer ind i nye, så den kan huske dine præferencer og din kontekst. Selve modellen gemmer intet af det. Assistenten opbevarer det separat og tilføjer det igen, når det er relevant, hvilket giver modellen en vedvarende kontekst, som den ellers ville mangle.
Denne guide forklarer, hvordan assistenter gemmer og genkalder den information, hvad de gemmer, hvorfor de nogle gange tager fejl, og hvordan du kan se, ændre eller slå det fra.
Hvad er AI-hukommelse?
AI-hukommelse, også kaldet vedvarende hukommelse, er en funktion i AI-assistenter, der gemmer information om dig, såsom præferencer, fakta og kontekst fra tidligere interaktioner, som assistenten kan bruge i senere samtaler.
En AI-assistent kan opbygge denne oversigt ud fra ting, du beder den om at huske, detaljer, den selv opfanger, og tidligere chats, den kan henvise tilbage til.
AI-hukommelseslaget gør det muligt for AI-assistenter at give personlige svar, uden at du skal dele dine præferencer i hver chat. Hvis du har fortalt en assistent, at du træner til et maraton og foretrækker kilometer, får dit næste spørgsmål om tempo et svar i kilometer, uden at du behøver at gentage det.
Sammenlignet med at gentage din situation i hver chat sparer hukommelse dig for at skrive og holder prompten kort, hvilket er vigtigt, fordi lange input gør svarene mindre præcise.
Hukommelse er ikke en udskrift af alle samtaler, men en samling af vigtige fakta om dig. Den vil altså huske, at du foretrækker kilometer. Om du kan finde den præcise træningsplan, den udarbejdede i sidste måned, afhænger af, om assistenten også kan slå tidligere chats op.
Typer af AI-hukommelse
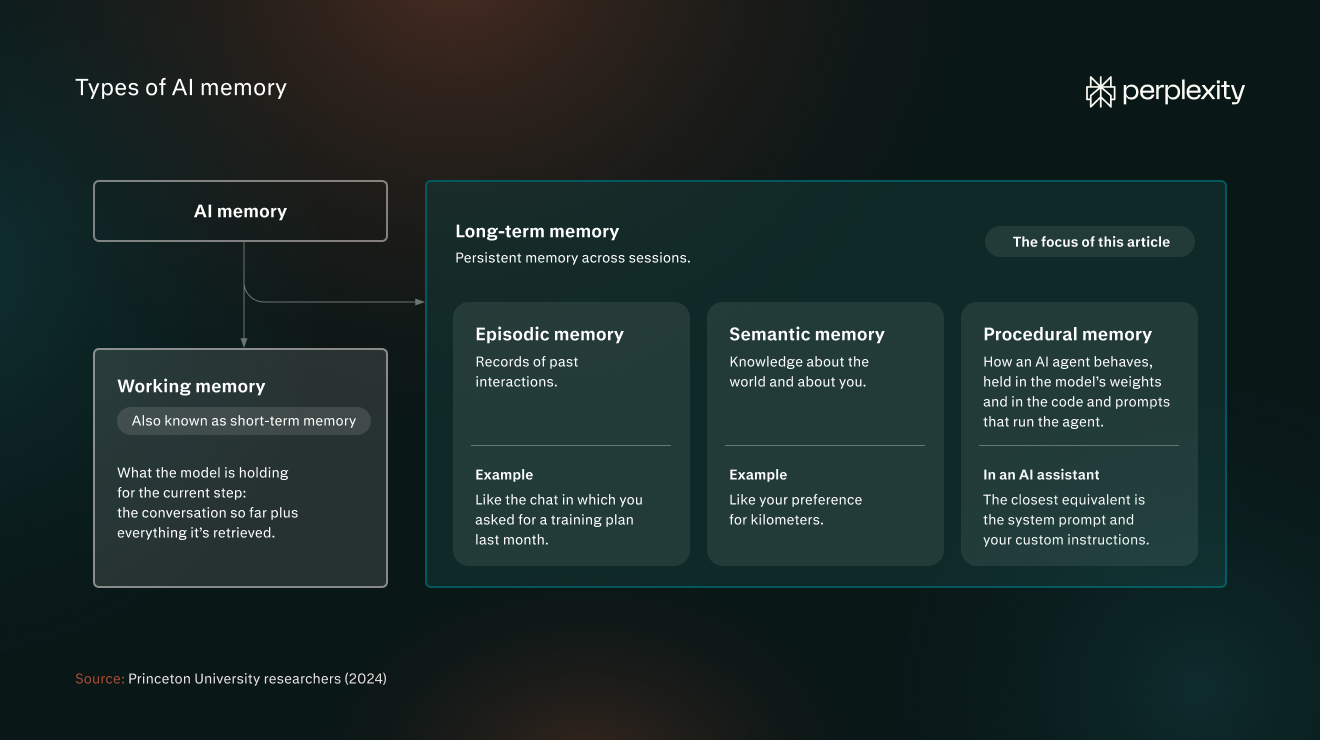
Forskere fra Princeton University (2024) har lånt terminologi fra forskningen i menneskets hukommelse til at klassificere typer af AI-hukommelsessystemer. Deres begrebsramme skelner mellem arbejdshukommelse og langtidshukommelse:
- Arbejdshukommelse: Det, modellen holder styr på i det aktuelle trin, altså samtalen indtil nu plus alt, hvad den har hentet. Kaldes også korttidshukommelse.
- Langtidshukommelse: Vedvarende hukommelse på tværs af sessioner. Det er denne type hukommelse, artiklen handler om.
Langtidshukommelse består af tre typer hukommelse:
- Episodisk hukommelse: Registreringer af tidligere interaktioner, som den chat, hvor du bad om en træningsplan i sidste måned.
- Semantisk hukommelse: Viden om verden og om dig, som at du foretrækker kilometer.
- Procedurel hukommelse: Hvordan en AI-agent opfører sig, indbygget i modellens vægte og i den kode og de prompts, der kører agenten. I en AI-assistent er det nærmeste modstykke systemprompten og dine brugerdefinerede instruktioner.
AI-assistenthukommelse vs. AI-agenthukommelse
AI-assistenthukommelse og AI-agenthukommelse er begge langtidshukommelse. AI-assistenthukommelse er for det meste semantisk hukommelse og gemmer fakta om dig, så svarene passer til dig. Agenthukommelse, som Perplexitys Brain, gemmer, hvad agenten gjorde, og hvordan det gik, herunder hvad der virkede, og hvad du rettede, så den starter hver ny opgave fra et bedre udgangspunkt.
AI-assistenthukommelse | AI-agenthukommelse | |
Hvad den husker | Dig | Opgaven og dens historik |
Hvad den bruges til | Svar, der passer til dig | At fortsætte arbejde i flere trin uden at starte forfra |
Eksempel | Husker, at du foretrækker kilometer | Husker din maratontræningsplan, de justeringer, den har foretaget, og de træningspas, du har gennemført indtil nu, så den bedre kan planlægge fremtidige træningsblokke |
AI-hukommelse vs. kontekstvinduer, træningsdata og brugerdefinerede instruktioner
AI-hukommelse er let at forveksle med tre andre ting, der former et svar: modellens kontekstvindue, træningsdata og brugerdefinerede instruktioner. Hver af dem rummer forskellig information, varer forskelligt lang tid og styres af et forskelligt system.
Et kontekstvindue er den mængde tekst, en stor sprogmodel (LLM) kan læse på én gang, og det dækker den aktuelle samtale. Det nulstilles, når du starter en ny chat.
Nogle nuværende modeller har store kontekstvinduer på en million tokens eller mere, så teknisk set kunne du indsætte dine vigtigste oplysninger i hver samtale. Men det øger ventetiden og omkostningerne at behandle det hele.
Flere undersøgelser har også vist, at nøjagtigheden af outputtet falder, når inputtet vokser, selv når svaret findes i konteksten.
En undersøgelse fra 2025 fra University of Illinois og Amazon så det, selv når modellerne kunne gengive alle relevante detaljer: Nøjagtigheden faldt med 13,9–85 %, efterhånden som inputtet voksede til 30.000 tokens, langt under modellernes angivne grænser. NoLiMa, et benchmark fra 2025 fra Adobe Research og LMU München, fandt, at 11 af de 13 testede modeller klarede sig markant dårligere ved blot 32.000 tokens, når spørgsmålet og svaret ikke havde nogen nøgleord til fælles. Chromas rapport fra juli 2025 så det på tværs af 18 modeller, også når de svarede ud fra en chathistorik på 113.000 tokens.
Træningsdata er den information, der er indbygget i modellens vægte før lanceringen. Brugerne kan ikke ændre den. Udviklere kan finjustere en model med nye data, men det er en teknisk proces, ikke en brugerindstilling,
Brugerdefinerede instruktioner er regler gemt i assistentens indstillinger, som du selv skriver og redigerer for at tilpasse AI-assistentens adfærd og output. Du kan for eksempel bruge brugerdefinerede instruktioner til at fastlægge svarenes tone og stil, eller hvilke kilder assistenten må bruge.
Sådan kan de fire sammenlignes:
Kontekstvindue | AI-hukommelse | Træningsdata | Brugerdefinerede instruktioner | |
Hvad det indeholder | Beskederne i den aktuelle chat | Gemte fakta og præferencer om dig | Det, modellen lærte før lanceringen | Retningslinjer, du selv skriver |
Hvor længe det varer | Kun denne chat | Indtil det opdateres eller slettes | Fast, indtil en ny model udgives | Indtil du redigerer det |
Hvem styrer det | Dig, inden for den grænse, som modeludbyderen fastsætter. | Dig og assistenten | AI-virksomheden | Dig |
Eksempel | Det spørgsmål om tempo, du stillede for et minut siden | At du foretrækker kilometer | Hvordan træningsplaner til maraton generelt er opbygget | Instruktion om at formatere træningsplaner i et skema, hvor rækkerne er uger og kolonnerne ugedage |
Hvad AI-hukommelse gemmer
Assistenter gemmer udvalgte detaljer om dig, såsom fakta, præferencer og opsummeringer, og nogle trækker også på dine tidligere chats.
- Fakta og præferencer, du beder den om at huske: Det er detaljer, du udtrykkeligt beder assistenten om at gemme, såsom »husk, at jeg foretrækker kilometer«. Assistenten opretter mindet, når du beder om det, og det varer, indtil du sletter det, eller en senere samtale opdaterer det.
- Detaljer, den opfanger fra dine samtaler: Assistenten gemmer dem, når indstillingen er slået til. Perplexity »prioriterer hyppigheden af spørgsmål stillet og oplysninger givet af brugeren«, så noget, du nævner ofte, har større sandsynlighed for at blive hængende end noget, du nævner én gang. Mindet varer, indtil det opdateres, eller du sletter det.
- Henvisninger til dine tidligere chats: Assistenten trækker direkte på tidligere samtaler i stedet for på en gemt liste. Perplexity kalder det søgehistorik: dine tidligere spørgsmål og svar, der bruges til at gøre et nyt svar mere relevant.
Sådan fungerer AI-hukommelse
AI-modellen husker ikke noget mellem samtaler. Det arbejde udfører AI-hukommelsessystemet: Det opbevarer en separat registrering om dig og tilføjer de relevante dele til hver ny samtale. Lagring og hentning sker i baggrunden, så modellen læser dem sammen med dit spørgsmål.
Processen foregår i fem trin:
- Gemning: Assistenten gemmer et minde, når du beder den om det, eller når den vurderer, at en detalje er værd at beholde.
- Opbevaring: Minderne lægges i en database, der holdes adskilt fra modellen. I mange systemer er det en vektordatabase, så de kan søges efter betydning. Listen, du ser i indstillingerne, er en visning af dette hukommelseslager.
- Hentning: Når du sender en besked, afgør assistenten, hvilke minder der er relevante. Mange systemer gør det ved at konvertere din besked og hvert minde til embeddings, numeriske repræsentationer af betydning, og vælge de bedste match. Sådan kan de genkalde et minde, selv når det ikke har nogen ord til fælles med dit spørgsmål. Enklere systemer indlæser alle gemte minder i hver samtale.
- Brug: Genkaldte minder indsættes som almindelig tekst i inputtet, som regel i en blok af instruktioner, som modellen læser før din besked. Modellen behandler dem som al anden tekst i inputtet.
- Opdatering og fjernelse: Assistenten udtrækker fakta fra chats, søger i eksisterende minder og beslutter, om de skal tilføjes som nye, opdatere et eksisterende minde eller flettes med et, eller om et gammelt minde, der modsiger nye oplysninger, skal slettes. Nogle assistenter tidsstempler hvert minde for at kunne skelne nyere information fra ældre.
Udfordringer og risici ved AI-hukommelse
AI-hukommelse skal forbedre kvaliteten af svarene, men benchmarks viser, at hentning fra hukommelsen ikke altid fremfinder relevant eller aktuel information, især fra store databaser. Den medfører også sikkerheds- og privatlivsrisici.
Almindelige problemer med pålidelighed og sikkerhed i forbindelse med AI-hukommelse omfatter:
- Fejlanvendte minder: Et minde kan blive trukket ind i et svar, det ikke har noget med at gøre. En undersøgelse fra 2026 testede 18 modeller for, om et gemt minde fra ét livsområde sivede ind i et svar inden for et andet. Den mediane fejlrate var 53 %. Undersøgelsen viste også, at når hukommelsen først indeholdt brugernes holdninger eller påståede ekspertise, gentog næsten alle modeller dem, selv hvis spørgsmålet krævede et neutralt svar.
- Forældede minder: Assistenten bliver ved med at handle ud fra en detalje, efter at en senere samtale har gjort den usand, især når du aldrig sagde det direkte. I et benchmark fra maj 2026, der testede, om modeller bemærker sådanne implicitte ændringer, opnåede den bedste model i gennemsnit 55,2 %.
- Overbelastning af hukommelsen: Jo mere en assistent skal læse igen, desto sværere er det at udvælge det, der betyder noget. LongMemEval, et benchmark fra 2024, fandt, at modeller, der læste en chathistorik på omkring 115.000 tokens, klarede sig 30 % til 60 % dårligere end modeller, der kun fik de relevante sessioner.
- Forgiftning af hukommelsen: Falske oplysninger eller skjulte instruktioner havner i en assistents hukommelse, for eksempel gennem indhold, du beder den om at læse, hvilket fører til skæve eller usikre svar eller datalæk.
- Privatlivsrisici: Hukommelsen gemmer personlige oplysninger ud over den chat, de stammer fra, nogle gange længere, end du forventer. Perplexity kan for eksempel opbevare en log over slettede minder i op til 30 dage af hensyn til sikkerhed og fejlfinding. Databeskyttelseslovgivningen behandler gemte minder som personoplysninger, så du bør kunne gennemse og slette dem.
Sådan ser, redigerer og slår du AI-hukommelse fra
Du kan se, hvad en assistent har gemt, slette det, slå hukommelsen fra eller bruge en privat chat, der ikke opretter minder.
Administration af hukommelse handler om en håndfuld indstillinger. Her er, hvad hver af dem gør, og hvornår du skal bruge den:
Indstilling | Hvad den gør | Hvornår du skal bruge den |
Se, hvad der er gemt | Åbner din hukommelsesbank, hvor du kan søge i, filtrere og gennemse de enkelte poster. | Når et svar indeholder en detalje, du ikke havde forventet. |
Slet et minde | Fjerner posten, og assistenten holder op med at bruge den i senere svar (assistenter kan opbevare en log over slettede minder i en periode). | Når et minde er forkert, forældet eller følsomt. |
Slå hukommelse fra | Får assistenten til at holde op med at bruge hukommelsen i fremtidige svar (det sletter muligvis ikke allerede gemte minder – tjek din assistent). | Når du vil have svar uden personalisering |
Slå søgehistorik fra | Får assistenten til at holde op med at bruge dine tidligere spørgsmål og svar. Hvis du sletter en session fra din søgehistorik, fjernes dens indflydelse på senere svar. | Når tidligere samtaler styrer svarene, er det tid til at starte forfra. |
Brug en inkognito-chat | Hukommelse og søgehistorik er altid slået fra, og spørgsmål, der stilles der, bliver aldrig gemt eller brugt i hukommelsen. | Til enkeltstående eller følsomme emner. |
Vil du starte helt på en frisk, kan du slå hukommelsen fra og rydde det, der er gemt.
Sådan håndterer Perplexity hukommelse
Perplexitys hukommelse fungerer på tværs af alle de modeller, Perplexity tilbyder.
Perplexity personaliserer svar ud fra to kilder: minder, som er de præferencer og oplysninger, du deler, og din søgehistorik. Når et minde former et svar, vises det blandt svarets kilder, så du kan se, hvilke minder der blev brugt, og slette ethvert af dem.
Du kan også personalisere dine svar ved at angive oplysninger om dig selv og ved at give tilpassede instruktioner til projekter (hvert projekt har sit eget hukommelseslag).
Perplexity kan bruge indhold fra hukommelsen til at forbedre sine modeller på forbrugerkonti (aldrig på Enterprise-konti), medmindre du slår det fra (AI-dataopbevaring under Indstillinger → Præferencer → Kunstig intelligens).
Abonnenter på Max og Enterprise Max får også Brain, et delt hukommelseslag, der bygger videre på hukommelsen ved at holde styr på dine projekter og dit arbejde. Det har sin egen kontakt og ignorerer inkognito-sessioner.
Prøv Perplexity, og se, hvordan minder former dit næste svar.
Ofte stillede spørgsmål om AI-hukommelse
Hvad er begrænset hukommelse i AI?
IBM definerer AI med begrænset hukommelse som AI, der kan huske tidligere hændelser og resultater og overvåge situationer over tid, men som ikke kan opbevare disse data i et langsigtet bibliotek af tidligere erfaringer. Det er én af fire kategorier i en taksonomi over AI-systemer, og IBM placerer chatbots og virtuelle assistenter i den.
Assistenthukommelse er ekstern hukommelse, som disse systemer tilføjer oven i. Den bevares på tværs af sessioner, så en assistent kan bruge oplysninger, du har delt i en tidligere samtale.
Hvilken AI-assistent har den bedste hukommelse?
Ingen enkelt assistent er bedst for alle. En god hukommelse er en, du selv kan styre, så vurder AI-værktøjer ved at stille fire spørgsmål: Kan du se, hvad den har gemt? Kan du slette et minde uafhængigt af den chat, det stammer fra? Er træning en separat indstilling, adskilt fra hukommelsen? Findes der en midlertidig tilstand eller inkognitotilstand, der ikke opretter minder?
Lærer en AI-model af det, den husker om dig?
At bruge hukommelse i et svar er en anden proces end træning. Ifølge Perplexity henter tjenesten relevant kontekst fra dit hukommelseslager i stedet for at behandle din historik som træningsdata. Om dit indhold må bruges til at forbedre modeller, er en separat indstilling. På forbrugerkonti kan Perplexity bruge indhold fra hukommelsen til det formål, og AI-dataopbevaring slår det fra.
Hvad bør du holde ude af AI-hukommelsen?
Hold alt ude af AI-hukommelsen, som du ikke ønsker gemt, brugt til at profilere dig eller gentaget senere: identitets- og økonomiske oplysninger, helbredsoplysninger, adgangskoder, andre personers oplysninger og alt om børn. Canadas Office of the Privacy Commissioner (maj 2025) og det britiske National Cyber Security Centre (marts 2023) anbefaler at springe enhver prompt over, der ville skabe problemer, hvis den blev offentlig.
Filtre mindsker risikoen for dit privatliv, men garanterer ikke, at dine helbreds- eller økonomiske oplysninger slet ikke bliver gemt, så gennemgå din hukommelsesbank, og brug inkognito til enkeltstående følsomme spørgsmål.