
Kontekstforfald i AI-agenter: hvorfor lange opgaver mister nøjagtighed, og hvordan du forebygger det
En guide til, hvad der hober sig op i en AI-agents kontekst, hvorfor det skader nøjagtigheden, og hvordan du sætter opgaver op, der forbliver pålidelige.
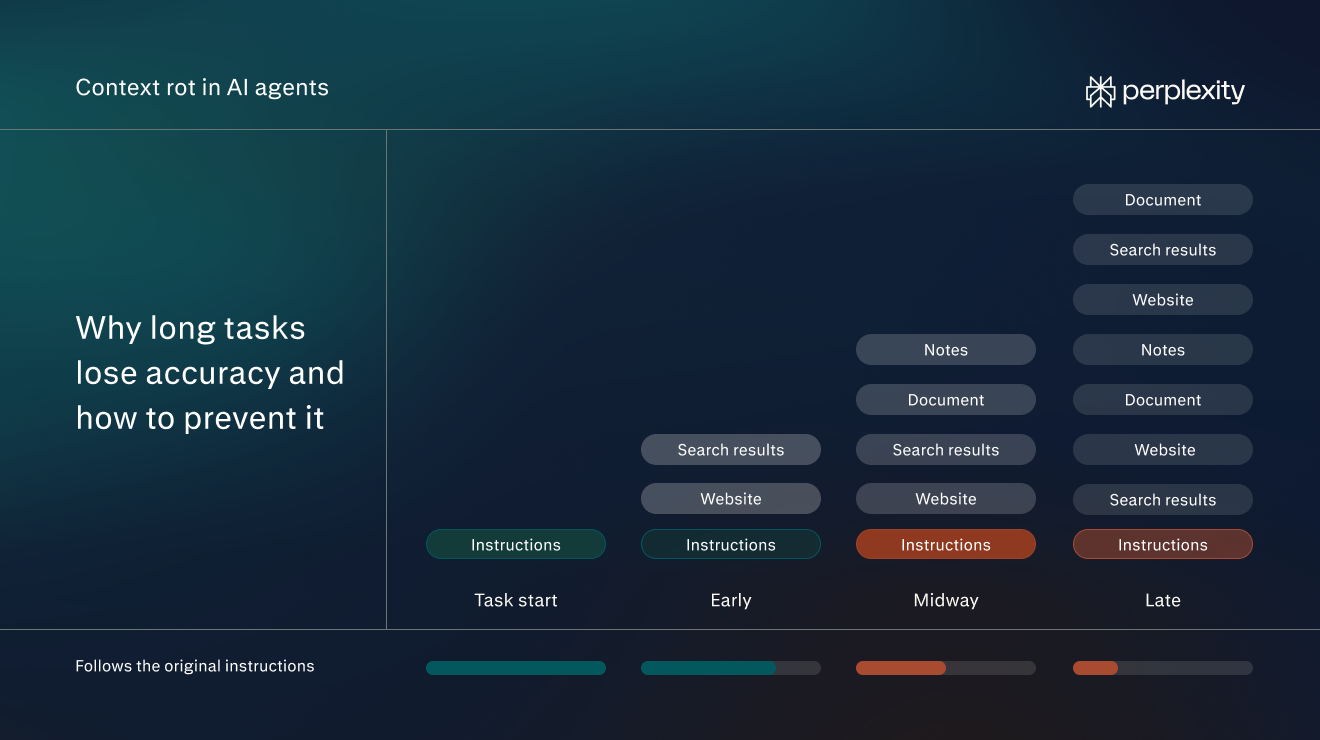
Hvad kontekstforfald betyder for AI-agenter
Kontekstforfald (context rot) i AI-agenter er det gradvise tab af nøjagtighed, der opstår, efterhånden som en agents kontekst fyldes op under en lang opgave.
En agents kontekst er de oplysninger, modellen har til rådighed til sit næste trin. Den kan omfatte instruktioner, tidligere beskeder, søgeresultater og tekst fra websites eller filer. Mens agenten arbejder, kan den tilføje mere.
Lad os for eksempel sige, at en agent har til opgave at finde leverandører, der leverer inden for to uger. I starten indeholder dens kontekst kun den anmodning. Midt i opgaven vil konteksten også indeholde teksten fra snesevis af leverandørers websites, flere sider med søgeresultater og noter om, hvilke leverandører agenten allerede har tjekket.
Der er en grænse for, hvor meget kontekst en model kan rumme (kaldet kontekstvinduet). Vinduet måles i tokens, som er små tekststykker, typisk et ord eller en del af et ord. Kontekstforfald tiltager, i takt med at konteksten vokser, og derfor opstår det oftest i lange opgaver med mange trin.
Når kontekstforfaldet forværres, bliver agenten mindre nøjagtig. Den følger måske sine oprindelige instruktioner mindre nøje, overser detaljer eller tror, at oplysninger, der blot ligner det, den har brug for, er det rigtige.
Agenten begynder for eksempel måske at medtage leverandører, der er seks uger om at levere, selvom den blev bedt om at finde levering inden for to uger. Instruktionen står stadig i dens kontekst, men den styrer ikke længere agentens valg.
Kontekstforfald er ikke det samme som blot at løbe tør for plads i kontekstvinduet. Når en opgaves kontekst vokser ud over vinduet, bliver materiale skåret fra, eller opgaven mislykkes. Kontekstforfald begynder et godt stykke før det punkt, mens alt stadig kan være der.
Det er heller ikke det samme som kontekstforgiftning (når vildledende eller skadelige oplysninger kommer ind i agentens kontekst). En agent med korrekte og fuldstændige oplysninger kan stadig opleve kontekstforfald.
Hvorfor kontekstforfald opstår
Kontekstforfald opstår, fordi en models opmærksomhed er begrænset, selv når kontekstvinduet har plads til overs. I AI-modeller er opmærksomhed (attention) den tekniske betegnelse for, hvordan en model afgør, hvilke dele af sit input den skal trække på, når den skriver hvert ord i et svar. Alle dele af konteksten konkurrerer om den opmærksomhed. Jo mere tekst der er, desto mindre opmærksomhed får hver del.
Chroma har for eksempel offentliggjort en undersøgelse af, hvordan inputlængde påvirker AI-modeller. Den testede 18 modeller fra Anthropic, OpenAI, Google og Alibaba. I én test gemte forskerne en sætning om skriveråd i en lang samling essays. Derefter spurgte de modellen, hvad rådet var.
De kørte testen mange gange og tilføjede mere essaytekst hver gang. Sætningen og spørgsmålet ændrede sig aldrig. Det gjorde kun mængden af tekst omkring dem.
Jo mere tekst modellerne skulle læse, desto dårligere klarede de sig. Det resultat holdt i alle tests i rapporten. Forskerne forudser, at faldet i nøjagtighed ville være endnu større i virkeligt arbejde, der kræver mange trin, som de fleste agentopgaver.
Hvordan kontekstforfald kan påvirke AI-agenter
Kontekstforfald viser sig typisk på en af fire måder:
Agenten mister overblikket over de oprindelige instruktioner
Chromas enkleste test bad modellerne om at kopiere en lang streng af gentagne ord nøjagtigt, med ét afvigende ord indsat et sted i den. Det var en triviel opgave med en eksplicit instruktion. Alligevel faldt ydeevnen for alle modeller, efterhånden som teksten blev længere. Nogle modeller begyndte at producere ord, der slet ikke var i inputtet.
I en agentopgave fastsætter brugeren typisk specifikke begrænsninger i starten af opgaven, såsom et budget eller et påkrævet format. Agenten anvender dem måske mindre konsekvent, efterhånden som konteksten vokser. Årsagen er kontekstens samlede længde, ikke hvor instruktionen står.
Oversete detaljer fra midten af en opgave
AI-modeller bruger oplysninger mest pålideligt, når de står helt i begyndelsen eller helt i slutningen af deres input, ifølge en Stanford-undersøgelse fra 2023. I én test gav forskerne modellerne et sæt på 20 dokumenter og stillede et spørgsmål, som kun ét af dem besvarede. Når det dokument kom først eller sidst, fandt modellerne som regel svaret. Når det lå i midten af sættet, overså de det langt oftere. Forskere kalder dette en positionseffekt.
Det samme mønster gælder for agenter. Oplysninger, der blev fundet tidligere i en opgave, kan ligge midt i en lang samtale, hvor nogle modeller har sværere ved at bruge dem. I leverandøreksemplet kan den endelige liste udelade en god leverandør, som agenten tjekkede undervejs i opgaven.
Sammenblanding af lignende oplysninger
Efterhånden som konteksten vokser, kan agenter blive dårligere til at genkende, hvilke oplysninger der passer til deres instruktioner. Lad os for eksempel sige, at brugeren bad agenten om at finde leverandører, der sender “inden for to uger”. På en leverandørs website står der “ankommer inden for 14 kalenderdage efter bestilling”. I en kort opgave ville en agent sandsynligvis opdage, at det betyder det samme. Begravet blandt snesevis af andre leverandørsider er der større risiko for, at den overser sammenhængen.
Agenten kan også begynde at medtage resultater, der ikke er relevante. Lad os sige, at agenten leder efter leverandører af kontorstole. En leverandørs website lover levering inden for to uger, men kun for skriveborde. Dens stole tager seks uger. Websitet bruger de samme ord som instruktionen, så agenten tilføjer måske alligevel leverandøren til sin liste. Forskere kalder den slags oplysninger en distraktor. Den ser relevant ud, men er det ikke, og konkurrerer derfor med de oplysninger, der betyder noget.
Chromas undersøgelse viste, at begge problemer blev værre, efterhånden som mængden af omgivende tekst voksede.
Fejl, der er svære at opdage
Kontekstforfald udløser ikke en fejlmeddelelse. Agenten fortsætter med at arbejde og afleverer et resultat, der ser færdigt ud. Det gør dens fejl lette at overse.
I Chromas tests optrådte disse fejl i to former. Nogle gange gav en model et selvsikkert svar, der var forkert. I eksemplet med leverandørresearch kunne agenten levere en pæn, velformateret leverandørliste, der indeholder en leverandør, hvis leveringsbetingelser den har læst forkert.
Andre gange sagde en model, at den ikke kunne finde oplysninger, der faktisk var der. Agenten kunne for eksempel levere en rapport om, at ingen leverandører overholder grænsen på to uger, selvom flere gør det.
Sådan sætter du agentopgaver op for at mindske kontekstforfald
Når opgaver sættes korrekt op, minimeres virkningen af kontekstforfald, og agenten holdes så nøjagtig som muligt gennem hele opgaven. Følgende bedste praksis kan hjælpe.
Formulér opgaven som en konkret bestilling
En klar bestilling holder konteksten mindre. Agenten ved, hvornår den er færdig, så den holder op med at indsamle materiale, når den har nok. Specifikke krav giver den også noget konkret at holde hver side op imod. Det gør det lettere for agenten at finde de rigtige oplysninger.
Før du sender en opgave, skal du tjekke, at den dækker tre ting:
- Opgaven: hvad agenten skal gøre og levere, f.eks. “find leverandører, og returner en kortliste”.
- Kravene: de fakta, agenten ikke kan gætte, f.eks. budgettet, deadlinen, leveringsadressen, og hvem resultatet er til.
- Resultatet: format, længde og struktur, f.eks. “en tabel med navn, pris pr. stol og leveringstid”.
Samlet set kunne forespørgslen til leverandøropgaven se sådan ud:
“Find 10 leverandører, der kan levere 40 kontorstole til vores kontor i Chicago inden for to uger til under 250 $ pr. stol. Returner en tabel med leverandørnavn, pris pr. stol, leveringstid og et link til produktsiden. Listen er til vores kontorchef, som skal afgive bestillingen.”
Hold hver opgave fokuseret
Én opgave med ét klart mål holder konteksten lille. Lange opgaver koster også mere. Hvert trin behandler alt, hvad der er indsamlet indtil nu, så en oppustet kontekst bruger flere kreditter ved hvert trin.
Del et projekt med flere dele op:
- Opstil de separate leverancer, for eksempel en leverandørsøgning, en prissammenligning og en e-mail til den valgte leverandør.
- Kør hver leverance som sin egen opgave.
- Send kun det færdige resultat videre fra én opgave til den næste. Upload for eksempel leverandørtabellen som en fil for at starte sammenligningsopgaven i stedet for at fortsætte i den tråd, der producerede den.
Sammenligningsopgaven starter så med én tabel i stedet for hver eneste side.
Henvis agenten til de rigtige kilder
Hver side, agenten læser, føjes til dens kontekst, herunder menuer, annoncer og standardtekst omkring den nyttige del. Når du giver agenten dens kilder direkte, skæres der ned på den støj.
Upload de filer, opgaven afhænger af, f.eks. listen over godkendte leverandører, ved at vedhæfte dem til forespørgslen. Angiv de websites, der er værd at søge på, når agenten skal søge på nettet, f.eks. to pålidelige leverandørkataloger.
Forbind værktøjerne, hvor oplysningerne findes. I Perplexity Computer kan du for eksempel åbne Connectors i sidepanelet og aktivere de apps, opgaven har brug for, såsom Google Drive eller Slack. Nævn dem derefter i forespørgslen: “Brug stolespecifikationerne i vores Google Drive.” Forbind kun relevante apps, da hver connector optager en del af agentens kontekst.
Hvis oplysningerne findes i en app, der ikke er på listen over Connectors, kan det stadig være muligt at forbinde den. Mange apps tilbyder en MCP-connector (Model Context Protocol), en standardmåde, hvorpå AI-værktøjer kan kobles til anden software. Computer kan bruge dem sammen med sine indbyggede connectors. På en virksomhedskonto skal en administrator muligvis aktivere dem først.
Bed om en afsluttende kontrol op imod instruktionerne
Afslut forespørgslen med et gennemgangstrin, der nævner de vigtigste begrænsninger:
“Før du afslutter, skal du tjekke hver leverandør op imod disse krav: levering inden for to uger, under 250 $ pr. stol. Markér dem, der ikke opfylder kravene, i stedet for at udelade dem.”
Begrænsningerne står stadig i starten af konteksten. Gennemgangstrinnet giver agenten en grund til at sammenligne sit endelige resultat med begrænsningerne i stedet for at regne med, at instruktionerne bevarer deres indflydelse gennem hvert trin.
Samtidig gør det fejl lettere at fange, når du beder den om at markere problemer i stedet for blot at droppe de pågældende resultater (f.eks. hvis den afviser en leverandør, der lover levering inden for 14 kalenderdage, fordi den ikke bruger ordene “to uger”).
Gennemgå arbejdet ved kontrolpunkter
Ved længere opgaver kan du indbygge et kontrolpunkt i forespørgslen:
“Start med at finde 20 mulige leverandører, og stop så. Jeg bekræfter listen, før du indsamler priser.”
Tjek kortlisten op imod de oprindelige instruktioner. Ret det, der er forkert, i en opfølgning, og lad derefter agenten fortsætte. Fejl, der fanges på dette tidspunkt, føres ikke videre til alle de efterfølgende trin.
Start en ny opgave, når en opgave kommer på afveje
Hvis agenten gentager den samme fejl efter rettelser, så start en ny opgave. Hver rettelse tilføjer mere tekst til en i forvejen lang kontekst. Opret i stedet en ny opgave. Gentag instruktionerne, upload eventuelle gode resultater fra første forsøg, og begynd forfra.
Nogle agenter gør en version af dette automatisk, en proces kaldet komprimering (compaction). Når en opgave bliver lang, erstatter agenten ældre materiale, f.eks. den fulde tekst fra sider, den læste tidligt, med et kort resumé af det, den fandt. Perplexitys Portable Computer komprimerer sin kontekst på denne måde, så modellen holder sig inden for den mængde, den kan håndtere godt.
Det er også vigtigt at starte en ny opgave, hvis målet ændrer sig. En tråd, der begyndte som en leverandørsøgning, bør ikke også blive til en kontraktgennemgang.
Gør gentagne instruktioner til en Skill
Nogle instruktioner går igen i alle opgaver af en bestemt type, f.eks. et foretrukket tabelformat, en liste over leverandører, der skal undgås, eller et standardgennemgangstrin. I Computer kan de gemmes som en Skill, et genanvendeligt sæt instruktioner, som agenten følger hver gang. En Skill indbygger de øvrige bedste praksisser i alle opgaver, der bruger den.
Sådan opretter du en:
- Vælg en opgave, der ofte går igen, f.eks. leverandørresearch.
- Skriv de instruktioner ned, du giver hver gang: formatet, kontrollerne og de kilder, der skal bruges eller undgås.
- Gem dem som en Skill. Instruktioner, der allerede er skrevet i Markdown, kan importeres direkte.
- Nævn Skill’en i fremtidige forespørgsler: “Brug leverandørresearch-Skill’en til at finde stoleleverandører til kontoret i Denver.”
Sådan griber Perplexity kontekst an i agentarbejde
Perplexity Computer håndterer lange opgaver på måder, der holder hver models kontekst lille og relevant. Tre dele af designet begrænser, hvor meget en model skal læse på én gang.
Opdeling af arbejdet mellem underagenter
Computer deler en anmodning op i opgaver og delopgaver og opretter derefter underagenter til at udføre dem. Hver underagent arbejder på én del af jobbet i sin egen kontekst. I leverandøropgaven kan én underagent undersøge priser, mens en anden tjekker leveringsbetingelser. Ingen af dem behøver at læse alt det, den anden har læst.
Arbejdet gemmes i filer
Hver Computer-opgave får sit eget arbejdsområde med egne filer, webbrowser og værktøjer. Agenten kan gemme sit arbejde i en fil, f.eks. en løbende opdateret tabel over de leverandører, den har tjekket. Den åbner derefter kun filen igen, når den har brug for den.
Udvælgelse af relevante passager fra søgeresultater
Websider er fulde af materiale, som modellen ikke har brug for, f.eks. menuer, annoncer, metadata og tekst om andre emner. Forespørgselsbevidst kontekstkomprimering fjerner det. Før en side når frem til modellen, beholder Perplexity kun de sætninger, der vedrører forespørgslen.
Udforsk tips, vejledninger og eksempelopgaver til Perplexity Computer for at omsætte disse trin til praksis.
Ofte stillede spørgsmål
Er kontekstforfald det samme som hallucination?
Nej, men de hænger sammen. En hallucination er ethvert svar, der angiver noget forkert eller udokumenteret. Kontekstforfald er et af de forhold, der gør hallucinationer mere sandsynlige, sammen med andre fejl som ignorerede instruktioner og oversete detaljer.
Kan en bedre forespørgsel løse kontekstforfald?
En klar forespørgsel mindsker kontekstforfald ved at holde opgaven fokuseret. Den kan dog ikke forhindre konteksten i at vokse. Ved en lang nok opgave indsamler agenten stadig mere, end den kan bruge godt, og derfor er det lige så vigtigt at dele arbejdet op og tjekke det undervejs som selve forespørgslen.
Påvirker kontekstforfald også almindelige AI-chats, ikke kun agenter?
Ja. I en chat er konteksten hele samtalen indtil nu, inklusive alle beskeder og eventuelle dokumenter, der er indsat eller uploadet i den. En tråd, der har kørt i timevis på tværs af flere emner, kan give de samme fejl som en lang agentopgave. Hvis du starter en ny tråd til et nyt emne, holdes hver samtale fokuseret.
Hvor lang kan en opgave blive, før kontekstforfald sætter ind?
Der er ikke noget fast punkt. Det afhænger af modellen og opgaven. Modeller på enheden med kontekstvinduer på 260.000 tokens begynder for eksempel at få problemer ud over ca. 100.000 tokens, et godt stykke under deres grænse. Faldet sker desuden gradvist frem for pludseligt.