
Sådan overvåger og styrer du dit teams tokenforbrug
Sådan kan teams se deres tokenforbrug i dashboards og rapporter, hvilke typer AI-arbejde der bruger flest tokens, og hvordan de kan bruge kontroller til at reducere det.
Hvad er tokenforbrug
Tokenforbrug er det antal tokens, et team bruger med AI, og hvad disse tokens koster. Et token er en tekstenhed, f.eks. et ord, en del af et ord eller et tegnsætningstegn, som en AI-model læser eller skriver. På engelsk svarer 1 token cirka til 4 tegn. Tokens er ikke standardiserede på tværs af modeller eller udbydere, så den samme tekst kan give forskellige antal tokens i forskellige værktøjer.
Forbrugsrapporter opdeler normalt tokens i nogle få typer:
- Inputtokens er alt, hvad modellen læser for en forespørgsel. Det omfatter selve forespørgslen, eventuel vedhæftet tekst og samtalehistorik, som modellen genbruger fra tidligere i samme tråd.
- Outputtokens er det svar, modellen skriver. De koster ofte mere end inputtokens. Ifølge Perplexitys API-priser koster output for nogle modeller seks gange så meget.
- Ræsonneringstokens er tekst, som en model genererer internt for at arbejde sig igennem et problem, før den svarer. De vises ikke i svaret, så et længere synligt svar betyder ikke nødvendigvis, at en model har brugt flere tokens i alt.
Teams, der bruger AI-værktøjer via et abonnement, ser sjældent en afgift pr. token. Tokens har stadig betydning for, hvad de får, da tungere opgaver bruger kreditter hurtigere eller når forbrugsgrænser tidligere. Teams, der bygger deres egne værktøjer oven på en AI-model, betaler i stedet typisk pr. token via forbrugsbaseret prissætning.
Sådan holder du øje med tokenforbrug
Overvågning af tokenforbrug med et abonnement
Abonnementsværktøjer viser normalt ikke antallet af tokens. Mange abonnementer bruger i stedet kreditter, forudbetalte enheder, som trækkes fra abonnementet, efterhånden som arbejdet udføres. Kreditter er ikke det samme som tokens, da én kredit kan dække tekst, billeder eller andet arbejde. Men opgaver, der bruger flere tokens, bruger som regel også flere kreditter, så de er den bedste indikator for tokenforbrug på et abonnement. Brugere kan følge deres eget kreditforbrug, og nogle abonnementer indeholder også et administratordashboard, der viser kreditforbruget for hele teamet.
I Perplexity bruger almindelige søgninger for eksempel ikke kreditter. Det er kun Perplexity Computer – assistenten, der håndterer opgaver i flere trin – som bruger dem. Folk, der bruger Computer, kan se, hvor mange kreditter de har brugt, og hvad de har brugt dem på. Hver Computer-opgave viser også sit eget samlede kreditforbrug i menuen "Forbrug" i den pågældende samtale.
På Enterprise-abonnementer kan administratorer i Insights-dashboardet se, hvor mange personer der bruger Perplexity, og hvor mange forespørgsler de foretager hver uge (tilgængeligt for organisationer med 50 eller flere licenser eller mindst ét Enterprise Max-medlem).
Overvågning af tokenforbrug i API-forbrugsrapporter
API-udbyderens forbrugsrapporter viser antallet af tokens direkte, som regel opdelt efter tokentype. I Perplexitys API Platform-konsol kan brugere for eksempel følge målinger som input-, output- og ræsonneringstokenforbrug på siden Fakturering.
Hvorfor tokenforbruget vokser
Agenter kører mange trin pr. opgave, og hvert trin er en separat forespørgsel til en model. Én opgave kan løbe op i hundredtusindvis eller endda millioner af tokens.
Ræsonneringsmodeller bliver også mere udbredte. En ræsonneringsmodel skriver sine overvejelser ud, før den svarer, og hvert eneste ord tæller som tokens. Den samme forespørgsel bruger derfor som regel flere tokens på en ræsonneringsmodel end på en standardmodel, selvom svaret på skærmen ser lige langt ud.
Endelig vokser tokenforbruget, efterhånden som flere personer og arbejdsprocesser bruger AI generelt. En del af væksten skyldes også tokenmaxxing, hvor udviklere primært kører agenter for at øge deres personlige antal tokens og placere sig højere på interne tokenranglister.
Sådan reducerer du tokenforbruget
Det meste høje tokenforbrug kommer fra nogle få typer arbejde, der bruger flere tokens, end det ser ud til.
Lange samtaler og agentopgaver
Hver gang en model svarer, genlæser den som regel hele samtalen indtil da. Hver ny forespørgsel indeholder hele den tidligere samtalehistorik plus brugerens aktuelle besked. Et kort spørgsmål sent i en lang tråd bruger derfor flere tokens end det samme spørgsmål i en ny tråd. Agentopgaver fungerer på samme måde, fordi hvert trin føjer sine resultater til den historik, som det næste trin genlæser.
Hvad du kan gøre ved det
- Start en ny samtale, når emnet skifter. Indled den med et resumé på to eller tre linjer af det fra den gamle tråd, som modellen stadig har brug for.
- Del lange agentopgaver op i mindre. Kør hver del som en selvstændig opgave, og send kun de resultater videre, som den næste del har brug for.
- Tjek, om teamets agentværktøjer bruger kontekstkomprimering. Komprimering opsummerer automatisk ældre dele af en opgave, så modellen skal genlæse mindre. Hvis et værktøj tilbyder det som en indstilling, så slå det til.
De samme dokumenter behandlet igen og igen
Når nogen vedhæfter den samme lange fil, f.eks. en håndbog med retningslinjer eller et produktkatalog, til mange separate forespørgsler, læser modellen hele filen hver gang. Hver læsning tæller som inputtokens.
Hvad du kan gøre ved det
- Lær brugerne at kopiere det relevante afsnit af en håndbog eller et katalog ind i forespørgslen i stedet for at vedhæfte hele filen.
- Lav en kort version af dokumenter, som teamet ofte bruger. Et resumé på én side af et langt politikdokument kan erstatte hele dokumentet i rutinemæssige forespørgsler.
Nye forsøg og løkker
Når et svar ikke var det, man havde brug for, og man kører opgaven igen, bruger hvert forsøg tokens. Det samme sker, når en agent sidder fast og gentager det samme trin.
Hvad du kan gøre ved det
- Beskriv opgaven, resultatet og kilderne præcist i den første forespørgsel. For eksempel: "Opsummer de vigtigste årsager til, at kunder opsagde i 3. kvartal, kun ud fra de vedhæftede undersøgelsesresultater, i fem punkter."
- Tjek de første par trin i en agentopgave. Hvis agenten gentager det samme trin eller den samme søgning, så stop den, og start forfra med en mere afgrænset forespørgsel.
Store modeller til simple opgaver
Mere avancerede modeller koster som regel mere pr. token, så rutinearbejde som resuméer eller omformatering kan bruge et teams budget hurtigere end nødvendigt.
Hvad du kan gøre ved det
- Brug modelrouting, som matcher hver opgave med en model, der kan håndtere den. En kort omskrivning eller et resumé kan sendes til en mindre og billigere model, mens den mest avancerede model forbeholdes ræsonnering eller analyse i flere trin. Perplexitys API bruger denne tilgang med sine forudindstillinger, som tildeler en mindre model til et hurtigt opslag og en større model til en udtømmende analyse.
Stigninger efter nye arbejdsprocesser
En ny automatiseret arbejdsproces eller et værktøj, der rulles ud til et helt team, kan øge forbruget fra den ene dag til den anden. En stigning er ikke et problem i sig selv, men det er værd at vide, hvilket arbejde der forårsagede den.
Hvad du kan gøre ved det
- Test nye arbejdsprocesser med en lille gruppe først. Hold øje med gruppens forbrug i en uge eller to, før arbejdsprocessen rulles ud til hele teamet.
- Fastsæt et månedligt budget for hvert team. Baser det på forbruget i en typisk måned, så et spring skiller sig ud.
- Slå automatisk genopfyldning fra. Når automatisk genopfyldning er slået fra, stopper arbejdet, når kreditterne slipper op, i stedet for at der automatisk købes flere kreditter.
Sådan optimerer du tokenforbruget i Perplexity
Til daglig brug
Computer bruger kreditter, men kører kun, når du vælger det, enten ved at vælge Computer-ikonet, arbejde i et projekt, der som standard bruger Computer, eller bruge Comets Work-tilstand.
Hvis du vil tilbage til almindelig søgning, skal du vælge Perplexity-ikonet for at skifte tilbage til Ask-tilstand. Brugere kan se kreditforbruget ved at åbne oversigten i Perplexity-grænsefladen.
Teams, der arbejder i projekter, Perplexitys delte arbejdsområder, kan indstille hvert projekts standardtilstand til Search eller Computer. Et projekt, der primært bruges til hurtig informationssøgning, kan som standard bruge Search, så ingen kommer til at starte en Computer-opgave ved et uheld.
Til Enterprise-administratorer
- Vid, hvad hver licens omfatter. Enterprise Pro-brugere får en månedlig tildeling på 500 kreditter, og Enterprise Max-brugere får 15.000 kreditter. De udløber ved slutningen af hver månedlig periode og overføres ikke.
- Angiv først en standardforbrugsgrænse. En forbrugsgrænse begrænser, hvor mange ekstra kreditter et medlem kan trække fra den fælles pulje, når medlemmets egen tildeling er brugt op.
- Opret navngivne grænser for forskellige typer brugere. Administratorer kan oprette grænser som "Standard", "Superbruger" og "Konsulent" og tildele dem til brugergrupper eller enkelte medlemmer. Grupper kan komme fra Perplexity eller synkroniseres fra virksomhedens identitetsudbyder. Hvis en person tilhører mere end én gruppe, gælder den højeste grænse.
- Brug personlige tilsidesættelser til undtagelser. Når én person har brug for en anden grænse end sin gruppe, har en personlig tilsidesættelse forrang for enhver gruppe- eller fællesgrænse. Det er nyttigt til et kort projekt med omfattende undersøgelser, uden at grænsen hæves for et helt team.
- Sæt et loft over automatisk genopfyldning. Automatisk genopfyldning fylder automatisk den fælles pulje op. Den har en konfigurerbar månedlig genopfyldningsgrænse, så forbruget ikke kan vokse uden et fastsat maksimum.
- Beslut, hvordan medlemmer beder om mere. Indstillingen Tillad medlemmer at anmode om flere kreditter giver personer, der når deres grænse, mulighed for at anmode en administrator om flere i stedet for at blive stoppet helt.
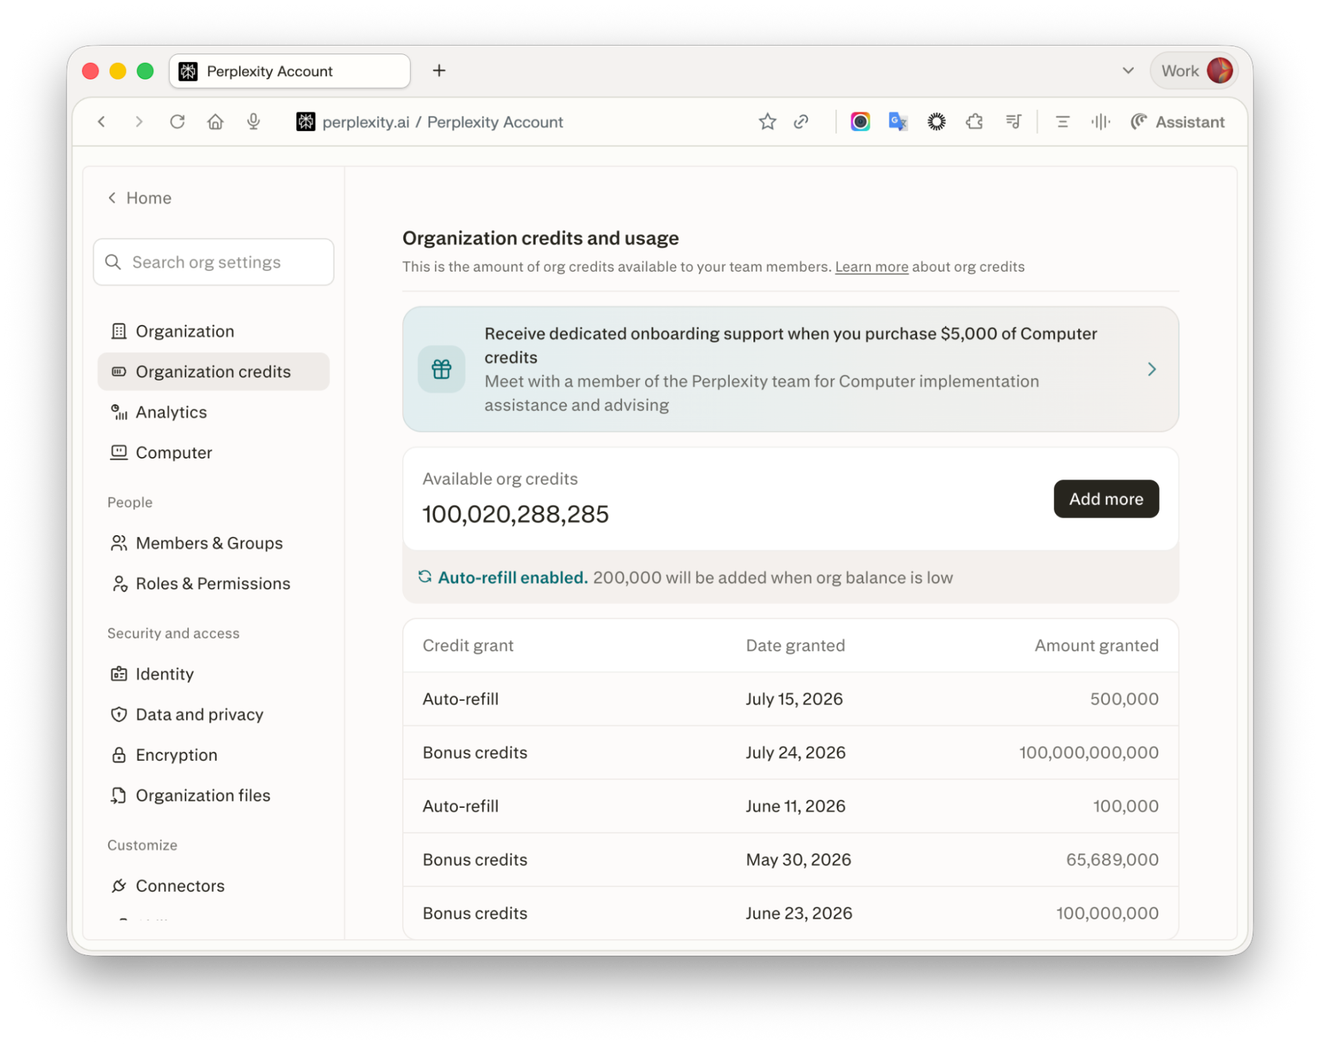
- Gennemgå forbruget hver måned. Siden Organisationskreditter viser tildelte, brugte og resterende kreditter for hvert medlem samt gruppegrænser og puljens saldo. For organisationer med 50 eller flere licenser eller mindst ét Enterprise Max-medlem viser Insights-dashboardet desuden månedlige aktive brugere og ugentlige forespørgsler over tid. For flere detaljer registrerer revisionslogfiler opgavekørsel, brug af connectors, kreditforbrug og tildeling af kreditter.
Til teams, der bygger på API'et
- Giv hvert værktøj eller team sin egen API-nøgle. Perplexity kan vise fakturering for hver nøgle separat, og separate nøgler gør det tydeligt, hvilket værktøj der driver forbruget.
- Tjek på faktureringssiden, hvilken type token der vokser. Den viser input-, output- og ræsonneringstokens over tid. Stigende inputtokens betyder som regel, at et værktøj sender mere tekst end nødvendigt. Stigende ræsonneringstokens betyder, at opgaver kører på modeller, der tænker problemer grundigt igennem.
- Brug Search API, når et værktøj kun har brug for søgeresultater. Det returnerer webresultater, uden at en model skriver et svar, og det afregnes pr. forespørgsel uden yderligere tokenbaserede gebyrer.
- Start agentværktøjer ud fra en forudindstilling. Perplexitys forudindstillinger tilpasser modellens størrelse til opgavens størrelse og holder simple forespørgsler væk fra de dyreste modeller
Lokalt arbejde først
Noget arbejde kræver slet ikke en betalt cloudmodel. Portable Computer er en version af Perplexitys agent, der kører på personens egen computer og bruger en AI-model, der er gemt på den maskine. Fordi modellen kører lokalt, bruger rutinearbejde ikke betalte tokens. Den går kun ud på nettet, til forbundne apps eller til en stærkere cloudmodel, når en opgave kræver det, og spørger brugeren først.
Se, hvordan Perplexity Computer håndterer arbejde i flere trin på tværs af nettet, filer og forbundne værktøjer.
Ofte stillede spørgsmål
Hvad er forskellen på tokenforbrug og AI-omkostninger?
Tokenforbrug måler, hvor meget AI-arbejde et team udfører, opgjort i tokens. AI-omkostninger dækker alt, hvad et team betaler for at bruge AI, herunder abonnementer, ekstra kreditter og opsætning. Tokenforbruget bestemmer den forbrugsbaserede del af regningen.
Betaler abonnementsbrugere pr. token?
Som regel ikke direkte. Abonnementsværktøjer måler forbrug i beskeder, forespørgsler eller kreditter, og opgaver, der bruger flere tokens, opbruger dem hurtigere. I Perplexity bruger almindelige søgninger slet ikke kreditter; det gør kun Computer-opgaver.
Hvorfor bruger AI-agenter så mange tokens?
En agent udfører en opgave i mange trin, og hvert trin er en separat forespørgsel, der genlæser arbejdet indtil da. En lang opgave bruger derfor flere tokens for hvert trin, den tager.
Hvorfor stiger tokenforbruget pludselig?
De fleste stigninger følger en ændring i den måde, et team arbejder på, f.eks. en ny automatiseret arbejdsproces, et værktøj, der rulles ud til flere personer, eller en lang agentopgave. Hvis man sammenholder datoen for stigningen med nylige lanceringer, viser det som regel årsagen. At teste nye arbejdsprocesser med en lille gruppe først hjælper med at forebygge stigninger.