
Context Rot bei KI-Agenten: Warum lange Aufgaben an Genauigkeit verlieren und wie sich das verhindern lässt
Ein Leitfaden dazu, was sich im Kontext eines KI-Agenten ansammelt, warum das die Genauigkeit beeinträchtigt und wie sich Aufgaben zuverlässig aufsetzen lassen.
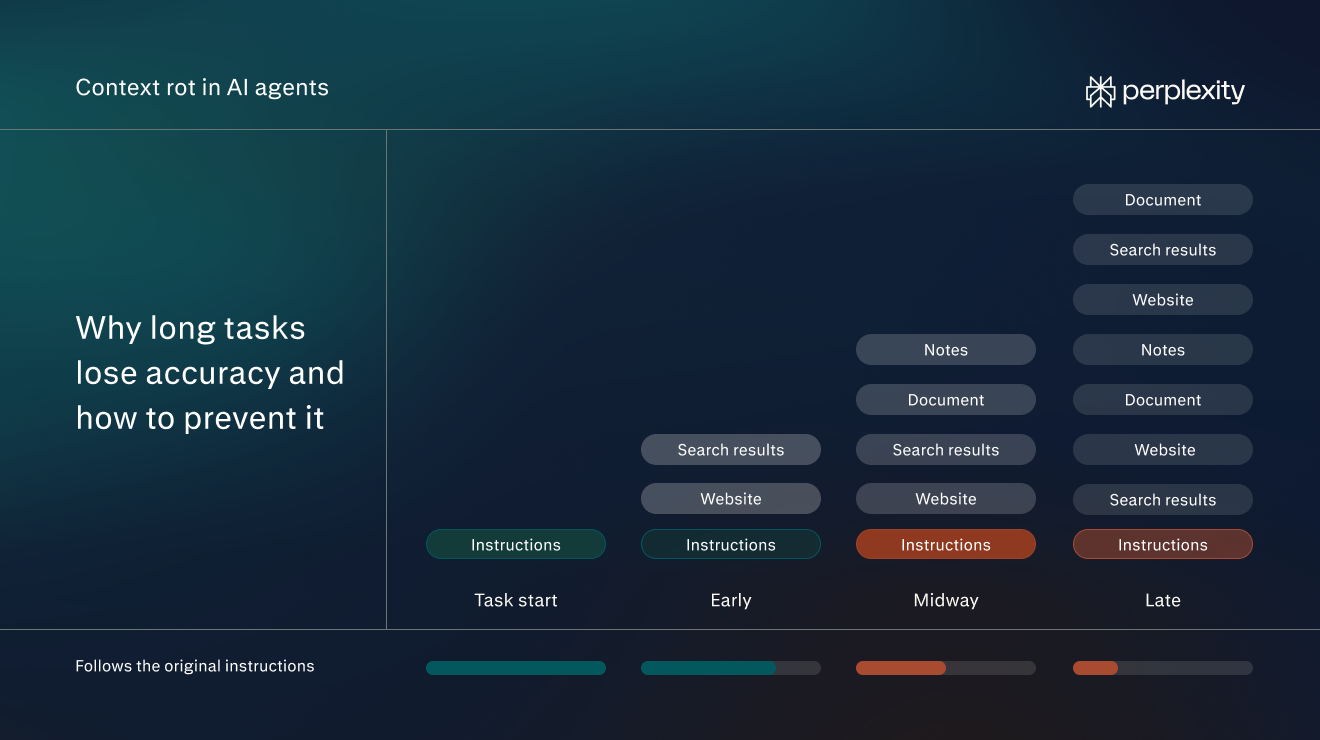
Was Context Rot für KI-Agenten bedeutet
Context Rot (etwa: Kontextverfall) bei KI-Agenten bezeichnet den allmählichen Verlust an Genauigkeit, der einsetzt, wenn sich der Kontext eines Agenten während einer langen Aufgabe füllt.
Der Kontext eines Agenten umfasst die Informationen, die dem Modell für seinen nächsten Schritt zur Verfügung stehen. Dazu können Anweisungen, frühere Nachrichten, Suchergebnisse sowie Texte von Websites oder aus Dateien gehören. Während der Agent arbeitet, kann er weitere Inhalte hinzufügen.
Angenommen, ein Agent soll Lieferanten finden, die innerhalb von zwei Wochen liefern. Zu Beginn enthält sein Kontext nur diese Anfrage. Mitten in der Aufgabe umfasst der Kontext zusätzlich die Texte Dutzender Lieferanten-Websites, mehrere Seiten mit Suchergebnissen und Notizen dazu, welche Lieferanten der Agent bereits geprüft hat.
Wie viel Kontext ein Modell aufnehmen kann, ist begrenzt (diese Grenze nennt man Kontextfenster). Das Fenster wird in Token gemessen – kleinen Texteinheiten, meist ein Wort oder ein Wortteil. Context Rot nimmt mit wachsendem Kontext zu und tritt deshalb am ehesten bei langen Aufgaben mit vielen Schritten auf.
Je stärker der Context Rot wird, desto ungenauer arbeitet der Agent. Er hält sich womöglich weniger genau an seine ursprünglichen Anweisungen, übersieht Details oder hält ähnlich aussehende Informationen für die, die er braucht.
So könnte der Agent zum Beispiel anfangen, Lieferanten mit sechs Wochen Lieferzeit aufzunehmen, obwohl er Lieferanten mit Lieferung innerhalb von zwei Wochen finden sollte. Die Anweisung steht weiterhin in seinem Kontext, beeinflusst seine Entscheidungen aber nicht mehr.
Context Rot ist nicht dasselbe, wie wenn im Kontextfenster schlicht kein Platz mehr ist. Wächst der Kontext einer Aufgabe über das Fenster hinaus, werden Inhalte abgeschnitten oder die Aufgabe schlägt fehl. Context Rot setzt lange vor diesem Punkt ein, während noch alles hineinpasst.
Ebenso wenig ist es dasselbe wie Context Poisoning (wenn irreführende oder schädliche Informationen in den Kontext des Agenten gelangen). Auch ein Agent mit korrekten, vollständigen Informationen kann von Context Rot betroffen sein.
Warum Context Rot entsteht
Context Rot entsteht, weil die Aufmerksamkeit eines Modells begrenzt ist – selbst wenn in seinem Kontextfenster noch reichlich Platz ist. Bei KI-Modellen bezeichnet der Fachbegriff Aufmerksamkeit (Attention), wie ein Modell entscheidet, auf welche Teile seiner Eingabe es beim Schreiben jedes einzelnen Wortes einer Antwort zurückgreift. Alle Teile des Kontexts konkurrieren um diese Aufmerksamkeit. Je mehr Text vorhanden ist, desto weniger Aufmerksamkeit erhält jeder einzelne Teil.
Chroma hat beispielsweise eine Studie dazu veröffentlicht, wie sich die Eingabelänge auf KI-Modelle auswirkt. Darin wurden 18 Modelle von Anthropic, OpenAI, Google und Alibaba getestet. In einem Test versteckten die Forschenden einen Satz mit einem Schreibtipp in einer langen Sammlung von Essays. Anschließend fragten sie das Modell, worin der Tipp bestand.
Den Test führten sie viele Male durch und fügten jedes Mal mehr Essaytext hinzu. Der Satz und die Frage blieben immer gleich. Nur die Menge des umgebenden Textes änderte sich.
Je mehr Text die Modelle lesen mussten, desto schlechter schnitten sie ab. Dieses Ergebnis zeigte sich in allen Tests des Berichts. Die Forschenden gehen davon aus, dass der Genauigkeitsverlust bei realen Aufgaben mit vielen Schritten – wie den meisten Agentenaufgaben – noch größer ausfallen würde.
Wie sich Context Rot auf KI-Agenten auswirken kann
Context Rot zeigt sich in der Regel auf eine von vier Arten:
Die ursprünglichen Anweisungen aus dem Blick verlieren
In Chromas einfachstem Test sollten Modelle eine lange Folge sich wiederholender Wörter exakt abschreiben, in die an einer Stelle ein abweichendes Wort eingefügt war. Es war eine triviale Aufgabe mit einer expliziten Anweisung. Trotzdem ließ die Leistung bei allen Modellen nach, je länger der Text wurde. Einige Modelle gaben sogar Wörter aus, die in der Eingabe überhaupt nicht vorkamen.
Bei einer Agentenaufgabe legt der Nutzer zu Beginn in der Regel konkrete Vorgaben fest, etwa ein Budget oder ein bestimmtes Format. Mit wachsendem Kontext wendet der Agent sie womöglich weniger konsequent an. Die Ursache ist die Gesamtlänge des Kontexts, nicht die Stelle, an der die Anweisung steht.
Übersehene Details aus der Mitte einer Aufgabe
Laut einer Stanford-Studie aus dem Jahr 2023 nutzen KI-Modelle Informationen am zuverlässigsten, wenn diese ganz am Anfang oder ganz am Ende ihrer Eingabe stehen. In einem Test gaben die Forschenden Modellen 20 Dokumente und stellten eine Frage, die nur eines davon beantwortete. Stand dieses Dokument an erster oder letzter Stelle, fanden die Modelle die Antwort meist. Lag es in der Mitte, übersahen sie sie deutlich häufiger. Forschende bezeichnen dies als Positionseffekt.
Dasselbe Muster gilt für Agenten. Informationen, die früher in einer Aufgabe gefunden wurden, liegen womöglich mitten in einer langen Unterhaltung, wo manche Modelle sie schlechter nutzen können. Im Lieferantenbeispiel könnte in der finalen Liste ein guter Lieferant fehlen, den der Agent mitten in der Aufgabe geprüft hat.
Ähnliche Informationen verwechseln
Mit wachsendem Kontext fällt es Agenten unter Umständen schwerer zu erkennen, welche Informationen zu ihren Anweisungen passen. Angenommen, der Nutzer hat den Agenten beauftragt, Lieferanten zu finden, die „innerhalb von zwei Wochen“ liefern. Auf der Website eines Lieferanten steht: „Lieferung innerhalb von 14 Kalendertagen nach Bestellung.“ Bei einer kurzen Aufgabe würde ein Agent wahrscheinlich erkennen, dass beides dasselbe bedeutet. Zwischen Dutzenden anderer Lieferantenseiten übersieht er die Übereinstimmung eher.
Ebenso könnte der Agent anfangen, Ergebnisse aufzunehmen, die nicht relevant sind. Angenommen, der Agent sucht Lieferanten für Bürostühle. Die Website eines Lieferanten verspricht Lieferung innerhalb von zwei Wochen, allerdings nur für Schreibtische. Seine Stühle brauchen sechs Wochen. Da die Website dieselben Wörter wie die Anweisung verwendet, nimmt der Agent den Lieferanten womöglich trotzdem in seine Liste auf. Forschende nennen solche Informationen einen Distraktor. Sie wirken relevant, sind es aber nicht, und konkurrieren so mit den Informationen, auf die es ankommt.
Chromas Studie ergab, dass sich beide Probleme verschärften, je mehr umgebender Text hinzukam.
Schwer erkennbare Fehler
Context Rot löst keine Fehlermeldung aus. Der Agent arbeitet weiter und liefert ein Ergebnis, das fertig aussieht. Deshalb übersieht man seine Fehler leicht.
In Chromas Tests traten diese Fehler in zwei Formen auf. Manchmal gab ein Modell selbstsicher eine falsche Antwort. Im Beispiel der Lieferantenrecherche könnte der Agent eine saubere, gut formatierte Lieferantenliste liefern, die einen Lieferanten enthält, dessen Lieferbedingungen er falsch gelesen hat.
In anderen Fällen gab ein Modell an, Informationen nicht finden zu können, die tatsächlich vorhanden waren. So könnte der Agent beispielsweise einen Bericht liefern, laut dem kein Lieferant die Zwei-Wochen-Frist einhält, obwohl mehrere es tun.
Agentenaufgaben so aufsetzen, dass Context Rot möglichst gering bleibt
Richtig aufgesetzte Aufgaben minimieren die Auswirkungen von Context Rot und halten den Agenten über den gesamten Verlauf der Aufgabe so genau wie möglich. Die folgenden Best Practices helfen dabei.
Die Aufgabe als Auftrag formulieren
Ein klarer Auftrag hält den Kontext kleiner. Der Agent weiß, wann er fertig ist, und hört daher auf, Material zu sammeln, sobald er genug hat. Konkrete Anforderungen geben ihm außerdem einen greifbaren Maßstab, an dem er jede Seite messen kann. So fällt es dem Agenten leichter, die richtigen Informationen zu erkennen.
Vor dem Absenden einer Aufgabe sollte geprüft werden, ob sie drei Punkte abdeckt:
- Die Aufgabe: was der Agent tun und liefern soll, etwa „Lieferanten finden und eine Auswahlliste zurückgeben“.
- Die Anforderungen: die Fakten, die der Agent nicht erraten kann, etwa das Budget, die Frist, die Lieferadresse und für wen das Ergebnis bestimmt ist.
- Das Ergebnis: Format, Länge und Struktur, etwa „eine Tabelle mit Name, Preis pro Stuhl und Lieferzeit“.
Zusammengenommen könnte die Anfrage für die Lieferantenaufgabe so aussehen:
„Finde 10 Lieferanten, die innerhalb von zwei Wochen 40 Bürostühle an unser Büro in Chicago liefern können, für unter 250 $ pro Stuhl. Gib eine Tabelle mit Lieferantenname, Preis pro Stuhl, Lieferzeit und einem Link zur Produktseite zurück. Die Liste ist für unser Office-Management bestimmt, das die Bestellung aufgeben wird.“
Jede Aufgabe fokussiert halten
Eine Aufgabe mit einem klaren Ziel hält den Kontext klein. Lange Aufgaben kosten außerdem mehr. Jeder Schritt verarbeitet alles, was bis dahin gesammelt wurde, sodass ein aufgeblähter Kontext bei jedem Schritt mehr Credits verbraucht.
Ein Projekt mit mehreren Teilen sollte aufgeteilt werden:
- Die einzelnen Teilergebnisse auflisten, zum Beispiel eine Lieferantensuche, einen Preisvergleich und eine E-Mail an den ausgewählten Lieferanten.
- Jedes Teilergebnis als eigene Aufgabe ausführen.
- Nur das fertige Ergebnis von einer Aufgabe an die nächste weitergeben. Zum Beispiel die Lieferantentabelle als Datei hochladen, um die Vergleichsaufgabe zu starten, statt in dem Thread weiterzuarbeiten, in dem sie entstanden ist.
Die Vergleichsaufgabe beginnt dann mit einer einzigen Tabelle statt mit sämtlichen Seiten.
Den Agenten auf die richtigen Quellen verweisen
Jede Seite, die der Agent liest, vergrößert seinen Kontext – einschließlich der Menüs, Werbung und Standardtexte rund um den nützlichen Teil. Wer dem Agenten seine Quellen direkt vorgibt, reduziert dieses Rauschen.
Dateien, von denen die Aufgabe abhängt – etwa die Liste freigegebener Anbieter –, lassen sich hochladen, indem man sie an die Anfrage anhängt. Muss der Agent im Web suchen, empfiehlt es sich, die lohnenden Websites zu nennen, etwa zwei vertrauenswürdige Lieferantenverzeichnisse.
Es empfiehlt sich, die Tools zu verbinden, in denen die Informationen liegen. In Perplexity Computer öffnet man dazu etwa in der Seitenleiste die Konnektoren und aktiviert die Apps, die die Aufgabe benötigt, zum Beispiel Google Drive oder Slack. Anschließend erwähnt man sie in der Anfrage: „Verwende die Stuhlspezifikationen in unserem Google Drive.“ Dabei sollten nur relevante Apps verbunden werden, da jeder Konnektor einen Teil des Kontexts des Agenten belegt.
Liegen die Informationen in einer App, die nicht in der Liste der Konnektoren steht, lässt sie sich möglicherweise trotzdem verbinden. Viele Apps bieten einen MCP-Konnektor (Model Context Protocol) an – eine standardisierte Möglichkeit, KI-Tools an andere Software anzubinden. Computer kann diese zusätzlich zu seinen integrierten Konnektoren nutzen. Bei einem Unternehmenskonto muss sie unter Umständen zuerst ein Administrator aktivieren.
Eine abschließende Prüfung anhand der Anweisungen anfordern
Die Anfrage mit einem Prüfschritt abschließen, der die wichtigsten Vorgaben benennt:
„Prüfe vor dem Abschluss jeden Lieferanten anhand dieser Anforderungen: Lieferung innerhalb von zwei Wochen, unter 250 $ pro Stuhl. Markiere alle, die diese Anforderungen nicht erfüllen, statt sie wegzulassen.“
Die Vorgaben stehen weiterhin am Anfang des Kontexts. Der Prüfschritt gibt dem Agenten einen Anlass, sein Endergebnis mit den Vorgaben abzugleichen, statt sich darauf zu verlassen, dass die Anweisungen über alle Schritte hinweg ihren Einfluss behalten.
Wer den Agenten zudem bittet, Probleme zu markieren, statt die betreffenden Ergebnisse einfach zu verwerfen, kann Fehler leichter erkennen (etwa wenn ein Lieferant abgelehnt wird, der Lieferung innerhalb von 14 Kalendertagen verspricht, weil er nicht die Worte „zwei Wochen“ verwendet).
Die Arbeit an Kontrollpunkten prüfen
Bei längeren Aufgaben einen Kontrollpunkt in die Anfrage einbauen:
„Suche zunächst 20 mögliche Lieferanten und halte dann an. Ich bestätige die Liste, bevor du Preise sammelst.“
Die Auswahlliste mit den ursprünglichen Anweisungen abgleichen. Abweichungen in einer Folgenachricht korrigieren und den Agenten dann weiterarbeiten lassen. Fehler, die an diesem Punkt auffallen, ziehen sich nicht durch alle folgenden Schritte.
Eine neue Aufgabe starten, wenn eine aus dem Ruder läuft
Wiederholt der Agent trotz Korrekturen denselben Fehler, empfiehlt sich eine neue Aufgabe. Jede Korrektur fügt einem ohnehin langen Kontext weiteren Text hinzu. Besser ist es, eine neue Aufgabe zu erstellen: die Anweisungen erneut formulieren, brauchbare Ergebnisse aus dem ersten Versuch hochladen und von vorn beginnen.
Manche Agenten erledigen eine Variante davon automatisch – ein Vorgang namens Compaction (Verdichtung). Wird eine Aufgabe lang, ersetzt der Agent ältere Inhalte, etwa den vollständigen Text früh gelesener Seiten, durch eine kurze Zusammenfassung seiner Erkenntnisse. Portable Computer von Perplexity verdichtet seinen Kontext auf diese Weise, sodass das Modell innerhalb der Menge bleibt, die es gut verarbeiten kann.
Eine neue Aufgabe ist auch dann wichtig, wenn sich das Ziel ändert. Ein Thread, der als Lieferantensuche begonnen hat, sollte nicht auch noch zur Vertragsprüfung werden.
Wiederkehrende Anweisungen in einen Skill umwandeln
Manche Anweisungen tauchen bei jeder Aufgabe einer bestimmten Art auf, etwa ein bevorzugtes Tabellenformat, eine Liste zu meidender Anbieter oder ein standardmäßiger Prüfschritt. In Computer lassen sie sich als Skill speichern – ein wiederverwendbarer Satz von Anweisungen, denen der Agent jedes Mal folgt. Ein Skill verankert die übrigen Best Practices in jeder Aufgabe, die ihn nutzt.
So wird ein Skill eingerichtet:
- Eine häufig wiederkehrende Aufgabe auswählen, etwa die Lieferantenrecherche.
- Die Anweisungen aufschreiben, die jedes Mal gegeben werden: das Format, die Prüfungen, die zu nutzenden oder zu meidenden Quellen.
- Die Anweisungen als Skill speichern. Bereits in Markdown verfasste Anweisungen lassen sich direkt importieren.
- Den Skill in künftigen Anfragen nennen: „Verwende den Skill für Lieferantenrecherche, um Stuhllieferanten für das Büro in Denver zu finden.“
Wie Perplexity bei der Arbeit von Agenten mit Kontext umgeht
Perplexity Computer bewältigt lange Aufgaben so, dass der Kontext jedes Modells klein und relevant bleibt. Drei Elemente seines Designs begrenzen, wie viel ein Modell auf einmal lesen muss.
Arbeit auf Sub-Agenten verteilen
Computer zerlegt eine Anfrage in Aufgaben und Teilaufgaben und erstellt dann Sub-Agenten, die sie ausführen. Jeder Sub-Agent bearbeitet in seinem eigenen Kontext einen Teil der Arbeit. Bei der Lieferantenaufgabe könnte ein Sub-Agent Preise recherchieren, während ein anderer die Lieferbedingungen prüft. Keiner muss alles lesen, was der andere gelesen hat.
Arbeit in Dateien festhalten
Jede Aufgabe in Computer erhält eine eigene Arbeitsumgebung mit eigenen Dateien, eigenem Webbrowser und eigenen Tools. Der Agent kann seine Arbeit in einer Datei speichern, etwa in einer fortlaufend aktualisierten Tabelle der bereits geprüften Lieferanten. Diese Datei öffnet er erst dann wieder, wenn er sie braucht.
Relevante Passagen aus Suchergebnissen auswählen
Webseiten sind voller Inhalte, die das Modell nicht braucht, etwa Menüs, Werbung, Metadaten und Texte zu anderen Themen. Die anfragebezogene Kontextkomprimierung entfernt diese Inhalte. Bevor eine Seite das Modell erreicht, behält Perplexity nur die Sätze, die sich auf die Anfrage beziehen.
Entdecken Sie Tipps, Anleitungen und Beispielaufgaben für Perplexity Computer, um diese Schritte in die Praxis umzusetzen.
Häufige Fragen
Ist Context Rot dasselbe wie Halluzination?
Nein, aber beides hängt zusammen. Eine Halluzination ist jede Antwort, die etwas Falsches oder Unbelegtes behauptet. Context Rot ist einer der Faktoren, die Halluzinationen wahrscheinlicher machen – ebenso wie andere Fehler, etwa ignorierte Anweisungen und übersehene Details.
Lässt sich Context Rot mit einer besseren Anfrage beheben?
Eine klare Anfrage verringert Context Rot, weil sie die Aufgabe fokussiert hält. Sie kann jedoch nicht verhindern, dass der Kontext wächst. Bei einer ausreichend langen Aufgabe sammelt der Agent trotzdem mehr, als er gut nutzen kann. Deshalb sind das Aufteilen der Arbeit und Zwischenprüfungen genauso wichtig wie die Anfrage selbst.
Betrifft Context Rot auch normale KI-Chats und nicht nur Agenten?
Ja. In einem Chat ist der Kontext die gesamte bisherige Unterhaltung, einschließlich aller Nachrichten und aller hineinkopierten oder hochgeladenen Dokumente. Ein Thread, der über Stunden und mehrere Themen hinweg läuft, kann dieselben Fehler hervorbringen wie eine lange Agentenaufgabe. Wer für ein neues Thema einen neuen Thread beginnt, hält jede Unterhaltung fokussiert.
Wie lang kann eine Aufgabe werden, bevor Context Rot einsetzt?
Einen festen Punkt gibt es nicht. Das hängt vom Modell und von der Aufgabe ab. On-Device-Modelle mit einem Kontextfenster von 260.000 Token etwa geraten ab rund 100.000 Token ins Straucheln – weit vor ihrer Grenze. Zudem erfolgt der Rückgang allmählich und nicht plötzlich.