
So erfassen und kontrollieren Sie die Token-Ausgaben Ihres Teams
Wie Teams ihre Token-Nutzung in Dashboards und Berichten einsehen, welche Arten von KI-Arbeit die meisten Tokens verbrauchen und wie sich die Nutzung mit Steuerungsfunktionen senken lässt.
Was sind Token-Ausgaben?
Token-Ausgaben bezeichnen die Anzahl der Tokens, die ein Team bei der Nutzung von KI verbraucht, und die Kosten dieser Tokens. Ein Token ist eine Texteinheit – etwa ein Wort, ein Wortteil oder ein Satzzeichen –, die ein KI-Modell liest oder schreibt. Im Englischen entspricht 1 Token ungefähr 4 Zeichen. Tokens sind nicht modell- oder anbieterübergreifend standardisiert, sodass derselbe Text in verschiedenen Tools zu unterschiedlichen Token-Zahlen führen kann.
Nutzungsberichte unterteilen Tokens in der Regel in einige Typen:
- Eingabe-Tokens umfassen alles, was das Modell für eine Anfrage liest. Dazu gehören die eigentliche Frage, angehängte Texte und der frühere Gesprächsverlauf aus demselben Thread, den das Modell wiederverwendet.
- Ausgabe-Tokens sind die Antwort, die das Modell schreibt. Sie kosten oft mehr als Eingabe-Tokens. In der API-Preisgestaltung von Perplexity kostet die Ausgabe bei manchen Modellen das Sechsfache.
- Reasoning-Tokens sind Text, den ein Modell intern erzeugt, um ein Problem vor der Antwort durchzuarbeiten. Sie erscheinen nicht in der Antwort. Eine längere sichtbare Antwort bedeutet also nicht unbedingt, dass ein Modell insgesamt mehr Tokens verbraucht hat.
Teams, die KI-Tools im Abonnement nutzen, sehen selten eine Abrechnung pro Token. Trotzdem bestimmen Tokens, was sie bekommen, denn aufwendigere Aufgaben verbrauchen Credits schneller oder stoßen früher an Nutzungslimits. Teams, die eigene Tools auf Basis eines KI-Modells entwickeln, zahlen dagegen in der Regel pro Token – im Rahmen einer nutzungsbasierten Preisgestaltung.
So erfassen Sie Token-Ausgaben
Token-Ausgaben bei einem Abo-Tarif erfassen
Abo-Tools zeigen in der Regel keine Token-Zahlen an. Stattdessen setzen viele Tarife auf Credits – vorab bezahlte Einheiten, die mit fortschreitender Arbeit aufgebraucht werden. Credits sind nicht dasselbe wie Tokens, denn ein Credit kann Text, Bilder oder andere Arbeit abdecken. Aufgaben, die mehr Tokens verbrauchen, benötigen aber in der Regel auch mehr Credits. Deshalb sind Credits bei einem Abo der beste Anhaltspunkt für die Token-Ausgaben. Nutzer können ihren eigenen Credit-Verbrauch verfolgen, und manche Tarife bieten zusätzlich ein Admin-Dashboard, das den Credit-Verbrauch des gesamten Teams zeigt.
In Perplexity verbrauchen normale Suchen beispielsweise keine Credits. Nur Perplexity Computer, der Assistent für mehrstufige Aufgaben, nutzt sie. Wer Computer verwendet, kann sehen, wie viele Credits verbraucht wurden und wofür. Außerdem zeigt jede Computer-Aufgabe im Menü „Nutzung“ ihrer Unterhaltung ihren eigenen Credit-Gesamtverbrauch an.
In Enterprise-Tarifen können Administratoren im Insights-Dashboard sehen, wie viele Personen Perplexity nutzen und wie viele Anfragen sie pro Woche stellen (verfügbar für Organisationen mit 50 oder mehr Plätzen oder mindestens einem Mitglied mit Enterprise Max).
Token-Ausgaben in API-Nutzungsberichten erfassen
Die Nutzungsberichte des API-Anbieters zeigen Token-Zahlen direkt an, meist aufgeschlüsselt nach Token-Typ. In der Konsole der API Platform von Perplexity können Nutzer beispielsweise auf der Abrechnungsseite Kennzahlen wie die Ausgaben für Eingabe-, Ausgabe- und Reasoning-Tokens verfolgen.
Warum Token-Ausgaben steigen
Agenten führen pro Aufgabe viele Schritte aus, und jeder Schritt ist eine eigene Anfrage an ein Modell. Eine einzige Aufgabe kann so auf Hunderttausende oder sogar Millionen Tokens kommen.
Zudem werden Reasoning-Modelle immer verbreiteter. Ein Reasoning-Modell formuliert seine Überlegungen aus, bevor es antwortet, und jedes Wort davon schlägt als Token zu Buche. Dieselbe Anfrage verbraucht bei einem Reasoning-Modell daher meist mehr Tokens als bei einem Standardmodell, auch wenn die Antwort auf dem Bildschirm gleich lang aussieht.
Und schließlich summiert sich die Token-Nutzung, je mehr Menschen und Workflows KI ganz allgemein einsetzen. Ein Teil dieses Wachstums geht zudem auf sogenanntes Tokenmaxxing zurück: Dabei lassen Entwickler Agenten vor allem laufen, um ihre persönlichen Token-Zahlen zu steigern und in internen Token-Ranglisten weiter oben zu landen.
So senken Sie Token-Ausgaben
Hohe Token-Ausgaben entstehen meist durch einige wenige Arten von Arbeit, die mehr Tokens verbrauchen, als es den Anschein hat.
Lange Unterhaltungen und Agent-Aufgaben
Bei jeder Antwort liest ein Modell in der Regel die gesamte bisherige Unterhaltung erneut. Jede neue Anfrage enthält den kompletten bisherigen Gesprächsverlauf plus die aktuelle Nachricht des Nutzers. Eine kurze Frage spät in einem langen Thread verbraucht deshalb mehr Tokens als dieselbe Frage in einem neuen. Bei Agent-Aufgaben ist es genauso, denn jeder Schritt fügt seine Ergebnisse dem Verlauf hinzu, den der nächste Schritt erneut liest.
Was dagegen hilft
- Beginnen Sie bei einem Themenwechsel eine neue Unterhaltung. Eröffnen Sie sie mit einer zwei- bis dreizeiligen Zusammenfassung all dessen, was das Modell aus dem alten Thread noch braucht.
- Teilen Sie lange Agent-Aufgaben in kleinere auf. Führen Sie jeden Teil als eigene Aufgabe aus, und geben Sie nur die Ergebnisse weiter, die der nächste Teil benötigt.
- Prüfen Sie, ob die Agent-Tools Ihres Teams Kontextkomprimierung nutzen. Dabei werden ältere Teile einer Aufgabe automatisch zusammengefasst, sodass das Modell weniger erneut lesen muss. Bietet ein Tool die Komprimierung als Einstellung an, aktivieren Sie sie.
Dieselben Dokumente, immer wieder verarbeitet
Wenn jemand dieselbe lange Datei – etwa ein Richtlinienhandbuch oder einen Produktkatalog – an viele separate Anfragen anhängt, liest das Modell jedes Mal die gesamte Datei. Jeder Lesevorgang wird als Eingabe-Tokens berechnet.
Was dagegen hilft
- Schulen Sie Nutzer darin, den relevanten Abschnitt eines Handbuchs oder Katalogs in die Anfrage zu kopieren, statt die gesamte Datei anzuhängen.
- Erstellen Sie Kurzfassungen von Dokumenten, die das Team häufig nutzt. Eine einseitige Zusammenfassung einer langen Richtlinie kann bei Routineanfragen das vollständige Dokument ersetzen.
Wiederholungen und Schleifen
Wenn eine Antwort nicht das liefert, was jemand brauchte, und die Aufgabe erneut ausgeführt wird, verbraucht jeder Versuch Tokens. Dasselbe passiert, wenn ein Agent hängen bleibt und immer wieder denselben Schritt wiederholt.
Was dagegen hilft
- Legen Sie bereits in der ersten Anfrage die Aufgabe, das gewünschte Ergebnis und die Quellen klar fest. Zum Beispiel: „Fasse in fünf Stichpunkten die Hauptgründe zusammen, aus denen Kunden im dritten Quartal gekündigt haben, und nutze dabei ausschließlich die angehängten Umfrageergebnisse.“
- Überprüfen Sie die ersten Schritte einer Agent-Aufgabe. Wiederholt der Agent denselben Schritt oder dieselbe Suche, stoppen Sie ihn und starten Sie mit einer enger gefassten Anfrage neu.
Große Modelle für einfache Aufgaben
Leistungsfähigere Modelle kosten in der Regel mehr pro Token. Routinearbeiten wie Zusammenfassungen oder Umformatierungen können das Budget eines Teams daher schneller aufbrauchen als nötig.
Was dagegen hilft
- Nutzen Sie Modell-Routing, das jeder Aufgabe ein Modell zuordnet, das sie bewältigen kann. Eine kurze Umformulierung oder Zusammenfassung kann an ein kleineres, günstigeres Modell gehen, während das leistungsfähigste Modell für mehrstufiges Reasoning oder Analysen reserviert bleibt. Die API von Perplexity verfolgt diesen Ansatz mit ihren Presets, die einer schnellen Abfrage ein kleineres Modell und einer umfassenden Analyse ein größeres zuweisen.
Nutzungsspitzen nach neuen Workflows
Ein neuer automatisierter Workflow oder ein Tool, das für ein ganzes Team eingeführt wird, kann die Nutzung über Nacht in die Höhe treiben. Eine solche Spitze ist an sich kein Problem, aber es lohnt sich zu wissen, welche Arbeit sie verursacht hat.
Was dagegen hilft
- Testen Sie neue Workflows zunächst mit einer kleinen Gruppe. Beobachten Sie deren Nutzung ein bis zwei Wochen lang, bevor Sie den Workflow für das gesamte Team einführen.
- Legen Sie für jedes Team ein monatliches Budget fest. Orientieren Sie sich dabei an der Nutzung eines typischen Monats, damit ein Anstieg sofort auffällt.
- Deaktivieren Sie die automatische Aufladung. Ist sie ausgeschaltet, wird die Arbeit angehalten, sobald die Credits aufgebraucht sind, statt dass automatisch weitere Credits gekauft werden.
So optimieren Sie Token-Ausgaben in Perplexity
Für die tägliche Nutzung
Computer verbraucht Credits, läuft aber nur, wenn Sie ihn ausdrücklich wählen: indem Sie das Computer-Symbol auswählen, in einem Projekt arbeiten, das standardmäßig Computer verwendet, oder den Work-Modus in Comet nutzen.
Um zur normalen Suche zurückzukehren, wählen Sie das Perplexity-Symbol und wechseln so wieder in den Ask-Modus. Ihren Credit-Verbrauch können Nutzer im Tracker innerhalb der Perplexity-Oberfläche einsehen.
Teams, die in Projekten arbeiten, den gemeinsamen Arbeitsbereichen von Perplexity, können den Standardmodus jedes Projekts auf „Suche“ oder „Computer“ festlegen. Ein Projekt, das hauptsächlich für schnelle Recherchen genutzt wird, kann standardmäßig auf „Suche“ eingestellt werden, damit niemand versehentlich eine Computer-Aufgabe startet.
Für Enterprise-Administratoren
- Informieren Sie sich, was jeder Platz umfasst. Nutzer mit Enterprise Pro erhalten ein monatliches Kontingent von 500 Credits, Nutzer mit Enterprise Max 15.000 Credits. Diese verfallen am Ende jedes Monatszyklus und werden nicht übertragen.
- Legen Sie zuerst ein Standard-Nutzungslimit fest. Ein Nutzungslimit begrenzt, wie viele zusätzliche Credits ein Mitglied aus dem gemeinsamen Pool beziehen kann, sobald sein eigenes Kontingent aufgebraucht ist.
- Erstellen Sie benannte Limits für verschiedene Nutzertypen. Admins können Limits wie „Standard“, „Power-User“ und „Auftragnehmer“ einrichten und sie Nutzergruppen oder einzelnen Mitgliedern zuweisen. Gruppen können aus Perplexity stammen oder vom Identitätsanbieter des Unternehmens synchronisiert werden. Gehört jemand mehreren Gruppen an, gilt das höchste Limit.
- Nutzen Sie persönliche Überschreibungen für Ausnahmen. Braucht eine Person ein anderes Limit als ihre Gruppe, hat eine persönliche Überschreibung Vorrang vor allen Gruppen- oder gemeinsamen Limits. Das ist etwa bei einem kurzen Projekt mit umfangreicher Recherche hilfreich, ohne dass das Limit für ein ganzes Team angehoben werden muss.
- Setzen Sie der automatischen Aufladung eine Obergrenze. Die automatische Aufladung füllt den gemeinsamen Pool automatisch auf. Sie verfügt über ein konfigurierbares monatliches Aufladelimit, sodass die Ausgaben nicht über ein festgelegtes Maximum hinaus wachsen können.
- Legen Sie fest, wie Mitglieder zusätzliche Credits anfordern. Mit der Einstellung „Mitgliedern erlauben, weitere Credits anzufordern“ können Personen, die ihr Limit erreicht haben, bei einem Admin weitere Credits anfragen, statt einfach gestoppt zu werden.
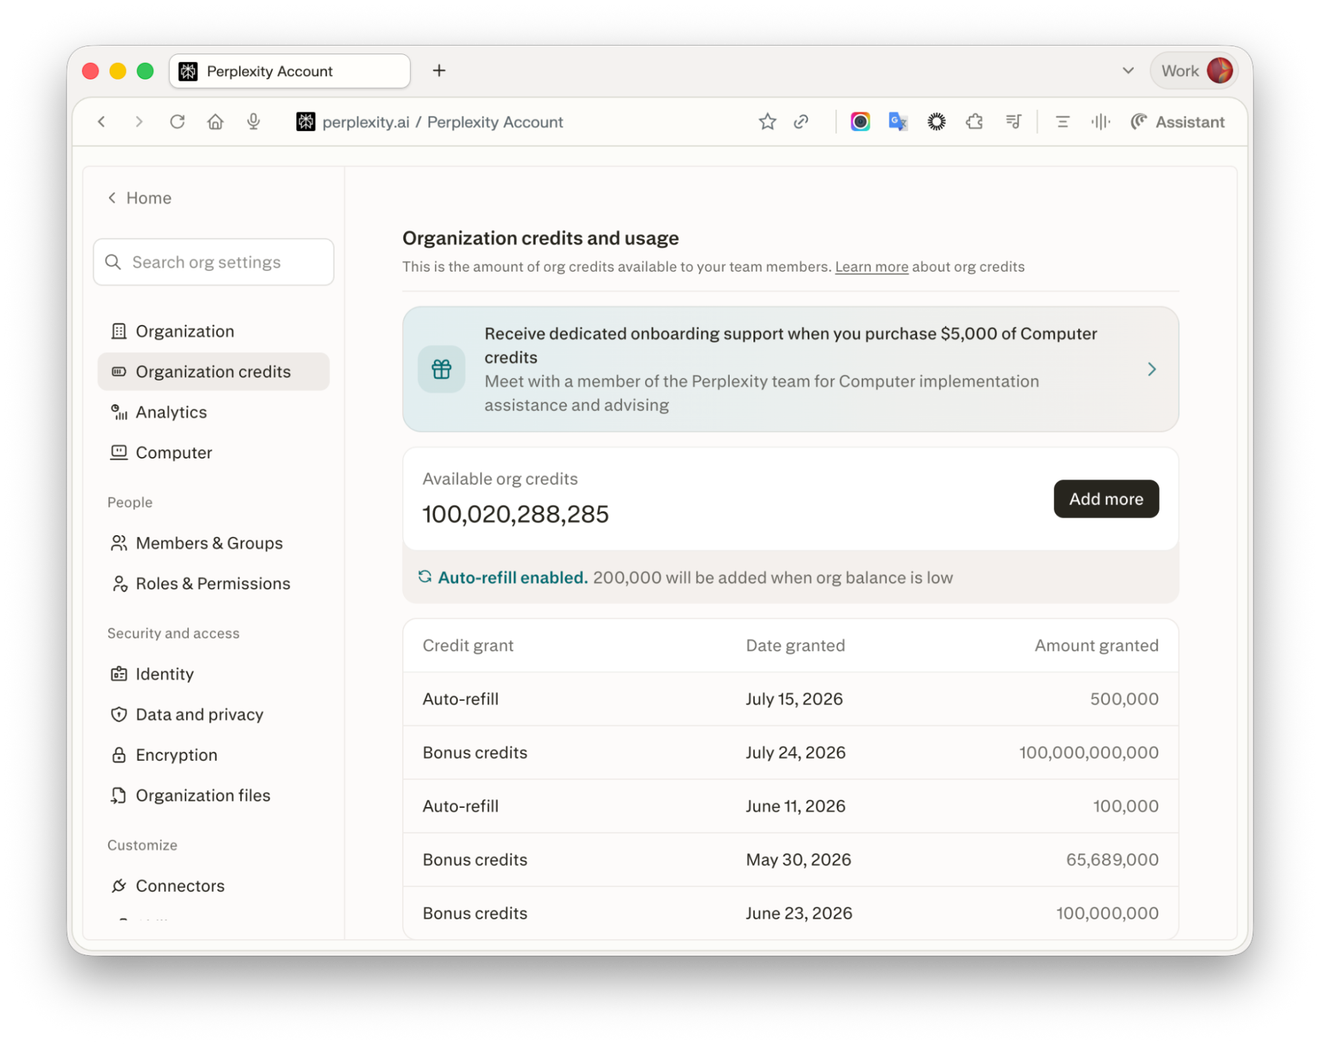
- Überprüfen Sie die Nutzung jeden Monat. Die Seite „Organisations-Credits“ zeigt für jedes Mitglied die gewährten, verbrauchten und verbleibenden Credits sowie die Gruppenlimits und das Pool-Guthaben. Für Organisationen mit 50 oder mehr Plätzen oder mindestens einem Mitglied mit Enterprise Max ergänzt das Insights-Dashboard die monatlich aktiven Nutzer und die wöchentlichen Anfragen im Zeitverlauf. Für weitere Details erfassen Audit-Logs die Ausführung von Aufgaben, die Konnektor-Nutzung, den Credit-Verbrauch und Credit-Zuteilungen.
Für Teams, die mit der API entwickeln
- Geben Sie jedem Tool oder Team einen eigenen API-Schlüssel. Perplexity kann die Abrechnung für jeden Schlüssel separat anzeigen, und mit getrennten Schlüsseln ist klar ersichtlich, welches Tool die Nutzung verursacht.
- Prüfen Sie auf der Abrechnungsseite, welche Art von Tokens zunimmt. Sie zeigt Eingabe-, Ausgabe- und Reasoning-Tokens im Zeitverlauf. Steigende Eingabe-Tokens bedeuten meist, dass ein Tool mehr Text sendet als nötig. Steigende Reasoning-Tokens bedeuten, dass Aufgaben auf Modellen laufen, die Probleme ausführlich durchdenken.
- Nutzen Sie die Search API, wenn ein Tool nur Suchergebnisse benötigt. Sie liefert Webergebnisse, ohne dass ein Modell eine Antwort schreibt, und wird pro Anfrage ohne zusätzliche tokenbasierte Gebühren abgerechnet.
- Starten Sie Agent-Tools mit einem Preset. Die Presets von Perplexity stimmen die Modellgröße auf den Umfang der Aufgabe ab und halten einfache Anfragen von den teuersten Modellen fern.
Arbeiten nach dem Local-first-Prinzip
Manche Arbeit erfordert überhaupt kein kostenpflichtiges Cloud-Modell. Portable Computer ist eine Version des Perplexity-Agenten, die auf dem eigenen Rechner einer Person läuft und ein auf diesem Gerät gespeichertes KI-Modell nutzt. Da das Modell lokal läuft, verbrauchen Routinearbeiten keine kostenpflichtigen Tokens. Auf das Web, verbundene Apps oder ein leistungsstärkeres Cloud-Modell greift Portable Computer nur zu, wenn eine Aufgabe dies erfordert – und fragt vorher den Nutzer.
Erfahren Sie, wie Perplexity Computer mehrstufige Aufgaben bewältigt – im Web, in Dateien und in verbundenen Tools.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Token-Ausgaben und KI-Kosten?
Token-Ausgaben messen, wie viel KI-Arbeit ein Team leistet – gezählt in Tokens. KI-Kosten umfassen alles, was ein Team für die Nutzung von KI bezahlt, einschließlich Abonnements, zusätzlicher Credits und Einrichtung. Token-Ausgaben bestimmen den nutzungsbasierten Teil dieser Rechnung.
Zahlen Abo-Nutzer pro Token?
Meist nicht direkt. Abo-Tools erfassen die Nutzung in Nachrichten, Anfragen oder Credits, und Aufgaben, die mehr Tokens verbrauchen, zehren diese schneller auf. Bei Perplexity verbrauchen normale Suchen überhaupt keine Credits; das tun nur Computer-Aufgaben.
Warum verbrauchen KI-Agenten so viele Tokens?
Ein Agent erledigt eine Aufgabe in vielen Schritten, und jeder Schritt ist eine eigene Anfrage, die die bisherige Arbeit erneut liest. Eine lange Aufgabe verbraucht daher mit jedem weiteren Schritt mehr Tokens.
Warum steigt die Token-Nutzung plötzlich sprunghaft an?
Die meisten Nutzungsspitzen folgen auf eine Veränderung in der Arbeitsweise eines Teams, etwa einen neuen automatisierten Workflow, ein Tool, das für mehr Personen eingeführt wurde, oder eine lange Agent-Aufgabe. Ein Abgleich des Datums der Spitze mit den jüngsten Einführungen zeigt meist die Ursache. Wer neue Workflows zunächst mit einer kleinen Gruppe testet, kann solchen Spitzen vorbeugen.