
Memoria de la IA: qué es, cómo funciona y qué almacena
Una guía sobre la memoria de la IA: cómo los asistentes de IA guardan y recuerdan detalles de conversaciones anteriores, qué almacenan, dónde falla la memoria y cómo verla, editarla o desactivarla.
La memoria de IA es la información que un asistente de IA conversacional guarda de tus conversaciones anteriores y lleva a las nuevas, para poder recordar tus preferencias y tu contexto. El modelo en sí no conserva nada de eso. El asistente la almacena por separado y la vuelve a agregar cuando es relevante, lo que le da al modelo un contexto persistente que de otro modo no tendría.
Esta guía explica cómo los asistentes guardan y recuerdan esa información, qué almacenan, por qué a veces se equivocan y cómo verla, cambiarla o desactivarla.
¿Qué es la memoria de IA?
La memoria de IA, también llamada memoria persistente, es una función de los asistentes de IA que almacena información sobre ti, como preferencias, datos y contexto de interacciones anteriores, que el asistente puede usar en conversaciones posteriores.
Un asistente de IA puede crear ese registro a partir de lo que le pides que recuerde, los detalles que detecta por su cuenta y los chats anteriores que puede consultar.
La capa de memoria de IA permite que los asistentes de IA ofrezcan respuestas personalizadas sin que tengas que compartir tus preferencias en cada chat. Si le dijiste a un asistente que estás entrenando para un maratón y que prefieres los kilómetros, tu siguiente pregunta sobre ritmo recibirá una respuesta en kilómetros sin que tengas que repetirlo.
En comparación con volver a explicar tu situación en cada chat, la memoria te ahorra escribir y mantiene corto el prompt, lo cual importa porque las entradas largas hacen que las respuestas sean menos precisas.
La memoria no es una transcripción de cada conversación, sino una colección de datos clave sobre ti. Así que recordará que prefieres los kilómetros. Encontrar el plan de entrenamiento exacto que redactó el mes pasado depende de si el asistente también puede buscar en chats anteriores.
Tipos de memoria de IA
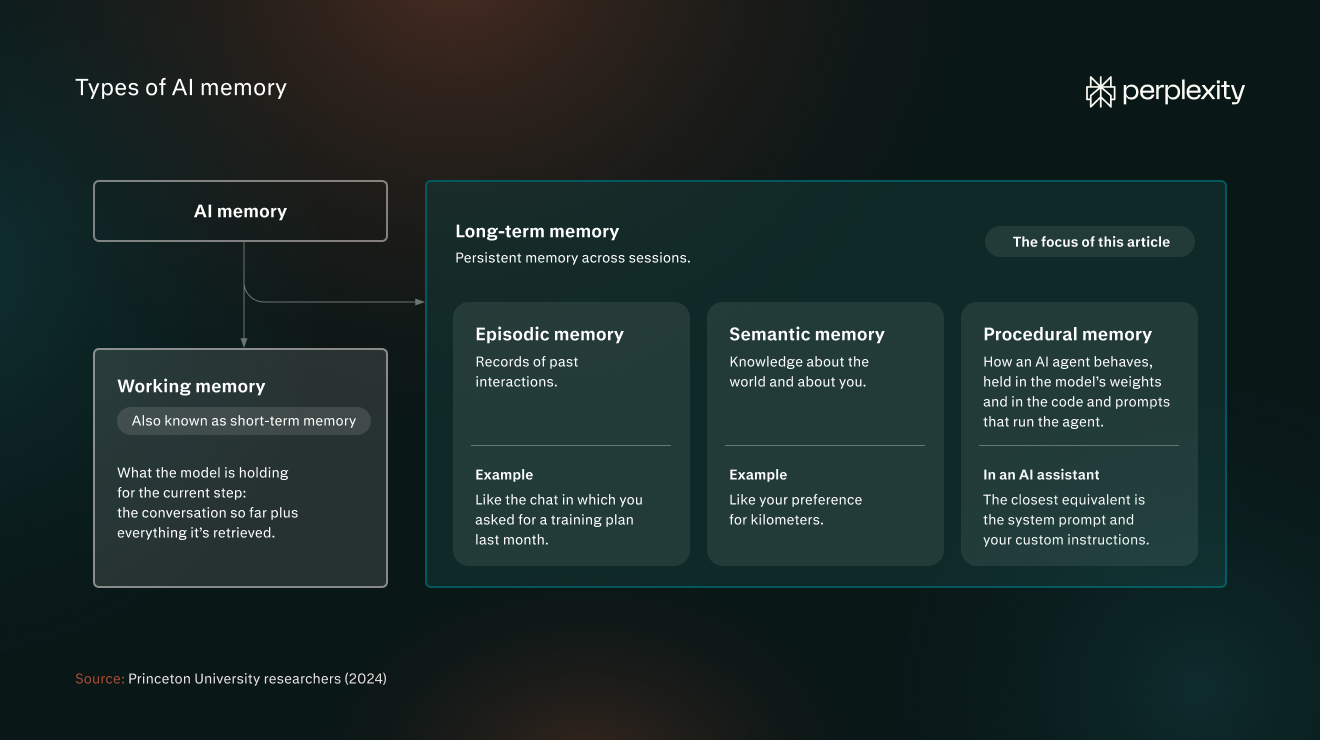
Investigadores de la Universidad de Princeton (2024) tomaron prestada terminología de la ciencia de la memoria humana para clasificar los tipos de sistemas de memoria de IA. Su marco distingue la memoria de trabajo de la memoria a largo plazo:
- Memoria de trabajo: Lo que el modelo retiene para el paso actual, es decir, la conversación hasta el momento más todo lo que ha recuperado. También se conoce como memoria a corto plazo.
- Memoria a largo plazo: Memoria persistente entre sesiones. Este es el tipo de memoria del que trata este artículo.
La memoria a largo plazo se compone de tres tipos de memoria:
- Memoria episódica: Registros de interacciones anteriores, como el chat en el que pediste un plan de entrenamiento el mes pasado.
- Memoria semántica: Conocimiento sobre el mundo y sobre ti, como tu preferencia por los kilómetros.
- Memoria procedimental: Cómo se comporta un agente de IA, integrado en los pesos del modelo y en el código y los prompts que ejecutan al agente. En un asistente de IA, el equivalente más cercano es el prompt del sistema y tus instrucciones personalizadas.
Memoria del asistente de IA vs. memoria del agente de IA
Tanto la memoria del asistente de IA como la memoria del agente de IA son memoria a largo plazo. La memoria del asistente de IA es principalmente memoria semántica y almacena datos sobre ti para que las respuestas se ajusten a ti. La memoria del agente, como Brain de Perplexity, almacena lo que hizo el agente y cómo le fue, incluido lo que funcionó y lo que corregiste, para que empiece cada nueva tarea desde una mejor posición.
Memoria del asistente de IA | Memoria del agente de IA | |
Qué recuerda | A ti | La tarea y su historial |
Para qué sirve | Respuestas que se ajustan a ti | Continuar trabajos de varios pasos sin empezar de cero |
Ejemplo | Recuerda que prefieres los kilómetros | Recuerda tu plan de entrenamiento para el maratón, los ajustes que le hizo y las sesiones que has completado hasta ahora, para planificar mejor los próximos bloques |
Memoria de IA vs. ventanas de contexto, datos de entrenamiento e instrucciones personalizadas
Es fácil confundir la memoria de IA con otros tres elementos que influyen en una respuesta: la ventana de contexto del modelo, los datos de entrenamiento y las instrucciones personalizadas. Cada uno contiene información distinta, dura un tiempo distinto y lo controla un sistema distinto.
Una ventana de contexto es la cantidad de texto que un modelo de lenguaje grande (LLM) puede leer a la vez y abarca la conversación actual. Se restablece cuando inicias un chat nuevo.
Algunos modelos actuales tienen ventanas de contexto grandes, de un millón de tokens o más, así que técnicamente podrías pegar tu información clave en cada conversación. Pero procesarla toda aumenta la latencia y el costo.
Varios estudios también han encontrado que la precisión de la salida disminuye a medida que crece la entrada, incluso cuando la respuesta está en el contexto.
Un estudio de 2025 de la Universidad de Illinois y Amazon lo observó incluso cuando los modelos podían recitar cada detalle relevante: la precisión cayó entre un 13.9% y un 85% a medida que las entradas crecieron hasta 30,000 tokens, muy por debajo de los límites declarados de los modelos. NoLiMa, un benchmark de 2025 de Adobe Research y la LMU de Múnich, encontró que 11 de los 13 modelos evaluados tuvieron un rendimiento significativamente inferior con apenas 32,000 tokens cuando la pregunta y la respuesta no compartían palabras clave. El reporte de julio de 2025 de Chroma lo observó en 18 modelos, incluso cuando respondían a partir de un historial de chat de 113,000 tokens.
Los datos de entrenamiento son la información integrada en los pesos del modelo antes de su lanzamiento. Los usuarios no pueden cambiarlos. Los desarrolladores pueden ajustar un modelo con datos nuevos, pero ese es un proceso de ingeniería, no una configuración del usuario,
Las instrucciones personalizadas son reglas guardadas en la configuración del asistente que tú mismo escribes y editas para personalizar el comportamiento y las respuestas del asistente de IA. Por ejemplo, podrías usar instrucciones personalizadas para definir el tono y el estilo de las respuestas o qué fuentes puede usar el asistente.
Así se comparan los cuatro:
Ventana de contexto | Memoria de IA | Datos de entrenamiento | Instrucciones personalizadas | |
Qué contiene | Los mensajes del chat actual | Datos y preferencias guardados sobre ti | Lo que el modelo aprendió antes de su lanzamiento | Indicaciones que escribes tú mismo |
Cuánto dura | Solo este chat | Hasta que se actualiza o se elimina | No cambia hasta que se lanza un nuevo modelo | Hasta que las editas |
Quién lo controla | Tú, dentro del límite que establece el proveedor del modelo. | Tú y el asistente | La empresa de IA | Tú |
Ejemplo | La pregunta sobre ritmo que hiciste hace un minuto | Que prefieres los kilómetros | Cómo se estructuran en general los planes de entrenamiento para maratón | Instrucción para dar formato a los planes de entrenamiento en una cuadrícula donde las filas representan semanas y las columnas, días de la semana |
Qué almacena la memoria de IA
Los asistentes conservan ciertos detalles sobre ti, como datos, preferencias y resúmenes, y algunos también recurren a tus chats anteriores.
- Datos y preferencias que le pides que recuerde: Son detalles que le indicas explícitamente al asistente que guarde, como “recuerda que prefiero los kilómetros”. El asistente crea el recuerdo cuando se lo pides, y dura hasta que lo eliminas o una conversación posterior lo actualiza.
- Detalles que detecta en tus conversaciones: El asistente los guarda cuando la configuración está activada. Perplexity “da prioridad a la frecuencia de las preguntas que hace el usuario y de la información que proporciona”, así que es más probable que se quede algo que mencionas a menudo que algo que mencionas una sola vez. El recuerdo dura hasta que se actualiza o lo eliminas.
- Referencias a tus chats anteriores: El asistente recurre directamente a conversaciones anteriores en lugar de a una lista guardada. Perplexity llama a esto historial de búsqueda: tus preguntas y respuestas anteriores, que se usan para que una nueva respuesta sea más relevante.
Cómo funciona la memoria de IA
El modelo de IA no recuerda nada entre conversaciones. De eso se encarga el sistema de memoria de IA: mantiene un registro separado sobre ti y agrega las partes relevantes a cada conversación nueva. El almacenamiento y la recuperación ocurren en segundo plano, así que el modelo lee esas partes junto con tu pregunta.
Ese proceso consta de cinco pasos:
- Guardado: El asistente guarda un recuerdo cuando se lo pides o cuando considera que vale la pena conservar un detalle.
- Almacenamiento: Los recuerdos van a una base de datos separada del modelo. En muchos sistemas, es una base de datos vectorial, para que se puedan buscar por significado. La lista que ves en la configuración es una vista de ese almacén de memoria.
- Recuperación: Cuando envías un mensaje, el asistente decide qué recuerdos aplican. Muchos sistemas lo hacen convirtiendo tu mensaje y cada recuerdo en embeddings, representaciones numéricas del significado, y eligiendo las coincidencias más cercanas. Así es como pueden recuperar un recuerdo incluso cuando no comparte ninguna palabra con tu pregunta. Los sistemas más simples cargan todos los recuerdos guardados en cada conversación.
- Uso: Los recuerdos recuperados se insertan como texto sin formato en la entrada, generalmente en un bloque de instrucciones que el modelo lee antes de tu mensaje. El modelo los procesa como cualquier otro texto de esa entrada.
- Actualización y eliminación: El asistente extrae datos de los chats, busca entre los recuerdos existentes y decide si agregar cada dato como nuevo, actualizar un recuerdo existente, combinarlo con otro o eliminar un recuerdo antiguo que contradiga la información nueva. Algunos asistentes agregan una marca de tiempo a cada recuerdo para distinguir la información más reciente de la más antigua.
Desafíos y riesgos de la memoria de IA
La memoria de IA busca mejorar la calidad de las respuestas, pero los benchmarks muestran que la recuperación de memoria no siempre ofrece información relevante o actual, sobre todo en bases de datos grandes. También plantea riesgos de seguridad y privacidad.
Entre los problemas comunes de confiabilidad y seguridad relacionados con la memoria de IA se encuentran:
- Recuerdos mal aplicados: Un recuerdo puede colarse en una respuesta con la que no tiene nada que ver. Un estudio de 2026 evaluó 18 modelos para ver si un recuerdo guardado de un ámbito de la vida se filtraba en una respuesta sobre otro. La tasa de fallo mediana fue del 53%. El estudio también encontró que, cuando la memoria contenía las creencias de los usuarios o la experiencia que afirmaban tener, casi todos los modelos las repetían aunque la pregunta requiriera una respuesta neutral.
- Recuerdos desactualizados: El asistente sigue actuando con base en un detalle después de que una conversación posterior lo volvió falso, sobre todo cuando nunca lo dijiste de forma explícita. En un benchmark de mayo de 2026, que evaluó si los modelos detectan esos cambios implícitos, el mejor modelo obtuvo un promedio de 55.2%.
- Sobrecarga de memoria: Cuanto más tiene que releer un asistente, más difícil le resulta identificar lo importante. LongMemEval, un benchmark de 2024, encontró que los modelos que leían un historial de chat de unos 115,000 tokens tuvieron un rendimiento entre un 30% y un 60% peor que los modelos a los que solo se les dieron las sesiones relevantes.
- Envenenamiento de memoria: Información falsa o instrucciones ocultas llegan a la memoria de un asistente, por ejemplo, a través de contenido que le pides que lea, lo que provoca respuestas sesgadas o inseguras, o filtraciones de datos.
- Riesgos de privacidad: La memoria conserva datos personales más allá del chat del que provienen, a veces por más tiempo del que esperas. Perplexity, por ejemplo, puede conservar un registro de los recuerdos eliminados hasta por 30 días por motivos de seguridad y depuración. Las leyes de protección de datos consideran los recuerdos almacenados como datos personales, por lo que deberías poder revisarlos y eliminarlos.
Cómo ver, editar y desactivar la memoria de IA
Puedes ver lo que un asistente ha guardado, eliminarlo, desactivar la memoria o usar un chat privado que no cree recuerdos.
La gestión de la memoria se reduce a unos cuantos controles. Esto es lo que hace cada uno y cuándo usarlo:
Control | Qué hace | Cuándo usarlo |
Ver lo guardado | Abre tu banco de memoria, donde puedes buscar, filtrar y revisar entradas individuales. | Cuando una respuesta incluye un detalle que no esperabas. |
Eliminar un recuerdo | Elimina la entrada, y el asistente deja de usarla en respuestas posteriores (los asistentes pueden conservar un registro de los recuerdos borrados durante cierto tiempo). | Cuando un recuerdo es incorrecto, está desactualizado o es sensible. |
Desactivar la memoria | Hace que el asistente deje de consultar la memoria en respuestas futuras (es posible que no borre los recuerdos ya almacenados; revisa tu asistente). | Cuando quieres respuestas sin personalización |
Desactivar el historial de búsqueda | Hace que el asistente deje de usar tus preguntas y respuestas anteriores. Eliminar una sesión de tu historial de búsqueda elimina su influencia en respuestas posteriores. | Cuando las conversaciones anteriores influyen en las respuestas, conviene empezar de cero. |
Usa un chat incógnito | La memoria y el historial de búsqueda siempre están desactivados, y las preguntas que haces ahí nunca se conservan ni se usan en la memoria. | Para temas puntuales o delicados. |
Para empezar de cero, desactiva la memoria y borra lo que esté guardado.
Cómo gestiona Perplexity la memoria
La memoria de Perplexity funciona con todos los modelos que ofrece.
Perplexity personaliza las respuestas a partir de dos fuentes: los recuerdos, que son las preferencias y los detalles que compartes, y tu historial de búsqueda. Cuando un recuerdo influye en una respuesta, aparece entre las fuentes de esa respuesta, para que puedas ver qué recuerdos se usaron y eliminar cualquiera de ellos.
También puedes personalizar tus respuestas proporcionando información sobre ti e instrucciones personalizadas para los proyectos (cada proyecto tiene su propia capa de memoria).
Perplexity puede usar el contenido de la memoria para mejorar sus modelos en las cuentas de consumidor (nunca en las de Enterprise), a menos que lo desactives (Retención de datos de IA en Configuración → Preferencias → Inteligencia artificial).
Los suscriptores de Max y Enterprise Max también obtienen Brain, una capa de memoria compartida que amplía la memoria al dar seguimiento a tus proyectos y a tu trabajo. Tiene su propio interruptor e ignora las sesiones de incógnito.
Prueba Perplexity y observa cómo los recuerdos influyen en tu próxima respuesta.
Preguntas frecuentes sobre la memoria de la IA
¿Qué es la memoria limitada en la IA?
IBM define la IA de memoria limitada como aquella que puede recordar eventos y resultados pasados y monitorear situaciones a lo largo del tiempo, pero no puede conservar esos datos en una biblioteca de experiencias pasadas a largo plazo. Es una de las cuatro categorías de una taxonomía de sistemas de IA, e IBM incluye en ella a los chatbots y los asistentes virtuales.
La memoria del asistente es una memoria externa que esos sistemas agregan por encima. Persiste entre sesiones, por lo que un asistente puede usar detalles que compartiste en una conversación anterior.
¿Qué asistente de IA tiene la mejor memoria?
Ningún asistente es el mejor para todos. Una buena memoria es aquella que puedes controlar, así que evalúa las herramientas de IA con cuatro preguntas: ¿Puedes ver lo que guardó? ¿Puedes eliminar un recuerdo por separado del chat del que surgió? ¿El entrenamiento es una configuración independiente de la memoria? ¿Hay un modo temporal o incógnito que no cree recuerdos?
¿Un modelo de IA aprende de lo que recuerda sobre ti?
Usar la memoria en una respuesta es un proceso distinto del entrenamiento. Perplexity afirma que recupera el contexto relevante de tu almacén de memoria en lugar de tratar tu historial como datos de entrenamiento. Que tu contenido pueda usarse para mejorar los modelos es una configuración aparte. En las cuentas de consumidor, Perplexity puede usar el contenido de la memoria con ese fin, y la opción Retención de datos de IA lo desactiva.
¿Qué no deberías guardar en la memoria de la IA?
Mantén fuera de la memoria de la IA todo lo que no quieras que se almacene, se use para crear un perfil tuyo o se repita más adelante: datos de identidad y financieros, información de salud, contraseñas, información de otras personas y cualquier cosa sobre niños. La Oficina del Comisionado de Privacidad de Canadá (mayo de 2025) y el Centro Nacional de Ciberseguridad del Reino Unido (marzo de 2023) recomiendan evitar cualquier instrucción que pudiera causar problemas si se hiciera pública.
Los filtros reducen los riesgos de privacidad, pero no garantizan que tu información de salud o financiera no se almacene en absoluto, así que revisa tu banco de memoria y usa el modo incógnito para preguntas delicadas puntuales.