
Deterioro del contexto en agentes de IA: por qué las tareas largas pierden precisión y cómo evitarlo
Una guía sobre lo que se acumula en el contexto de un agente de IA, por qué afecta la precisión y cómo configurar tareas que sigan siendo confiables.
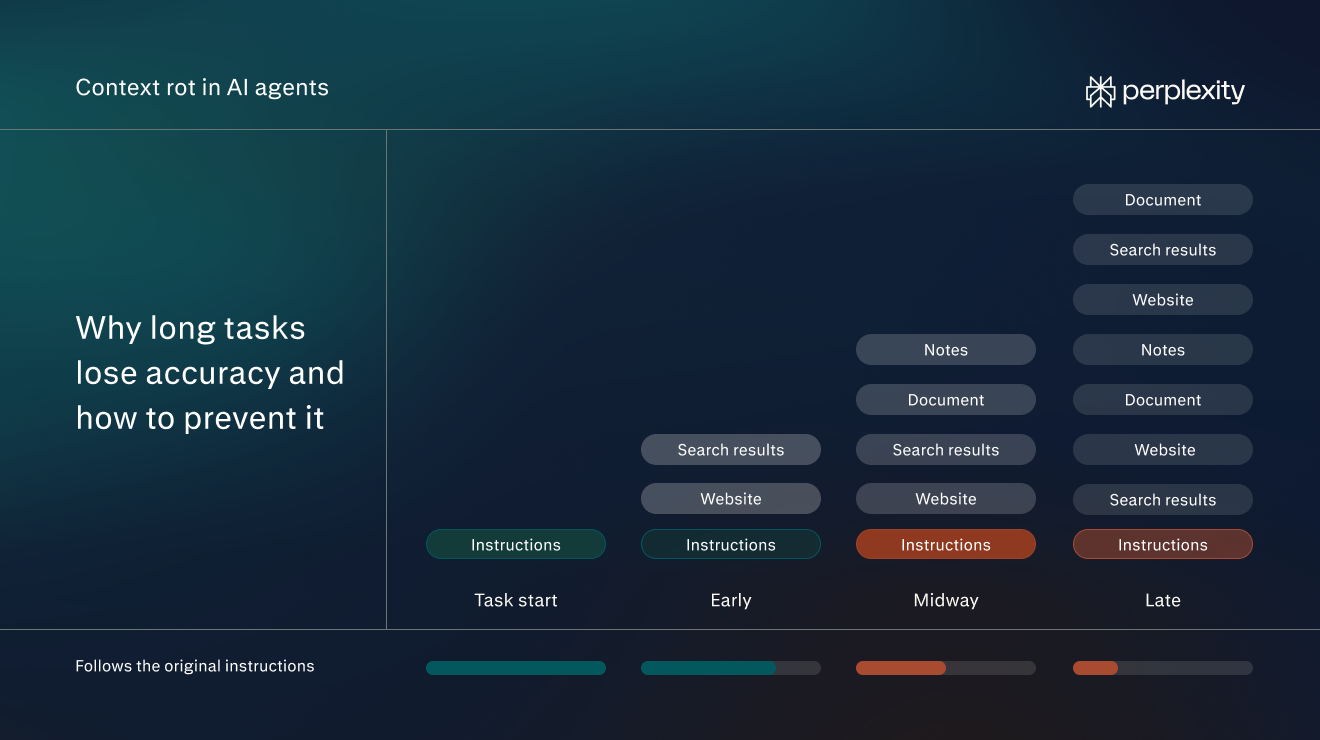
Qué significa el deterioro del contexto para los agentes de IA
El deterioro del contexto (context rot) en los agentes de IA es la pérdida gradual de precisión que se produce a medida que el contexto de un agente se llena durante una tarea larga.
El contexto de un agente es la información que el modelo tiene disponible para su siguiente paso. Puede incluir instrucciones, mensajes anteriores, resultados de búsqueda y texto de sitios web o archivos. A medida que el agente trabaja, puede ir agregando más.
Por ejemplo, supongamos que la tarea de un agente es encontrar proveedores que entreguen en un plazo de dos semanas. Al principio, su contexto contiene solo esa solicitud. A mitad de la tarea, el contexto también incluirá el texto de decenas de sitios web de proveedores, varias páginas de resultados de búsqueda y notas sobre qué proveedores ya revisó el agente.
Hay un límite en la cantidad de contexto que puede manejar un modelo (llamado ventana de contexto). La ventana se mide en tokens, que son pequeños fragmentos de texto, por lo general una palabra o parte de una palabra. El deterioro del contexto aumenta a medida que crece el contexto, por eso es más probable que ocurra en tareas largas con muchos pasos.
A medida que el deterioro del contexto empeora, el agente se vuelve menos preciso. Puede seguir sus instrucciones originales con menos rigor, pasar por alto detalles o confundir información de apariencia similar con la que necesita.
Por ejemplo, el agente podría empezar a incluir proveedores que tardan seis semanas, aunque se le pidió encontrar entregas en dos semanas. La instrucción sigue en su contexto, pero ya no orienta las decisiones del agente.
El deterioro del contexto no es lo mismo que simplemente quedarse sin espacio en la ventana de contexto. Cuando el contexto de una tarea supera la ventana, parte del material se recorta o la tarea falla. El deterioro del contexto empieza mucho antes de ese punto, cuando todo todavía cabe.
Tampoco es lo mismo que el envenenamiento del contexto (cuando entra información engañosa o dañina en el contexto del agente). Un agente con información precisa y completa aún puede sufrir deterioro del contexto.
Por qué ocurre el deterioro del contexto
El deterioro del contexto ocurre porque la atención de un modelo es limitada, incluso cuando su ventana de contexto todavía tiene espacio de sobra. En los modelos de IA, la atención es el término técnico para la forma en que un modelo decide en qué partes de su entrada apoyarse al escribir cada palabra de una respuesta. Todas las partes del contexto compiten por esa atención. Cuanto más texto hay, menos atención recibe cada parte.
Por ejemplo, Chroma publicó un estudio sobre cómo afecta la longitud de la entrada a los modelos de IA. Evaluó 18 modelos de Anthropic, OpenAI, Google y Alibaba. En una prueba, los investigadores escondieron una oración sobre consejos de escritura dentro de una larga colección de ensayos. Luego le preguntaron al modelo cuál era el consejo.
Repitieron la prueba muchas veces, agregando más texto de los ensayos cada vez. La oración y la pregunta nunca cambiaron. Solo cambió la cantidad de texto a su alrededor.
Cuanto más texto tenían que leer los modelos, peor era su desempeño. Este hallazgo se mantuvo en todas las pruebas del informe. Los investigadores prevén que la caída en la precisión sería aún mayor en trabajos reales que requieren muchos pasos, como la mayoría de las tareas de agentes.
Cómo puede afectar el deterioro del contexto a los agentes de IA
El deterioro del contexto suele manifestarse de una de estas cuatro formas:
Perder de vista las instrucciones originales
La prueba más sencilla de Chroma pidió a los modelos copiar exactamente una larga cadena de palabras repetidas, con una palabra distinta insertada en algún punto. Era una tarea trivial con una instrucción explícita. Aun así, el desempeño disminuyó en todos los modelos a medida que el texto se alargaba. Algunos modelos empezaron a producir palabras que ni siquiera estaban en la entrada.
En una tarea de agente, el usuario suele establecer restricciones específicas al inicio, como un presupuesto o un formato obligatorio. El agente podría aplicarlas de forma menos constante a medida que crece el contexto. La causa es la longitud total del contexto, no el lugar donde está la instrucción.
Detalles omitidos de la mitad de una tarea
Los modelos de IA usan la información de forma más confiable cuando está justo al principio o justo al final de su entrada, según un estudio de Stanford de 2023. En una prueba, los investigadores dieron a los modelos un conjunto de 20 documentos y les hicieron una pregunta que solo uno de ellos respondía. Cuando ese documento aparecía en primer o en último lugar, los modelos solían encontrar la respuesta. Cuando estaba a la mitad del conjunto, la pasaban por alto con mucha más frecuencia. Los investigadores llaman a esto efecto de posición.
El mismo patrón se aplica a los agentes. La información encontrada al principio de una tarea puede quedar a la mitad de una conversación larga, donde a algunos modelos les cuesta más usarla. En el ejemplo de los proveedores, la lista final podría omitir a un buen proveedor que el agente revisó a mitad de la tarea.
Confundir información similar
A medida que crece el contexto, a los agentes les puede costar más reconocer qué información se ajusta a sus instrucciones. Por ejemplo, supongamos que el usuario le pidió al agente encontrar proveedores que envíen "en un plazo de dos semanas". El sitio web de un proveedor dice "llega dentro de los 14 días naturales posteriores al pedido". En una tarea corta, es probable que un agente se dé cuenta de que significan lo mismo. Entre decenas de otras páginas de proveedores, es más probable que no detecte la coincidencia.
O bien, el agente podría empezar a incluir resultados que no son relevantes. Supongamos que el agente busca proveedores de sillas de oficina. El sitio web de un proveedor promete entrega en dos semanas, pero solo para escritorios. Sus sillas tardan seis semanas. El sitio usa las mismas palabras que la instrucción, así que el agente podría agregar al proveedor a su lista de todos modos. Los investigadores llaman distractor a este tipo de información. Parece relevante, pero no lo es, así que compite con la información que importa.
El estudio de Chroma encontró que ambos problemas empeoraban a medida que aumentaba la cantidad de texto circundante.
Errores difíciles de detectar
El deterioro del contexto no genera ningún mensaje de error. El agente sigue trabajando y entrega un resultado que parece terminado. Por eso es fácil pasar por alto sus errores.
En las pruebas de Chroma, estos errores tomaron dos formas. A veces, un modelo daba con seguridad una respuesta incorrecta. En el ejemplo de la investigación de proveedores, el agente podría entregar una lista de proveedores ordenada y bien formateada que incluya a un proveedor cuyas condiciones de entrega interpretó mal.
Otras veces, un modelo decía que no podía encontrar información que en realidad estaba ahí. Por ejemplo, el agente podría entregar un informe que diga que ningún proveedor cumple con el límite de dos semanas cuando varios sí lo cumplen.
Cómo configurar las tareas de agentes para reducir el deterioro del contexto
Configurar bien las tareas minimiza el impacto del deterioro del contexto y mantiene al agente lo más preciso posible durante toda la tarea. Las siguientes prácticas recomendadas pueden ayudar.
Redacta la tarea como un encargo
Un encargo claro mantiene el contexto más pequeño. El agente sabe cuándo terminó, así que deja de reunir material en cuanto tiene suficiente. Los requisitos específicos también le dan algo concreto con qué contrastar cada página. Eso facilita que el agente detecte la información correcta.
Antes de enviar una tarea, verifica que cubra tres cosas:
- La tarea: qué debe hacer y producir el agente, como "encuentra proveedores y entrega una lista corta".
- Los requisitos: los datos que el agente no puede adivinar, como el presupuesto, la fecha límite, la dirección de entrega y para quién es el resultado.
- El resultado: el formato, la extensión y la estructura, como "una tabla con nombre, precio por silla y tiempo de entrega".
En conjunto, la consulta de la tarea de proveedores podría verse así:
"Encuentra 10 proveedores que puedan entregar 40 sillas de oficina en nuestra oficina de Chicago en un plazo de dos semanas, por menos de US$250 por silla. Devuelve una tabla con el nombre del proveedor, el precio por silla, el tiempo de entrega y un enlace a la página del producto. La lista es para nuestro gerente de oficina, quien hará el pedido."
Mantén cada tarea enfocada
Una sola tarea con un objetivo claro mantiene el contexto pequeño. Las tareas largas también cuestan más. Cada paso procesa todo lo reunido hasta ese momento, así que un contexto sobrecargado consume más créditos en cada paso.
Si un proyecto tiene varias partes, divídelo:
- Enumera los entregables por separado, por ejemplo, una búsqueda de proveedores, una comparación de precios y un correo electrónico al proveedor elegido.
- Ejecuta cada entregable como una tarea independiente.
- Pasa solo el resultado final de una tarea a la siguiente. Por ejemplo, sube la tabla de proveedores como archivo para iniciar la tarea de comparación, en lugar de continuar en el hilo que la produjo.
Así, la tarea de comparación empieza con una sola tabla en lugar de todas las páginas.
Dirige al agente a las fuentes correctas
Cada página que lee el agente se suma a su contexto, incluidos los menús, los anuncios y el texto genérico que rodean la parte útil. Darle al agente sus fuentes directamente reduce ese ruido.
Sube los archivos de los que depende la tarea, como la lista de proveedores aprobados, adjuntándolos a la consulta. Si el agente tiene que buscar en la web, indica los sitios web en los que vale la pena buscar, como dos directorios de proveedores de confianza.
Conecta las herramientas donde está la información. Por ejemplo, en Perplexity Computer, abre Conectores en la barra lateral y habilita las apps que necesita la tarea, como Google Drive o Slack. Luego menciónalas en la consulta: "Usa las especificaciones de las sillas que están en nuestro Google Drive". Conecta solo las apps relevantes, ya que cada conector ocupa parte del contexto del agente.
Si la información está en una app que no aparece en la lista de Conectores, es posible que aun así se pueda conectar. Muchas apps ofrecen un conector MCP (Model Context Protocol), una forma estándar de que las herramientas de IA se conecten con otro software. Computer puede usarlos junto con sus conectores integrados. En una cuenta de empresa, es posible que un administrador tenga que habilitarlos primero.
Pide una verificación final con base en las instrucciones
Termina la consulta con un paso de revisión que mencione las restricciones más importantes:
"Antes de terminar, verifica que cada proveedor cumpla con estos requisitos: entrega en un plazo de dos semanas y menos de US$250 por silla. Señala los que no cumplan esos requisitos en lugar de omitirlos."
Las restricciones siguen estando al inicio del contexto. El paso de revisión le da al agente un motivo para comparar su resultado final con las restricciones, en lugar de confiar en que las instrucciones mantengan su influencia a lo largo de cada paso.
Además, pedirle que señale los problemas, en lugar de simplemente descartar esos resultados, hace que los errores sean más fáciles de detectar (por ejemplo, rechazar a un proveedor que promete la llegada en un plazo de 14 días naturales porque no usa las palabras “dos semanas”).
Revisa el trabajo en puntos de control
En tareas más largas, incluye un punto de control en la consulta:
"Empieza por encontrar 20 proveedores candidatos y luego detente. Confirmaré la lista antes de que recopiles los precios."
Compara la lista corta con las instrucciones originales. Corrige lo que no esté bien en un mensaje de seguimiento y luego deja que el agente continúe. Los errores detectados en este punto no se arrastrarán a todos los pasos siguientes.
Inicia una nueva tarea cuando una se desvíe
Si el agente repite el mismo error después de las correcciones, inicia una nueva tarea. Cada corrección agrega más texto a un contexto que ya es largo. En su lugar, crea una nueva tarea. Vuelve a plantear las instrucciones, sube cualquier resultado útil del primer intento y empieza de nuevo.
Algunos agentes hacen una versión de esto automáticamente, un proceso llamado compactación. A medida que una tarea se alarga, el agente reemplaza el material más antiguo, como el texto completo de las páginas que leyó al principio, por un breve resumen de lo que encontró. Portable Computer de Perplexity compacta su contexto de esta manera, para que el modelo se mantenga dentro de la cantidad que puede manejar bien.
También es importante iniciar una nueva tarea si cambia el objetivo. Un hilo que empezó como una búsqueda de proveedores no debería convertirse también en una revisión de contratos.
Convierte las instrucciones repetidas en una Skill
Algunas instrucciones se repiten en todas las tareas de cierto tipo, como un formato de tabla preferido, una lista de proveedores que se deben evitar o un paso de revisión estándar. En Computer, estas se pueden guardar como una Skill, un conjunto reutilizable de instrucciones que el agente sigue cada vez. Una Skill incorpora las demás prácticas recomendadas en cada tarea que la usa.
Para configurar una:
- Elige una tarea que se repita con frecuencia, como la investigación de proveedores.
- Escribe las instrucciones que das cada vez: el formato, las verificaciones y las fuentes que se deben usar o evitar.
- Guárdalas como una Skill. Las instrucciones que ya estén escritas en Markdown se pueden importar directamente.
- Menciona la Skill en consultas futuras: "Usa la Skill de investigación de proveedores para encontrar proveedores de sillas para la oficina de Denver".
Cómo aborda Perplexity el contexto en el trabajo de agentes
Perplexity Computer gestiona las tareas largas de manera que el contexto de cada modelo se mantenga pequeño y relevante. Tres aspectos de su diseño limitan cuánto tiene que leer un modelo a la vez.
Dividir el trabajo entre subagentes
Computer divide una solicitud en tareas y subtareas, y luego crea subagentes para llevarlas a cabo. Cada subagente se encarga de una parte del trabajo en su propio contexto. En la tarea de proveedores, un subagente podría investigar los precios mientras otro revisa las condiciones de entrega. Ninguno tiene que leer todo lo que leyó el otro.
Guardar el trabajo en archivos
Cada tarea de Computer tiene su propio espacio de trabajo, con sus propios archivos, navegador web y herramientas. El agente puede guardar su trabajo en un archivo, como una tabla que va actualizando con los proveedores que ya revisó. Después, vuelve a abrir ese archivo solo cuando lo necesita.
Seleccionar los pasajes relevantes de los resultados de búsqueda
Las páginas web están llenas de material que el modelo no necesita, como menús, anuncios, metadatos y texto sobre otros temas. La compresión de contexto según la consulta elimina todo eso. Antes de que una página llegue al modelo, Perplexity conserva solo las oraciones relacionadas con la consulta.
Explora consejos, guías y tareas de ejemplo para Perplexity Computer para poner en práctica estos pasos.
Preguntas frecuentes
¿El deterioro del contexto es lo mismo que una alucinación?
No, pero están relacionados. Una alucinación es cualquier respuesta que afirma algo falso o sin fundamento. El deterioro del contexto es una de las condiciones que hacen más probables las alucinaciones, junto con otros errores como ignorar instrucciones u omitir detalles.
¿Una mejor consulta puede solucionar el deterioro del contexto?
Una consulta clara reduce el deterioro del contexto porque mantiene la tarea enfocada. Sin embargo, no puede impedir que el contexto crezca. En una tarea lo bastante larga, el agente sigue reuniendo más de lo que puede aprovechar bien, por eso dividir el trabajo y revisarlo sobre la marcha importa tanto como la propia consulta.
¿El deterioro del contexto afecta a los chats normales con IA, no solo a los agentes?
Sí. En un chat, el contexto es toda la conversación hasta ese momento, incluidos todos los mensajes y cualquier documento que se haya pegado o subido. Un hilo que lleva horas abierto y abarca varios temas puede producir los mismos errores que una tarea larga de un agente. Iniciar un hilo nuevo para cada tema nuevo mantiene enfocada cada conversación.
¿Cuánto puede durar una tarea antes de que aparezca el deterioro del contexto?
No hay un punto fijo. Depende del modelo y de la tarea. Por ejemplo, los modelos que se ejecutan en el dispositivo con ventanas de contexto de 260,000 tokens empiezan a tener dificultades a partir de unos 100,000 tokens, muy por debajo de su límite. Además, el deterioro es gradual, no repentino.