
Cómo monitorear y controlar el gasto en tokens del equipo
Cómo pueden los equipos ver su uso de tokens en paneles y reportes, qué tipos de trabajo de IA usan más tokens y cómo usar controles para reducirlo.
Qué es el gasto en tokens
El gasto en tokens es la cantidad de tokens que un equipo consume con IA y lo que cuestan esos tokens. Un token es una unidad de texto, como una palabra, parte de una palabra o un signo de puntuación, que un modelo de IA lee o escribe. En inglés, 1 token equivale aproximadamente a 4 caracteres. Los tokens no están estandarizados entre modelos ni proveedores, así que el mismo texto puede generar un conteo distinto en diferentes herramientas.
Los reportes de uso suelen dividir los tokens en varios tipos:
- Los tokens de entrada son todo lo que el modelo lee en una solicitud. Eso incluye la consulta, cualquier texto adjunto y el historial de la conversación que el modelo reutiliza de mensajes anteriores del mismo hilo.
- Los tokens de salida son la respuesta que escribe el modelo. Suelen costar más que los tokens de entrada. En los precios de la API de Perplexity, algunos modelos cobran seis veces más por la salida.
- Los tokens de razonamiento son el texto que un modelo genera internamente para resolver un problema antes de responder. No aparecen en la respuesta, así que una respuesta visible más larga no significa necesariamente que un modelo haya usado más tokens en total.
Los equipos que usan herramientas de IA con una suscripción rara vez ven un cargo por token. Aun así, los tokens determinan lo que obtienen, ya que las tareas más pesadas consumen créditos o alcanzan los límites de uso más rápido. En cambio, los equipos que crean sus propias herramientas sobre un modelo de IA suelen pagar por token, con precios basados en el uso.
Cómo dar seguimiento al gasto en tokens
Seguimiento del gasto en tokens en un plan de suscripción
Las herramientas de suscripción normalmente no muestran el conteo de tokens. En su lugar, muchos planes usan créditos, unidades prepagadas que el plan va descontando a medida que se realiza el trabajo. Los créditos no son lo mismo que los tokens, ya que un crédito puede cubrir texto, imágenes u otro tipo de trabajo. Pero las tareas que usan más tokens también suelen usar más créditos, por lo que son la mejor referencia del gasto en tokens en una suscripción. Los usuarios pueden dar seguimiento a su propio uso de créditos, y algunos planes también incluyen un panel de administración que muestra el uso de créditos de todo el equipo.
En Perplexity, por ejemplo, las búsquedas normales no usan créditos. Solo los usa Perplexity Computer, el asistente que se encarga de las tareas de varios pasos. Quienes usan Computer pueden ver cuántos créditos han usado y en qué los usaron. Cada tarea de Computer también muestra su propio total de créditos en el menú “Uso” de su conversación.
En los planes Enterprise, los administradores pueden ver cuántas personas usan Perplexity y cuántas consultas hacen cada semana en el panel de Insights (disponible para organizaciones con 50 o más puestos, o con al menos un miembro de Enterprise Max).
Seguimiento del gasto en tokens en los reportes de uso de la API
Los reportes de uso del proveedor de la API muestran directamente el conteo de tokens, normalmente desglosado por tipo de token. La consola de la API Platform de Perplexity, por ejemplo, permite a los usuarios dar seguimiento a métricas como el gasto en tokens de entrada, de salida y de razonamiento en la página Facturación.
Por qué está creciendo el gasto en tokens
Los agentes ejecutan muchos pasos por tarea, y cada paso es una solicitud independiente a un modelo. Una sola tarea puede sumar cientos de miles o incluso millones de tokens.
Los modelos de razonamiento también son cada vez más comunes. Un modelo de razonamiento escribe su proceso de pensamiento antes de responder, y cada palabra de ese proceso cuenta como tokens. Por eso, la misma solicitud suele usar más tokens en un modelo de razonamiento que en uno estándar, aunque la respuesta en pantalla parezca de la misma longitud.
Por último, a medida que más personas y flujos de trabajo usan IA en general, el uso de tokens se acumula. Parte de ese crecimiento también proviene del tokenmaxxing, una práctica en la que los ingenieros ejecutan agentes principalmente para aumentar su conteo personal de tokens y subir posiciones en las clasificaciones internas de tokens.
Cómo reducir el gasto en tokens
La mayor parte del gasto alto en tokens proviene de unos cuantos tipos de trabajo que usan más tokens de lo que parece.
Conversaciones largas y tareas de agentes
Cada vez que un modelo responde, normalmente vuelve a leer toda la conversación hasta ese momento. Cada nueva solicitud incluye todo el historial anterior de la conversación más el mensaje actual del usuario. Así, una pregunta corta al final de un hilo largo usa más tokens que la misma pregunta en uno nuevo. Las tareas de agentes funcionan igual, porque cada paso agrega sus resultados al historial que el siguiente paso vuelve a leer.
Qué hacer al respecto
- Inicia una nueva conversación cuando cambie el tema. Ábrela con un resumen de dos o tres líneas de lo que el modelo todavía necesite del hilo anterior.
- Divide las tareas largas de agentes en tareas más pequeñas. Ejecuta cada parte como una tarea independiente y transmite solo los resultados que necesite la siguiente parte.
- Verifica si las herramientas de agentes del equipo usan compactación de contexto. La compactación resume automáticamente las partes más antiguas de una tarea para que el modelo vuelva a leer menos. Si una herramienta la ofrece como opción de configuración, actívala.
Los mismos documentos procesados una y otra vez
Cuando alguien adjunta el mismo archivo largo, como un manual de políticas o un catálogo de productos, a muchas consultas distintas, el modelo lee el archivo completo cada vez. Cada lectura cuenta como tokens de entrada.
Qué hacer al respecto
- Capacita a los usuarios para que copien en la solicitud la sección relevante del manual o del catálogo en lugar de adjuntar el archivo completo.
- Crea una versión breve de los documentos que el equipo usa con frecuencia. Un resumen de una página de una política extensa puede sustituir al documento completo en las consultas de rutina.
Reintentos y bucles
Cuando una respuesta no es lo que alguien necesitaba y vuelve a ejecutar la tarea, cada intento usa tokens. Lo mismo ocurre cuando un agente se atasca repitiendo el mismo paso.
Qué hacer al respecto
- Especifica la tarea, el resultado y las fuentes en la primera solicitud. Por ejemplo: “Resume las principales razones por las que los clientes cancelaron en el tercer trimestre, usando solo los resultados de la encuesta adjunta, en cinco viñetas”.
- Revisa los primeros pasos de una tarea de agente. Si el agente repite el mismo paso o la misma búsqueda, detenlo y reinícialo con una solicitud más acotada.
Modelos grandes para tareas sencillas
Los modelos más capaces suelen costar más por token, así que el trabajo rutinario, como resúmenes o cambios de formato, puede agotar el presupuesto de un equipo más rápido de lo necesario.
Qué hacer al respecto
- Usa el enrutamiento de modelos, que asigna cada tarea a un modelo capaz de resolverla. Una reescritura o un resumen breve puede ir a un modelo más pequeño y económico, y el modelo más capaz se reserva para el razonamiento o el análisis de varios pasos. La API de Perplexity sigue este enfoque con sus ajustes preestablecidos, que asignan un modelo más pequeño a una búsqueda rápida y uno más grande a un análisis exhaustivo.
Picos después de nuevos flujos de trabajo
Un nuevo flujo de trabajo automatizado, o una herramienta implementada en todo un equipo, puede elevar el uso de la noche a la mañana. Un pico no es un problema en sí mismo, pero vale la pena saber qué trabajo lo provocó.
Qué hacer al respecto
- Prueba los nuevos flujos de trabajo primero con un grupo pequeño. Revisa su uso durante una o dos semanas antes de implementar el flujo de trabajo en todo el equipo.
- Establece un presupuesto mensual para cada equipo. Básalo en el uso de un mes típico para que cualquier aumento repentino destaque.
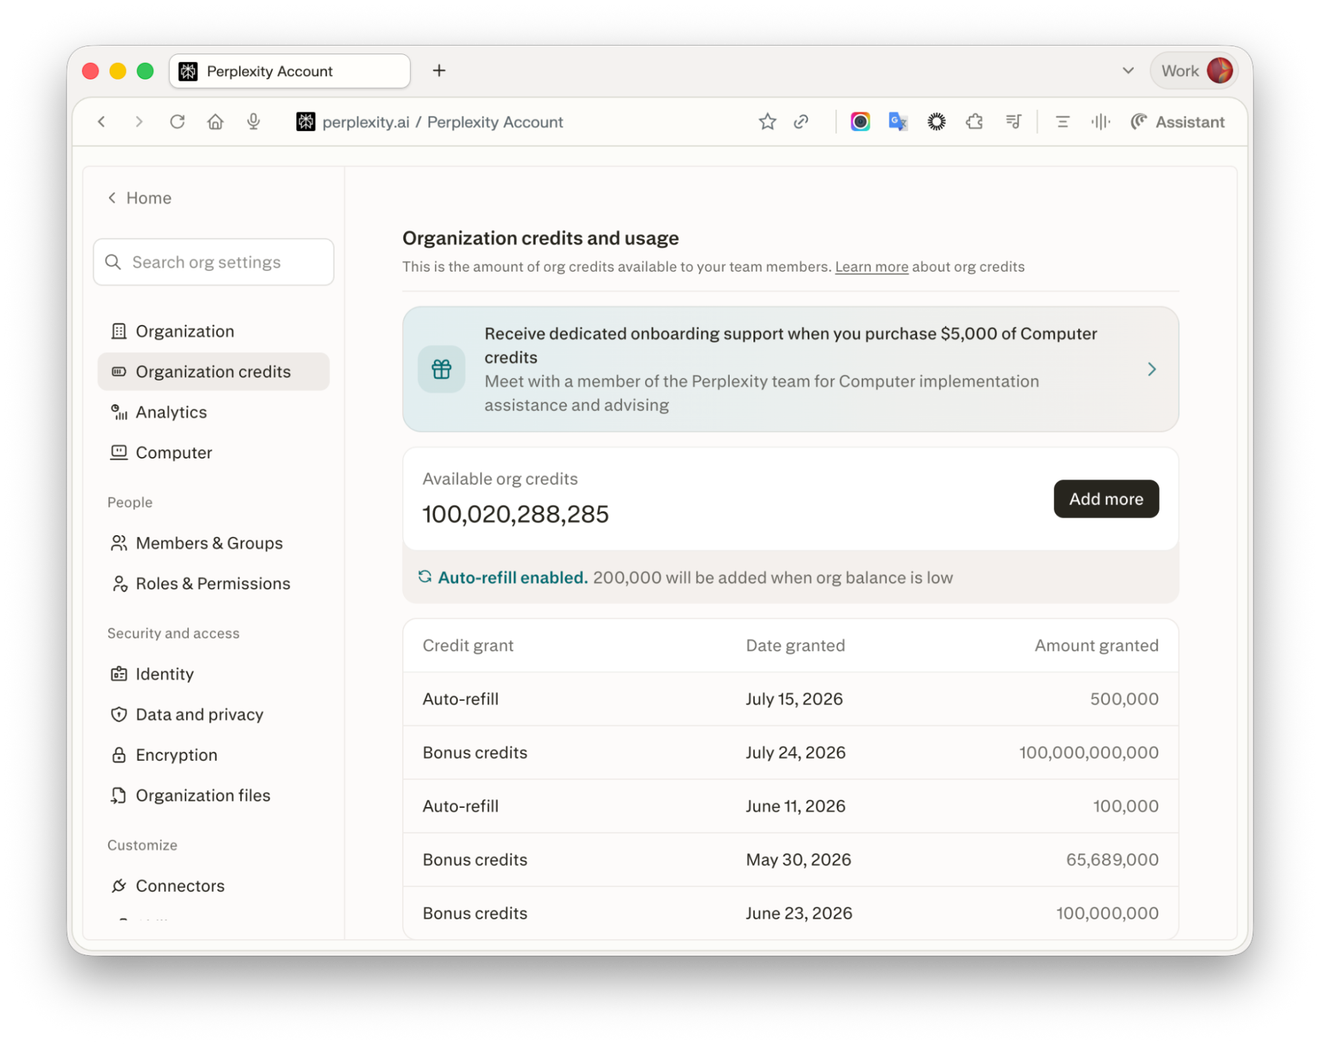
- Desactiva la recarga automática. Con la recarga automática desactivada, el trabajo se detiene cuando se agotan los créditos, en lugar de que se compren más créditos automáticamente.
Cómo optimizar el gasto en tokens en Perplexity
Para el uso diario
Computer usa créditos, pero solo se ejecuta cuando tú lo eliges, ya sea al seleccionar el ícono de Computer, al trabajar en un proyecto que usa Computer de forma predeterminada o al usar el modo Work de Comet.
Para volver a la búsqueda normal, selecciona el ícono de Perplexity para regresar al modo Ask. Para ver el uso de créditos, los usuarios pueden abrir el contador de créditos dentro de la interfaz de Perplexity.
Los equipos que trabajan en proyectos, los espacios de trabajo compartidos de Perplexity, pueden configurar el modo predeterminado de cada proyecto en Búsqueda o Computer. Un proyecto que se usa principalmente para investigaciones rápidas puede tener Búsqueda como modo predeterminado, para que nadie inicie una tarea de Computer por accidente.
Para administradores de Enterprise
- Conoce lo que incluye cada puesto. Los usuarios de Enterprise Pro reciben una asignación mensual de 500 créditos y los usuarios de Enterprise Max reciben 15,000 créditos. Estos créditos vencen al final de cada ciclo mensual y no se acumulan para el siguiente.
- Primero, establece un límite de uso predeterminado. Un límite de uso fija cuántos créditos adicionales puede tomar un miembro del fondo compartido una vez que se agota su propia asignación.
- Crea límites con nombre para distintos tipos de usuarios. Los administradores pueden configurar límites como “Estándar”, “Usuario avanzado” y “Contratista”, y asignarlos a grupos de usuarios o a miembros individuales. Los grupos pueden crearse en Perplexity o sincronizarse desde el proveedor de identidad de la empresa. Si alguien pertenece a más de un grupo, se aplica el límite más alto.
- Usa anulaciones personales para las excepciones. Cuando una persona necesita un límite distinto al de su grupo, una anulación personal tiene prioridad sobre cualquier límite de grupo o compartido. Esto es útil para un proyecto corto con mucha investigación, sin tener que aumentar el límite de todo un equipo.
- Ponle un tope a la recarga automática. La recarga automática repone el fondo compartido de forma automática. Incluye un límite mensual de recarga configurable, para que el gasto no pueda crecer sin un máximo establecido.
- Decide cómo pueden pedir más los miembros. La opción Permitir que los miembros soliciten más créditos hace posible que quienes alcancen su límite pidan más a un administrador, en lugar de quedar bloqueados por completo.
- Revisa el uso cada mes. La página Créditos de la organización muestra los créditos otorgados, usados y restantes de cada miembro, junto con los límites de grupo y el saldo del fondo. Para organizaciones con 50 o más puestos, o con al menos un miembro de Enterprise Max, el panel de Insights agrega los usuarios activos mensuales y las consultas semanales a lo largo del tiempo. Para obtener más detalles, los registros de auditoría documentan la ejecución de tareas, el uso de conectores, el consumo de créditos y las asignaciones de créditos.
Para equipos que desarrollan sobre la API
- Asigna a cada herramienta o equipo su propia clave de API. Perplexity puede mostrar la facturación de cada clave por separado, y tener claves separadas deja claro qué herramienta está impulsando el uso.
- Revisa en la página de facturación qué tipo de token está aumentando. Ahí se muestran los tokens de entrada, de salida y de razonamiento a lo largo del tiempo. Si aumentan los tokens de entrada, normalmente significa que una herramienta está enviando más texto del necesario. Si aumentan los tokens de razonamiento, significa que las tareas se están ejecutando en modelos que analizan los problemas con detenimiento.
- Usa la Search API cuando una herramienta solo necesite resultados de búsqueda. Devuelve resultados web sin que un modelo redacte una respuesta, y cobra por solicitud sin cargos adicionales basados en tokens.
- Inicia las herramientas de agentes desde un ajuste preestablecido. Los ajustes preestablecidos de Perplexity adaptan el tamaño del modelo al tamaño de la tarea y mantienen las solicitudes sencillas alejadas de los modelos más caros
Trabajo con prioridad local
Parte del trabajo ni siquiera necesita un modelo de pago en la nube. Portable Computer es una versión del agente de Perplexity que se ejecuta en la propia computadora de una persona, con un modelo de IA almacenado en ese equipo. Como el modelo se ejecuta localmente, el trabajo rutinario no usa tokens de pago. Solo se conecta a la web, a las apps conectadas o a un modelo en la nube más potente cuando una tarea lo requiere, y antes le pide permiso al usuario.
Descubre cómo Perplexity Computer gestiona el trabajo de varios pasos en la web, los archivos y las herramientas conectadas.
Preguntas frecuentes
¿Cuál es la diferencia entre el gasto en tokens y los costos de IA?
El gasto en tokens mide cuánto trabajo de IA realiza un equipo, contabilizado en tokens. Los costos de IA abarcan todo lo que un equipo paga por usar IA, incluidas las suscripciones, los créditos adicionales y la configuración. El gasto en tokens determina la parte de esa factura que se basa en el uso.
¿Los usuarios con suscripción pagan por token?
Normalmente no de forma directa. Las herramientas de suscripción miden el uso en mensajes, consultas o créditos, y las tareas que usan más tokens los agotan más rápido. En Perplexity, las búsquedas normales no usan créditos en absoluto; solo las tareas de Computer los usan.
¿Por qué los agentes de IA usan tantos tokens?
Un agente completa una tarea en muchos pasos, y cada paso es una solicitud independiente que vuelve a leer el trabajo realizado hasta ese momento. Por eso, una tarea larga usa más tokens con cada paso que da.
¿Por qué el uso de tokens aumenta de repente?
La mayoría de los picos se producen tras un cambio en la forma de trabajar de un equipo, como un nuevo flujo de trabajo automatizado, una herramienta implementada para más personas o una tarea larga de un agente. Comparar la fecha del pico con los lanzamientos recientes normalmente revela la causa. Probar primero los nuevos flujos de trabajo con un grupo pequeño ayuda a prevenir los picos.