
La dégradation du contexte chez les agents d’IA : pourquoi les longues tâches perdent en précision et comment l’éviter
Un guide sur ce qui s’accumule dans le contexte d’un agent d’IA, pourquoi cela nuit à sa précision et comment configurer des tâches qui restent fiables.
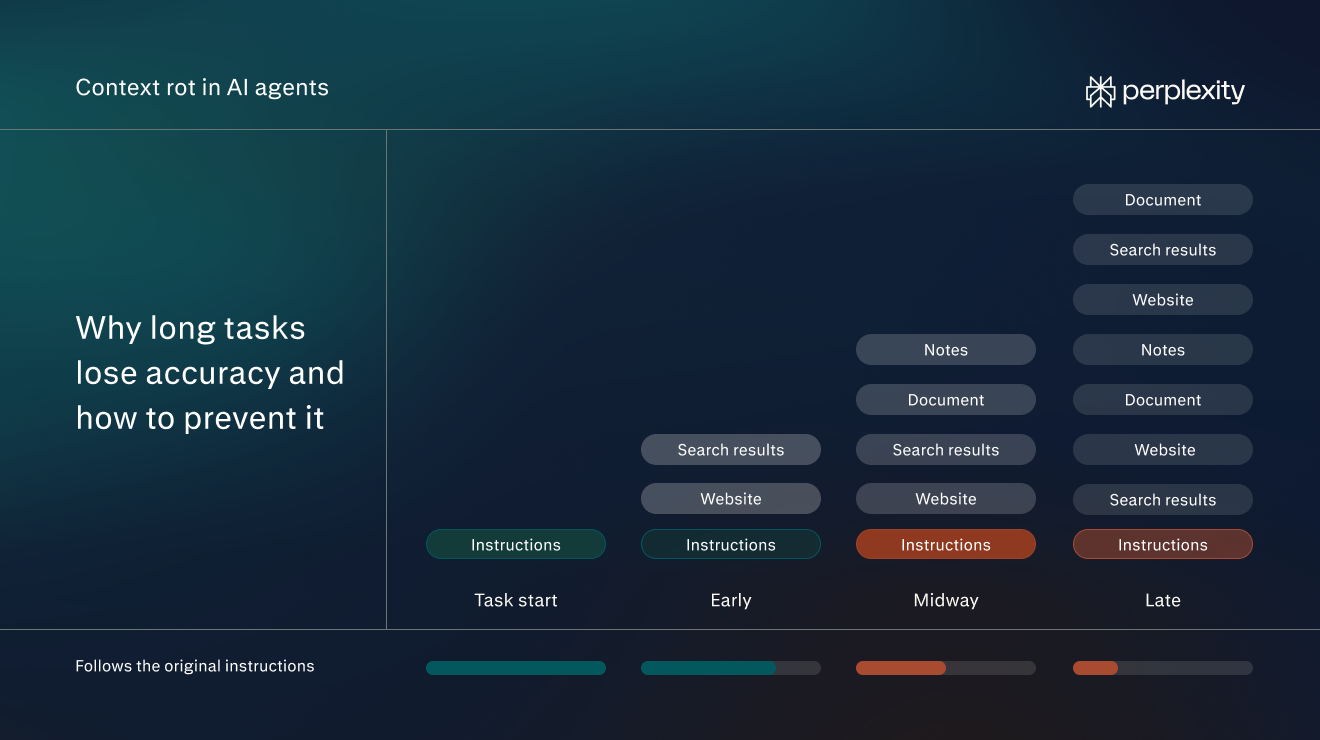
Ce que la dégradation du contexte signifie pour les agents d’IA
La dégradation du contexte (context rot) chez les agents d’IA est la perte graduelle de précision qui s’installe à mesure que le contexte d’un agent se remplit au cours d’une longue tâche.
Le contexte d’un agent correspond à l’information dont le modèle dispose pour sa prochaine étape. Il peut comprendre des instructions, des messages antérieurs, des résultats de recherche et du texte provenant de sites Web ou de fichiers. Au fil de son travail, l’agent peut y en ajouter davantage.
Par exemple, supposons que la tâche d’un agent consiste à trouver des fournisseurs qui livrent dans un délai de deux semaines. Au départ, son contexte ne contient que cette demande. À mi-parcours, le contexte comprendra aussi le texte de dizaines de sites Web de fournisseurs, plusieurs pages de résultats de recherche et des notes indiquant quels fournisseurs l’agent a déjà vérifiés.
La quantité de contexte qu’un modèle peut contenir est limitée (c’est ce qu’on appelle la fenêtre de contexte). Cette fenêtre se mesure en jetons, de petits fragments de texte qui correspondent généralement à un mot ou à une partie de mot. La dégradation du contexte s’accentue à mesure que le contexte grandit, c’est pourquoi elle survient le plus souvent dans les longues tâches comportant de nombreuses étapes.
À mesure que la dégradation du contexte s’aggrave, l’agent devient moins précis. Il peut suivre ses instructions initiales moins rigoureusement, négliger des détails ou confondre de l’information d’apparence semblable avec celle dont il a besoin.
Par exemple, l’agent pourrait commencer à inclure des fournisseurs dont le délai est de six semaines, même si on lui a demandé de trouver une livraison en deux semaines. L’instruction se trouve toujours dans son contexte, mais elle n’oriente plus les choix de l’agent.
La dégradation du contexte n’est pas la même chose que le simple manque d’espace dans la fenêtre de contexte. Lorsque le contexte d’une tâche dépasse la fenêtre, une partie du contenu est tronquée ou la tâche échoue. La dégradation du contexte commence bien avant ce point, alors que tout tient encore dans la fenêtre.
Elle diffère aussi de l’empoisonnement du contexte (lorsque de l’information trompeuse ou nuisible s’introduit dans le contexte de l’agent). Un agent qui dispose d’information exacte et complète peut tout de même subir une dégradation du contexte.
Pourquoi la dégradation du contexte se produit
La dégradation du contexte se produit parce que l’attention d’un modèle est limitée, même lorsque sa fenêtre de contexte a encore de la place. Dans les modèles d’IA, l’attention est le terme technique qui désigne la façon dont un modèle choisit les parties de son entrée sur lesquelles s’appuyer pour rédiger chaque mot d’une réponse. Toutes les parties du contexte se disputent cette attention. Plus il y a de texte, moins chaque partie reçoit d’attention.
Par exemple, Chroma a publié une étude sur l’effet de la longueur de l’entrée sur les modèles d’IA. Elle a testé 18 modèles d’Anthropic, d’OpenAI, de Google et d’Alibaba. Dans l’un des tests, les chercheurs ont caché une phrase contenant un conseil d’écriture dans un long recueil d’essais. Ils ont ensuite demandé au modèle quel était ce conseil.
Ils ont répété le test de nombreuses fois, en ajoutant chaque fois plus de texte d’essai. La phrase et la question n’ont jamais changé. Seule la quantité de texte qui les entourait variait.
Plus les modèles avaient de texte à lire, moins leurs résultats étaient bons. Ce constat s’est vérifié dans tous les tests du rapport. Les chercheurs prévoient que la baisse de précision serait encore plus importante dans un travail réel comportant de nombreuses étapes, comme la plupart des tâches d’agent.
Comment la dégradation du contexte peut affecter les agents d’IA
La dégradation du contexte se manifeste généralement de l’une des quatre façons suivantes :
Perdre de vue les instructions initiales
Le test le plus simple de Chroma demandait aux modèles de copier exactement une longue chaîne de mots répétés, dans laquelle un mot différent avait été inséré quelque part. C’était une tâche triviale, assortie d’une instruction explicite. Malgré tout, la performance a diminué chez tous les modèles à mesure que le texte s’allongeait. Certains modèles se sont même mis à produire des mots qui ne figuraient pas du tout dans l’entrée.
Dans une tâche d’agent, l’utilisateur fixe généralement des contraintes précises au début, comme un budget ou un format requis. L’agent pourrait les appliquer de façon moins constante à mesure que le contexte grandit. La cause est la longueur globale du contexte, et non l’endroit où se trouve l’instruction.
Des détails manqués au milieu d’une tâche
Les modèles d’IA utilisent l’information de la façon la plus fiable lorsqu’elle se trouve tout au début ou tout à la fin de leur entrée, selon une étude de Stanford publiée en 2023. Dans l’un des tests, les chercheurs ont fourni aux modèles un ensemble de 20 documents et posé une question à laquelle un seul de ces documents répondait. Lorsque ce document arrivait en premier ou en dernier, les modèles trouvaient généralement la réponse. Lorsqu’il se trouvait au milieu de l’ensemble, ils la manquaient beaucoup plus souvent. Les chercheurs appellent ce phénomène un effet de position.
Le même schéma s’applique aux agents. L’information trouvée plus tôt dans une tâche peut se retrouver au milieu d’une longue conversation, là où certains modèles ont plus de difficulté à l’utiliser. Dans l’exemple des fournisseurs, la liste finale pourrait omettre un bon fournisseur que l’agent a vérifié en cours de tâche.
Confondre des informations semblables
À mesure que le contexte grandit, les agents peuvent avoir plus de mal à reconnaître quelle information correspond à leurs instructions. Par exemple, supposons que l’utilisateur a demandé à l’agent de trouver des fournisseurs qui expédient « dans un délai de deux semaines ». Le site Web d’un fournisseur indique « livraison dans les 14 jours civils suivant la commande ». Dans une tâche courte, un agent remarquerait probablement que ces deux formulations veulent dire la même chose. Noyé parmi des dizaines d’autres pages de fournisseurs, il risque davantage de ne pas faire le lien.
L’agent pourrait aussi commencer à inclure des résultats qui ne sont pas pertinents. Supposons que l’agent cherche des fournisseurs de chaises de bureau. Le site Web d’un fournisseur promet une livraison en deux semaines, mais seulement pour ses bureaux. Ses chaises prennent six semaines. Le site utilise les mêmes mots que l’instruction, si bien que l’agent pourrait quand même ajouter ce fournisseur à sa liste. Les chercheurs appellent ce type d’information un distracteur. Elle semble pertinente sans l’être, et fait donc concurrence à l’information qui compte.
L’étude de Chroma a révélé que ces deux problèmes s’aggravaient à mesure que la quantité de texte environnant augmentait.
Des erreurs difficiles à repérer
La dégradation du contexte ne déclenche aucun message d’erreur. L’agent continue de travailler et remet un résultat qui semble terminé. Ses erreurs passent donc facilement inaperçues.
Dans les tests de Chroma, ces erreurs prenaient deux formes. Parfois, un modèle donnait avec assurance une réponse erronée. Dans l’exemple de recherche de fournisseurs, l’agent pourrait remettre une liste de fournisseurs soignée et bien formatée qui comprend un fournisseur dont il a mal lu les conditions de livraison.
D’autres fois, un modèle affirmait ne pas trouver une information qui s’y trouvait pourtant. Par exemple, l’agent pourrait remettre un rapport indiquant qu’aucun fournisseur ne respecte la limite de deux semaines, alors que plusieurs la respectent.
Comment configurer les tâches d’agent pour réduire la dégradation du contexte
Bien configurer les tâches permet de réduire au minimum l’effet de la dégradation du contexte et de garder l’agent aussi précis que possible tout au long de la tâche. Les pratiques exemplaires suivantes peuvent vous aider.
Rédigez la tâche comme un mandat
Un mandat clair limite la taille du contexte. L’agent sait quand il a terminé, alors il cesse de recueillir du contenu dès qu’il en a assez. Des exigences précises lui donnent aussi des critères concrets pour évaluer chaque page. Il lui est ainsi plus facile de repérer la bonne information.
Avant d’envoyer une tâche, vérifiez qu’elle couvre trois éléments :
- La tâche : ce que l’agent doit faire et produire, par exemple « trouver des fournisseurs et fournir une liste restreinte ».
- Les exigences : les faits que l’agent ne peut pas deviner, comme le budget, l’échéance, l’adresse de livraison et le destinataire du résultat.
- Le résultat : le format, la longueur et la structure, par exemple « un tableau indiquant le nom, le prix par chaise et le délai de livraison ».
Une fois assemblée, la requête pour la tâche des fournisseurs pourrait ressembler à ceci :
« Trouvez 10 fournisseurs capables de livrer 40 chaises de bureau à notre bureau de Chicago d’ici deux semaines, pour moins de 250 $ par chaise. Fournissez un tableau indiquant le nom du fournisseur, le prix par chaise, le délai de livraison et un lien vers la page du produit. La liste est destinée à notre gestionnaire de bureau, qui passera la commande. »
Gardez chaque tâche ciblée
Une tâche dotée d’un seul objectif clair garde le contexte restreint. Les longues tâches coûtent aussi plus cher. Chaque étape traite tout ce qui a été recueilli jusque-là, si bien qu’un contexte surchargé consomme plus de crédits à chaque étape.
Pour un projet comportant plusieurs volets, divisez-le :
- Dressez la liste des livrables distincts, par exemple une recherche de fournisseurs, une comparaison de prix et un courriel au fournisseur retenu.
- Exécutez chaque livrable comme une tâche distincte.
- Ne transmettez que le résultat final d’une tâche à la suivante. Par exemple, téléversez le tableau des fournisseurs sous forme de fichier pour lancer la tâche de comparaison, plutôt que de poursuivre dans le fil qui l’a produit.
La tâche de comparaison démarre alors avec un seul tableau plutôt qu’avec toutes les pages.
Dirigez l’agent vers les bonnes sources
Chaque page que l’agent lit s’ajoute à son contexte, y compris les menus, les publicités et le texte passe-partout qui entourent la partie utile. Fournir directement ses sources à l’agent réduit ce bruit.
Téléversez les fichiers dont la tâche dépend, comme la liste des fournisseurs approuvés, en les joignant à la requête. Lorsque l’agent doit faire des recherches sur le Web, nommez les sites qui valent la peine d’être consultés, par exemple deux répertoires de fournisseurs de confiance.
Connectez les outils où se trouve l’information. Par exemple, dans Perplexity Computer, ouvrez Connecteurs dans la barre latérale et activez les applications dont la tâche a besoin, comme Google Drive ou Slack. Mentionnez-les ensuite dans la requête : « Utilisez les spécifications des chaises qui se trouvent dans notre Google Drive. » Ne connectez que les applications pertinentes, puisque chaque connecteur occupe une partie du contexte de l’agent.
Si l’information se trouve dans une application qui ne figure pas dans la liste Connecteurs, il est peut-être quand même possible de la connecter. De nombreuses applications offrent un connecteur MCP (Model Context Protocol), une façon standard de brancher des outils d’IA à d’autres logiciels. Computer peut les utiliser en plus de ses connecteurs intégrés. Dans un compte d’entreprise, un administrateur devra peut-être d’abord les activer.
Demandez une vérification finale par rapport aux instructions
Terminez la requête par une étape de révision qui nomme les contraintes les plus importantes :
« Avant de terminer, vérifiez chaque fournisseur par rapport à ces exigences : livraison d’ici deux semaines, moins de 250 $ par chaise. Signalez ceux qui ne respectent pas ces exigences au lieu de les écarter. »
Les contraintes se trouvent toujours au début du contexte. L’étape de révision donne à l’agent une raison de comparer son résultat final aux contraintes, au lieu de compter sur les instructions pour conserver leur influence à chaque étape.
Par ailleurs, lui demander de signaler les problèmes plutôt que de simplement retirer ces résultats permet de repérer plus facilement les erreurs (comme le rejet d’un fournisseur qui promet une livraison dans les 14 jours civils parce qu’il n’utilise pas les mots « deux semaines »).
Révisez le travail à des points de contrôle
Pour les tâches plus longues, intégrez un point de contrôle à la requête :
« Commencez par trouver 20 fournisseurs potentiels, puis arrêtez-vous. Je confirmerai la liste avant que vous recueilliez les prix. »
Vérifiez la liste restreinte par rapport aux instructions initiales. Corrigez tout ce qui cloche dans un message de suivi, puis laissez l’agent continuer. Les erreurs repérées à ce stade ne se répercuteront pas sur toutes les étapes suivantes.
Lancez une nouvelle tâche quand une tâche déraille
Si l’agent répète la même erreur après des corrections, lancez une nouvelle tâche. Chaque correction ajoute du texte à un contexte déjà long. Créez plutôt une nouvelle tâche. Reformulez les instructions, téléversez tout bon résultat de la première tentative et recommencez.
Certains agents font automatiquement une version de cela, un processus appelé compaction. Lorsqu’une tâche s’allonge, l’agent remplace le contenu plus ancien, comme le texte intégral des pages lues au début, par un court résumé de ce qu’il a trouvé. Portable Computer de Perplexity compacte son contexte de cette façon, afin que le modèle reste dans les limites de ce qu’il peut bien gérer.
Il est aussi important de lancer une nouvelle tâche si l’objectif change. Un fil qui a commencé comme une recherche de fournisseurs ne devrait pas devenir aussi une révision de contrat.
Transformez les instructions répétées en Skill
Certaines instructions reviennent dans chaque tâche d’un certain type, comme un format de tableau préféré, une liste de fournisseurs à éviter ou une étape de révision standard. Dans Computer, elles peuvent être enregistrées sous forme de Skill, un ensemble réutilisable d’instructions que l’agent suit chaque fois. Un Skill intègre les autres pratiques exemplaires à chaque tâche qui l’utilise.
Pour en configurer un :
- Choisissez une tâche qui revient souvent, comme la recherche de fournisseurs.
- Notez les instructions que vous donnez chaque fois : le format, les vérifications, les sources à utiliser ou à éviter.
- Enregistrez-les sous forme de Skill. Les instructions déjà rédigées en Markdown peuvent être importées directement.
- Nommez le Skill dans vos prochaines requêtes : « Utilisez le Skill de recherche de fournisseurs pour trouver des fournisseurs de chaises pour le bureau de Denver. »
L’approche de Perplexity en matière de contexte dans le travail des agents
Perplexity Computer gère les longues tâches de façon à garder le contexte de chaque modèle restreint et pertinent. Trois éléments de sa conception limitent la quantité de texte qu’un modèle doit lire à la fois.
Répartir le travail entre des sous-agents
Computer divise une demande en tâches et en sous-tâches, puis crée des sous-agents pour les exécuter. Chaque sous-agent s’occupe d’une partie du travail dans son propre contexte. Dans la tâche des fournisseurs, un sous-agent pourrait se pencher sur les prix pendant qu’un autre vérifie les conditions de livraison. Aucun n’a besoin de lire tout ce que l’autre a lu.
Conserver le travail dans des fichiers
Chaque tâche Computer dispose de son propre espace de travail, avec ses propres fichiers, son navigateur Web et ses outils. L’agent peut enregistrer son travail dans un fichier, comme un tableau tenu à jour des fournisseurs qu’il a vérifiés. Il ne rouvre ensuite ce fichier que lorsqu’il en a besoin.
Sélectionner les passages pertinents des résultats de recherche
Les pages Web regorgent de contenu dont le modèle n’a pas besoin, comme des menus, des publicités, des métadonnées et du texte sur d’autres sujets. La compression du contexte en fonction de la requête élimine ce contenu. Avant qu’une page n’atteigne le modèle, Perplexity ne conserve que les phrases liées à la requête.
Explorez des conseils, des guides et des exemples de tâches pour Perplexity Computer afin de mettre ces étapes en pratique.
FAQ
La dégradation du contexte est-elle la même chose qu’une hallucination?
Non, mais les deux sont liées. Une hallucination est toute réponse qui affirme quelque chose de faux ou de non fondé. La dégradation du contexte est l’une des conditions qui rendent les hallucinations plus probables, tout comme d’autres erreurs telles que des instructions ignorées ou des détails manqués.
Une meilleure requête peut-elle corriger la dégradation du contexte?
Une requête claire réduit la dégradation du contexte en gardant la tâche ciblée. Elle ne peut toutefois pas empêcher le contexte de grandir. Dans une tâche suffisamment longue, l’agent finit quand même par recueillir plus d’information qu’il ne peut en utiliser efficacement. C’est pourquoi diviser le travail et le vérifier en cours de route compte autant que la requête elle-même.
La dégradation du contexte touche-t-elle aussi les clavardages ordinaires avec l’IA, et pas seulement les agents?
Oui. Dans un clavardage, le contexte est l’ensemble de la conversation jusqu’ici, y compris chaque message et tout document qui y a été collé ou téléversé. Un fil qui se poursuit depuis des heures sur plusieurs sujets peut produire les mêmes erreurs qu’une longue tâche d’agent. Lancer un nouveau fil pour chaque nouveau sujet permet de garder chaque conversation ciblée.
Combien de temps une tâche peut-elle durer avant que la dégradation du contexte ne s’installe?
Il n’y a pas de seuil fixe. Cela dépend du modèle et de la tâche. Par exemple, des modèles sur appareil dotés de fenêtres de contexte de 260 000 jetons commencent à éprouver des difficultés au-delà d’environ 100 000 jetons, bien en deçà de leur limite. Le déclin est aussi graduel plutôt que soudain.