
Comment suivre et contrôler la consommation de jetons de votre équipe
Comment les équipes peuvent voir leur utilisation de jetons dans les tableaux de bord et les rapports, quels types de travail d'IA consomment le plus de jetons et comment utiliser des contrôles pour la réduire.
Qu'est-ce que la consommation de jetons
La consommation de jetons correspond au nombre de jetons qu'une équipe utilise avec l'IA, et à ce que ces jetons coûtent. Un jeton est une unité de texte, comme un mot, une partie de mot ou un signe de ponctuation, qu'un modèle d'IA lit ou écrit. En anglais, 1 jeton équivaut à environ 4 caractères. Les jetons ne sont pas normalisés d'un modèle ou d'un fournisseur à l'autre : un même texte peut donc donner un nombre différent selon l'outil.
Les rapports d'utilisation répartissent généralement les jetons en quelques types :
- Les jetons d'entrée correspondent à tout ce que le modèle lit pour traiter une requête. Cela comprend la question posée, tout texte joint et l'historique de conversation que le modèle réutilise à partir des échanges précédents dans le même fil de discussion.
- Les jetons de sortie correspondent à la réponse rédigée par le modèle. Ils coûtent souvent plus cher que les jetons d'entrée. Selon la tarification de l'API de Perplexity, certains modèles facturent la sortie six fois plus cher.
- Les jetons de raisonnement correspondent au texte qu'un modèle génère en interne pour résoudre un problème avant de répondre. Ils n'apparaissent pas dans la réponse : une réponse visible plus longue ne signifie donc pas nécessairement qu'un modèle a utilisé plus de jetons au total.
Les équipes qui utilisent des outils d'IA par abonnement voient rarement une facturation par jeton. Les jetons influencent tout de même ce qu'elles obtiennent, puisque les tâches plus lourdes épuisent les crédits ou atteignent les limites d'utilisation plus rapidement. Les équipes qui créent leurs propres outils à partir d'un modèle d'IA paient plutôt au jeton, selon une tarification à l'usage.
Comment suivre la consommation de jetons
Suivre la consommation de jetons avec un forfait d'abonnement
Les outils par abonnement n'affichent généralement pas le nombre de jetons. Bon nombre de forfaits utilisent plutôt des crédits, des unités prépayées que le forfait déduit à mesure que le travail s'effectue. Les crédits ne sont pas l'équivalent des jetons, puisqu'un crédit peut couvrir du texte, des images ou d'autres types de travail. Toutefois, les tâches qui utilisent plus de jetons consomment généralement aussi plus de crédits; ceux-ci constituent donc le meilleur indicateur de la consommation de jetons dans le cadre d'un abonnement. Les utilisateurs peuvent suivre leur propre utilisation de crédits, et certains forfaits comprennent aussi un tableau de bord d'administration qui présente l'utilisation des crédits de toute l'équipe.
Dans Perplexity, par exemple, les recherches ordinaires n'utilisent pas de crédits. Seul Perplexity Computer, l'assistant qui gère les tâches en plusieurs étapes, en consomme. Les personnes qui utilisent Computer peuvent voir combien de crédits elles ont utilisés et à quoi ils ont servi. Chaque tâche Computer affiche aussi son propre total de crédits dans le menu « Utilisation » de sa conversation.
Avec les forfaits Enterprise, les administrateurs peuvent voir combien de personnes utilisent Perplexity et combien de requêtes elles effectuent chaque semaine dans le tableau de bord Insights (offert aux organisations comptant 50 postes ou plus, ou au moins un membre Enterprise Max).
Suivre la consommation de jetons dans les rapports d'utilisation de l'API
Les rapports d'utilisation du fournisseur d'API affichent directement le nombre de jetons, généralement réparti par type. La console API Platform de Perplexity, par exemple, permet aux utilisateurs de suivre des mesures comme la consommation de jetons d'entrée, de sortie et de raisonnement à la page Facturation.
Pourquoi la consommation de jetons augmente
Les agents exécutent de nombreuses étapes par tâche, et chaque étape constitue une requête distincte envoyée à un modèle. Une seule tâche peut ainsi totaliser des centaines de milliers, voire des millions de jetons.
Les modèles de raisonnement sont aussi de plus en plus courants. Un modèle de raisonnement rédige sa réflexion avant de répondre, et chaque mot de cette réflexion compte en jetons. Une même requête utilise donc généralement plus de jetons avec un modèle de raisonnement qu'avec un modèle standard, même si la réponse affichée à l'écran semble de la même longueur.
Enfin, à mesure que davantage de personnes et de flux de travail utilisent l'IA, l'utilisation des jetons s'accumule. Une partie de cette croissance provient aussi du tokenmaxxing, une pratique où des ingénieurs lancent des agents surtout pour gonfler leur nombre personnel de jetons et grimper dans les classements internes de consommation de jetons.
Comment réduire la consommation de jetons
La majeure partie d'une consommation élevée de jetons provient de quelques types de travail qui utilisent plus de jetons qu'il n'y paraît.
Longues conversations et tâches d'agent
Chaque fois qu'un modèle répond, il relit généralement toute la conversation jusque-là. Chaque nouvelle requête comprend tout l'historique de la conversation, en plus du message actuel de l'utilisateur. Ainsi, une courte question posée tard dans un long fil de discussion utilise plus de jetons que la même question posée dans un nouveau fil. Les tâches d'agent fonctionnent de la même façon, car chaque étape ajoute ses résultats à l'historique que l'étape suivante relit.
Ce qu'il faut faire
- Commencez une nouvelle conversation lorsque le sujet change. Ouvrez-la avec un résumé de deux ou trois lignes de tout ce dont le modèle a encore besoin dans l'ancien fil.
- Divisez les longues tâches d'agent en tâches plus petites. Exécutez chaque partie comme une tâche distincte et ne transmettez que les résultats dont la partie suivante a besoin.
- Vérifiez si les outils d'agent de l'équipe utilisent la compaction du contexte. La compaction résume automatiquement les parties plus anciennes d'une tâche pour que le modèle ait moins à relire. Si un outil l'offre comme paramètre, activez-la.
Les mêmes documents traités encore et encore
Lorsqu'une personne joint le même long fichier, comme un guide des politiques ou un catalogue de produits, à de nombreuses requêtes distinctes, le modèle lit le fichier en entier chaque fois. Chaque lecture compte comme des jetons d'entrée.
Ce qu'il faut faire
- Apprenez aux utilisateurs à copier la section pertinente d'un guide ou d'un catalogue dans la requête plutôt que de joindre le fichier en entier.
- Créez une version abrégée des documents que l'équipe utilise souvent. Un résumé d'une page d'une longue politique peut remplacer le document complet dans les requêtes courantes.
Nouvelles tentatives et boucles
Lorsqu'une réponse ne correspond pas à ce dont une personne avait besoin et qu'elle relance la tâche, chaque tentative consomme des jetons. Il en va de même lorsqu'un agent reste coincé à répéter la même étape.
Ce qu'il faut faire
- Précisez la tâche, le résultat attendu et les sources dès la première requête. Par exemple : « Résume les principales raisons pour lesquelles les clients ont annulé au T3, en cinq points, en utilisant uniquement les résultats du sondage joint. »
- Vérifiez les premières étapes d'une tâche d'agent. Si l'agent répète la même étape ou la même recherche, arrêtez-le et relancez-le avec une requête plus ciblée.
Grands modèles pour des tâches simples
Les modèles plus performants coûtent généralement plus cher par jeton; le travail courant, comme les résumés ou la mise en forme, peut donc épuiser le budget d'une équipe plus vite que nécessaire.
Ce qu'il faut faire
- Utilisez le routage de modèles, qui associe chaque tâche à un modèle capable de la traiter. Une courte réécriture ou un résumé peut être confié à un modèle plus petit et moins coûteux, tandis que le modèle le plus performant est réservé au raisonnement ou à l'analyse en plusieurs étapes. L'API de Perplexity adopte cette approche avec ses préréglages, qui attribuent un modèle plus petit à une recherche rapide et un modèle plus grand à une analyse exhaustive.
Pics après de nouveaux flux de travail
Un nouveau flux de travail automatisé, ou un outil déployé auprès de toute une équipe, peut faire grimper l'utilisation du jour au lendemain. Un pic n'est pas un problème en soi, mais il vaut la peine de savoir quel travail l'a causé.
Ce qu'il faut faire
- Testez d'abord les nouveaux flux de travail avec un petit groupe. Surveillez leur utilisation pendant une semaine ou deux avant de déployer le flux de travail auprès de toute l'équipe.
- Fixez un budget mensuel pour chaque équipe. Basez-le sur l'utilisation d'un mois typique, afin qu'une hausse soit facile à repérer.
- Désactivez la recharge automatique. Lorsqu'elle est désactivée, le travail s'arrête quand les crédits sont épuisés, au lieu que des crédits supplémentaires soient achetés automatiquement.
Comment optimiser la consommation de jetons dans Perplexity
Pour l'utilisation quotidienne
Computer utilise des crédits, mais ne s'exécute que lorsque vous le choisissez, que ce soit en sélectionnant l'icône Computer, en travaillant dans un projet configuré par défaut sur Computer ou en utilisant le mode Work de Comet.
Pour revenir à la recherche ordinaire, sélectionnez l'icône Perplexity afin de repasser en mode Ask. Pour voir l'utilisation des crédits, les utilisateurs peuvent ouvrir l'outil de suivi intégré à l'interface de Perplexity.
Les équipes qui travaillent dans des projets, les espaces de travail partagés de Perplexity, peuvent définir le mode par défaut de chaque projet sur Search ou Computer. Un projet surtout utilisé pour des recherches rapides peut être configuré par défaut sur Search, afin que personne ne lance une tâche Computer par accident.
Pour les administrateurs Enterprise
- Sachez ce que comprend chaque poste. Les utilisateurs Enterprise Pro reçoivent une allocation mensuelle de 500 crédits, et les utilisateurs Enterprise Max, 15 000 crédits. Ces crédits expirent à la fin de chaque cycle mensuel et ne sont pas reportés.
- Définissez d'abord une limite d'utilisation par défaut. Une limite d'utilisation plafonne le nombre de crédits supplémentaires qu'un membre peut puiser dans la réserve partagée une fois sa propre allocation épuisée.
- Créez des limites nommées pour différents types d'utilisateurs. Les administrateurs peuvent configurer des limites comme « Standard », « Utilisateur avancé » et « Contractuel », et les attribuer à des groupes d'utilisateurs ou à des membres individuels. Les groupes peuvent être créés dans Perplexity ou synchronisés à partir du fournisseur d'identité de l'entreprise. Si une personne appartient à plus d'un groupe, la limite la plus élevée s'applique.
- Utilisez des dérogations personnelles pour les exceptions. Lorsqu'une personne a besoin d'un plafond différent de celui de son groupe, une dérogation personnelle a préséance sur toute limite de groupe ou partagée. C'est utile pour un court projet nécessitant beaucoup de recherche, sans relever le plafond de toute une équipe.
- Plafonnez la recharge automatique. La recharge automatique réapprovisionne automatiquement la réserve partagée. Elle comprend une limite de recharge mensuelle configurable, de sorte que les dépenses ne peuvent pas augmenter sans maximum défini.
- Décidez comment les membres peuvent en demander plus. Le paramètre « Autoriser les membres à demander plus de crédits » permet aux personnes qui atteignent leur limite d'en demander davantage à un administrateur, plutôt que d'être bloquées d'emblée.
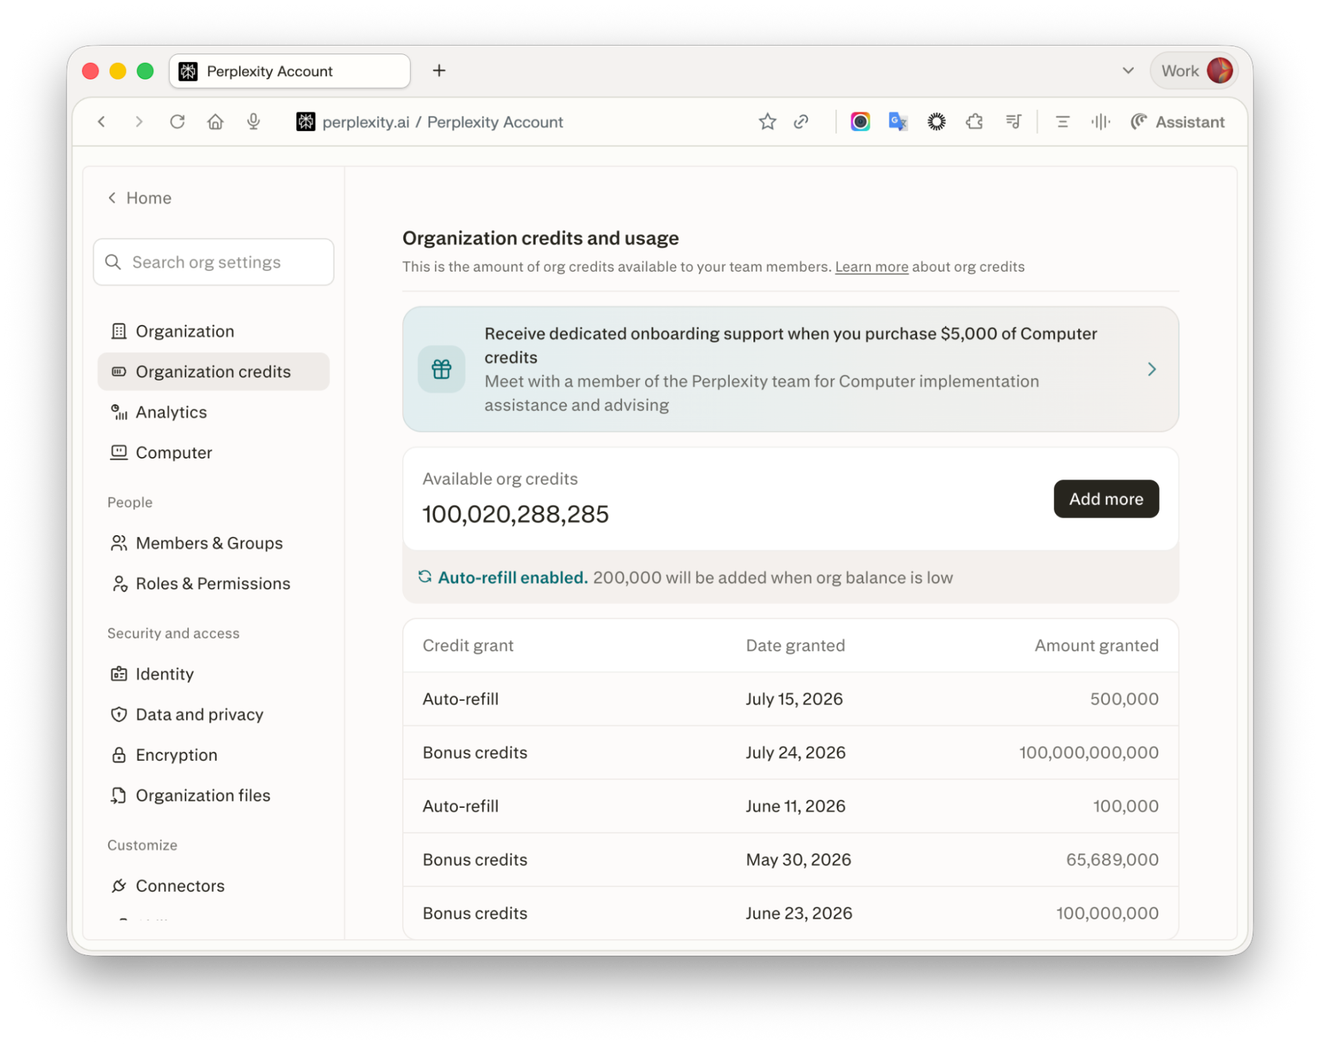
- Examinez l'utilisation chaque mois. La page Crédits de l'organisation présente les crédits accordés, utilisés et restants pour chaque membre, ainsi que les limites de groupe et le solde de la réserve. Pour les organisations comptant 50 postes ou plus, ou au moins un membre Enterprise Max, le tableau de bord Insights ajoute les utilisateurs actifs mensuels et les requêtes hebdomadaires au fil du temps. Pour plus de détails, les journaux d'audit consignent l'exécution des tâches, l'utilisation des connecteurs, la consommation de crédits et les octrois de crédits.
Pour les équipes qui développent avec l'API
- Attribuez à chaque outil ou équipe sa propre clé d'API. Perplexity peut afficher la facturation de chaque clé séparément, et des clés distinctes permettent de voir clairement quel outil génère l'utilisation.
- Consultez la page de facturation pour voir quel type de jeton augmente. Elle présente les jetons d'entrée, de sortie et de raisonnement au fil du temps. Une hausse des jetons d'entrée signifie généralement qu'un outil envoie plus de texte que nécessaire. Une hausse des jetons de raisonnement signifie que des tâches s'exécutent sur des modèles qui réfléchissent longuement aux problèmes.
- Utilisez l'API Search lorsqu'un outil n'a besoin que de résultats de recherche. Elle renvoie des résultats Web sans qu'un modèle rédige de réponse, et elle est facturée par requête, sans frais supplémentaires basés sur les jetons.
- Démarrez les outils d'agent à partir d'un préréglage. Les préréglages de Perplexity adaptent la taille du modèle à celle de la tâche et évitent d'envoyer les requêtes simples aux modèles les plus coûteux
Privilégier le travail local
Certains travaux n'ont pas du tout besoin d'un modèle infonuagique payant. Portable Computer est une version de l'agent de Perplexity qui s'exécute sur l'ordinateur même de la personne, à l'aide d'un modèle d'IA stocké sur cette machine. Comme le modèle s'exécute localement, le travail courant ne consomme pas de jetons payants. L'agent ne fait appel au Web, aux applications connectées ou à un modèle infonuagique plus puissant que lorsqu'une tâche l'exige, et il demande d'abord l'autorisation de l'utilisateur.
Découvrez comment Perplexity Computer gère le travail en plusieurs étapes sur le Web, dans les fichiers et avec les outils connectés.
FAQ
Quelle est la différence entre la consommation de jetons et les coûts de l'IA?
La consommation de jetons mesure la quantité de travail d'IA qu'une équipe effectue, comptée en jetons. Les coûts de l'IA englobent tout ce qu'une équipe paie pour utiliser l'IA, y compris les abonnements, les crédits supplémentaires et la mise en place. La consommation de jetons détermine la partie de cette facture qui est basée sur l'utilisation.
Les utilisateurs d'un abonnement paient-ils au jeton?
Généralement pas directement. Les outils par abonnement mesurent l'utilisation en messages, en requêtes ou en crédits, et les tâches qui utilisent plus de jetons les épuisent plus rapidement. Dans Perplexity, les recherches ordinaires n'utilisent aucun crédit; seules les tâches Computer en consomment.
Pourquoi les agents d'IA utilisent-ils autant de jetons?
Un agent accomplit une tâche en de nombreuses étapes, et chaque étape est une requête distincte qui relit le travail effectué jusque-là. Une longue tâche utilise donc plus de jetons à chaque étape franchie.
Pourquoi l'utilisation des jetons connaît-elle des pics soudains?
La plupart des pics font suite à un changement dans la façon de travailler d'une équipe, comme un nouveau flux de travail automatisé, un outil déployé auprès d'un plus grand nombre de personnes ou une longue tâche d'agent. Comparer la date du pic avec les lancements récents permet généralement d'en trouver la cause. Tester d'abord les nouveaux flux de travail avec un petit groupe aide à prévenir les pics.