
Mémoire de l'IA : ce que c'est, comment elle fonctionne et ce qu'elle stocke
Un guide de la mémoire de l'IA : comment les assistants IA enregistrent et rappellent des informations issues de conversations passées, ce qu'ils stockent, où la mémoire se trompe, et comment la consulter, la modifier ou la désactiver.
La mémoire de l’IA désigne les informations qu’un assistant IA conversationnel enregistre à partir de vos conversations passées et réutilise dans les nouvelles, afin de se souvenir de vos préférences et de votre contexte. Le modèle lui-même n’en conserve rien. L’assistant les stocke séparément et les réintègre lorsqu’elles sont pertinentes, ce qui donne au modèle un contexte persistant dont il serait autrement dépourvu.
Ce guide explique comment les assistants enregistrent et retrouvent ces informations, ce qu’ils stockent, pourquoi ils se trompent parfois, et comment les consulter, les modifier ou désactiver cette fonctionnalité.
Qu’est-ce que la mémoire de l’IA ?
La mémoire de l’IA, également appelée mémoire persistante, désigne une fonctionnalité des assistants IA qui stocke des informations vous concernant, comme vos préférences, des faits et le contexte de vos interactions passées, que l’assistant peut utiliser lors de conversations ultérieures.
Un assistant IA peut constituer ce dossier à partir de ce que vous lui demandez de retenir, des détails qu’il relève de lui-même et des conversations précédentes auxquelles il peut se référer.
La couche de mémoire de l’IA permet aux assistants IA de proposer des réponses personnalisées sans que vous ayez à indiquer vos préférences dans chaque chat. Si vous avez dit à un assistant que vous vous entraînez pour un marathon et que vous préférez les kilomètres, votre prochaine question sur l’allure recevra une réponse en kilomètres, sans que vous ayez à le préciser de nouveau.
Comparée à la répétition de votre situation dans chaque chat, la mémoire vous épargne de la saisie et garde le prompt court, ce qui est important, car les entrées longues rendent les réponses moins précises.
La mémoire n’est pas une transcription de chaque conversation, mais un ensemble de faits clés vous concernant. Elle retiendra donc que vous préférez les kilomètres. En revanche, retrouver le plan d’entraînement exact rédigé le mois dernier dépend de la capacité de l’assistant à consulter également vos conversations passées.
Types de mémoire de l’IA
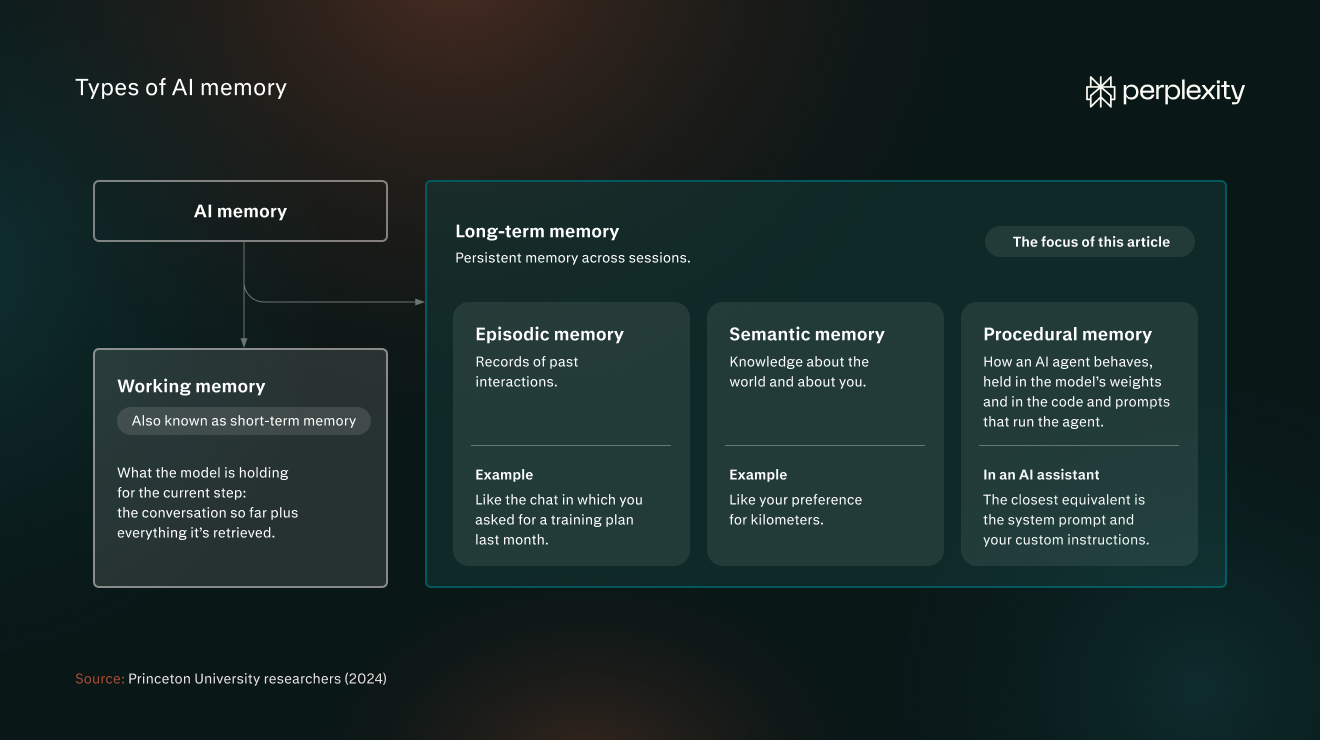
Des chercheurs de l’université de Princeton (2024) ont emprunté la terminologie des sciences de la mémoire humaine pour classer les types de systèmes de mémoire de l’IA. Leur cadre distingue la mémoire de travail de la mémoire à long terme :
- Mémoire de travail : Ce que le modèle garde en tête pour l’étape en cours, c’est-à-dire la conversation jusqu’ici ainsi que tout ce qu’il a récupéré. Également appelée mémoire à court terme.
- Mémoire à long terme : Mémoire persistante d’une session à l’autre. C’est le type de mémoire dont traite cet article.
La mémoire à long terme comprend trois types de mémoire :
- Mémoire épisodique : Enregistrements des interactions passées, comme le chat dans lequel vous avez demandé un plan d’entraînement le mois dernier.
- Mémoire sémantique : Connaissances sur le monde et sur vous, comme votre préférence pour les kilomètres.
- Mémoire procédurale : La manière dont un agent IA se comporte, intégrée aux poids du modèle ainsi qu’au code et aux prompts qui font fonctionner l’agent. Dans un assistant IA, l’équivalent le plus proche est le prompt système et vos instructions personnalisées.
Mémoire des assistants IA et mémoire des agents IA
La mémoire des assistants IA et celle des agents IA relèvent toutes deux de la mémoire à long terme. La mémoire des assistants IA est principalement sémantique et stocke des faits vous concernant, afin que les réponses vous correspondent. La mémoire des agents, comme Brain de Perplexity, stocke ce que l’agent a fait et comment cela s’est passé, y compris ce qui a fonctionné et ce que vous avez corrigé, afin qu’il aborde chaque nouvelle tâche dans de meilleures conditions.
Mémoire des assistants IA | Mémoire des agents IA | |
Ce qu’elle retient | Vous | La tâche et son historique |
À quoi elle sert | Des réponses qui vous correspondent | Poursuivre un travail en plusieurs étapes sans repartir de zéro |
Exemple | Retient que vous préférez les kilomètres | Retient votre plan d’entraînement pour le marathon, les ajustements qu’il y a apportés et les séances que vous avez effectuées jusqu’ici, afin de mieux planifier les prochains blocs |
Mémoire de l’IA, fenêtres de contexte, données d’entraînement et instructions personnalisées : quelles différences ?
On confond facilement la mémoire de l’IA avec trois autres éléments qui façonnent une réponse : la fenêtre de contexte du modèle, les données d’entraînement et les instructions personnalisées. Chacun contient des informations différentes, dure plus ou moins longtemps et est contrôlé par un système différent.
Une fenêtre de contexte correspond à la quantité de texte qu’un grand modèle de langage (LLM) peut lire en une seule fois ; elle couvre la conversation en cours. Elle est réinitialisée lorsque vous démarrez un nouveau chat.
Certains modèles actuels disposent de grandes fenêtres de contexte d’un million de tokens ou plus : techniquement, vous pourriez donc coller vos informations clés dans chaque conversation. Mais traiter l’ensemble de ces informations augmente la latence et le coût.
Plusieurs études ont également montré que la précision des résultats diminue à mesure que l’entrée s’allonge, même lorsque la réponse figure dans le contexte.
Une étude de l’université de l’Illinois et d’Amazon publiée en 2025 l’a observé même lorsque les modèles pouvaient restituer chaque détail pertinent : la précision chutait de 13,9 à 85 % à mesure que les entrées atteignaient 30 000 tokens, bien en deçà des limites annoncées des modèles. NoLiMa, un benchmark publié en 2025 par Adobe Research et la LMU de Munich, a constaté que 11 des 13 modèles testés obtenaient des performances nettement inférieures dès 32 000 tokens lorsque la question et la réponse ne partageaient aucun mot-clé. Le rapport de Chroma de juillet 2025 l’a observé sur 18 modèles, y compris lorsqu’ils répondaient à partir d’un historique de chat de 113 000 tokens.
Les données d’entraînement sont les informations intégrées aux poids du modèle avant sa sortie. Les utilisateurs ne peuvent pas les modifier. Les développeurs peuvent affiner un modèle sur de nouvelles données, mais il s’agit d’un processus d’ingénierie, et non d’un réglage utilisateur.
Les instructions personnalisées sont des règles enregistrées dans les paramètres de l’assistant, que vous rédigez et modifiez vous-même pour personnaliser le comportement et les réponses de l’assistant IA. Par exemple, vous pouvez utiliser des instructions personnalisées pour définir le ton et le style des réponses ou les sources que l’assistant peut utiliser.
Voici comment ces quatre éléments se comparent :
Fenêtre de contexte | Mémoire de l’IA | Données d’entraînement | Instructions personnalisées | |
Contenu | Les messages du chat en cours | Les faits et préférences enregistrés vous concernant | Ce que le modèle a appris avant sa sortie | Les consignes que vous rédigez vous-même |
Durée de conservation | Ce chat uniquement | Jusqu’à sa mise à jour ou sa suppression | Figées jusqu’à la sortie d’un nouveau modèle | Jusqu’à modification de votre part |
Qui en a le contrôle | Vous, dans la limite fixée par le fournisseur du modèle. | Vous et l’assistant | L’entreprise d’IA | Vous |
Exemple | La question sur l’allure que vous avez posée il y a une minute | Votre préférence pour les kilomètres | La structure générale des plans d’entraînement pour le marathon | Instruction de présenter les plans d’entraînement sous forme de grille, avec les semaines en lignes et les jours de la semaine en colonnes |
Ce que stocke la mémoire de l’IA
Les assistants conservent certains détails vous concernant, comme des faits, des préférences et des résumés, et certains s’appuient aussi sur vos conversations passées.
- Faits et préférences que vous lui demandez de retenir : Il s’agit de détails que vous demandez explicitement à l’assistant d’enregistrer, comme « retiens que je préfère les kilomètres ». L’assistant crée le souvenir à votre demande, et celui-ci est conservé jusqu’à ce que vous le supprimiez ou qu’une conversation ultérieure le mette à jour.
- Détails qu’il relève dans vos conversations : L’assistant les enregistre lorsque le paramètre est activé. Perplexity « privilégie la fréquence des questions posées et des informations fournies par l’utilisateur » : ce que vous mentionnez souvent a donc plus de chances d’être retenu que ce que vous ne mentionnez qu’une fois. Le souvenir est conservé jusqu’à sa mise à jour ou jusqu’à ce que vous le supprimiez.
- Références à vos conversations passées : L’assistant s’appuie directement sur vos conversations précédentes plutôt que sur une liste enregistrée. Perplexity appelle cela l’historique de recherche : vos questions et réponses passées, utilisées pour rendre une nouvelle réponse plus pertinente.
Comment fonctionne la mémoire de l’IA
Le modèle d’IA ne se souvient de rien d’une conversation à l’autre. C’est le système de mémoire de l’IA qui s’en charge : il conserve un dossier distinct vous concernant et ajoute les éléments pertinents à chaque nouvelle conversation. Le stockage et la récupération se font en coulisses, de sorte que le modèle lit ces éléments en même temps que votre question.
Ce processus se déroule en cinq étapes :
- Enregistrement : L’assistant enregistre un souvenir lorsque vous le lui demandez, ou lorsqu’il estime qu’un détail mérite d’être conservé.
- Stockage : Les souvenirs sont placés dans une base de données distincte du modèle. Dans de nombreux systèmes, il s’agit d’une base de données vectorielle, ce qui permet de les rechercher par leur sens. La liste que vous voyez dans les paramètres est une vue de cette base de souvenirs.
- Récupération : Lorsque vous envoyez un message, l’assistant détermine quels souvenirs s’appliquent. De nombreux systèmes procèdent en convertissant votre message et chaque souvenir en embeddings, des représentations numériques du sens, puis en sélectionnant les correspondances les plus proches. C’est ainsi qu’ils peuvent rappeler un souvenir même s’il n’a aucun mot en commun avec votre question. Les systèmes plus simples chargent tous les souvenirs enregistrés dans chaque conversation.
- Utilisation : Les souvenirs rappelés sont insérés en texte brut dans l’entrée, généralement dans un bloc d’instructions que le modèle lit avant votre message. Le modèle les traite comme n’importe quel autre texte de cette entrée.
- Mise à jour et suppression : L’assistant extrait des faits des conversations, recherche parmi les souvenirs existants et décide s’il faut les ajouter comme nouveaux, mettre à jour un souvenir existant, les fusionner avec l’un d’eux ou supprimer un ancien souvenir contredit par de nouvelles informations. Certains assistants horodatent chaque souvenir pour distinguer les informations récentes des plus anciennes.
Défis et risques de la mémoire de l’IA
La mémoire de l’IA vise à améliorer la qualité des réponses, mais les benchmarks montrent que la récupération des souvenirs ne fait pas toujours remonter des informations pertinentes ou à jour, en particulier dans les grandes bases de données. Elle présente également des risques en matière de sécurité et de confidentialité.
Parmi les problèmes de fiabilité et de sécurité courants liés à la mémoire de l’IA, on trouve :
- Souvenirs mal appliqués : Un souvenir peut être intégré à une réponse avec laquelle il n’a rien à voir. Une étude de 2026 a testé 18 modèles pour déterminer si un souvenir enregistré dans un domaine de la vie s’immisçait dans une réponse portant sur un autre. Le taux d’échec médian était de 53 %. L’étude a également montré que dès que la mémoire contenait les convictions des utilisateurs ou une expertise revendiquée, presque tous les modèles les reprenaient, même lorsque la question exigeait une réponse neutre.
- Souvenirs obsolètes : L’assistant continue de s’appuyer sur un détail alors qu’une conversation ultérieure l’a rendu inexact, surtout lorsque vous ne l’avez jamais dit explicitement. Dans un benchmark de mai 2026, qui évaluait si les modèles remarquent ces changements implicites, le meilleur modèle a obtenu une moyenne de 55,2 %.
- Surcharge de mémoire : Plus un assistant doit relire d’informations, plus il lui est difficile d’identifier ce qui compte. LongMemEval, un benchmark de 2024, a constaté que les modèles lisant un historique de conversation d’environ 115 000 tokens obtenaient des résultats inférieurs de 30 à 60 % à ceux des modèles recevant uniquement les sessions pertinentes.
- Empoisonnement de la mémoire : De fausses informations ou des instructions cachées s’introduisent dans la mémoire d’un assistant, par exemple via un contenu que vous lui demandez de lire, ce qui entraîne des réponses biaisées ou dangereuses, ou des fuites de données.
- Risques pour la confidentialité : La mémoire conserve des données personnelles au-delà de la conversation dont elles proviennent, parfois plus longtemps que vous ne le pensez. Perplexity, par exemple, peut conserver un journal des souvenirs supprimés jusqu’à 30 jours à des fins de sécurité et de débogage. La législation sur la protection des données considère les souvenirs stockés comme des données personnelles : vous devez donc pouvoir les consulter et les supprimer.
Comment consulter, modifier et désactiver la mémoire de l’IA
Vous pouvez voir ce qu’un assistant a enregistré, le supprimer, désactiver la mémoire ou utiliser une conversation privée qui ne crée pas de souvenirs.
La gestion de la mémoire se résume à quelques réglages. Voici ce que fait chacun d’eux et quand l’utiliser :
Réglage | Ce qu’il fait | Quand l’utiliser |
Voir ce qui est enregistré | Ouvre votre banque de mémoire, où vous pouvez rechercher, filtrer et examiner chaque entrée. | Lorsqu’une réponse contient un détail inattendu. |
Supprimer un souvenir | Supprime l’entrée, et l’assistant cesse de l’utiliser dans ses réponses ultérieures (les assistants peuvent conserver un journal des souvenirs effacés pendant un certain temps). | Lorsqu’un souvenir est erroné, obsolète ou sensible. |
Désactiver la mémoire | Empêche l’assistant de faire appel à la mémoire dans ses réponses futures (cela n’efface pas forcément les souvenirs déjà stockés ; vérifiez dans votre assistant). | Lorsque vous souhaitez des réponses sans personnalisation |
Désactiver l’historique de recherche | Empêche l’assistant d’utiliser vos questions et réponses passées. Supprimer une session de votre historique de recherche élimine son influence sur les réponses ultérieures. | Lorsque des conversations passées orientent les réponses, mieux vaut repartir de zéro. |
Utiliser un chat en navigation privée | La mémoire et l'historique de recherche y sont toujours désactivés, et les questions qui y sont posées ne sont jamais conservées ni utilisées dans la mémoire. | Pour les sujets ponctuels ou sensibles. |
Pour repartir de zéro, désactivez la mémoire et effacez ce qui est enregistré.
Comment Perplexity gère la mémoire
La mémoire de Perplexity fonctionne avec tous les modèles proposés.
Perplexity personnalise les réponses à partir de deux sources : les souvenirs, c'est-à-dire les préférences et les informations que vous partagez, et votre historique de recherche. Lorsqu'un souvenir influence une réponse, il apparaît parmi les sources de cette réponse : vous pouvez ainsi voir quels souvenirs ont été utilisés et supprimer n'importe lequel d'entre eux.
Vous pouvez aussi personnaliser vos réponses en fournissant des informations sur vous et en définissant des instructions personnalisées pour les projets (chaque projet dispose de sa propre couche de mémoire).
Perplexity peut utiliser le contenu de la mémoire pour améliorer ses modèles sur les comptes grand public (jamais sur les comptes Enterprise), sauf si vous désactivez cette option (Conservation des données d'IA dans Paramètres → Préférences → Intelligence artificielle).
Les abonnés Max et Enterprise Max bénéficient aussi de Brain, une couche de mémoire partagée qui enrichit la mémoire en suivant vos projets et votre travail. Brain dispose de son propre bouton d'activation et ignore les sessions en navigation privée.
Essayez Perplexity et découvrez comment les souvenirs façonnent votre prochaine réponse.
FAQ sur la mémoire de l'IA
Qu'est-ce que la mémoire limitée en IA ?
IBM définit l'IA à mémoire limitée comme une IA capable de se souvenir d'événements et de résultats passés et de surveiller des situations au fil du temps, mais incapable de conserver ces données dans une bibliothèque à long terme d'expériences passées. Il s'agit de l'une des quatre catégories d'une taxonomie des systèmes d'IA, dans laquelle IBM range les chatbots et les assistants virtuels.
La mémoire des assistants est une mémoire externe que ces systèmes ajoutent par-dessus. Elle persiste d'une session à l'autre, si bien qu'un assistant peut utiliser des informations que vous avez partagées lors d'une conversation précédente.
Quel assistant IA a la meilleure mémoire ?
Aucun assistant n'est le meilleur pour tout le monde. Une bonne mémoire est une mémoire que vous pouvez contrôler : évaluez donc les outils d'IA en vous posant quatre questions. Pouvez-vous voir ce qu'il a enregistré ? Pouvez-vous supprimer un souvenir indépendamment du chat dont il provient ? L'entraînement est-il un réglage distinct de la mémoire ? Existe-t-il un mode temporaire ou de navigation privée qui ne crée aucun souvenir ?
Un modèle d'IA apprend-il de ce qu'il retient sur vous ?
Utiliser la mémoire dans une réponse est un processus différent de l'entraînement. Perplexity indique récupérer le contexte pertinent dans votre mémoire enregistrée au lieu de traiter votre historique comme des données d'entraînement. La possibilité d'utiliser votre contenu pour améliorer les modèles relève d'un réglage distinct. Sur les comptes grand public, Perplexity peut utiliser le contenu de la mémoire à cette fin, et l'option Conservation des données d'IA permet de le désactiver.
Que faut-il éviter de confier à la mémoire de l'IA ?
Évitez de confier à la mémoire de l'IA tout ce que vous ne voudriez pas voir stocké, utilisé pour établir votre profil ou répété plus tard : informations d'identité et financières, données de santé, mots de passe, informations sur d'autres personnes et tout ce qui concerne des enfants. Le Commissariat à la protection de la vie privée du Canada (mai 2025) et le National Cyber Security Centre du Royaume-Uni (mars 2023) recommandent de renoncer à toute requête qui poserait problème si elle devenait publique.
Les filtres réduisent les risques pour la confidentialité, mais ne garantissent pas que vos informations de santé ou financières ne seront jamais stockées : passez donc en revue votre banque de mémoire et utilisez la navigation privée pour les questions sensibles ponctuelles.