
Memoria da IA: que é, como funciona e que almacena
Unha guía sobre a memoria da IA: como os asistentes de IA gardan e lembran detalles de conversas anteriores, que almacenan, onde falla a memoria e como vela, editala ou desactivala.
A memoria da IA é a información que un asistente de IA conversacional garda das túas conversas anteriores e incorpora ás novas, para poder lembrar as túas preferencias e o teu contexto. O propio modelo non conserva nada diso. O asistente almacénaa por separado e volve engadila cando é relevante, o que lle dá ao modelo un contexto persistente que doutro xeito non tería.
Esta guía explica como os asistentes gardan e recuperan esa información, que almacenan, por que ás veces se equivocan e como vela, cambiala ou desactivala.
Que é a memoria da IA?
A memoria da IA, tamén chamada memoria persistente, é unha función dos asistentes de IA que almacena información sobre ti, como preferencias, datos e contexto de interaccións anteriores, que o asistente pode usar en conversas posteriores.
Un asistente de IA pode crear ese rexistro a partir das cousas que lle pides que lembre, dos detalles que capta pola súa conta e de chats anteriores aos que pode remitirse.
A capa de memoria da IA permite que os asistentes de IA ofrezan respostas personalizadas sen que teñas que compartir as túas preferencias en cada chat. Se lle dixeches a un asistente que estás adestrando para un maratón e que prefires os quilómetros, a túa seguinte pregunta sobre o ritmo recibirá unha resposta en quilómetros sen que teñas que repetilo.
En comparación con volver explicar a túa situación en cada chat, a memoria afórrache escribir e mantén o prompt curto, algo importante porque as entradas longas fan que as respostas sexan menos precisas.
A memoria non é unha transcrición de cada conversa, senón unha colección de datos clave sobre ti. Así, lembrará que prefires os quilómetros. Atopar o plan de adestramento exacto que redactou o mes pasado depende de se o asistente tamén pode consultar chats anteriores.
Tipos de memoria da IA
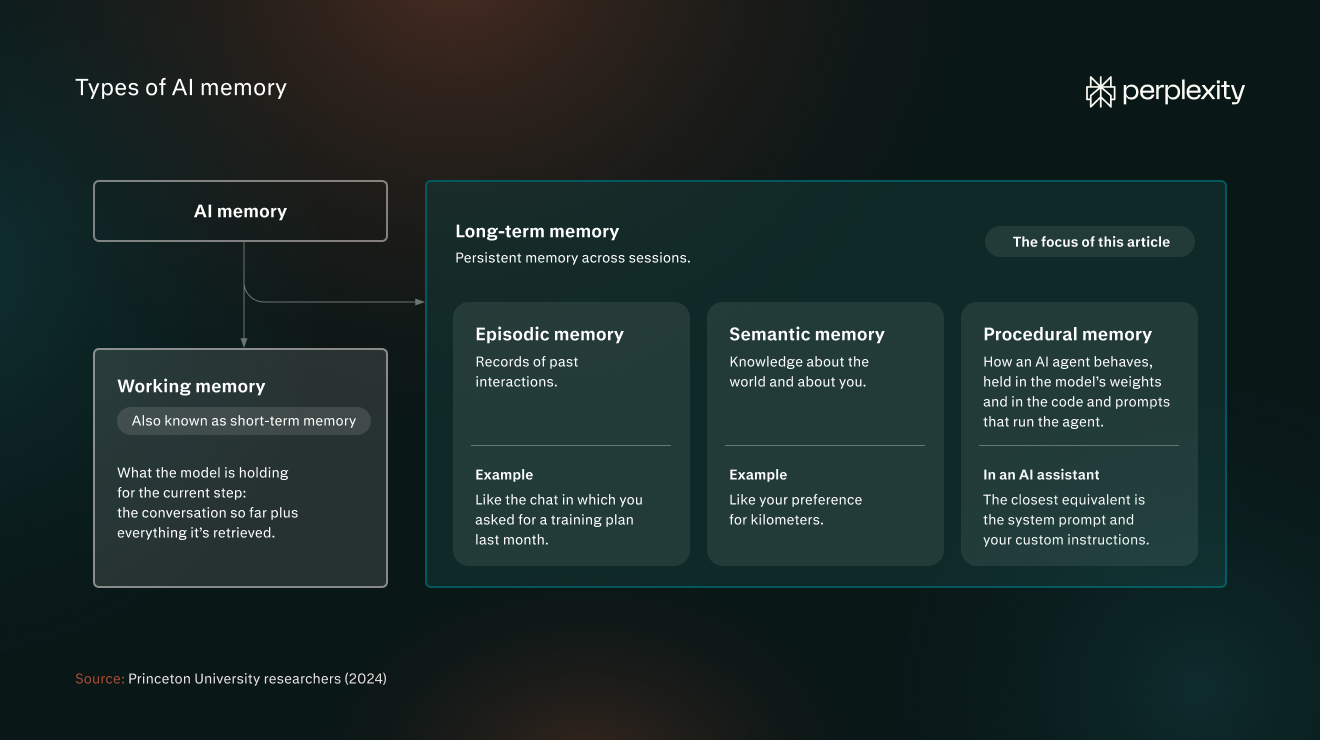
Investigadores da Universidade de Princeton (2024) tomaron prestada terminoloxía da ciencia da memoria humana para clasificar os tipos de sistemas de memoria da IA. O seu marco distingue a memoria de traballo da memoria a longo prazo:
- Memoria de traballo: O que o modelo ten presente para o paso actual, é dicir, a conversa ata o momento máis todo o que recuperou. Tamén se coñece como memoria a curto prazo.
- Memoria a longo prazo: Memoria persistente entre sesións. Este é o tipo de memoria do que trata este artigo.
A memoria a longo prazo consta de tres tipos de memoria:
- Memoria episódica: Rexistros de interaccións anteriores, como o chat no que pediches un plan de adestramento o mes pasado.
- Memoria semántica: Coñecemento sobre o mundo e sobre ti, como a preferencia polos quilómetros.
- Memoria procedemental: Como se comporta un axente de IA, integrado nos pesos do modelo e no código e os prompts que executan o axente. Nun asistente de IA, o equivalente máis próximo é o prompt do sistema e as túas instrucións personalizadas.
Memoria do asistente de IA fronte á memoria do axente de IA
A memoria do asistente de IA e a memoria do axente de IA son ambas memoria a longo prazo. A memoria do asistente de IA é principalmente memoria semántica e almacena datos sobre ti, para que as respostas se axusten a ti. A memoria do axente, como Brain de Perplexity, almacena o que fixo o axente e como lle foi, incluído o que funcionou e o que corrixiches, para que comece cada nova tarefa desde unha posición mellor.
Memoria do asistente de IA | Memoria do axente de IA | |
Que lembra | A ti | A tarefa e o seu historial |
Para que serve | Respostas que se axustan a ti | Continuar traballos de varios pasos sen comezar de novo |
Exemplo | Lembra que prefires os quilómetros | Lembra o teu plan de adestramento para o maratón, os axustes que fixo e as sesións que completaches ata agora, para poder planificar mellor os bloques futuros |
Memoria da IA fronte a xanelas de contexto, datos de adestramento e instrucións personalizadas
É doado confundir a memoria da IA con outras tres cousas que inflúen nunha resposta: a xanela de contexto do modelo, os datos de adestramento e as instrucións personalizadas. Cada unha contén información diferente, dura un tempo distinto e contrólaa un sistema diferente.
Unha xanela de contexto é a cantidade de texto que un modelo de linguaxe de grande tamaño (LLM) pode ler dunha vez e abrangue a conversa actual. Restablécese cando inicias un chat novo.
Algúns modelos actuais teñen xanelas de contexto grandes, dun millón de tokens ou máis, así que tecnicamente poderías pegar a túa información clave en cada conversa. Pero procesala toda engade latencia e custo.
Varios estudos tamén descubriron que a precisión da saída diminúe a medida que medra a entrada, mesmo cando a resposta está no contexto.
Un estudo da Universidade de Illinois e Amazon de 2025 observouno mesmo cando os modelos podían recitar todos os detalles relevantes: a precisión caeu entre un 13,9 % e un 85 % a medida que as entradas medraron ata os 30.000 tokens, moi por debaixo dos límites declarados dos modelos. NoLiMa, un benchmark de 2025 de Adobe Research e da LMU de Múnic, descubriu que 11 dos 13 modelos probados tiñan un rendemento significativamente peor con só 32.000 tokens sempre que a pregunta e a resposta non compartían palabras clave. O informe de Chroma de xullo de 2025 observouno en 18 modelos, mesmo cando respondían a partir dun historial de chat de 113.000 tokens.
Os datos de adestramento son a información integrada nos pesos do modelo antes do seu lanzamento. Os usuarios non poden cambialos. Os desenvolvedores poden axustar un modelo con datos novos mediante fine-tuning, pero iso é un proceso de enxeñaría, non unha opción de configuración do usuario,
As instrucións personalizadas son regras gardadas na configuración do asistente que ti mesmo escribes e editas para personalizar o comportamento e as respostas do asistente de IA. Por exemplo, poderías usar instrucións personalizadas para definir o ton e o estilo das respostas ou que fontes pode usar o asistente.
Esta é a comparación entre os catro:
Xanela de contexto | Memoria da IA | Datos de adestramento | Instrucións personalizadas | |
Que contén | As mensaxes do chat actual | Datos e preferencias gardados sobre ti | O que aprendeu o modelo antes do seu lanzamento | Indicacións que escribes ti mesmo |
Canto dura | Só este chat | Ata que se actualiza ou se elimina | Fixos ata que se lanza un modelo novo | Ata que as editas |
Quen o controla | Ti, dentro do límite que establece o provedor do modelo. | Ti e o asistente | A empresa de IA | Ti |
Exemplo | A pregunta sobre o ritmo que fixeches hai un minuto | Que prefires os quilómetros | Como se estruturan xeralmente os plans de adestramento para maratóns | Instrución para dar formato aos plans de adestramento nunha grade na que as filas representan semanas e as columnas, días da semana |
Que almacena a memoria da IA
Os asistentes conservan detalles seleccionados sobre ti, como datos, preferencias e resumos, e algúns tamén recorren aos teus chats anteriores.
- Datos e preferencias que lle pides que lembre: Son detalles que lle indicas explicitamente ao asistente que garde, como «lembra que prefiro os quilómetros». O asistente crea a memoria cando llo pides e dura ata que a eliminas ou ata que unha conversa posterior a actualiza.
- Detalles que capta das túas conversas: O asistente gárdaos cando a opción está activada. Perplexity «favorece a frecuencia das preguntas feitas e da información proporcionada polo usuario», así que é máis probable que se garde algo que mencionas a miúdo que algo que mencionas unha soa vez. A memoria dura ata que se actualiza ou a eliminas.
- Referencias aos teus chats anteriores: O asistente recorre directamente a conversas anteriores en lugar dunha lista gardada. Perplexity chámalle a isto historial de buscas: as túas preguntas e respostas anteriores, que se usan para que unha nova resposta sexa máis relevante.
Como funciona a memoria da IA
O modelo de IA non lembra nada entre conversas. Ese traballo faino o sistema de memoria da IA: garda un rexistro separado sobre ti e engade as partes relevantes a cada nova conversa. O almacenamento e a recuperación ocorren en segundo plano, de modo que o modelo le esa información xunto coa túa pregunta.
Ese proceso desenvólvese en cinco pasos:
- Gardado: O asistente garda unha memoria cando llo pides ou cando considera que un detalle paga a pena conservar.
- Almacenamento: As memorias van a unha base de datos separada do modelo. En moitos sistemas é unha base de datos vectorial, para que se poidan buscar polo seu significado. A lista que ves na configuración é unha vista dese almacén de memoria.
- Recuperación: Cando envías unha mensaxe, o asistente decide que memorias se aplican. Moitos sistemas fano convertendo a túa mensaxe e cada memoria en embeddings, representacións numéricas do significado, e escollendo as coincidencias máis próximas. Así poden lembrar unha memoria mesmo cando non comparte ningunha palabra coa túa pregunta. Os sistemas máis sinxelos cargan todas as memorias gardadas en cada conversa.
- Uso: As memorias recuperadas insírense como texto simple na entrada, normalmente nun bloque de instrucións que o modelo le antes da túa mensaxe. O modelo procésaas como calquera outro texto desa entrada.
- Actualización e eliminación: O asistente extrae datos dos chats, busca nas memorias existentes e decide se engadilos como novos, actualizar unha memoria existente, combinalos con outra ou eliminar unha memoria antiga que contradí a nova información. Algúns asistentes engaden unha marca de tempo a cada memoria para distinguir a información máis recente da máis antiga.
Desafíos e riscos da memoria da IA
A memoria da IA pretende mellorar a calidade das respostas, pero os benchmarks mostran que a recuperación de memoria non sempre achega información relevante ou actual, especialmente en bases de datos grandes. Tamén supón riscos de seguranza e privacidade.
Entre os problemas habituais de fiabilidade e seguranza relacionados coa memoria da IA están:
- Memorias mal aplicadas: Unha memoria pode acabar nunha resposta coa que non ten nada que ver. Un estudo de 2026 probou 18 modelos para ver se unha memoria gardada dun ámbito da vida se filtraba nunha resposta sobre outro. A taxa de fallos mediana foi do 53 %. O estudo tamén descubriu que, unha vez que a memoria contiña as crenzas dos usuarios ou a súa suposta experiencia, case todos os modelos as repetían aínda que a pregunta requirise unha resposta neutra.
- Memorias desactualizadas: O asistente segue actuando segundo un detalle despois de que unha conversa posterior o volvese falso, sobre todo cando nunca o dixeches abertamente. Nun benchmark de maio de 2026, que avaliaba se os modelos detectan eses cambios implícitos, o mellor modelo obtivo unha media do 55,2 %.
- Sobrecarga de memoria: Canto máis ten que reler un asistente, máis lle custa identificar o que importa. LongMemEval, un benchmark de 2024, descubriu que os modelos que lían un historial de chat de arredor de 115.000 tokens tiñan un rendemento entre un 30 % e un 60 % peor que os modelos aos que só se lles daban as sesións relevantes.
- Envelenamento da memoria: Información falsa ou instrucións ocultas chegan á memoria dun asistente, por exemplo, a través de contido que lle pides que lea, o que dá lugar a respostas nesgadas ou inseguras, ou a fugas de datos.
- Riscos para a privacidade: A memoria conserva datos persoais máis alá do chat do que proceden, ás veces durante máis tempo do que esperas. Perplexity, por exemplo, pode conservar un rexistro das memorias eliminadas durante ata 30 días por motivos de seguranza e depuración. A lexislación de protección de datos considera as memorias almacenadas como datos persoais, polo que deberías poder revisalas e eliminalas.
Como ver, editar e desactivar a memoria da IA
Podes ver o que gardou un asistente, eliminalo, desactivar a memoria ou usar un chat privado que non crea memorias.
A xestión da memoria redúcese a uns poucos controis. Isto é o que fai cada un e cando usalo:
Control | Que fai | Cando usalo |
Ver o que está gardado | Abre o teu banco de memoria, onde podes buscar, filtrar e revisar entradas individuais. | Cando unha resposta inclúe un detalle que non esperabas. |
Eliminar unha memoria | Elimina a entrada e o asistente deixa de usala en respostas posteriores (os asistentes poden conservar un rexistro das memorias borradas durante un tempo). | Cando unha memoria é incorrecta, está desactualizada ou é sensible. |
Desactivar a memoria | Fai que o asistente deixe de consultar a memoria en respostas futuras (Pode que non borre as memorias xa almacenadas: compróbao no teu asistente). | Cando queres respostas sen personalización |
Desactivar o historial de buscas | Fai que o asistente deixe de usar as túas preguntas e respostas anteriores. Eliminar unha sesión do teu historial de buscas elimina a súa influencia nas respostas posteriores. | Cando as conversas anteriores condicionan as respostas, convén comezar de cero. |
Usa un chat en modo incógnito | A memoria e o historial de buscas están sempre desactivados, e as preguntas que se fan alí nunca se conservan nin se usan na memoria. | Para temas puntuais ou delicados. |
Para comezar de cero, desactiva a memoria e borra o que estea gardado.
Como xestiona Perplexity a memoria
A memoria de Perplexity funciona con todos os modelos que ofrece.
Perplexity personaliza as respostas a partir de dúas fontes: as memorias, que son as preferencias e os detalles que compartes, e o teu historial de buscas. Cando unha memoria inflúe nunha resposta, aparece entre as fontes desa resposta, para que poidas ver que memorias se usaron e eliminar calquera delas.
Tamén podes personalizar as túas respostas proporcionando detalles sobre ti e instrucións personalizadas para os Proxectos (cada Proxecto ten a súa propia capa de memoria).
Perplexity pode usar o contido da memoria para mellorar os seus modelos nas contas de consumidor (nunca nas de Enterprise), a menos que o desactives (Retención de datos de IA en Configuración → Preferencias → Intelixencia artificial).
Os subscritores de Max e Enterprise Max tamén teñen Brain, unha capa de memoria compartida que amplía a memoria facendo un seguimento dos teus proxectos e do teu traballo. Ten o seu propio interruptor e ignora as sesións de incógnito.
Proba Perplexity e comproba como as memorias inflúen na túa próxima resposta.
Preguntas frecuentes sobre a memoria da IA
Que é a memoria limitada na IA?
IBM define a IA de memoria limitada como a IA que pode lembrar eventos e resultados pasados e supervisar situacións ao longo do tempo, pero non pode conservar eses datos nunha biblioteca a longo prazo de experiencias pasadas. É unha das catro categorías dunha taxonomía de sistemas de IA, e IBM inclúe nela os chatbots e os asistentes virtuais.
A memoria do asistente é unha memoria externa que eses sistemas engaden por riba. Persiste entre sesións, polo que un asistente pode usar detalles que compartiches nunha conversa anterior.
Que asistente de IA ten a mellor memoria?
Ningún asistente é o mellor para todo o mundo. Unha boa memoria é aquela que podes controlar, así que avalía as ferramentas de IA facendo catro preguntas: Podes ver o que gardou? Podes eliminar unha memoria por separado do chat do que procede? O adestramento é unha opción separada da memoria? Hai un modo temporal ou de incógnito que non cree memorias?
Un modelo de IA aprende do que lembra sobre ti?
Usar a memoria nunha resposta é un proceso diferente do adestramento. Perplexity afirma que recupera o contexto relevante do teu almacén de memoria en lugar de tratar o teu historial como datos de adestramento. Se o teu contido se pode usar para mellorar os modelos é unha opción aparte. Nas contas de consumidor, Perplexity pode usar o contido da memoria con ese fin, e Retención de datos de IA desactívao.
Que deberías manter fóra da memoria da IA?
Mantén fóra da memoria da IA todo o que non queiras que se garde, que se use para elaborar o teu perfil ou que se repita máis tarde: datos de identidade e financeiros, información de saúde, contrasinais, información doutras persoas e calquera cousa relacionada con nenos. A Oficina do Comisionado de Privacidade do Canadá (maio de 2025) e o Centro Nacional de Ciberseguridade do Reino Unido (marzo de 2023) recomendan evitar calquera indicación que puidese causar problemas se se fixese pública.
Os filtros reducen os riscos de privacidade, pero non garanten que a túa información de saúde ou financeira non se garde en absoluto, así que revisa o teu banco de memoria e usa o modo incógnito para preguntas delicadas puntuais.