
Como facer o seguimento e controlar o gasto en tokens do equipo
Como poden os equipos ver o seu uso de tokens en paneis e informes, que tipos de traballo con IA usan máis tokens e como usar controis para reducilo.
Que é o gasto en tokens
O gasto en tokens é o número de tokens que consome un equipo coa IA e o que custan eses tokens. Un token é unha unidade de texto, como unha palabra, parte dunha palabra ou un signo de puntuación, que un modelo de IA le ou escribe. En inglés, 1 token equivale aproximadamente a 4 caracteres. Os tokens non están estandarizados entre modelos nin provedores, polo que o mesmo texto pode dar un reconto diferente en distintas ferramentas.
Os informes de uso adoitan dividir os tokens en varios tipos:
- Os tokens de entrada son todo o que le o modelo nunha solicitude. Iso inclúe a consulta, calquera texto anexo e o historial da conversa que o modelo reutiliza de mensaxes anteriores do mesmo fío.
- Os tokens de saída son a resposta que escribe o modelo. Adoitan custar máis que os tokens de entrada. Nos prezos da API de Perplexity, algúns modelos cobran seis veces máis pola saída.
- Os tokens de razoamento son o texto que un modelo xera internamente para resolver un problema antes de responder. Non aparecen na resposta, polo que unha resposta visible máis longa non significa necesariamente que un modelo usase máis tokens en total.
Os equipos que usan ferramentas de IA mediante subscrición poucas veces ven un cargo por token. Aínda así, os tokens condicionan o que obteñen, xa que as tarefas máis pesadas gastan créditos ou alcanzan os límites de uso antes. Os equipos que crean as súas propias ferramentas sobre un modelo de IA adoitan pagar por token, cun modelo de prezos baseado no uso.
Como facer o seguimento do gasto en tokens
Seguimento do gasto en tokens nun plan de subscrición
As ferramentas de subscrición non adoitan mostrar o reconto de tokens. En vez diso, moitos plans usan créditos, unidades prepagadas que o plan vai descontando á medida que se fai o traballo. Os créditos non son o mesmo que os tokens, xa que un crédito pode cubrir texto, imaxes ou outro traballo. Pero as tarefas que usan máis tokens adoitan usar tamén máis créditos, así que son a mellor guía do gasto en tokens nunha subscrición. Os usuarios poden facer o seguimento do seu propio uso de créditos, e algúns plans tamén inclúen un panel de administración que mostra o uso de créditos de todo o equipo.
En Perplexity, por exemplo, as buscas normais non usan créditos. Só os usa Perplexity Computer, o asistente que se encarga das tarefas de varios pasos. Quen usa Computer pode ver cantos créditos usou e en que os usou. Cada tarefa de Computer tamén mostra o seu propio total de créditos no menú «Uso» da súa conversa.
Nos plans Enterprise, os administradores poden ver cantas persoas usan Perplexity e cantas consultas fan cada semana no panel de Insights (dispoñible para organizacións con 50 postos ou máis, ou con polo menos un membro de Enterprise Max).
Seguimento do gasto en tokens nos informes de uso da API
Os informes de uso do provedor da API mostran directamente o reconto de tokens, normalmente dividido por tipo de token. A consola da API Platform de Perplexity, por exemplo, permite aos usuarios seguir métricas como o gasto en tokens de entrada, de saída e de razoamento na páxina de facturación.
Por que está a medrar o gasto en tokens
Os axentes executan moitos pasos por tarefa, e cada paso é unha solicitude independente a un modelo. Unha soa tarefa pode chegar a sumar centos de miles ou mesmo millóns de tokens.
Os modelos de razoamento tamén son cada vez máis habituais. Un modelo de razoamento escribe o seu razoamento antes de responder, e cada palabra diso conta como tokens. Por iso, a mesma solicitude adoita usar máis tokens nun modelo de razoamento que nun estándar, aínda que a resposta en pantalla pareza da mesma lonxitude.
Por último, á medida que máis persoas e fluxos de traballo usan a IA en xeral, o uso de tokens vaise acumulando. Parte dese crecemento tamén procede do tokenmaxxing, a práctica pola que os enxeñeiros executan axentes principalmente para aumentar o seu reconto persoal de tokens e subir posicións nas clasificacións internas de tokens.
Como reducir o gasto en tokens
A maior parte do gasto elevado en tokens procede duns poucos tipos de traballo que usan máis tokens do que parece.
Conversas longas e tarefas de axentes
Cada vez que un modelo responde, adoita reler toda a conversa ata ese momento. Cada nova solicitude inclúe todo o historial anterior da conversa máis a mensaxe actual do usuario. Por iso, unha pregunta curta ao final dun fío longo usa máis tokens que a mesma pregunta nun fío novo. As tarefas de axentes funcionan igual, porque cada paso engade os seus resultados ao historial que rele o paso seguinte.
Que se pode facer
- Comeza unha nova conversa cando cambie o tema. Ábrea cun resumo de dúas ou tres liñas de todo o que o modelo aínda necesite do fío anterior.
- Divide as tarefas longas de axentes noutras máis pequenas. Executa cada parte como unha tarefa independente e pasa só os resultados que necesite a parte seguinte.
- Comproba se as ferramentas de axentes do equipo usan a compactación do contexto. A compactación resume automaticamente as partes máis antigas dunha tarefa para que o modelo relea menos. Se unha ferramenta a ofrece como opción de configuración, actívaa.
Os mesmos documentos procesados unha e outra vez
Cando alguén anexa o mesmo ficheiro longo, como un manual de políticas ou un catálogo de produtos, a moitas consultas distintas, o modelo le o ficheiro completo cada vez. Cada lectura conta como tokens de entrada.
Que se pode facer
- Forma os usuarios para que copien na solicitude a sección relevante do manual ou do catálogo en lugar de anexar o ficheiro completo.
- Crea unha versión breve dos documentos que o equipo usa a miúdo. Un resumo dunha páxina dunha política longa pode substituír o documento completo nas consultas habituais.
Reintentos e bucles
Cando unha resposta non é o que alguén necesitaba e volve executar a tarefa, cada intento usa tokens. O mesmo ocorre cando un axente queda atascado repetindo o mesmo paso.
Que se pode facer
- Detalla a tarefa, o resultado e as fontes na primeira solicitude. Por exemplo: «Resume en cinco viñetas os principais motivos polos que os clientes cancelaron no terceiro trimestre, usando só os resultados da enquisa anexa».
- Revisa os primeiros pasos dunha tarefa de axente. Se o axente repite o mesmo paso ou a mesma busca, detéñeo e reiníciao cunha solicitude máis concreta.
Modelos grandes para tarefas sinxelas
Os modelos máis capaces adoitan custar máis por token, polo que o traballo rutineiro, como os resumos ou os cambios de formato, pode esgotar o orzamento dun equipo máis rápido do necesario.
Que se pode facer
- Usa o enrutamento de modelos, que asigna cada tarefa a un modelo capaz de realizala. Unha reescritura ou un resumo breves poden ir a un modelo máis pequeno e barato, e o modelo máis capaz resérvase para o razoamento ou a análise de varios pasos. A API de Perplexity segue este enfoque coas súas configuracións predefinidas, que asignan un modelo máis pequeno a unha consulta rápida e un máis grande a unha análise exhaustiva.
Picos tras novos fluxos de traballo
Un novo fluxo de traballo automatizado, ou unha ferramenta implantada en todo un equipo, pode disparar o uso dun día para outro. Un pico non é un problema en si mesmo, pero convén saber que traballo o causou.
Que se pode facer
- Proba primeiro os novos fluxos de traballo cun grupo pequeno. Revisa o seu uso durante unha ou dúas semanas antes de implantar o fluxo de traballo en todo o equipo.
- Establece un orzamento mensual para cada equipo. Baséao no uso dun mes típico, para que calquera salto destaque.
- Desactiva a recarga automática. Coa recarga automática desactivada, o traballo detense cando se esgotan os créditos, en lugar de comprarse máis créditos automaticamente.
Como optimizar o gasto en tokens en Perplexity
Para o uso diario
Computer usa créditos, pero só se executa cando ti o escolles, xa sexa seleccionando a icona de Computer, traballando nun proxecto que use Computer de forma predeterminada ou usando o modo Work de Comet.
Para volver á busca normal, selecciona a icona de Perplexity para cambiar de novo ao modo Preguntar. Para ver o uso de créditos, os usuarios poden abrir o contador de créditos na interface de Perplexity.
Os equipos que traballan en proxectos, os espazos de traballo compartidos de Perplexity, poden configurar o modo predeterminado de cada proxecto como Busca ou Computer. Un proxecto que se use sobre todo para investigacións rápidas pode ter Busca como modo predeterminado, para que ninguén inicie unha tarefa de Computer por accidente.
Para administradores de Enterprise
- Coñece o que inclúe cada posto. Os usuarios de Enterprise Pro reciben unha asignación mensual de 500 créditos, e os de Enterprise Max reciben 15.000 créditos. Estes créditos caducan ao final de cada ciclo mensual e non se acumulan para o seguinte.
- Establece primeiro un límite de uso predeterminado. Un límite de uso fixa cantos créditos adicionais pode tomar un membro do fondo compartido unha vez esgotada a súa propia asignación.
- Crea límites con nome para distintos tipos de usuarios. Os administradores poden configurar límites como «Estándar», «Usuario avanzado» e «Contratista», e asignalos a grupos de usuarios ou a membros concretos. Os grupos poden crearse en Perplexity ou sincronizarse desde o provedor de identidade da empresa. Se alguén pertence a máis dun grupo, aplícase o límite máis alto.
- Usa excepcións persoais para os casos especiais. Cando unha persoa necesita un límite distinto do do seu grupo, unha excepción persoal ten prioridade sobre calquera límite de grupo ou compartido. Resulta útil para un proxecto curto con moita investigación, sen ter que subir o límite de todo un equipo.
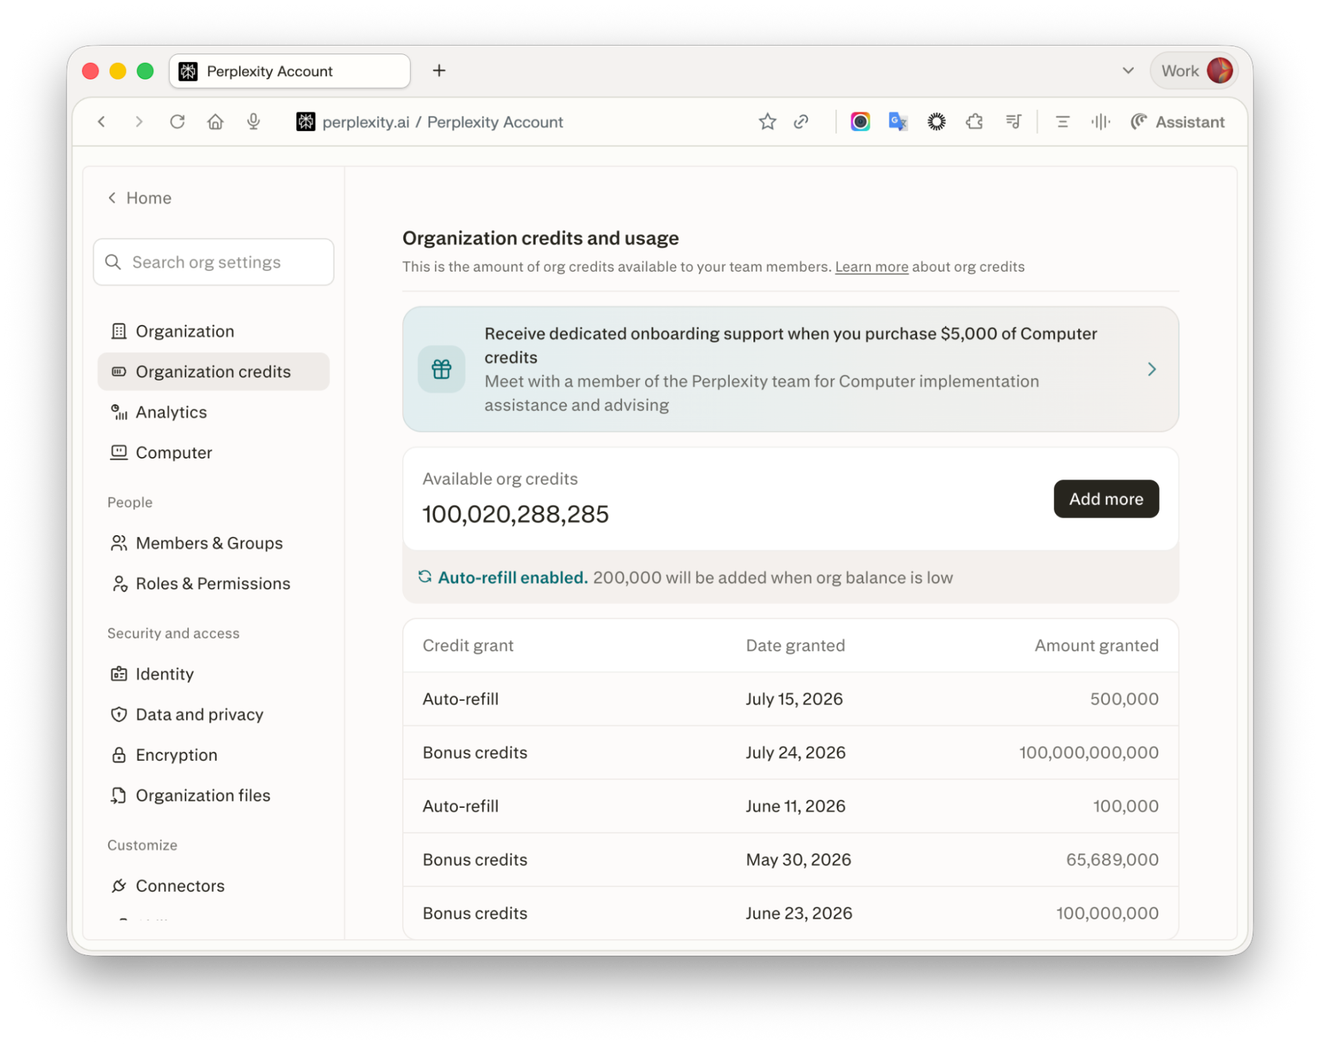
- Ponlle un teito á recarga automática. A recarga automática repón automaticamente o fondo compartido. Inclúe un límite mensual de recarga configurable, para que o gasto non poida medrar sen un máximo establecido.
- Decide como solicitan máis créditos os membros. A opción Permitir que os membros soliciten máis créditos deixa que quen alcance o seu límite pida máis a un administrador, en lugar de quedar bloqueado directamente.
- Revisa o uso cada mes. A páxina Créditos da organización mostra os créditos concedidos, usados e restantes de cada membro, xunto cos límites de grupo e o saldo do fondo. Para organizacións con 50 postos ou máis, ou con polo menos un membro de Enterprise Max, o panel de Insights engade os usuarios activos mensuais e as consultas semanais ao longo do tempo. Para obter máis detalle, os rexistros de auditoría recollen a execución de tarefas, o uso de conectores, o consumo de créditos e as concesións de créditos.
Para equipos que desenvolven sobre a API
- Dálle a cada ferramenta ou equipo a súa propia clave de API. Perplexity pode mostrar a facturación de cada clave por separado, e as claves separadas deixan claro que ferramenta está a impulsar o uso.
- Consulta na páxina de facturación que tipo de token está a medrar. Mostra os tokens de entrada, de saída e de razoamento ao longo do tempo. Se aumentan os tokens de entrada, normalmente significa que unha ferramenta está a enviar máis texto do necesario. Se aumentan os tokens de razoamento, significa que as tarefas se executan en modelos que razoan os problemas con detemento.
- Usa a Search API cando unha ferramenta só necesite resultados de busca. Devolve resultados web sen que un modelo escriba unha resposta, e cobra por solicitude, sen cargos adicionais baseados en tokens.
- Inicia as ferramentas de axentes a partir dunha configuración predefinida. As configuracións predefinidas de Perplexity axustan o tamaño do modelo ao tamaño da tarefa e manteñen as solicitudes sinxelas lonxe dos modelos máis caros.
Traballo prioritariamente local
Algúns traballos non necesitan para nada un modelo na nube de pago. Portable Computer é unha versión do axente de Perplexity que se executa no propio ordenador da persoa, usando un modelo de IA almacenado nese equipo. Como o modelo se executa localmente, o traballo rutineiro non consome tokens de pago. Só se conecta á web, ás aplicacións conectadas ou a un modelo na nube máis potente cando unha tarefa o require, e pídelle permiso ao usuario antes.
Descubre como Perplexity Computer xestiona o traballo de varios pasos na web, nos ficheiros e nas ferramentas conectadas.
Preguntas frecuentes
Que diferenza hai entre o gasto en tokens e os custos da IA?
O gasto en tokens mide canto traballo de IA fai un equipo, contado en tokens. Os custos da IA abarcan todo o que paga un equipo por usar a IA, incluídas as subscricións, os créditos adicionais e a configuración inicial. O gasto en tokens determina a parte da factura baseada no uso.
Os usuarios con subscrición pagan por token?
Normalmente non de forma directa. As ferramentas de subscrición miden o uso en mensaxes, consultas ou créditos, e as tarefas que usan máis tokens esgótanos máis rápido. En Perplexity, as buscas normais non usan créditos; só os usan as tarefas de Computer.
Por que usan tantos tokens os axentes de IA?
Un axente completa unha tarefa en moitos pasos, e cada paso é unha solicitude independente que rele o traballo feito ata ese momento. Por iso, unha tarefa longa usa máis tokens con cada paso que dá.
Por que se dispara de súpeto o uso de tokens?
A maioría dos picos prodúcense tras un cambio na forma de traballar dun equipo, como un novo fluxo de traballo automatizado, unha ferramenta implantada para máis persoas ou unha tarefa longa dun axente. Comparar a data do pico cos lanzamentos recentes adoita revelar a causa. Probar primeiro os novos fluxos de traballo cun grupo pequeno axuda a evitar picos.