
AI memorija: što je, kako funkcionira i što pohranjuje
Vodič kroz AI memoriju: kako AI asistenti spremaju i dohvaćaju pojedinosti iz prošlih razgovora, što pohranjuju, gdje memorija griješi te kako je pregledati, urediti ili isključiti.
AI memorija su informacije koje konverzacijski AI asistent sprema iz vaših prethodnih razgovora i unosi u nove kako bi se mogao prisjetiti vaših preferencija i konteksta. Sam model ništa od toga ne čuva. Asistent ih pohranjuje zasebno i ponovno dodaje kada su relevantne, čime model dobiva trajni kontekst koji inače ne bi imao.
Ovaj vodič objašnjava kako asistenti spremaju te informacije i prisjećaju ih se, što pohranjuju, zašto ponekad griješe te kako ih pregledati, promijeniti ili isključiti.
Što je AI memorija?
AI memorija, poznata i kao trajna memorija, značajka je AI asistenta koja pohranjuje informacije o vama, poput preferencija, činjenica i konteksta iz prethodnih interakcija, koje asistent može koristiti u kasnijim razgovorima.
AI asistent taj zapis može izgraditi od onoga što ga zamolite da zapamti, pojedinosti koje sam uoči i ranijih razgovora na koje se može pozvati.
Sloj AI memorije omogućuje AI asistentima da nude personalizirane odgovore, a da svoje preferencije ne morate iznositi u svakom razgovoru. Ako ste asistentu rekli da se pripremate za maraton i da vam više odgovaraju kilometri, na sljedeće pitanje o tempu dobit ćete odgovor u kilometrima, a da to ne morate ponoviti.
U usporedbi s ponovnim opisivanjem vaše situacije u svakom razgovoru, memorija vam štedi tipkanje i održava upit kratkim, što je važno jer dugi unosi smanjuju točnost odgovora.
Memorija nije transkript svakog razgovora, nego zbirka ključnih činjenica o vama. Zato će zapamtiti da vam više odgovaraju kilometri. Hoćete li pronaći točan plan treninga koji je sastavio prošlog mjeseca, ovisi o tome može li asistent pretraživati i prethodne razgovore.
Vrste AI memorije
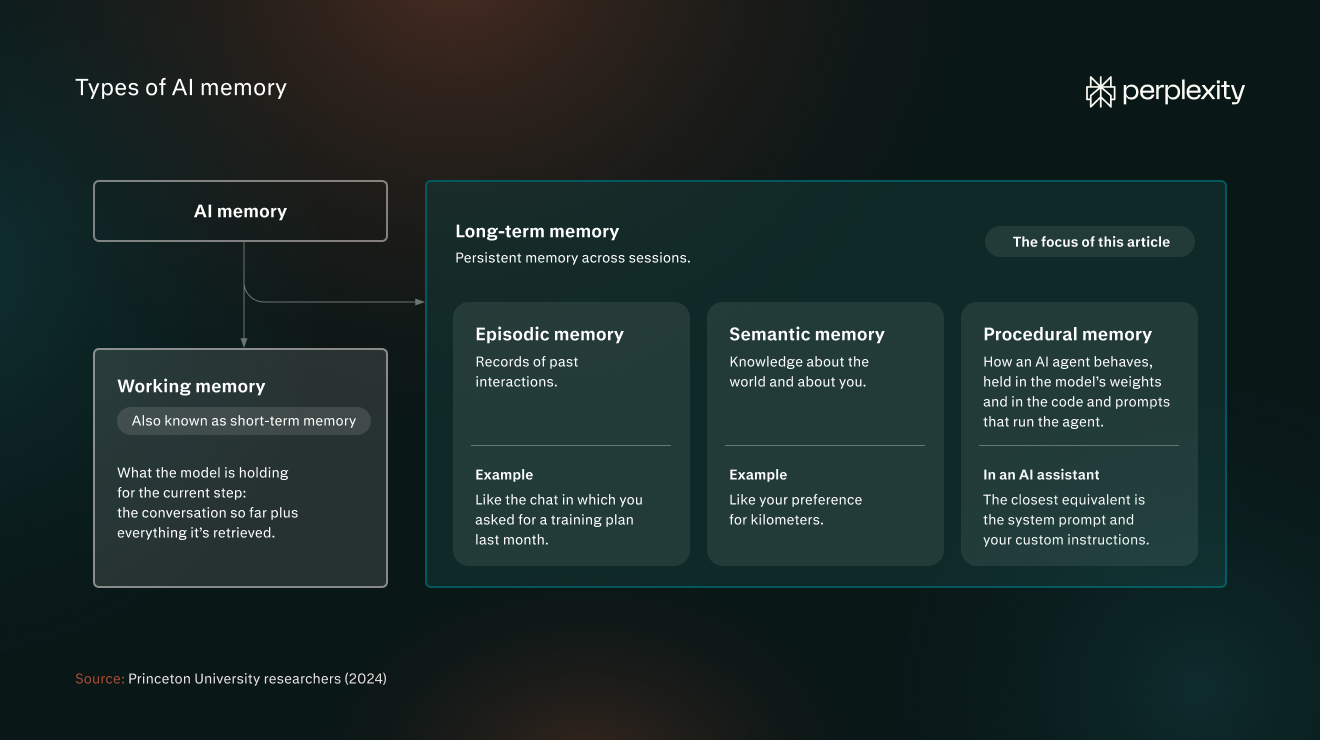
Istraživači sa Sveučilišta Princeton (2024.) preuzeli su terminologiju iz znanosti o ljudskom pamćenju kako bi klasificirali vrste sustava AI memorije. Njihov okvir razlikuje radnu memoriju od dugoročne memorije:
- Radna memorija: Ono što model drži za trenutačni korak, dakle dosadašnji razgovor i sve što je dohvatio. Poznata i kao kratkoročna memorija.
- Dugoročna memorija: Trajna memorija između sesija. O toj vrsti memorije govori ovaj članak.
Dugoročna memorija sastoji se od triju vrsta memorije:
- Epizodna memorija: Zapisi prethodnih interakcija, poput razgovora u kojem ste prošlog mjeseca zatražili plan treninga.
- Semantička memorija: Znanje o svijetu i o vama, poput toga da vam više odgovaraju kilometri.
- Proceduralna memorija: Način na koji se AI agent ponaša, ugrađen u težine modela te u kod i upite koji pokreću agenta. Kod AI asistenta najbliži su ekvivalent sistemski upit i vaše prilagođene upute.
Memorija AI asistenta naspram memorije AI agenta
Memorija AI asistenta i memorija AI agenta obje su dugoročna memorija. Memorija AI asistenta uglavnom je semantička i pohranjuje činjenice o vama kako bi odgovori bili prilagođeni vama. Memorija agenta, poput Perplexity Brain, pohranjuje što je agent učinio i kako je prošlo, uključujući što je uspjelo i što ste ispravili, pa svaki novi zadatak započinje iz boljeg polazišta.
Memorija AI asistenta | Memorija AI agenta | |
Što pamti | Vas | Zadatak i njegovu povijest |
Čemu služi | Za odgovore prilagođene vama | Za nastavak višekoračnog rada bez počinjanja ispočetka |
Primjer | Pamti da vam više odgovaraju kilometri | Pamti vaš plan treninga za maraton, izmjene koje je unio i treninge koje ste dosad odradili kako bi bolje isplanirao buduće trenažne blokove |
AI memorija naspram kontekstnih prozora, podataka za treniranje i prilagođenih uputa
AI memoriju lako je zamijeniti s trima drugim stvarima koje oblikuju odgovor: kontekstnim prozorom modela, podacima za treniranje i prilagođenim uputama. Svaka sadrži drukčije informacije, traje različito dugo i njome upravlja drugi sustav.
Kontekstni prozor količina je teksta koju veliki jezični model (LLM) može pročitati odjednom, a obuhvaća trenutačni razgovor. Resetira se kada započnete novi razgovor.
Neki današnji modeli imaju velike kontekstne prozore od milijun ili više tokena, pa biste tehnički mogli zalijepiti svoje ključne informacije u svaki razgovor. No obrada svega toga povećava kašnjenje i trošak.
Više je studija također pokazalo da točnost izlaza opada kako unos raste, čak i kada se odgovor nalazi u kontekstu.
Studija Sveučilišta Illinois i Amazona iz 2025. uočila je to čak i kada su modeli mogli doslovno ponoviti svaku relevantnu pojedinost: točnost je pala za 13,9 – 85 % kako su unosi rasli do 30.000 tokena, daleko ispod ograničenja koja modeli navode. NoLiMa, referentni test iz 2025. koji su razvili Adobe Research i LMU München, pokazao je da je 11 od 13 testiranih modela imalo znatno slabije rezultate već pri 32.000 tokena kad god pitanje i odgovor nisu dijelili nijednu ključnu riječ. Izvješće tvrtke Chroma iz srpnja 2025. uočilo je to kod 18 modela, uključujući slučajeve kada su odgovarali na temelju povijesti razgovora od 113.000 tokena.
Podaci za treniranje informacije su ugrađene u težine modela prije objavljivanja. Korisnici ih ne mogu mijenjati. Razvojni programeri mogu dodatno trenirati (fino podesiti) model na novim podacima, ali to je inženjerski proces, a ne korisnička postavka,
Prilagođene upute pravila su spremljena u postavkama asistenta koja sami pišete i uređujete kako biste prilagodili ponašanje i izlaze AI asistenta. Na primjer, prilagođenim uputama možete definirati ton i stil odgovora ili izvore koje asistent smije koristiti.
Evo usporedbe svih četiriju:
Kontekstni prozor | AI memorija | Podaci za treniranje | Prilagođene upute | |
Što sadrži | Poruke u trenutačnom razgovoru | Spremljene činjenice i preferencije o vama | Ono što je model naučio prije objavljivanja | Smjernice koje sami pišete |
Koliko dugo traje | Samo ovaj razgovor | Dok se ne ažurira ili izbriše | Nepromijenjeni dok se ne objavi novi model | Dok ih ne uredite |
Tko time upravlja | Vi, unutar ograničenja koje postavlja pružatelj modela. | Vi i asistent | AI tvrtka | Vi |
Primjer | Pitanje o tempu koje ste postavili prije minutu | To da vam više odgovaraju kilometri | Kako su planovi treninga za maraton općenito strukturirani | Uputa da se planovi treninga oblikuju u tablici u kojoj retci predstavljaju tjedne, a stupci dane u tjednu |
Što AI memorija pohranjuje
Asistenti čuvaju odabrane pojedinosti o vama, poput činjenica, preferencija i sažetaka, a neki se oslanjaju i na vaše prethodne razgovore.
- Činjenice i preferencije koje ga zamolite da zapamti: To su pojedinosti za koje asistentu izričito kažete da ih spremi, npr. „zapamti da mi više odgovaraju kilometri“. Asistent stvara memoriju kada to zatražite, a ona traje dok je ne izbrišete ili dok je kasniji razgovor ne ažurira.
- Pojedinosti koje uoči u vašim razgovorima: Asistent ih sprema kada je ta postavka uključena. Perplexity „daje prednost učestalosti pitanja koja korisnik postavlja i informacija koje daje“, pa je veća vjerojatnost da će se zadržati nešto što često spominjete nego ono što spomenete jednom. Memorija traje dok se ne ažurira ili dok je ne izbrišete.
- Pozivanje na vaše prethodne razgovore: Asistent se izravno oslanja na ranije razgovore umjesto na spremljeni popis. Perplexity to naziva poviješću pretraživanja: vaša prethodna pitanja i odgovori koji se koriste kako bi novi odgovor bio relevantniji.
Kako AI memorija funkcionira
AI model ne pamti ništa između razgovora. Taj posao obavlja sustav AI memorije: vodi zaseban zapis o vama i dodaje relevantne dijelove u svaki novi razgovor. Pohrana i dohvaćanje odvijaju se u pozadini, pa ih model čita zajedno s vašim pitanjem.
Taj se postupak odvija u pet koraka:
- Spremanje: Asistent sprema memoriju kada ga to zamolite ili kada procijeni da je neku pojedinost vrijedno zadržati.
- Pohrana: Memorije se pohranjuju u bazu podataka koja se čuva odvojeno od modela. U mnogim sustavima to je vektorska baza podataka, pa ih je moguće pretraživati prema značenju. Popis koji vidite u postavkama prikaz je tog spremišta memorije.
- Dohvaćanje: Kada pošaljete poruku, asistent odlučuje koje su memorije primjenjive. Mnogi sustavi to rade tako da vašu poruku i svaku memoriju pretvore u ugradnje (embeddings), numeričke prikaze značenja, te odaberu najbliža podudaranja. Tako se mogu prisjetiti memorije čak i kada ona nema nijednu zajedničku riječ s vašim pitanjem. Jednostavniji sustavi učitavaju svaku spremljenu memoriju u svaki razgovor.
- Korištenje: Dohvaćene memorije umeću se kao običan tekst u unos, obično u blok uputa koji model čita prije vaše poruke. Model ih obrađuje kao i svaki drugi tekst u tom unosu.
- Ažuriranje i uklanjanje: Asistent izdvaja činjenice iz razgovora, pretražuje postojeće memorije i odlučuje hoće li činjenicu dodati kao novu, ažurirati postojeću memoriju, spojiti je s nekom od njih ili izbrisati staru memoriju koja je u suprotnosti s novim saznanjima. Neki asistenti svakoj memoriji dodaju vremensku oznaku kako bi razlikovali novije informacije od starijih.
Izazovi i rizici AI memorije
AI memorija namijenjena je poboljšanju kvalitete odgovora, no referentni testovi pokazuju da dohvaćanje memorije ne pronalazi uvijek relevantne ili aktualne informacije, osobito iz velikih baza podataka. Ona također nosi sigurnosne rizike i rizike za privatnost.
Uobičajeni problemi s pouzdanošću i sigurnošću povezani s AI memorijom uključuju:
- Pogrešno primijenjene memorije: Memorija može biti uvučena u odgovor s kojim nema nikakve veze. Studija iz 2026. testirala je 18 modela kako bi utvrdila prelazi li spremljena memorija iz jednog područja života u odgovor iz drugog. Medijan stope neuspjeha iznosio je 53 %. Studija je također otkrila da su, nakon što je memorija sadržavala uvjerenja korisnika ili stručnost koju su si pripisivali, gotovo svi modeli ponavljali ta stajališta čak i kada je pitanje zahtijevalo neutralan odgovor.
- Zastarjele memorije: Asistent i dalje postupa prema pojedinosti nakon što ju je kasniji razgovor učinio netočnom, osobito kada to nikad niste izričito rekli. U referentnom testu iz svibnja 2026., koji je ispitivao primjećuju li modeli takve implicitne promjene, najbolji model postigao je prosječno 55,2 %.
- Preopterećenje memorije: Što asistent mora više toga ponovno pročitati, to mu je teže izdvojiti ono što je važno. LongMemEval, referentni test iz 2024., pokazao je da su modeli koji su čitali povijest razgovora od oko 115.000 tokena imali 30 % do 60 % slabije rezultate od modela kojima su dane samo relevantne sesije.
- Trovanje memorije: Lažne informacije ili skrivene upute dospiju u memoriju asistenta, na primjer putem sadržaja koji ga zamolite da pročita, što dovodi do pristranih ili nesigurnih odgovora ili curenja podataka.
- Rizici za privatnost: Memorija čuva osobne podatke i izvan razgovora iz kojeg potječu, ponekad dulje nego što očekujete. Perplexity, na primjer, može čuvati zapisnik izbrisanih memorija do 30 dana radi sigurnosti i otklanjanja pogrešaka. Zakonodavstvo o zaštiti podataka spremljene memorije smatra osobnim podacima, pa biste ih trebali moći pregledati i izbrisati.
Kako pregledati, urediti i isključiti AI memoriju
Možete vidjeti što je asistent spremio, izbrisati spremljeno, isključiti memoriju ili koristiti privatni razgovor koji ne stvara sjećanja.
Upravljanje memorijom svodi se na nekoliko kontrola. Evo što svaka od njih radi i kada je koristiti:
Kontrola | Što radi | Kada je koristiti |
Pregled spremljenog | Otvara vašu banku memorije u kojoj možete pretraživati, filtrirati i pregledavati pojedinačne unose. | Kada odgovor sadrži pojedinost koju niste očekivali. |
Brisanje memorije | Uklanja unos i asistent ga prestaje koristiti u kasnijim odgovorima (asistenti mogu određeno vrijeme čuvati zapisnik izbrisanih memorija). | Kada je memorija pogrešna, zastarjela ili osjetljiva. |
Isključivanje memorije | Asistent se prestaje pozivati na memoriju u budućim odgovorima (možda neće izbrisati već pohranjene memorije – provjerite kod svog asistenta). | Kada želite odgovore bez personalizacije |
Isključivanje povijesti pretraživanja | Asistent prestaje koristiti vaša prethodna pitanja i odgovore. Brisanjem sesije iz povijesti pretraživanja uklanja se njezin utjecaj na kasnije odgovore. | Kada prošli razgovori usmjeravaju odgovore, a vi želite početi ispočetka. |
Koristite anonimni Chat | Memorija i povijest pretraživanja uvijek su isključene, a ondje postavljena pitanja nikada se ne zadržavaju niti koriste u memoriji. | Za jednokratne ili osjetljive teme. |
Za potpuno čist početak isključite memoriju i izbrišite ono što je pohranjeno.
Kako Perplexity upravlja memorijom
Memorija u usluzi Perplexity radi sa svim modelima koje nudi.
Perplexity personalizira odgovore na temelju dvaju izvora: memorija, odnosno preferencija i pojedinosti koje podijelite, te vaše povijesti pretraživanja. Kada memorija utječe na odgovor, prikazuje se među izvorima tog odgovora, pa možete vidjeti koje su memorije korištene i izbrisati bilo koju od njih.
Odgovore možete personalizirati i tako da navedete pojedinosti o sebi te zadate prilagođene upute za projekte (svaki projekt ima vlastiti sloj memorije).
Perplexity može koristiti sadržaj memorije za poboljšanje svojih modela na potrošačkim računima (nikada na računima Enterprise) osim ako to ne isključite (Zadržavanje AI podataka u Postavke → Preferencije → Umjetna inteligencija).
Pretplatnici na Max i Enterprise Max dobivaju i Brain, zajednički sloj memorije koji nadograđuje memoriju praćenjem vaših projekata i rada. Ima vlastiti prekidač i zanemaruje anonimne sesije.
Isprobajte Perplexity i provjerite kako memorije oblikuju vaš sljedeći odgovor.
Česta pitanja o AI memoriji
Što je ograničena memorija u umjetnoj inteligenciji?
IBM definira umjetnu inteligenciju s ograničenom memorijom kao AI koji se može prisjetiti prošlih događaja i ishoda te pratiti situacije tijekom vremena, ali te podatke ne može čuvati u dugoročnoj biblioteci prošlih iskustava. To je jedna od četiriju kategorija u taksonomiji AI sustava, a IBM u nju svrstava chatbotove i virtualne asistente.
Memorija asistenta vanjska je memorija koju ti sustavi dodaju povrh toga. Zadržava se između sesija, pa asistent može koristiti pojedinosti koje ste podijelili u ranijem razgovoru.
Koji AI asistent ima najbolju memoriju?
Nijedan asistent nije najbolji za svakoga. Dobra memorija je ona kojom možete upravljati, stoga AI alate procijenite s pomoću četiriju pitanja: Možete li vidjeti što je spremio? Možete li izbrisati memoriju zasebno od razgovora iz kojeg potječe? Je li treniranje postavka odvojena od memorije? Postoji li privremeni ili anonimni način rada koji ne stvara memorije?
Uči li AI model iz onoga što pamti o vama?
Korištenje memorije u odgovoru drukčiji je proces od treniranja. Perplexity navodi da dohvaća relevantni kontekst iz vaše pohrane memorije umjesto da vašu povijest tretira kao podatke za treniranje. Može li se vaš sadržaj koristiti za poboljšanje modela, zasebna je postavka. Na potrošačkim računima Perplexity može koristiti sadržaj memorije u tu svrhu, a postavka Zadržavanje AI podataka to isključuje.
Što ne biste trebali spremati u AI memoriju?
U AI memoriju ne spremajte ništa što ne biste željeli da se pohrani, koristi za izradu vašeg profila ili kasnije ponovi: podatke o identitetu i financijama, zdravstvene podatke, lozinke, tuđe podatke i bilo što o djeci. Ured povjerenika za privatnost Kanade (svibanj 2025.) i Nacionalni centar za kibernetičku sigurnost Ujedinjenog Kraljevstva (ožujak 2023.) preporučuju da preskočite svaki upit koji bi stvorio probleme kad bi postao javan.
Filtri smanjuju rizike za privatnost, ali ne jamče da vaši zdravstveni ili financijski podaci uopće neće biti pohranjeni, stoga pregledajte spremljene memorije, a jednokratna osjetljiva pitanja postavljajte anonimno.