
Memori AI: apa itu, cara kerjanya, dan apa yang disimpannya
Panduan memori AI: cara asisten AI menyimpan dan mengingat detail dari percakapan sebelumnya, apa yang mereka simpan, kapan memori bisa keliru, dan cara melihat, mengedit, atau menonaktifkannya.
Memori AI adalah informasi yang disimpan asisten AI percakapan dari percakapan Anda sebelumnya dan dibawa ke percakapan baru, sehingga asisten dapat mengingat preferensi dan konteks Anda. Model itu sendiri tidak menyimpan informasi tersebut sama sekali. Asisten menyimpannya secara terpisah dan menambahkannya kembali saat relevan, sehingga model mendapatkan konteks persisten yang tidak akan dimilikinya tanpa memori.
Panduan ini menjelaskan cara asisten menyimpan dan mengingat kembali informasi tersebut, apa saja yang disimpan, mengapa terkadang keliru, dan cara melihat, mengubah, atau menonaktifkannya.
Apa itu memori AI?
Memori AI, yang juga disebut memori persisten, adalah fitur asisten AI yang menyimpan informasi tentang Anda, seperti preferensi, fakta, dan konteks dari interaksi sebelumnya, yang dapat digunakan asisten dalam percakapan berikutnya.
Asisten AI dapat membangun catatan tersebut dari hal-hal yang Anda minta untuk diingat, detail yang ditangkapnya sendiri, dan chat sebelumnya yang dapat dirujuknya kembali.
Lapisan memori AI memungkinkan asisten AI memberikan jawaban yang dipersonalisasi tanpa Anda harus menyampaikan preferensi di setiap chat. Jika Anda pernah memberi tahu asisten bahwa Anda sedang berlatih untuk maraton dan lebih suka kilometer, pertanyaan Anda berikutnya tentang kecepatan lari akan dijawab dalam kilometer tanpa Anda perlu menyebutkannya lagi.
Dibandingkan menjelaskan ulang situasi Anda di setiap chat, memori menghemat ketikan dan membuat prompt tetap singkat, yang penting karena input yang panjang membuat jawaban kurang akurat.
Memori bukanlah transkrip setiap percakapan, melainkan kumpulan fakta penting tentang Anda. Jadi, asisten akan ingat bahwa Anda lebih suka kilometer. Namun, bisa atau tidaknya menemukan rencana latihan persis yang disusunnya bulan lalu bergantung pada apakah asisten juga dapat mencari chat sebelumnya.
Jenis-jenis memori AI
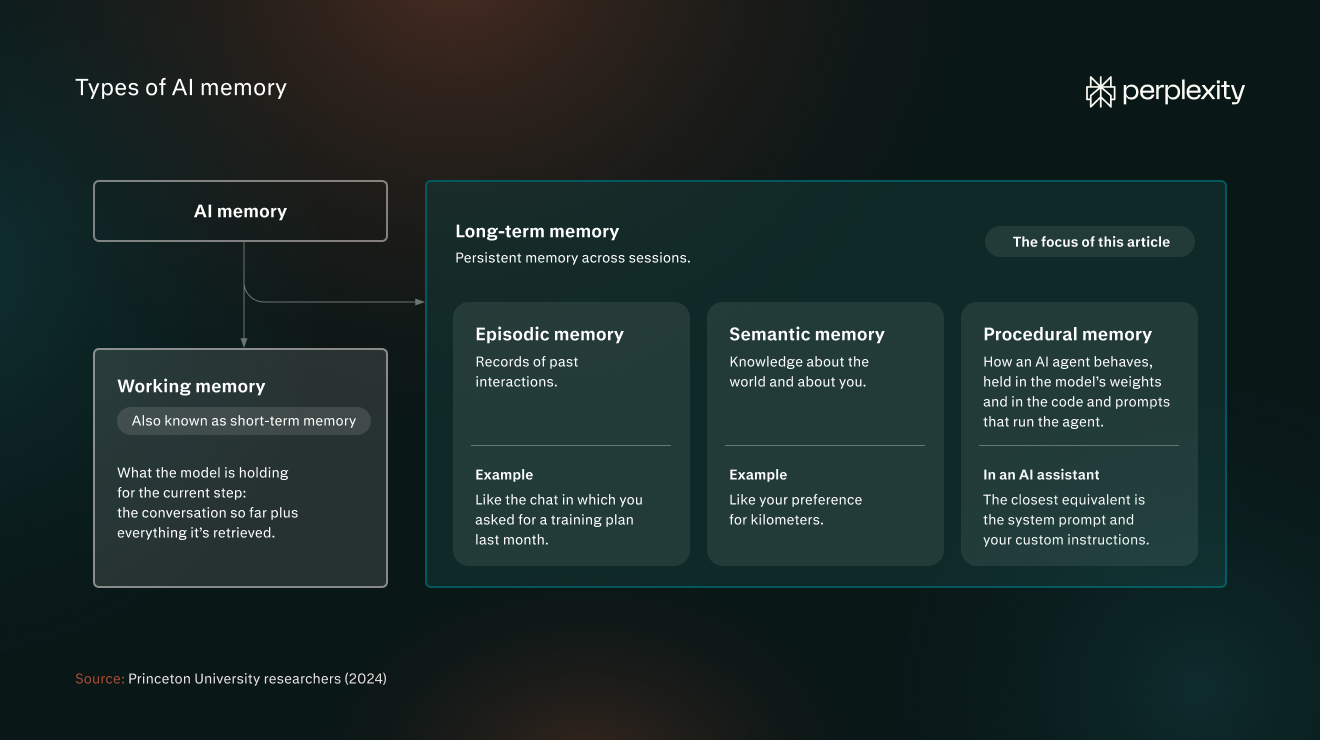
Para peneliti dari Princeton University (2024) meminjam terminologi dari ilmu memori manusia untuk mengklasifikasikan jenis-jenis sistem memori AI. Kerangka kerja mereka memisahkan memori kerja dari memori jangka panjang:
- Memori kerja: Apa yang sedang dipegang model untuk langkah saat ini, yaitu percakapan sejauh ini ditambah semua yang telah diambilnya. Juga dikenal sebagai memori jangka pendek.
- Memori jangka panjang: Memori persisten lintas sesi. Inilah jenis memori yang dibahas dalam artikel ini.
Memori jangka panjang terdiri dari tiga jenis memori:
- Memori episodik: Catatan interaksi sebelumnya, seperti chat tempat Anda meminta rencana latihan bulan lalu.
- Memori semantik: Pengetahuan tentang dunia dan tentang Anda, seperti preferensi terhadap kilometer.
- Memori prosedural: Cara agen AI berperilaku, yang tertanam dalam bobot model serta dalam kode dan prompt yang menjalankan agen tersebut. Pada asisten AI, padanan terdekatnya adalah prompt sistem dan instruksi kustom Anda.
Memori asisten AI vs. memori agen AI
Memori asisten AI dan memori agen AI sama-sama merupakan memori jangka panjang. Memori asisten AI sebagian besar berupa memori semantik dan menyimpan fakta tentang Anda, sehingga jawabannya sesuai dengan Anda. Memori agen, seperti Brain milik Perplexity, menyimpan apa yang telah dilakukan agen dan bagaimana hasilnya, termasuk apa yang berhasil dan apa yang Anda koreksi, sehingga agen memulai setiap tugas baru dari posisi yang lebih baik.
Memori asisten AI | Memori agen AI | |
Apa yang diingat | Anda | Tugas dan riwayatnya |
Kegunaannya | Jawaban yang sesuai dengan Anda | Melanjutkan pekerjaan multilangkah tanpa memulai dari awal |
Contoh | Mengingat bahwa Anda lebih suka kilometer | Mengingat rencana latihan maraton Anda, penyesuaian yang telah dibuatnya, dan sesi yang telah Anda selesaikan sejauh ini, sehingga dapat merencanakan blok latihan berikutnya dengan lebih baik |
Memori AI vs. jendela konteks, data pelatihan, dan instruksi kustom
Memori AI mudah tertukar dengan tiga hal lain yang membentuk jawaban: jendela konteks model, data pelatihan, dan instruksi kustom. Masing-masing menyimpan informasi yang berbeda, bertahan dalam jangka waktu yang berbeda, dan dikendalikan oleh sistem yang berbeda.
Jendela konteks adalah jumlah teks yang dapat dibaca model bahasa besar (LLM) sekaligus dan mencakup percakapan saat ini. Jendela konteks diatur ulang saat Anda memulai chat baru.
Beberapa model saat ini memiliki jendela konteks besar hingga satu juta token atau lebih, sehingga secara teknis Anda dapat menempelkan informasi penting Anda ke setiap percakapan. Namun, memproses semuanya menambah latensi dan biaya.
Berbagai studi juga menemukan bahwa akurasi output menurun seiring bertambahnya input, bahkan ketika jawabannya ada di dalam konteks.
Studi University of Illinois dan Amazon tahun 2025 menemukan hal ini bahkan ketika model dapat menyebutkan kembali setiap detail yang relevan: akurasi turun sebesar 13,9–85% seiring input bertambah hingga 30.000 token, jauh di bawah batas yang diklaim model tersebut. NoLiMa, tolok ukur tahun 2025 dari Adobe Research dan LMU Munich, menemukan bahwa 11 dari 13 model yang diuji berkinerja jauh lebih buruk hanya pada 32.000 token setiap kali pertanyaan dan jawaban tidak memiliki kata kunci yang sama. Laporan Chroma bulan Juli 2025 menemukan hal ini pada 18 model, termasuk saat model menjawab dari riwayat chat sebesar 113.000 token.
Data pelatihan adalah informasi yang tertanam dalam bobot model sebelum dirilis. Pengguna tidak dapat mengubahnya. Pengembang dapat melakukan fine-tuning model dengan data baru, tetapi itu adalah proses rekayasa, bukan pengaturan pengguna,
Instruksi kustom adalah aturan yang disimpan di pengaturan asisten, yang Anda tulis dan edit sendiri untuk menyesuaikan perilaku dan output asisten AI. Misalnya, Anda dapat menggunakan instruksi kustom untuk menentukan nada dan gaya jawaban atau sumber yang boleh digunakan asisten.
Berikut perbandingan keempatnya:
Jendela konteks | Memori AI | Data pelatihan | Instruksi kustom | |
Apa yang disimpan | Pesan dalam chat saat ini | Fakta dan preferensi tentang Anda yang disimpan | Apa yang dipelajari model sebelum dirilis | Panduan yang Anda tulis sendiri |
Berapa lama bertahan | Hanya chat ini | Hingga diperbarui atau dihapus | Tetap hingga model baru dirilis | Hingga Anda mengeditnya |
Siapa yang mengendalikannya | Anda, dalam batas yang ditetapkan penyedia model. | Anda dan asisten | Perusahaan AI | Anda |
Contoh | Pertanyaan tentang pengaturan tempo yang Anda ajukan semenit lalu | Bahwa Anda lebih suka kilometer | Bagaimana rencana latihan maraton umumnya disusun | Instruksi untuk memformat rencana latihan dalam bentuk kisi dengan baris mewakili minggu dan kolom mewakili hari dalam seminggu |
Apa yang disimpan memori AI
Asisten menyimpan detail tertentu tentang Anda, seperti fakta, preferensi, dan ringkasan, dan sebagian asisten juga memanfaatkan chat Anda sebelumnya.
- Fakta dan preferensi yang Anda minta untuk diingat: Ini adalah detail yang secara eksplisit Anda minta untuk disimpan asisten, seperti "ingat bahwa saya lebih suka kilometer." Asisten membuat memori tersebut saat Anda memintanya, dan memori itu bertahan hingga Anda menghapusnya atau percakapan selanjutnya memperbaruinya.
- Detail yang ditangkap dari percakapan Anda: Asisten menyimpan detail ini saat pengaturannya aktif. Perplexity "lebih mengutamakan frekuensi pertanyaan yang diajukan dan informasi yang diberikan oleh pengguna," sehingga hal yang sering Anda sebutkan lebih mungkin melekat daripada yang hanya Anda sebutkan sekali. Memori bertahan hingga diperbarui atau Anda menghapusnya.
- Rujukan ke chat Anda sebelumnya: Asisten memanfaatkan percakapan sebelumnya secara langsung, bukan daftar yang disimpan. Perplexity menyebutnya riwayat pencarian: pertanyaan dan jawaban Anda sebelumnya, yang digunakan agar respons baru lebih relevan.
Cara kerja memori AI
Model AI tidak mengingat apa pun di antara percakapan. Sistem memori AI-lah yang melakukannya: sistem ini menyimpan catatan terpisah tentang Anda dan menambahkan bagian yang relevan ke setiap percakapan baru. Penyimpanan dan pengambilan berlangsung di balik layar, sehingga model membacanya bersama pertanyaan Anda.
Proses tersebut berlangsung dalam lima langkah:
- Pencatatan: Asisten menyimpan memori saat Anda memintanya, atau saat asisten menilai suatu detail layak disimpan.
- Penyimpanan: Memori masuk ke database yang terpisah dari model. Pada banyak sistem, ini adalah database vektor, sehingga memori dapat dicari berdasarkan makna. Daftar yang Anda lihat di pengaturan adalah tampilan dari penyimpanan memori tersebut.
- Pengambilan: Saat Anda mengirim pesan, asisten memutuskan memori mana yang berlaku. Banyak sistem melakukannya dengan mengubah pesan Anda dan setiap memori menjadi embedding, yaitu representasi numerik dari makna, lalu memilih yang paling cocok. Dengan cara itulah sistem dapat mengingat suatu memori bahkan ketika memori tersebut tidak memiliki kata yang sama dengan pertanyaan Anda. Sistem yang lebih sederhana memuat setiap memori yang tersimpan ke dalam setiap percakapan.
- Penggunaan: Memori yang diambil disisipkan sebagai teks biasa ke dalam input, biasanya dalam blok instruksi yang dibaca model sebelum pesan Anda. Model memprosesnya seperti teks lain dalam input tersebut.
- Pembaruan dan penghapusan: Asisten mengekstrak fakta dari chat, mencari memori yang sudah ada, lalu memutuskan apakah akan menambahkannya sebagai memori baru, memperbarui memori yang ada, menggabungkannya dengan memori lain, atau menghapus memori lama yang bertentangan dengan temuan baru. Beberapa asisten memberi stempel waktu pada setiap memori untuk membedakan informasi yang lebih baru dari yang lebih lama.
Tantangan dan risiko memori AI
Memori AI dimaksudkan untuk meningkatkan kualitas jawaban, tetapi tolok ukur menunjukkan bahwa pengambilan memori tidak selalu menghadirkan informasi yang relevan atau terkini, terutama dari database yang besar. Memori AI juga menimbulkan risiko keamanan dan privasi.
Masalah keandalan dan keamanan umum terkait memori AI meliputi:
- Memori yang salah diterapkan: Suatu memori dapat ditarik ke dalam jawaban yang sama sekali tidak berkaitan dengannya. Sebuah studi tahun 2026 menguji 18 model untuk melihat apakah memori yang tersimpan dari satu bidang kehidupan bocor ke dalam jawaban untuk bidang lain. Median tingkat kegagalannya adalah 53%. Studi tersebut juga menemukan bahwa begitu memori menyimpan keyakinan pengguna atau keahlian yang mereka klaim, hampir setiap model menggemakannya meskipun pertanyaannya menuntut jawaban yang netral.
- Memori usang: Asisten terus bertindak berdasarkan suatu detail setelah percakapan selanjutnya membuatnya tidak lagi benar, terutama jika Anda tidak pernah menyatakannya secara terang-terangan. Dalam tolok ukur bulan Mei 2026, yang menguji apakah model menyadari perubahan implisit semacam itu, model terbaik mencapai rata-rata 55,2%.
- Kelebihan memori: Makin banyak yang harus dibaca ulang oleh asisten, makin sulit baginya memilah apa yang penting. LongMemEval, tolok ukur tahun 2024, menemukan bahwa model yang membaca riwayat chat sekitar 115.000 token berkinerja 30% hingga 60% lebih buruk daripada model yang hanya diberi sesi yang relevan.
- Peracunan memori: Informasi palsu atau instruksi tersembunyi masuk ke memori asisten, misalnya melalui konten yang Anda minta untuk dibacanya, sehingga menghasilkan jawaban yang bias atau tidak aman, atau kebocoran data.
- Risiko privasi: Memori menyimpan detail pribadi di luar chat asalnya, terkadang lebih lama dari yang Anda kira. Perplexity, misalnya, dapat menyimpan log memori yang dihapus hingga 30 hari untuk keperluan keamanan dan debugging. Undang-undang perlindungan data memperlakukan memori yang tersimpan sebagai data pribadi, sehingga Anda seharusnya dapat meninjau dan menghapusnya.
Cara melihat, mengedit, dan menonaktifkan memori AI
Anda dapat melihat apa yang telah disimpan asisten, menghapusnya, menonaktifkan memori, atau menggunakan chat privat yang tidak membuat memori.
Pengelolaan memori bergantung pada beberapa kontrol. Berikut fungsi masing-masing dan kapan menggunakannya:
Kontrol | Fungsinya | Kapan menggunakannya |
Lihat apa yang tersimpan | Membuka bank memori Anda, tempat Anda dapat mencari, memfilter, dan meninjau setiap entri. | Saat jawaban menyertakan detail yang tidak Anda duga. |
Hapus memori | Menghapus entri tersebut, dan asisten berhenti menggunakannya dalam jawaban berikutnya (asisten mungkin menyimpan log memori yang dihapus selama jangka waktu tertentu). | Saat memori salah, usang, atau sensitif. |
Nonaktifkan memori | Menghentikan asisten merujuk memori dalam jawaban berikutnya (Fitur ini mungkin tidak menghapus memori yang sudah tersimpan - periksa asisten Anda). | Saat Anda menginginkan jawaban tanpa personalisasi |
Nonaktifkan riwayat pencarian | Menghentikan asisten menggunakan pertanyaan dan jawaban Anda sebelumnya. Menghapus sesi dari riwayat pencarian Anda akan menghilangkan pengaruhnya pada jawaban berikutnya. | Saat percakapan sebelumnya memengaruhi jawaban, Anda perlu memulai dari awal. |
Gunakan chat Incognito | Memori dan riwayat pencarian selalu nonaktif, dan pertanyaan yang diajukan di sana tidak pernah disimpan atau digunakan dalam memori. | Untuk topik sekali saja atau yang sensitif. |
Untuk memulai dari nol, nonaktifkan memori dan hapus apa yang tersimpan.
Cara Perplexity menangani memori
Memori Perplexity berfungsi di semua model yang ditawarkannya.
Perplexity mempersonalisasi jawaban dari dua sumber: memori, yaitu preferensi dan detail yang Anda bagikan, serta riwayat pencarian Anda. Saat sebuah memori memengaruhi jawaban, memori tersebut muncul di antara sumber jawaban itu, sehingga Anda dapat melihat memori mana yang digunakan dan menghapus memori mana pun.
Anda juga dapat mempersonalisasi jawaban dengan memberikan detail tentang diri Anda dan dengan memberikan instruksi khusus untuk Proyek (setiap Proyek memiliki lapisan memorinya sendiri).
Perplexity dapat menggunakan konten memori untuk meningkatkan modelnya pada akun konsumen (tidak pernah pada akun Enterprise) kecuali Anda menonaktifkannya (Retensi Data AI di Pengaturan → Preferensi → Kecerdasan Buatan).
Pelanggan Max dan Enterprise Max juga mendapatkan Brain, lapisan memori bersama yang memperluas memori dengan melacak proyek dan pekerjaan Anda. Brain memiliki sakelarnya sendiri dan mengabaikan sesi Incognito.
Coba Perplexity dan lihat bagaimana memori membentuk jawaban Anda berikutnya.
FAQ seputar memori AI
Apa itu memori terbatas dalam AI?
IBM mendefinisikan AI memori terbatas sebagai AI yang dapat mengingat peristiwa dan hasil di masa lalu serta memantau situasi dari waktu ke waktu, tetapi tidak dapat menyimpan data tersebut dalam pustaka jangka panjang berisi pengalaman masa lalu. Ini adalah salah satu dari empat kategori dalam taksonomi sistem AI, dan IBM memasukkan chatbot serta asisten virtual ke dalamnya.
Memori asisten adalah memori eksternal yang ditambahkan sistem tersebut sebagai lapisan tambahan. Memori ini tetap ada di seluruh sesi, sehingga asisten dapat menggunakan detail yang Anda bagikan dalam percakapan sebelumnya.
Asisten AI mana yang memiliki memori terbaik?
Tidak ada satu asisten pun yang terbaik untuk semua orang. Memori yang baik adalah memori yang dapat Anda kendalikan, jadi evaluasi alat AI dengan mengajukan empat pertanyaan: Dapatkah Anda melihat apa yang disimpannya? Dapatkah Anda menghapus memori secara terpisah dari chat asalnya? Apakah pelatihan merupakan pengaturan yang terpisah dari memori? Apakah ada mode sementara atau Incognito yang tidak membuat memori?
Apakah model AI belajar dari apa yang diingatnya tentang Anda?
Menggunakan memori dalam jawaban adalah proses yang berbeda dari pelatihan. Perplexity menyatakan bahwa ia mengambil konteks yang relevan dari penyimpanan memori Anda alih-alih memperlakukan riwayat Anda sebagai data pelatihan. Apakah konten Anda dapat digunakan untuk meningkatkan model merupakan pengaturan tersendiri. Pada akun konsumen, Perplexity dapat menggunakan konten memori untuk tujuan tersebut, dan Retensi Data AI akan menonaktifkannya.
Apa yang sebaiknya tidak dimasukkan ke memori AI?
Jangan masukkan ke memori AI apa pun yang tidak Anda inginkan tersimpan, digunakan untuk membuat profil Anda, atau diulang di kemudian hari: detail identitas dan keuangan, informasi kesehatan, kata sandi, informasi orang lain, dan apa pun tentang anak-anak. Kantor Komisioner Privasi Kanada (Mei 2025) dan Pusat Keamanan Siber Nasional Inggris (Maret 2023) menyarankan untuk tidak menggunakan prompt apa pun yang akan menimbulkan masalah jika menjadi publik.
Filter mengurangi risiko privasi, tetapi tidak menjamin bahwa informasi kesehatan atau keuangan Anda sama sekali tidak akan disimpan, jadi tinjau bank memori Anda dan gunakan Incognito untuk pertanyaan sensitif yang hanya sekali.