
Cara melacak dan mengendalikan pengeluaran token tim
Cara tim melihat penggunaan token mereka di dasbor dan laporan, jenis pekerjaan AI mana yang paling banyak menggunakan token, dan cara menggunakan kontrol untuk menguranginya.
Apa itu pengeluaran token
Pengeluaran token adalah jumlah token yang dikonsumsi tim saat menggunakan AI, beserta biaya token tersebut. Token adalah satuan teks, seperti kata, bagian kata, atau tanda baca, yang dibaca atau ditulis oleh model AI. Dalam bahasa Inggris, 1 token kira-kira setara dengan 4 karakter. Token tidak distandardisasi di seluruh model atau penyedia, sehingga teks yang sama dapat menghasilkan jumlah token yang berbeda di alat yang berbeda.
Laporan penggunaan biasanya membagi token menjadi beberapa jenis:
- Token input adalah semua yang dibaca model untuk sebuah permintaan. Ini mencakup kueri, teks yang dilampirkan, dan riwayat percakapan yang digunakan kembali oleh model dari bagian sebelumnya dalam utas yang sama.
- Token output adalah respons yang ditulis oleh model. Biayanya sering kali lebih tinggi daripada token input. Dalam harga API Perplexity, beberapa model mengenakan biaya enam kali lipat untuk output.
- Token penalaran adalah teks yang dihasilkan model secara internal untuk memecahkan masalah sebelum menjawab. Token ini tidak muncul dalam jawaban, sehingga respons yang terlihat lebih panjang belum tentu berarti model menggunakan lebih banyak token secara keseluruhan.
Tim yang menggunakan alat AI berbasis langganan jarang melihat biaya per token. Namun, token tetap memengaruhi apa yang mereka dapatkan, karena tugas yang lebih berat menghabiskan kredit atau mencapai batas penggunaan lebih cepat. Sebaliknya, tim yang membangun alat sendiri di atas model AI biasanya membayar per token dengan skema harga berbasis penggunaan.
Cara melacak pengeluaran token
Melacak pengeluaran token pada paket langganan
Alat berbasis langganan biasanya tidak menampilkan jumlah token. Sebagai gantinya, banyak paket menggunakan kredit, yaitu unit prabayar yang berkurang seiring pekerjaan diselesaikan. Kredit tidak sama dengan token, karena satu kredit dapat mencakup teks, gambar, atau pekerjaan lainnya. Namun, tugas yang menggunakan lebih banyak token biasanya juga menggunakan lebih banyak kredit, sehingga kredit menjadi panduan terbaik untuk memperkirakan pengeluaran token pada paket langganan. Pengguna dapat melacak penggunaan kredit mereka sendiri, dan beberapa paket juga menyertakan dasbor admin yang menampilkan penggunaan kredit untuk seluruh tim.
Di Perplexity, misalnya, pencarian biasa tidak menggunakan kredit. Hanya Perplexity Computer, asisten yang menangani tugas multilangkah, yang menggunakannya. Pengguna Computer dapat melihat berapa banyak kredit yang telah mereka gunakan dan untuk apa kredit tersebut digunakan. Setiap tugas Computer juga menampilkan total kreditnya sendiri di menu "Penggunaan" pada percakapannya.
Pada paket Enterprise, administrator dapat melihat berapa banyak orang yang menggunakan Perplexity dan berapa banyak kueri yang mereka jalankan setiap minggu di dasbor Insights (tersedia untuk organisasi dengan 50 lisensi atau lebih, atau setidaknya satu anggota Enterprise Max).
Melacak pengeluaran token dalam laporan penggunaan API
Laporan penggunaan dari penyedia API menampilkan jumlah token secara langsung, biasanya dibagi berdasarkan jenis token. Konsol API Platform Perplexity, misalnya, memungkinkan pengguna melacak metrik seperti pengeluaran token input, output, dan penalaran di halaman Penagihan.
Mengapa pengeluaran token terus meningkat
Agen menjalankan banyak langkah untuk setiap tugas, dan setiap langkah merupakan permintaan terpisah ke model. Satu tugas saja bisa menghabiskan ratusan ribu hingga jutaan token.
Model penalaran juga makin umum digunakan. Model penalaran menuliskan proses berpikirnya sebelum menjawab, dan setiap kata dari proses tersebut dihitung sebagai token. Jadi, permintaan yang sama biasanya menggunakan lebih banyak token pada model penalaran dibandingkan model standar, meskipun jawaban di layar tampak sama panjangnya.
Terakhir, seiring makin banyak orang dan alur kerja yang menggunakan AI secara umum, penggunaan token pun terus bertambah. Sebagian pertumbuhan tersebut juga berasal dari tokenmaxxing, yaitu ketika engineer menjalankan agen terutama untuk menaikkan jumlah token pribadi mereka dan mendapat peringkat lebih tinggi di papan peringkat token internal.
Cara mengurangi pengeluaran token
Sebagian besar pengeluaran token yang tinggi berasal dari beberapa jenis pekerjaan yang menggunakan lebih banyak token daripada yang terlihat.
Percakapan panjang dan tugas agen
Setiap kali model membalas, model biasanya membaca ulang seluruh percakapan hingga saat itu. Setiap permintaan baru mencakup semua riwayat percakapan sebelumnya ditambah pesan pengguna saat ini. Jadi, pertanyaan singkat di bagian akhir utas yang panjang menggunakan lebih banyak token daripada pertanyaan yang sama di utas baru. Tugas agen bekerja dengan cara yang sama, karena setiap langkah menambahkan hasilnya ke riwayat yang dibaca ulang oleh langkah berikutnya.
Cara mengatasinya
- Mulailah percakapan baru saat topik berubah. Awali dengan ringkasan dua atau tiga baris tentang apa pun dari utas lama yang masih dibutuhkan model.
- Pecah tugas agen yang panjang menjadi tugas-tugas yang lebih kecil. Jalankan setiap bagian sebagai tugas tersendiri, dan teruskan hanya hasil yang dibutuhkan bagian berikutnya.
- Periksa apakah alat agen yang digunakan tim memakai pemadatan konteks (context compaction). Pemadatan meringkas bagian tugas yang lebih lama secara otomatis sehingga model tidak perlu membaca ulang terlalu banyak. Jika suatu alat menyediakannya sebagai pengaturan, aktifkan pengaturan tersebut.
Dokumen yang sama diproses berulang kali
Saat seseorang melampirkan file panjang yang sama, seperti buku panduan kebijakan atau katalog produk, ke banyak kueri terpisah, model membaca seluruh file tersebut setiap kali. Setiap pembacaan dihitung sebagai token input.
Cara mengatasinya
- Latih pengguna untuk menyalin bagian yang relevan dari buku panduan atau katalog ke dalam permintaan, alih-alih melampirkan seluruh file.
- Buat versi singkat dari dokumen yang sering digunakan tim. Ringkasan satu halaman dari kebijakan yang panjang dapat menggantikan dokumen lengkap untuk kueri rutin.
Percobaan ulang dan perulangan
Saat jawaban tidak sesuai dengan yang dibutuhkan dan seseorang menjalankan tugas lagi, setiap percobaan menggunakan token. Hal yang sama terjadi ketika agen terjebak mengulangi langkah yang sama.
Cara mengatasinya
- Jelaskan tugas, hasil yang diinginkan, dan sumbernya secara rinci dalam permintaan pertama. Contoh: "Ringkas alasan utama pelanggan berhenti berlangganan pada kuartal ketiga, hanya menggunakan hasil survei terlampir, dalam lima poin."
- Periksa beberapa langkah pertama dari tugas agen. Jika agen mengulangi langkah atau pencarian yang sama, hentikan dan mulai ulang dengan permintaan yang lebih spesifik.
Model besar untuk tugas sederhana
Model yang lebih canggih biasanya lebih mahal per token, sehingga pekerjaan rutin seperti membuat ringkasan atau memformat ulang dapat menghabiskan anggaran tim lebih cepat dari yang seharusnya.
Cara mengatasinya
- Gunakan perutean model, yang mencocokkan setiap tugas dengan model yang mampu menanganinya. Penulisan ulang singkat atau ringkasan dapat diserahkan ke model yang lebih kecil dan lebih murah, sementara model yang paling canggih disimpan untuk penalaran atau analisis multilangkah. API Perplexity menerapkan pendekatan ini melalui preset-nya, yang menetapkan model lebih kecil untuk pencarian cepat dan model lebih besar untuk analisis menyeluruh.
Lonjakan setelah alur kerja baru
Alur kerja otomatis yang baru, atau alat yang diluncurkan ke seluruh tim, dapat meningkatkan penggunaan dalam semalam. Lonjakan itu sendiri bukanlah masalah, tetapi ada baiknya mengetahui pekerjaan mana yang menyebabkannya.
Cara mengatasinya
- Uji alur kerja baru dengan kelompok kecil terlebih dahulu. Periksa penggunaannya selama satu atau dua minggu sebelum meluncurkan alur kerja tersebut ke seluruh tim.
- Tetapkan anggaran bulanan untuk setiap tim. Dasarkan anggaran pada penggunaan bulan biasa, sehingga lonjakan mudah terlihat.
- Nonaktifkan pengisian ulang otomatis. Jika pengisian ulang otomatis dinonaktifkan, pekerjaan akan berhenti saat kredit habis, alih-alih membeli kredit tambahan secara otomatis.
Cara mengoptimalkan pengeluaran token di Perplexity
Untuk penggunaan sehari-hari
Computer menggunakan kredit, tetapi hanya berjalan saat Anda memilihnya, baik dengan memilih ikon Computer, bekerja di proyek yang secara default menggunakan Computer, maupun menggunakan mode Work di Comet.
Untuk kembali ke pencarian biasa, pilih ikon Perplexity untuk beralih kembali ke mode Ask. Untuk melihat penggunaan kredit, pengguna dapat membuka pelacak di antarmuka Perplexity.
Tim yang bekerja di proyek, ruang kerja bersama Perplexity, dapat mengatur mode default setiap proyek ke Search atau Computer. Proyek yang sebagian besar digunakan untuk penelitian singkat dapat diatur ke Search secara default, sehingga tidak ada yang memulai tugas Computer secara tidak sengaja.
Untuk administrator Enterprise
- Ketahui apa yang termasuk dalam setiap lisensi. Pengguna Enterprise Pro menerima alokasi bulanan sebesar 500 kredit, dan pengguna Enterprise Max menerima 15.000 kredit. Kredit ini kedaluwarsa di akhir setiap siklus bulanan dan tidak diakumulasikan ke siklus berikutnya.
- Tetapkan batas penggunaan default terlebih dahulu. Batas penggunaan membatasi berapa banyak kredit tambahan yang dapat diambil anggota dari kumpulan bersama setelah alokasi mereka sendiri habis.
- Buat batas bernama untuk berbagai jenis pengguna. Admin dapat menyiapkan batas seperti "Standar", "Pengguna mahir", dan "Kontraktor", lalu menetapkannya ke grup pengguna atau anggota individual. Grup dapat berasal dari Perplexity atau disinkronkan dari penyedia identitas perusahaan. Jika seseorang tergabung dalam lebih dari satu grup, batas tertinggilah yang berlaku.
- Gunakan penggantian pribadi untuk pengecualian. Jika seseorang membutuhkan batas yang berbeda dari grupnya, penggantian pribadi akan diprioritaskan di atas batas grup atau batas bersama mana pun. Ini berguna untuk proyek singkat dengan penelitian intensif, tanpa harus menaikkan batas untuk seluruh tim.
- Tetapkan batas atas untuk pengisian ulang otomatis. Pengisian ulang otomatis menambah saldo kumpulan bersama secara otomatis. Fitur ini dilengkapi batas pengisian ulang bulanan yang dapat dikonfigurasi, sehingga pengeluaran tidak dapat melampaui batas maksimum yang ditetapkan.
- Tentukan cara anggota meminta tambahan kredit. Pengaturan Izinkan anggota meminta kredit tambahan memungkinkan orang yang telah mencapai batasnya untuk meminta tambahan dari admin, alih-alih langsung dihentikan.
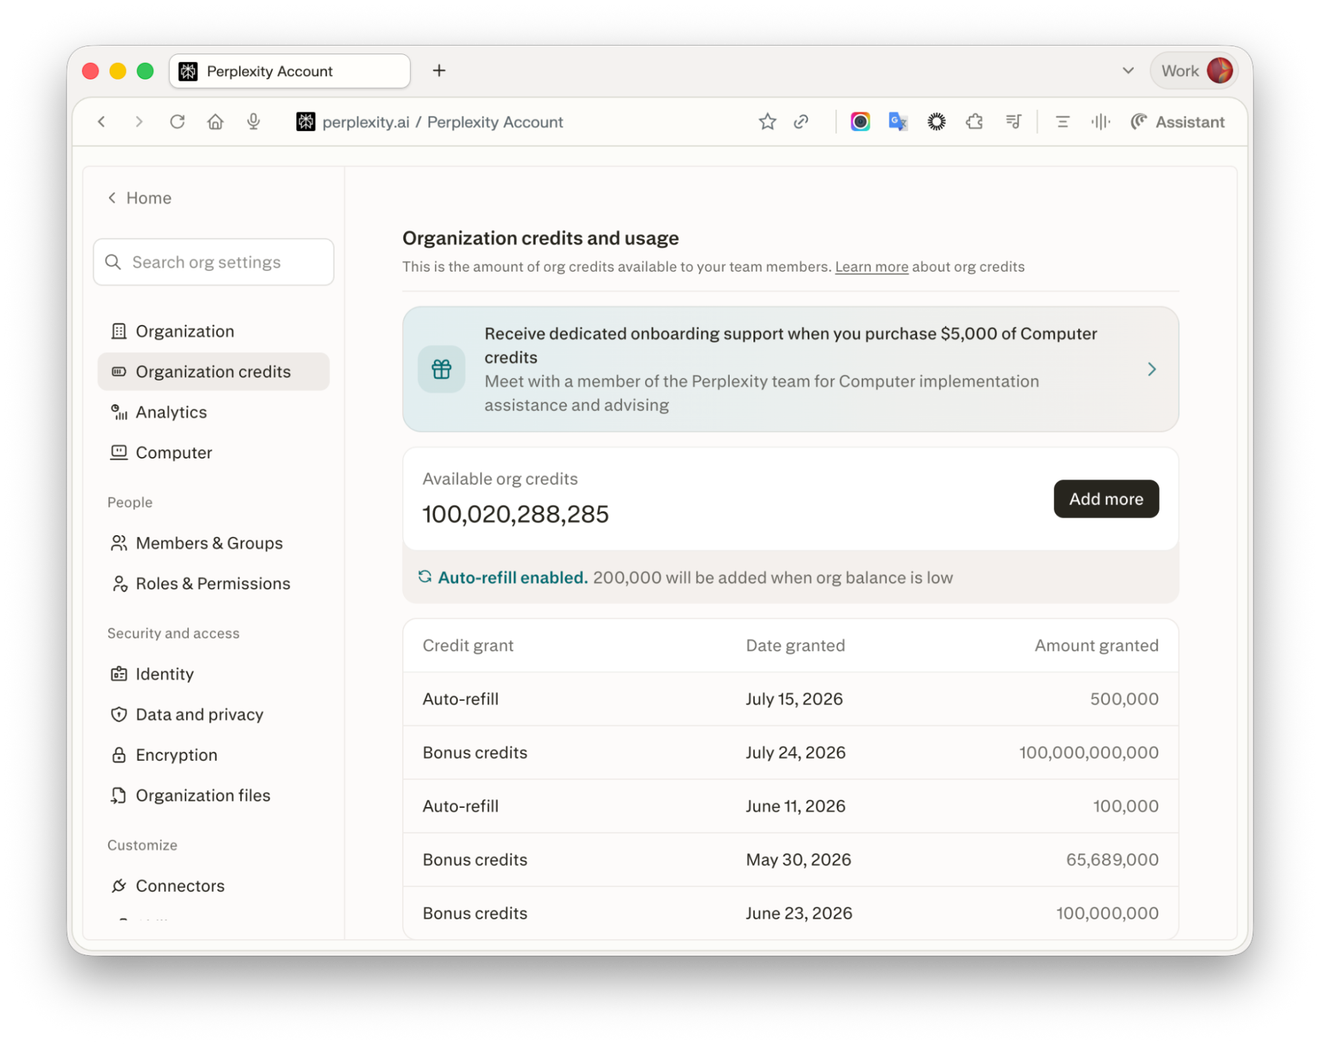
- Tinjau penggunaan setiap bulan. Halaman Kredit organisasi menampilkan kredit yang diberikan, digunakan, dan tersisa untuk setiap anggota, beserta batas grup dan saldo kumpulan. Untuk organisasi dengan 50 lisensi atau lebih, atau setidaknya satu anggota Enterprise Max, dasbor Insights juga menampilkan pengguna aktif bulanan dan kueri mingguan dari waktu ke waktu. Untuk detail lebih lanjut, log audit mencatat eksekusi tugas, penggunaan konektor, konsumsi kredit, dan pemberian kredit.
Untuk tim yang membangun di atas API
- Berikan kunci API tersendiri untuk setiap alat atau tim. Perplexity dapat menampilkan tagihan untuk setiap kunci secara terpisah, dan kunci yang terpisah memperjelas alat mana yang mendorong penggunaan.
- Periksa halaman penagihan untuk mengetahui jenis token mana yang bertambah. Halaman ini menampilkan token input, output, dan penalaran dari waktu ke waktu. Token input yang meningkat biasanya berarti suatu alat mengirimkan lebih banyak teks daripada yang diperlukan. Token penalaran yang meningkat berarti tugas dijalankan pada model yang memikirkan masalah secara panjang lebar.
- Gunakan Search API jika suatu alat hanya membutuhkan hasil pencarian. API ini mengembalikan hasil web tanpa perlu model menulis jawaban, dan mengenakan biaya per permintaan tanpa biaya tambahan berbasis token.
- Mulai alat agen dari preset. Preset Perplexity menyesuaikan ukuran tugas dengan ukuran model dan menjauhkan permintaan sederhana dari model yang paling mahal
Pekerjaan berbasis lokal
Sebagian pekerjaan sama sekali tidak memerlukan model cloud berbayar. Portable Computer adalah versi agen Perplexity yang berjalan di komputer milik pengguna sendiri, menggunakan model AI yang tersimpan di perangkat tersebut. Karena model berjalan secara lokal, pekerjaan rutin tidak menggunakan token berbayar. Agen ini hanya mengakses web, aplikasi yang terhubung, atau model cloud yang lebih kuat saat tugas membutuhkannya, dan akan meminta izin pengguna terlebih dahulu.
Pelajari cara Perplexity Computer menangani pekerjaan multilangkah di web, file, dan alat yang terhubung.
FAQ
Apa perbedaan antara pengeluaran token dan biaya AI?
Pengeluaran token mengukur seberapa banyak pekerjaan AI yang dilakukan tim, yang dihitung dalam token. Biaya AI mencakup semua yang dibayar tim untuk menggunakan AI, termasuk langganan, kredit tambahan, dan penyiapan. Pengeluaran token menentukan bagian berbasis penggunaan dari tagihan tersebut.
Apakah pengguna langganan membayar per token?
Biasanya tidak secara langsung. Alat berbasis langganan melacak penggunaan dalam bentuk pesan, kueri, atau kredit, dan tugas yang menggunakan lebih banyak token akan menghabiskannya lebih cepat. Di Perplexity, pencarian biasa sama sekali tidak menggunakan kredit; hanya tugas Computer yang menggunakannya.
Mengapa agen AI menggunakan begitu banyak token?
Agen menyelesaikan tugas dalam banyak langkah, dan setiap langkah merupakan permintaan terpisah yang membaca ulang pekerjaan yang telah dilakukan sejauh ini. Karena itu, tugas yang panjang menggunakan lebih banyak token di setiap langkah yang diambilnya.
Mengapa penggunaan token tiba-tiba melonjak?
Sebagian besar lonjakan terjadi setelah adanya perubahan dalam cara kerja tim, seperti alur kerja otomatis yang baru, alat yang diluncurkan ke lebih banyak orang, atau tugas agen yang panjang. Membandingkan tanggal lonjakan dengan peluncuran terbaru biasanya akan menunjukkan penyebabnya. Menguji alur kerja baru dengan kelompok kecil terlebih dahulu membantu mencegah lonjakan.