
AIメモリとは:その仕組みと保存される内容
AIメモリのガイド:AIアシスタントが過去の会話の詳細をどのように保存・想起するのか、何を保存するのか、メモリがうまく機能しないケース、そしてメモリを表示、編集、またはオフにする方法。
AIメモリとは、対話型AIアシスタントが過去の会話から情報を保存して新しい会話に持ち込むことで、ユーザーの好みや文脈を思い出せるようにする仕組みです。モデル自体はその情報を一切保持しません。アシスタントが情報を別途保存し、関連する場面で付け加えることで、本来モデルには備わっていない永続的なコンテキストを与えます。
このガイドでは、アシスタントがその情報をどのように保存して呼び出すのか、何を保存するのか、なぜ時に誤るのか、そして内容を確認・変更する方法やオフにする方法を説明します。
AIメモリとは?
AIメモリ(永続メモリとも呼ばれます)とは、過去のやり取りから得た好み、事実、文脈など、ユーザーに関する情報を保存し、後の会話で活用できるようにするAIアシスタントの機能を指します。
AIアシスタントは、覚えておくよう依頼された内容、自ら拾い上げた詳細、参照できる過去のチャットをもとに、その記録を作り上げます。
AIメモリレイヤーにより、AIアシスタントはチャットのたびに好みを伝えなくても、パーソナライズされた回答を提供できます。マラソンに向けてトレーニング中で、キロメートル表記を好むとアシスタントに伝えておけば、次にペースについて質問したときも、改めて伝えなくてもキロメートルで回答が返ってきます。
チャットのたびに状況を説明し直すのに比べ、メモリを使えば入力の手間が省け、プロンプトも短く保てます。入力が長いと回答の精度が下がるため、これは重要なポイントです。
メモリはすべての会話の記録ではなく、ユーザーに関する重要な事実の集まりです。そのため、キロメートル表記を好むことは覚えています。一方、先月作成したトレーニングプランそのものを見つけられるかどうかは、アシスタントが過去のチャットも検索できるかどうかによります。
AIメモリの種類
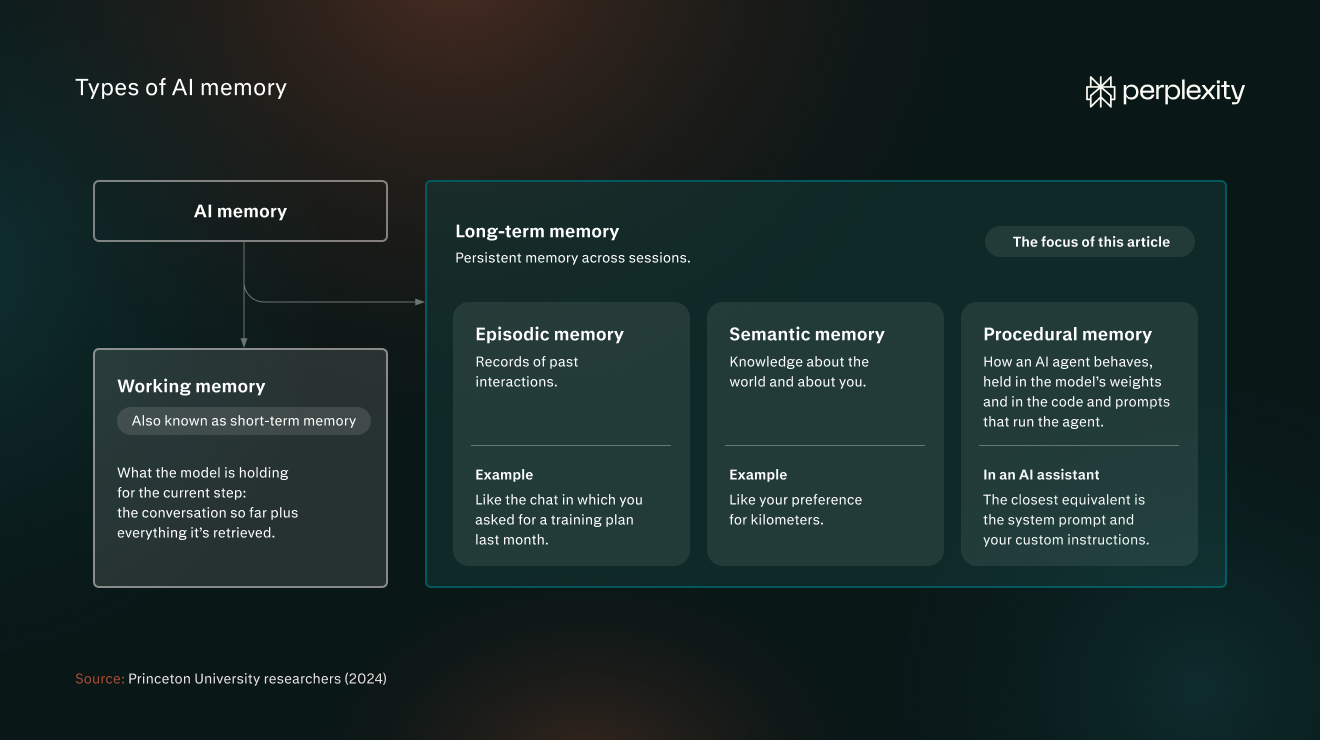
プリンストン大学の研究者(2024年)は、人間の記憶科学の用語を借りて、AIメモリシステムの種類を分類しています。この枠組みでは、ワーキングメモリと長期記憶を区別しています:
- ワーキングメモリ:現在のステップでモデルが保持している内容、つまりこれまでの会話と取得したすべての情報です。短期記憶とも呼ばれます。
- 長期記憶:セッションをまたいで持続するメモリです。本記事で扱うのはこのタイプのメモリです。
長期記憶は、次の3種類のメモリで構成されます:
- エピソード記憶:過去のやり取りの記録です。たとえば、先月トレーニングプランを依頼したチャットなどです。
- 意味記憶:世界やユーザーに関する知識です。たとえば、キロメートル表記を好むことなどです。
- 手続き記憶:AIエージェントの振る舞い方で、モデルの重みや、エージェントを動かすコードとプロンプトに組み込まれています。AIアシスタントでこれに最も近いのは、システムプロンプトとカスタム指示です。
AIアシスタントのメモリとAIエージェントのメモリの違い
AIアシスタントのメモリとAIエージェントのメモリは、どちらも長期記憶です。AIアシスタントのメモリは主に意味記憶で、ユーザーに関する事実を保存し、回答をユーザーに合わせたものにします。PerplexityのBrainのようなエージェントのメモリは、エージェントが何を行い、どのような結果になったかを、うまくいったことやユーザーが修正したことも含めて保存し、新しいタスクのたびにより良い状態から始められるようにします。
AIアシスタントのメモリ | AIエージェントのメモリ | |
記憶する内容 | ユーザー自身 | タスクとその履歴 |
目的 | ユーザーに合った回答 | 最初からやり直さずに複数ステップの作業を継続 |
例 | キロメートル表記を好むことを覚えている | マラソンのトレーニングプラン、自ら加えた調整、これまでに完了したセッションを覚えておき、今後のトレーニングブロックをより適切に計画できる |
AIメモリとコンテキストウィンドウ、学習データ、カスタム指示の違い
AIメモリは、回答を左右するほかの3つの要素、つまりモデルのコンテキストウィンドウ、学習データ、カスタム指示と混同されがちです。それぞれ保持する情報も、持続する期間も、管理するシステムも異なります。
コンテキストウィンドウとは、大規模言語モデル(LLM)が一度に読み込めるテキストの量で、現在の会話が対象となります。新しいチャットを始めるとリセットされます。
現在のモデルの中には100万トークン以上の大きなコンテキストウィンドウを持つものもあり、技術的には重要な情報を毎回の会話に貼り付けることも可能です。しかし、そのすべてを処理すると、レイテンシーとコストが増加します。
また複数の研究で、答えがコンテキスト内にある場合でも、入力が長くなるにつれて出力の精度が低下することがわかっています。
2025年のイリノイ大学とAmazonによる研究では、モデルが関連する詳細をすべて復唱できる場合でもこの現象が見られました。入力が30,000トークンに増えると精度は13.9〜85%低下し、これはモデルが公称する上限をはるかに下回る長さでした。Adobe ResearchとLMUミュンヘンによる2025年のベンチマークNoLiMaでは、質問と答えに共通するキーワードがない場合、テストした13モデルのうち11モデルで、わずか32,000トークンで性能が大幅に低下しました。Chromaの2025年7月のレポートでは、113,000トークンのチャット履歴から回答した場合も含め、18のモデルにわたってこの現象が確認されました。
学習データとは、リリース前にモデルの重みに組み込まれた情報です。ユーザーが変更することはできません。開発者は新しいデータでモデルをファインチューニングできますが、それはエンジニアリングのプロセスであり、ユーザー設定ではありません。
カスタム指示とは、AIアシスタントの振る舞いや出力をカスタマイズするために、ユーザー自身が作成・編集してアシスタントの設定に保存するルールです。たとえば、カスタム指示を使って、回答のトーンやスタイル、アシスタントが使用できる情報源を指定できます。
4つを比較すると次のとおりです:
コンテキストウィンドウ | AIメモリ | 学習データ | カスタム指示 | |
保持する内容 | 現在のチャット内のメッセージ | 保存されたユーザーに関する事実と好み | リリース前にモデルが学習した内容 | ユーザー自身が作成するガイダンス |
持続期間 | このチャット内のみ | 更新または削除されるまで | 新しいモデルがリリースされるまで固定 | ユーザーが編集するまで |
管理する主体 | ユーザー(モデルプロバイダーが設定する上限の範囲内)。 | ユーザーとアシスタント | AI企業 | ユーザー自身 |
例 | 1分前にしたペースに関する質問 | キロメートル表記を好むこと | マラソンのトレーニングプランの一般的な構成 | トレーニングプランを、行を週、列を曜日とした表形式で作成するよう求める指示 |
AIメモリが保存する内容
アシスタントは、事実、好み、要約など、ユーザーに関する選ばれた詳細を保持します。過去のチャットも参照するアシスタントもあります。
- 覚えておくよう依頼した事実と好み:「キロメートル表記が好きだと覚えておいて」のように、アシスタントに保存するよう明示的に伝えた詳細です。アシスタントは依頼された時点でメモリを作成し、そのメモリはユーザーが削除するか、後の会話で更新されるまで保持されます。
- 会話から拾い上げた詳細:設定がオンの場合、アシスタントはこれらを保存します。Perplexityは「ユーザーが質問する頻度や提供する情報の頻度を重視する」ため、一度だけ触れた内容よりも、頻繁に話題にする内容のほうが記憶に残りやすくなります。このメモリは、更新されるかユーザーが削除するまで保持されます。
- 過去のチャットへの参照:アシスタントは保存されたリストではなく、過去の会話を直接参照します。Perplexityではこれを検索履歴と呼んでおり、過去の質問と回答を使って新しい回答の関連性を高めます。
AIメモリの仕組み
AIモデルは会話と会話の間で何も記憶しません。その役割を担うのがAIメモリシステムです。ユーザーに関する記録を別途保持し、関連する部分を新しい会話のたびに追加します。保存と取得は裏側で行われ、モデルはそれらを質問と一緒に読み込みます。
このプロセスは次の5つのステップで進みます:
- 保存:アシスタントは、依頼されたとき、または保持する価値がある詳細だと判断したときにメモリを保存します。
- 格納:メモリはモデルとは別に保持されるデータベースに格納されます。多くのシステムではベクトルデータベースが使われ、意味で検索できるようになっています。設定画面に表示されるリストは、このメモリストアを表示したものです。
- 取得:メッセージを送信すると、アシスタントはどのメモリを適用するかを判断します。多くのシステムでは、メッセージと各メモリを、意味を数値で表したエンベディングに変換し、最も近いものを選びます。そのため、質問と共通する単語がなくてもメモリを呼び出せるのです。よりシンプルなシステムでは、保存されたすべてのメモリを各会話に読み込みます。
- 活用:呼び出されたメモリはプレーンテキストとして入力に挿入されます。通常は、モデルがメッセージより先に読む指示ブロックの中に入ります。モデルはそれらを、入力内のほかのテキストと同じように処理します。
- 更新と削除:アシスタントはチャットから事実を抽出し、既存のメモリを検索したうえで、新しいメモリとして追加するか、既存のメモリを更新するか、既存のメモリと統合するか、新しい情報と矛盾する古いメモリを削除するかを判断します。各メモリにタイムスタンプを付けて、新しい情報と古い情報を区別するアシスタントもあります。
AIメモリの課題とリスク
AIメモリは回答の質を高めることを目的としていますが、ベンチマークでは、特に大規模なデータベースからのメモリ取得において、関連性のある情報や最新の情報が必ずしも取り出されるとは限らないことが示されています。また、セキュリティやプライバシーのリスクもあります。
AIメモリに関連する信頼性とセキュリティの一般的な問題には、次のようなものがあります:
- メモリの誤適用:まったく関係のない回答にメモリが引き込まれることがあります。2026年の研究では、生活のある領域で保存されたメモリが別の領域の回答に漏れ出すかどうかについて、18のモデルをテストしました。失敗率の中央値は53%でした。また、メモリにユーザーの信念や自称する専門知識が保持されると、質問が中立的な回答を必要とする場合でも、ほぼすべてのモデルがそれに同調することもわかりました。
- 古くなったメモリ:後の会話で事実ではなくなった詳細に基づいて、アシスタントが動作し続けることがあります。特に、ユーザーがそれをはっきり伝えていない場合に起こりがちです。こうした暗黙の変化にモデルが気づくかどうかをテストした2026年5月のベンチマークでは、最も優れたモデルでも平均55.2%でした。
- メモリの過負荷:アシスタントが読み返す量が多いほど、重要な情報を見つけ出すのが難しくなります。2024年のベンチマークLongMemEvalでは、約115,000トークンのチャット履歴を読んだモデルは、関連するセッションのみを与えられたモデルに比べて性能が30〜60%低下しました。
- メモリポイズニング:たとえば読み込むよう依頼したコンテンツを通じて、誤った情報や隠された指示がアシスタントのメモリに入り込み、偏った回答や安全でない回答、データ漏えいにつながります。
- プライバシーのリスク:メモリは、個人情報を元のチャットを超えて、ときには想定以上に長く保持します。たとえばPerplexityでは、安全性とデバッグのために、削除されたメモリのログを最大30日間保持する場合があります。データ保護法では保存されたメモリを個人データとして扱うため、ユーザーはそれらを確認・削除できるはずです。
AIメモリを確認、編集、オフにする方法
アシスタントが保存した内容を確認・削除したり、メモリをオフにしたり、メモリを作成しないプライベートチャットを使ったりできます。
メモリの管理は、いくつかの操作に集約されます。それぞれの機能と使用する場面は次のとおりです:
操作 | 機能 | 使用する場面 |
保存内容を確認する | メモリバンクを開き、個々の項目を検索、絞り込み、確認できます。 | 予想外の詳細が回答に含まれていたとき。 |
メモリを削除する | 項目が削除され、アシスタントは以降の回答でそれを使わなくなります(アシスタントによっては、消去されたメモリのログを一定期間保持する場合があります)。 | メモリが誤っている、古くなっている、または機密性が高いとき。 |
メモリをオフにする | 今後の回答でアシスタントがメモリを参照しなくなります(すでに保存されているメモリは消去されない場合があります。お使いのアシスタントでご確認ください)。 | パーソナライズなしで回答を得たいとき |
検索履歴をオフにする | アシスタントが過去の質問と回答を使わなくなります。検索履歴からセッションを削除すると、そのセッションが以降の回答に与える影響もなくなります。 | 過去の会話が回答に影響しているときは、一からやり直したいものです。 |
シークレットチャットを使う | メモリと検索履歴は常にオフになっており、そこでした質問が保持されたり、メモリに使われたりすることはありません。 | 一時的な話題や機密性の高い話題に。 |
まっさらな状態にするには、メモリをオフにして、保存されている内容を消去します。
Perplexityのメモリの仕組み
Perplexityのメモリは提供されているすべてのモデルで機能します。
Perplexityは2つのソースから回答をパーソナライズします。1つはメモリ(あなたが共有した好みや詳細情報)、もう1つは検索履歴です。メモリが回答に影響した場合、そのメモリは回答のソースに表示されるため、どのメモリが使われたかを確認し、任意のメモリを削除できます。
また、自分についての詳細情報を提供したり、プロジェクト用のカスタム指示を設定したりすることで、回答をパーソナライズすることもできます(各プロジェクトには独自のメモリレイヤーがあります)。
Perplexityは、個人向けアカウントではメモリの内容をモデルの改善に使用する場合があります(Enterpriseアカウントでは使用しません)。これを無効にするには、「設定」→「環境設定」→「人工知能」で「AIデータ保持」をオフにします。
MaxおよびEnterprise Maxの加入者は、共有メモリレイヤーであるBrainも利用できます。Brainはプロジェクトや作業を追跡することで、メモリをさらに発展させます。独自のトグルがあり、シークレットセッションは無視されます。
Perplexityを試して、メモリが次の回答にどう影響するかを確認しましょう。
AIメモリに関するよくある質問
AIにおける限定メモリとは?
IBMの定義によると、限定メモリAIとは、過去の出来事や結果を想起し、状況を継続的に監視できるものの、そのデータを過去の経験の長期的なライブラリとして保持することはできないAIです。これはAIシステムの分類における4つのカテゴリの1つで、IBMはチャットボットや仮想アシスタントをこのカテゴリに分類しています。
アシスタントのメモリは、こうしたシステムの上に追加される外部メモリです。セッションをまたいで保持されるため、アシスタントは以前の会話であなたが共有した詳細情報を利用できます。
最も優れたメモリを持つAIアシスタントはどれですか?
すべての人にとって最適なアシスタントというものはありません。優れたメモリとは自分で管理できるメモリです。そのため、AIツールは次の4つの質問で評価しましょう。保存された内容を確認できるか?メモリを、その元になったチャットとは別に削除できるか?トレーニングはメモリとは別の設定になっているか?メモリを作成しない一時モードやシークレットモードはあるか?
AIモデルは、あなたについて記憶した内容から学習しますか?
回答にメモリを使うことは、トレーニングとは異なるプロセスです。Perplexityによると、履歴をトレーニングデータとして扱うのではなく、メモリストアから関連するコンテキストを取得しています。コンテンツをモデルの改善に使用できるかどうかは、別の設定です。個人向けアカウントでは、Perplexityがメモリの内容をその目的に使用する場合があり、「AIデータ保持」でオフにできます。
AIメモリに入れないほうがよいものは?
保存されたくないもの、プロファイリングに使われたくないもの、後で繰り返されたくないものは、AIメモリに入れないようにしましょう。たとえば、身元や金融に関する情報、健康情報、パスワード、他人の情報、子どもに関するあらゆる情報です。カナダのプライバシー・コミッショナー事務局(2025年5月)と英国国家サイバーセキュリティセンター(2023年3月)は、公開されたら問題になるようなプロンプトは入力しないよう推奨しています。
フィルターはプライバシーリスクを軽減しますが、健康情報や金融情報がまったく保存されないことを保証するものではありません。そのため、メモリバンクを確認し、一時的な機密性の高い質問にはシークレットモードを使いましょう。