
AIエージェントのコンテキストロット:長いタスクで精度が落ちる理由と防止策
AIエージェントのコンテキストに何が蓄積されるのか、それがなぜ精度を損なうのか、そして信頼性を保てるタスクの設定方法を解説するガイドです。
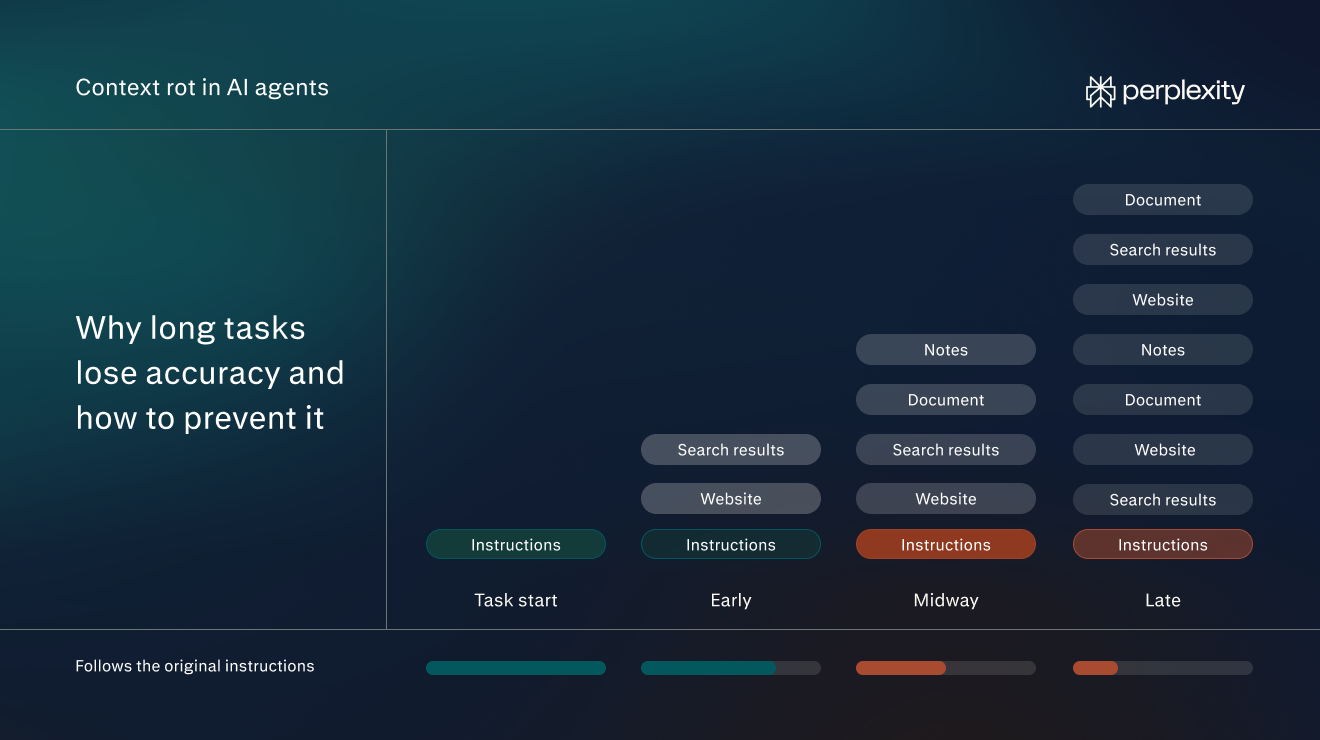
AIエージェントにとってのコンテキストロットとは
AIエージェントにおけるコンテキストロットとは、長いタスクの間にエージェントのコンテキストが埋まっていくにつれて、徐々に精度が低下していく現象です。
エージェントのコンテキストとは、モデルが次のステップで利用できる情報のことです。指示、以前のメッセージ、検索結果、Webサイトやファイルのテキストなどが含まれます。エージェントが作業を進めるにつれて、さらに情報が追加されることもあります。
たとえば、エージェントのタスクが「2週間以内に納品できるサプライヤーを探すこと」だとします。開始時点では、コンテキストにはその依頼しか含まれていません。タスクの途中になると、コンテキストには数十件のサプライヤーのWebサイトのテキスト、数ページ分の検索結果、そしてエージェントがすでに確認したサプライヤーについてのメモも含まれるようになります。
モデルが保持できるコンテキストの量には上限があります(これをコンテキストウィンドウと呼びます)。ウィンドウの大きさはトークンで測られます。トークンとはテキストの小さな単位で、通常は1つの単語または単語の一部にあたります。コンテキストロットはコンテキストが大きくなるほど進行するため、多くのステップを伴う長いタスクで最も起こりやすくなります。
コンテキストロットが悪化すると、エージェントの精度は低下します。当初の指示に従う度合いが弱まったり、細部を見落としたり、似たような情報を必要な情報と取り違えたりすることがあります。
たとえば、2週間以内に納品できるサプライヤーを探すよう指示されていたにもかかわらず、エージェントが納品に6週間かかるサプライヤーを含め始めることがあります。指示はまだコンテキスト内に残っていますが、もはやエージェントの選択に影響を与えていないのです。
コンテキストロットは、単にコンテキストウィンドウの容量が足りなくなることとは異なります。タスクのコンテキストがウィンドウを超えると、内容が切り捨てられるか、タスクが失敗します。コンテキストロットは、すべてがまだウィンドウに収まっている、そのずっと前の段階から始まります。
また、コンテキストポイズニング(誤解を招く情報や有害な情報がエージェントのコンテキストに入り込むこと)とも異なります。正確で完全な情報を持つエージェントでも、コンテキストロットは起こり得ます。
コンテキストロットが起こる理由
コンテキストロットが起こるのは、コンテキストウィンドウに余裕がある場合でも、モデルのアテンションには限りがあるためです。AIモデルにおけるアテンションとは、応答の各単語を書く際に、入力のどの部分を参照するかをモデルが決める仕組みを指す専門用語です。コンテキストのあらゆる部分が、そのアテンションを奪い合います。テキストが多いほど、各部分に向けられるアテンションは少なくなります。
たとえば、Chromaは入力の長さがAIモデルに与える影響に関する研究を発表しました。この研究では、Anthropic、OpenAI、Google、Alibabaの18のモデルがテストされました。あるテストでは、研究者たちは文章の書き方に関するアドバイスを述べた1文を、長いエッセイ集の中に隠しました。そのうえで、モデルにそのアドバイスが何だったかを尋ねました。
このテストは、毎回エッセイのテキストを追加しながら何度も実施されました。隠した文と質問は一切変えず、変えたのはその周囲のテキストの量だけです。
モデルが読まなければならないテキストが多いほど、結果は悪くなりました。この傾向は、レポート内のすべてのテストで一貫して見られました。研究者たちは、ほとんどのエージェントタスクのように多くのステップを要する実際の作業では、精度の低下がさらに大きくなると予測しています。
コンテキストロットがAIエージェントに与える影響
コンテキストロットは通常、次の4つのいずれかの形で現れます。
当初の指示を見失う
Chromaの最も単純なテストでは、同じ単語を繰り返した長い文字列の途中に別の単語を1つ挿入し、それをモデルに正確に書き写させました。明確な指示のある簡単なタスクです。それにもかかわらず、テキストが長くなるにつれて、すべてのモデルでパフォーマンスが低下しました。入力にまったく存在しない単語を出力し始めるモデルもありました。
エージェントタスクでは、ユーザーはタスクの開始時に予算や必要な形式といった具体的な制約を設定するのが一般的です。コンテキストが大きくなるにつれて、エージェントがそれらの制約を一貫して適用しなくなることがあります。原因は指示が置かれている位置ではなく、コンテキスト全体の長さにあります。
タスクの途中の詳細を見落とす
2023年のスタンフォード大学の研究によると、AIモデルが情報を最も確実に活用できるのは、その情報が入力の冒頭または末尾にある場合です。あるテストでは、研究者たちはモデルに20件の文書を与え、そのうち1件だけに答えが含まれる質問をしました。その文書が最初または最後にある場合、モデルはたいてい答えを見つけました。文書が中ほどにある場合は、答えを見落とす頻度がはるかに高くなりました。研究者たちはこれを位置効果と呼んでいます。
同じパターンはエージェントにも当てはまります。タスクの早い段階で見つけた情報は、長い会話の中ほどに埋もれてしまうことがあり、モデルによってはそうした情報を活用しにくくなります。サプライヤーの例では、エージェントがタスクの途中で確認した優良なサプライヤーが、最終リストから漏れてしまうかもしれません。
似た情報を取り違える
コンテキストが大きくなるにつれて、エージェントはどの情報が指示に合致するかを見分けるのが苦手になることがあります。たとえば、ユーザーがエージェントに「2週間以内」に発送するサプライヤーを探すよう指示したとします。あるサプライヤーのWebサイトには「注文から14暦日以内にお届け」と書かれています。短いタスクであれば、エージェントはこの2つが同じ意味だとおそらく気づくでしょう。しかし、他の数十件のサプライヤーページに埋もれていると、この一致を見落とす可能性が高くなります。
あるいは、エージェントが関係のない結果を含め始めることもあります。たとえば、エージェントがオフィスチェアのサプライヤーを探しているとします。あるサプライヤーのWebサイトでは2週間での納品をうたっていますが、それはデスクに限った話で、チェアは6週間かかります。Webサイトに指示と同じ言葉が使われているため、エージェントはそれでもこのサプライヤーをリストに加えてしまうかもしれません。研究者たちは、このような情報をディストラクター(妨害情報)と呼んでいます。関連があるように見えて実際には関連がないため、本当に重要な情報と競合してしまうのです。
Chromaの研究では、周囲のテキストの量が増えるにつれて、どちらの問題も悪化することがわかりました。
気づきにくいエラー
コンテキストロットが起きても、エラーメッセージは表示されません。エージェントは作業を続け、完成したように見える出力を返します。そのため、ミスを見逃しやすくなります。
Chromaのテストでは、こうしたミスは2つの形で現れました。1つは、モデルが自信を持って誤った回答をするケースです。サプライヤー調査の例でいえば、エージェントが見やすく整ったサプライヤーリストを提出したものの、その中に納品条件を読み違えたサプライヤーが含まれている、といった状況です。
もう1つは、実際には存在する情報を、モデルが見つけられなかったと答えるケースです。たとえば、2週間という条件を満たすサプライヤーが複数あるにもかかわらず、該当するサプライヤーはないというレポートをエージェントが提出することがあります。
コンテキストロットを減らすためのエージェントタスクの設定方法
タスクを正しく設定すれば、コンテキストロットの影響を最小限に抑え、タスク全体を通してエージェントの精度をできるだけ高く保つことができます。次のベストプラクティスが役立ちます。
タスクを「課題」として書く
明確な課題にすることで、コンテキストを小さく保てます。エージェントはいつ完了すればよいかがわかるので、十分な情報が集まった時点で収集を止めます。また、具体的な要件があれば、各ページを照らし合わせるための具体的な基準ができます。その結果、エージェントは正しい情報を見つけやすくなります。
タスクを送信する前に、次の3つが含まれているか確認しましょう。
- タスク:エージェントが何をし、何を作成すべきか。例:「サプライヤーを探して候補リストを返す」。
- 要件:エージェントが推測できない事実。例:予算、期限、納品先住所、成果物の対象者。
- 出力:形式、長さ、構成。例:「名前、チェア1脚あたりの価格、納期をまとめた表」。
これらをまとめると、サプライヤー探しのタスクのクエリは次のようになります。
「当社のシカゴオフィスに、2週間以内にオフィスチェア40脚を1脚あたり250ドル未満で納品できるサプライヤーを10社探してください。サプライヤー名、チェア1脚あたりの価格、納期、製品ページへのリンクをまとめた表を返してください。このリストは、発注を担当するオフィスマネージャー向けです。」
各タスクの焦点を絞る
1つのタスクに1つの明確な目標を設定すれば、コンテキストを小さく保てます。また、長いタスクはコストもかさみます。各ステップではそれまでに集めたすべての情報が処理されるため、コンテキストが肥大化すると、ステップごとに消費するクレジットが増えます。
複数のパートからなるプロジェクトは、次のように分割しましょう。
- 個別の成果物を書き出します。たとえば、サプライヤーの検索、価格の比較、選定したサプライヤーへのメールなどです。
- 各成果物をそれぞれ独立したタスクとして実行します。
- あるタスクから次のタスクへは、完成した結果だけを渡します。たとえば、サプライヤーの表を作成したスレッドでそのまま続けるのではなく、その表をファイルとしてアップロードして比較タスクを開始します。
こうすれば、比較タスクはすべてのページではなく、1つの表から始められます。
エージェントに適切な情報源を示す
エージェントが読むページはすべてコンテキストに追加されます。そこには、有用な部分の周りにあるメニューや広告、定型文も含まれます。エージェントに情報源を直接与えることで、そうしたノイズを減らせます。
承認済みベンダーのリストなど、タスクに必要なファイルはクエリに添付してアップロードしましょう。エージェントがWebを検索する必要がある場合は、信頼できるサプライヤー名鑑2つなど、検索する価値のあるWebサイトを指定しましょう。
情報がある場所のツールを接続しましょう。たとえばPerplexity Computerでは、サイドバーで「コネクタ」を開き、Google DriveやSlackなど、タスクに必要なアプリを有効にします。そのうえで、クエリの中でそれらに言及します。例:「Google Driveにあるチェアの仕様を使って」。コネクタはそれぞれエージェントのコンテキストを一部占有するため、関連するアプリだけを接続しましょう。
情報が「コネクタ」のリストにないアプリにある場合でも、接続できる可能性があります。多くのアプリはMCP(Model Context Protocol)コネクタを提供しています。これは、AIツールを他のソフトウェアに接続するための標準的な方法です。Computerは、組み込みのコネクタと併せてこれらを利用できます。企業アカウントの場合は、まず管理者がこれらを有効にする必要があるかもしれません。
最後に指示と照らし合わせて確認するよう依頼する
クエリの最後に、特に重要な制約を明記した確認ステップを入れましょう。
「完了する前に、すべてのサプライヤーを次の要件と照らし合わせて確認してください:2週間以内の納品、1脚あたり250ドル未満。要件を満たさないサプライヤーは除外せず、フラグを付けてください。」
制約は依然としてコンテキストの冒頭にあります。確認ステップを入れることで、指示がすべてのステップを通して影響力を保つことに頼るのではなく、エージェントが最終的な出力を制約と照らし合わせる理由が生まれます。
また、該当する結果を単に除外するのではなく、問題にフラグを付けるよう依頼すると、ミスに気づきやすくなります(たとえば、「2週間」という言葉を使っていないという理由で、14暦日以内の到着を約束しているサプライヤーを除外してしまう、といったミスです)。
チェックポイントで作業を確認する
長めのタスクでは、クエリにチェックポイントを組み込みましょう。
「まず候補となるサプライヤーを20社探して、そこで止めてください。価格情報を集める前に、私がリストを確認します。」
候補リストを当初の指示と照らし合わせて確認します。ずれている点があればフォローアップで修正し、エージェントに作業を続けさせます。この時点で見つけたミスは、その後のすべてのステップに持ち越されずに済みます。
タスクが軌道を外れたら新しいタスクを始める
修正しても同じミスを繰り返す場合は、新しいタスクを始めましょう。修正するたびに、すでに長いコンテキストにさらにテキストが追加されます。代わりに新しいタスクを作成し、指示を改めて伝え、最初の試行で得られた良い出力があればアップロードして、やり直します。
エージェントの中には、これに近いことを自動的に行うものもあります。これはコンパクションと呼ばれるプロセスです。タスクが長くなると、エージェントは古い情報(たとえば、序盤に読んだページの全文)を、そこで見つけた内容の短い要約に置き換えます。PerplexityのPortable Computerはこの方法でコンテキストをコンパクションするため、モデルは適切に処理できる量の範囲内に収まります。
目標が変わった場合も、新しいタスクを始めることが重要です。サプライヤー探しとして始まったスレッドで、契約書のレビューまで行うべきではありません。
繰り返し使う指示をスキルにする
好みの表の形式、避けるべきベンダーのリスト、標準的な確認ステップなど、特定の種類のタスクで毎回必要になる指示があります。Computerでは、これらをスキルとして保存できます。スキルとは、エージェントが毎回従う再利用可能な指示のセットです。スキルにより、ほかのベストプラクティスが、そのスキルを使用するすべてのタスクに組み込まれます。
設定方法:
- サプライヤー調査など、頻繁に発生するタスクを選びます。
- 毎回伝えている指示(形式、確認事項、使用する情報源や避ける情報源)を書き出します。
- それらをスキルとして保存します。すでにMarkdownで書かれた指示は、そのままインポートできます。
- 今後のクエリでスキルの名前を指定します。例:「サプライヤー調査スキルを使って、デンバーオフィス用の椅子のサプライヤーを探して」
エージェント作業におけるPerplexityのコンテキストへのアプローチ
Perplexity Computerは、各モデルのコンテキストを小さく、関連性の高い状態に保つ方法で長いタスクを処理します。その設計の3つの要素が、モデルが一度に読む必要のある量を制限しています。
サブエージェントに作業を分担させる
Computerは依頼をタスクとサブタスクに分解し、それらを実行するサブエージェントを作成します。各サブエージェントは、独自のコンテキストで作業の一部を担当します。サプライヤーのタスクでは、あるサブエージェントが価格を調べ、別のサブエージェントが納品条件を確認するといった具合です。どちらも、もう一方が読んだ内容をすべて読む必要はありません。
作業をファイルに保存する
Computerの各タスクには、専用のファイル、Webブラウザ、ツールを備えた独自のワークスペースが用意されます。エージェントは、確認済みのサプライヤーを随時記録する表など、作業内容をファイルに保存できます。そして、必要なときにだけそのファイルを再び開きます。
検索結果から関連する箇所を選び出す
Webページには、メニュー、広告、メタデータ、他のトピックに関するテキストなど、モデルが必要としない情報があふれています。クエリを考慮したコンテキスト圧縮は、それらを取り除きます。ページがモデルに届く前に、Perplexityはクエリに関連する文だけを残します。
これらのステップを実践するには、Perplexity Computerのヒント、ガイド、タスク例をご覧ください。
よくある質問
コンテキストロットはハルシネーションと同じですか?
いいえ。ただし、両者は関連しています。ハルシネーションとは、誤った内容や根拠のない内容を述べる回答全般を指します。コンテキストロットは、指示の無視や詳細の見落としといった他のミスと並んで、ハルシネーションを起こりやすくする条件の1つです。
より良いクエリでコンテキストロットは解消できますか?
明確なクエリはタスクの焦点を絞ることで、コンテキストロットを軽減します。ただし、コンテキストが大きくなること自体は防げません。タスクが十分に長くなれば、それでもエージェントは有効に活用できる以上の情報を集めてしまいます。だからこそ、作業を分割し、途中で確認することが、クエリそのものと同じくらい重要なのです。
コンテキストロットは、エージェントだけでなく通常のAIチャットにも影響しますか?
はい。チャットでは、すべてのメッセージや、貼り付けたりアップロードしたりしたドキュメントを含む、それまでの会話全体がコンテキストになります。複数のトピックにわたって何時間も続いたスレッドでは、長いエージェントタスクと同じミスが発生することがあります。新しいトピックごとに新しいスレッドを始めれば、それぞれの会話の焦点を保てます。
タスクがどのくらい長くなると、コンテキストロットが起き始めますか?
決まった境界はありません。モデルとタスクによって異なります。たとえば、26万トークンのコンテキストウィンドウを持つオンデバイスモデルは、約10万トークンを超えると苦戦し始めます。これは上限を大きく下回る水準です。また、精度の低下は突然ではなく、徐々に進みます。