
チームのトークン消費を把握し、管理する方法
チームがダッシュボードやレポートでトークン使用量を確認する方法、最も多くのトークンを使うAI作業の種類、そして管理機能を使って削減する方法を紹介します。
トークン消費とは
トークン消費とは、チームがAIの利用で消費するトークンの数と、そのトークンにかかるコストのことです。トークンとは、AIモデルが読み書きするテキストの単位で、単語、単語の一部、句読点などがこれにあたります。英語では、1トークンはおよそ4文字に相当します。トークンはモデルやプロバイダー間で標準化されていないため、同じテキストでもツールによってカウントが異なる場合があります。
利用状況レポートでは、通常、トークンはいくつかの種類に分けて表示されます。
- 入力トークンは、モデルが1回のリクエストで読み込むすべてのテキストです。これには、クエリ、添付されたテキスト、そして同じスレッド内でモデルが以前のやり取りから再利用する会話履歴が含まれます。
- 出力トークンは、モデルが書き出す回答です。出力トークンは入力トークンよりも高額になることがよくあります。PerplexityのAPI料金では、出力に6倍の料金がかかるモデルもあります。
- 推論トークンは、モデルが回答する前に問題を解くために内部で生成するテキストです。回答には表示されないため、目に見える回答が長いからといって、モデルが全体としてより多くのトークンを使ったとは限りません。
サブスクリプションでAIツールを利用しているチームが、トークン単位の料金を目にすることはほとんどありません。それでもトークンは利用できる量を左右します。負荷の高いタスクほどクレジットを早く消費したり、利用上限に早く達したりするためです。一方、AIモデルを使って独自のツールを構築するチームは、通常、従量課金制のもとでトークン単位で料金を支払います。
トークン消費を把握する方法
サブスクリプションプランでトークン消費を把握する
サブスクリプション型のツールでは、通常、トークン数は表示されません。その代わり、多くのプランではクレジットを採用しています。クレジットとは前払いの単位で、作業が進むにつれてプランから差し引かれます。1クレジットでテキスト、画像、その他の作業をまかなえることもあるため、クレジットはトークンと同じではありません。ただし、より多くのトークンを使うタスクは通常より多くのクレジットも消費するため、サブスクリプションにおけるトークン消費の目安としてはクレジットが最適です。ユーザーは自分のクレジット使用量を確認でき、プランによってはチーム全体のクレジット使用量を表示する管理者ダッシュボードも利用できます。
たとえばPerplexityでは、通常の検索ではクレジットを消費しません。クレジットを使うのは、複数ステップのタスクを処理するアシスタントであるPerplexity Computerだけです。Computerを利用するユーザーは、これまでに使用したクレジット数とその用途を確認できます。また、各Computerタスクの会話にある「使用状況」メニューには、そのタスクのクレジット合計も表示されます。
Enterpriseプランでは、管理者はInsightsダッシュボードで、Perplexityを利用している人数と、毎週実行されているクエリ数を確認できます(50シート以上の組織、または1人以上のEnterprise Maxメンバーがいる組織で利用可能)。
APIの利用状況レポートでトークン消費を把握する
APIプロバイダーの利用状況レポートにはトークン数が直接表示され、通常はトークンの種類ごとに分かれています。たとえばPerplexityのAPI Platformコンソールでは、「請求」ページで入力、出力、推論トークンの消費量などの指標を確認できます。
トークン消費が増えている理由
エージェントは1つのタスクで多くのステップを実行し、各ステップはモデルへの個別のリクエストになります。1つのタスクで数十万、場合によっては数百万トークンに達することもあります。
推論モデルも普及しつつあります。推論モデルは回答する前に思考過程を書き出し、そのすべての語がトークンとしてカウントされます。そのため、画面上の回答の長さが同じに見えても、同じリクエストで推論モデルは標準モデルより多くのトークンを使うのが一般的です。
さらに、AIを使う人やワークフローが全般的に増えるにつれて、トークン使用量も積み重なっていきます。この増加の一部は「トークンマキシング(tokenmaxxing)」によるものでもあります。これは、エンジニアが主に個人のトークン数を増やし、社内のトークンリーダーボードで上位に入るためにエージェントを実行する行為です。
トークン消費を削減する方法
トークン消費が多くなる原因のほとんどは、見た目以上に多くのトークンを使う、いくつかの種類の作業にあります。
長い会話とエージェントタスク
モデルは返信するたびに、通常それまでの会話全体を読み直します。新しいリクエストには、それまでのすべての会話履歴と現在のユーザーメッセージが含まれます。そのため、長いスレッドの終盤で短い質問をすると、新しいスレッドで同じ質問をするよりも多くのトークンを使います。エージェントタスクも同じ仕組みで、各ステップの結果が履歴に追加され、次のステップでそれを読み直します。
対処法
- 話題が変わったら新しい会話を始めましょう。その際、以前のスレッドの内容のうちモデルが引き続き必要とするものを2~3行で要約し、冒頭に入れます。
- 長いエージェントタスクは小さなタスクに分割しましょう。各部分を個別のタスクとして実行し、次の部分に必要な結果だけを引き継ぎます。
- チームのエージェントツールがコンテキストの圧縮(コンパクション)に対応しているか確認しましょう。コンパクションは、タスクの古い部分を自動的に要約し、モデルが読み直す量を減らします。ツールに設定項目として用意されている場合は、有効にしましょう。
同じドキュメントの繰り返し処理
ポリシーハンドブックや製品カタログなど、同じ長いファイルを多数の個別のクエリに添付すると、モデルはそのたびにファイル全体を読み込みます。読み込むたびに入力トークンとしてカウントされます。
対処法
- ファイル全体を添付するのではなく、ハンドブックやカタログの該当部分をリクエストにコピーするようユーザーに指導しましょう。
- チームがよく使うドキュメントの短縮版を作成しましょう。長いポリシーを1ページにまとめた要約があれば、日常的なクエリでは元のドキュメントの代わりに使えます。
再試行とループ
回答が求めていたものと違い、タスクをもう一度実行すると、試行のたびにトークンを使います。エージェントが同じステップを繰り返して行き詰まった場合も同様です。
対処法
- 最初のリクエストで、タスク、求める結果、使用するソースを明確に指定しましょう。たとえば「添付のアンケート結果のみを使って、第3四半期に顧客が解約した主な理由を5つの箇条書きで要約してください」のように指定します。
- エージェントタスクの最初の数ステップを確認しましょう。エージェントが同じステップや検索を繰り返している場合は停止し、範囲を絞ったリクエストでやり直します。
単純なタスクに大規模モデルを使う
高性能なモデルほどトークン単価が高くなる傾向があるため、要約や書式変更などの日常的な作業でも、必要以上に早くチームの予算を使い切ってしまうことがあります。
対処法
- モデルルーティングを活用しましょう。モデルルーティングとは、各タスクをそれを処理できるモデルに割り当てる仕組みです。短い書き直しや要約は小型で安価なモデルに任せ、最も高性能なモデルは複数ステップの推論や分析に充てます。PerplexityのAPIはプリセットでこのアプローチを採用しており、簡単な調べものには小型モデルを、徹底的な分析には大型モデルを割り当てます。
新しいワークフロー導入後の急増
新しい自動化ワークフローや、チーム全体に展開したツールによって、使用量が一夜にして増えることがあります。急増自体は問題ではありませんが、どの作業が原因なのかを把握しておく価値はあります。
対処法
- 新しいワークフローは、まず少人数のグループでテストしましょう。チーム全体に展開する前に、1~2週間その使用量を確認します。
- チームごとに月間予算を設定しましょう。通常の月の使用量を基準にすると、急増が目立つようになります。
- 自動チャージをオフにしましょう。自動チャージをオフにすると、クレジットが自動的に追加購入されることはなく、クレジットがなくなった時点で作業が停止します。
Perplexityでトークン消費を最適化する方法
日常的な利用の場合
Computerはクレジットを消費しますが、実行されるのはユーザーが選んだときだけです。具体的には、Computerアイコンを選択したとき、デフォルトがComputerに設定されたプロジェクトで作業しているとき、またはComet Workモードを使用しているときです。
通常の検索に戻るには、Perplexityアイコンを選択してAskモードに切り替えます。クレジットの使用状況を確認するには、Perplexityのインターフェース内でトラッカーを開きます。
Perplexityの共有ワークスペースであるプロジェクトで作業するチームは、プロジェクトごとにデフォルトモードを検索またはComputerに設定できます。主に簡単なリサーチに使うプロジェクトのデフォルトを検索にしておけば、誤ってComputerタスクを開始するのを防げます。
Enterprise管理者向け
- 各シートに含まれる内容を把握しましょう。Enterprise Proユーザーには毎月500クレジット、Enterprise Maxユーザーには15,000クレジットが割り当てられます。これらのクレジットは毎月のサイクルの終わりに失効し、翌月に繰り越されません。
- まずデフォルトの利用上限を設定しましょう。利用上限とは、メンバーが自分の割り当てを使い切った後に、共有プールから追加で使用できるクレジットの上限です。
- ユーザーの種類ごとに名前付きの上限を作成しましょう。管理者は「標準」「パワーユーザー」「業務委託」などの上限を設定し、ユーザーグループや個々のメンバーに割り当てることができます。グループはPerplexity上で作成することも、会社のIDプロバイダーから同期することもできます。複数のグループに所属している場合は、最も高い上限が適用されます。
- 例外には個人オーバーライドを使いましょう。グループとは異なる上限が必要なメンバーがいる場合、個人オーバーライドはグループや共有の上限よりも優先されます。チーム全体の上限を引き上げることなく、調査量の多い短期プロジェクトに対応できるので便利です。
- 自動チャージに上限を設けましょう。自動チャージは共有プールを自動的に補充します。月間の補充上限を設定できるため、上限なく支出が増え続けることはありません。
- メンバーが追加を依頼する方法を決めましょう。「メンバーにクレジットの追加リクエストを許可」設定を有効にすると、上限に達したメンバーは利用を完全に止められるのではなく、管理者に追加のクレジットをリクエストできます。
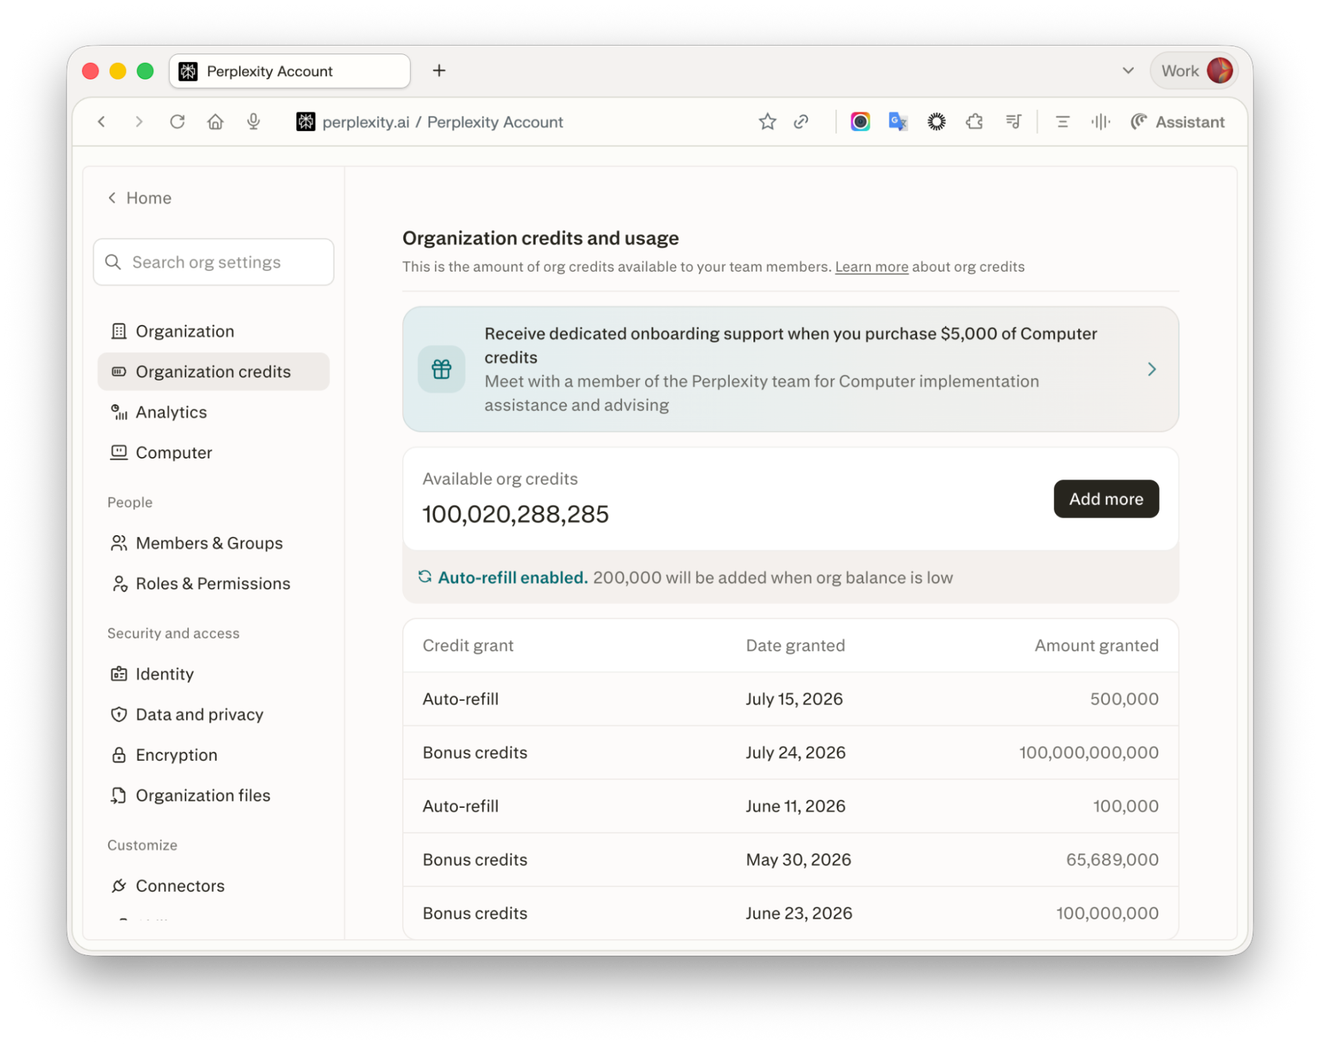
- 毎月使用状況を確認しましょう。「組織のクレジット」ページには、メンバーごとの付与済み、使用済み、残りのクレジットに加え、グループの上限やプールの残高が表示されます。50シート以上の組織、または1人以上のEnterprise Maxメンバーがいる組織では、Insightsダッシュボードで月間アクティブユーザー数と週ごとのクエリ数の推移も確認できます。さらに詳しく確認するには監査ログを利用できます。監査ログには、タスクの実行、コネクタの使用状況、クレジットの消費、クレジットの付与が記録されます。
APIで開発するチーム向け
- ツールやチームごとに個別のAPIキーを発行しましょう。Perplexityではキーごとに請求額を確認でき、キーを分けることで、どのツールが使用量を押し上げているかが明確になります。
- 請求ページで、どの種類のトークンが増えているかを確認しましょう。請求ページには、入力、出力、推論トークンの推移が表示されます。入力トークンが増えている場合は、通常、ツールが必要以上のテキストを送信していることを示しています。推論トークンが増えている場合は、問題をじっくり考えるモデルでタスクが実行されていることを意味します。
- ツールに必要なのが検索結果だけなら、Search APIを使いましょう。Search APIはモデルに回答を作成させることなくウェブ検索結果を返し、料金はリクエスト単位で、トークンベースの追加料金はかかりません。
- エージェントツールはプリセットから始めましょう。Perplexityのプリセットは、タスクの規模に合ったサイズのモデルを割り当て、簡単なリクエストに最も高価なモデルが使われないようにします。
ローカルファーストの作業
有料のクラウドモデルをまったく必要としない作業もあります。Portable Computerは、ユーザー自身のコンピューター上で動作するPerplexityのエージェントで、そのマシンに保存されたAIモデルを使用します。モデルがローカルで動作するため、日常的な作業では有料のトークンを消費しません。ウェブや連携アプリ、より高性能なクラウドモデルにアクセスするのはタスクで必要な場合だけで、その際も事前にユーザーに確認します。
ウェブ、ファイル、連携ツールをまたいでPerplexity Computerが複数ステップの作業を処理する仕組みをご覧ください。
よくある質問
トークン消費とAIコストの違いは何ですか?
トークン消費は、チームが行うAI作業の量をトークン単位で測ったものです。AIコストは、サブスクリプション、追加クレジット、導入費用など、チームがAIを利用するために支払うすべての費用を指します。トークン消費は、その請求のうち従量課金部分を左右します。
サブスクリプションユーザーはトークン単位で料金を支払うのですか?
通常、直接的には支払いません。サブスクリプション型のツールでは、使用量をメッセージ数、クエリ数、またはクレジットで管理しており、より多くのトークンを使うタスクほどそれらを早く消費します。Perplexityでは、通常の検索ではクレジットをまったく消費せず、クレジットを消費するのはComputerのタスクだけです。
AIエージェントはなぜそれほど多くのトークンを使うのですか?
エージェントは多くのステップを経てタスクを完了し、各ステップはそれまでの作業を読み直す個別のリクエストです。そのため、長いタスクではステップを重ねるごとに使用するトークンが増えていきます。
トークン使用量が急増するのはなぜですか?
急増の多くは、新しい自動化ワークフローの導入、より多くの人へのツールの展開、長時間のエージェントタスクなど、チームの働き方の変化に続いて起こります。急増した日付を最近導入・展開したものの時期と照らし合わせると、通常は原因がわかります。新しいワークフローをまず少人数のグループでテストすると、急増を防ぐのに役立ちます。