
検索エンジンの種類:クローラー、メタ検索、AIアンサーエンジン
クローラー型、メタ検索、AIアンサーエンジンが検索結果を見つけて返す仕組みと、プライバシー重視型や有料型からバーティカル型、地域型、エンタープライズ型まで、その他の種類の検索エンジンを紹介します。
検索エンジンの種類による主な違いは、情報の取得元と、返される結果の種類です。
クローラー型エンジンは自ら構築したインデックスを検索し、メタ検索エンジンは他の複数のエンジンの結果を組み合わせます。AI回答エンジンもインデックス化されたソースを使いますが、他の種類とは異なり、リンクの一覧を提示するのではなく、その情報を使って質問に合わせた回答を作成します。
ここでは、検索エンジンの3つの主要な種類の仕組みを、例を交えて紹介します。また、目にする機会のあるその他の種類(プライバシー重視型、有料型、バーティカル型、地域特化型、エンタープライズ向けの各エンジン、そしてウェブディレクトリ)や、検索エンジンを選ぶ際に役立つ問いについても取り上げます。
検索エンジンとは?
検索エンジンとは、検索クエリに一致するコンテンツを見つけ、検索結果として返すソフトウェアです。
GoogleやBingのようなインターネット検索エンジンはワールドワイドウェブを検索しますが、求人サイトや研究論文データベースなど、特定のコレクション内を検索するものもあります。
種類によって、検索結果はページへのリンクをランク付けした一覧の場合もあれば、見つけたソースをもとに作成された回答文の場合もあります。
検索エンジンとウェブブラウザの違い
ウェブブラウザは、PerplexityのComet、Chrome、Safari、Edge、Firefoxなど、ウェブページを開いて表示するためのアプリです。一方、検索エンジンは、そうしたページを見つけてくれるサービスです。
ブラウザのアドレスバーにウェブアドレスを入力すると、そのページに移動します。代わりに検索語を入力すると、ブラウザの設定でデフォルトを変更していない限り、ブラウザはそれをデフォルトの検索エンジン(CometならPerplexity、ChromeならGoogle検索、EdgeならBing)に送信します
検索エンジンの3つの主要な種類
検索エンジンは、結果の取得元と結果の見え方が異なります。結果の取得元は、エンジン独自のインデックス、ライセンス契約に基づく他のエンジンのインデックス、または同時に利用する複数のエンジンのいずれかであり、結果はページのランク付き一覧か、引用付きの回答文として表示されます。
クローラー型エンジンとメタ検索エンジンは、どちらもランク付けされたリンクの一覧を返しますが、結果の取得方法は異なります。クローラー型エンジンは自ら構築したインデックスを検索するのに対し、メタ検索エンジンはクエリを他の複数のエンジンに送信し、返された結果を組み合わせます。
AI回答エンジンもインデックスを検索しますが、従来の検索エンジンのようにページを一覧表示するのではなく、回答を作成します。現在では、その両方を行うエンジンも多くあります。Google、Bing、Brave Searchは、ランク付けされたリンクの上にAIが作成した回答を表示します。
種類 | 結果の取得元 | 得られるもの | 最適な用途 | トレードオフ | 例 |
クローラー型 | 独自のインデックス、またはクローラー型エンジンからライセンス提供を受けたインデックス | ランク付き一覧(AI回答を追加するエンジンも多数) | 幅広い検索、特定のページの検索 | 1つのエンジンから見たウェブのみ。ページの比較は自分で行う | Google、Bing、Brave Search、DuckDuckGo |
メタ検索 | 複数のエンジンを同時に利用 | ランク付き一覧 | より幅広い検索結果 | 低速:複数のエンジンの応答を待つ(制限時間あり) | eTools.ch、SearXNG、MetaGer |
AI回答エンジン | 独自のインデックス、またはライセンス提供を受けたインデックス | 引用付きの回答文 | 複数のソースを必要とする複雑な質問 | 引用元のページを確認する必要がある | Perplexity、Google AIモード |
クローラー型検索エンジン
GoogleやBingのようなクローラー型検索エンジンは、独自のインデックスに登録されたウェブページから、クエリへの回答を見つけます。幅広いウェブ検索や、特定のサイトやページを探すのに最適です。
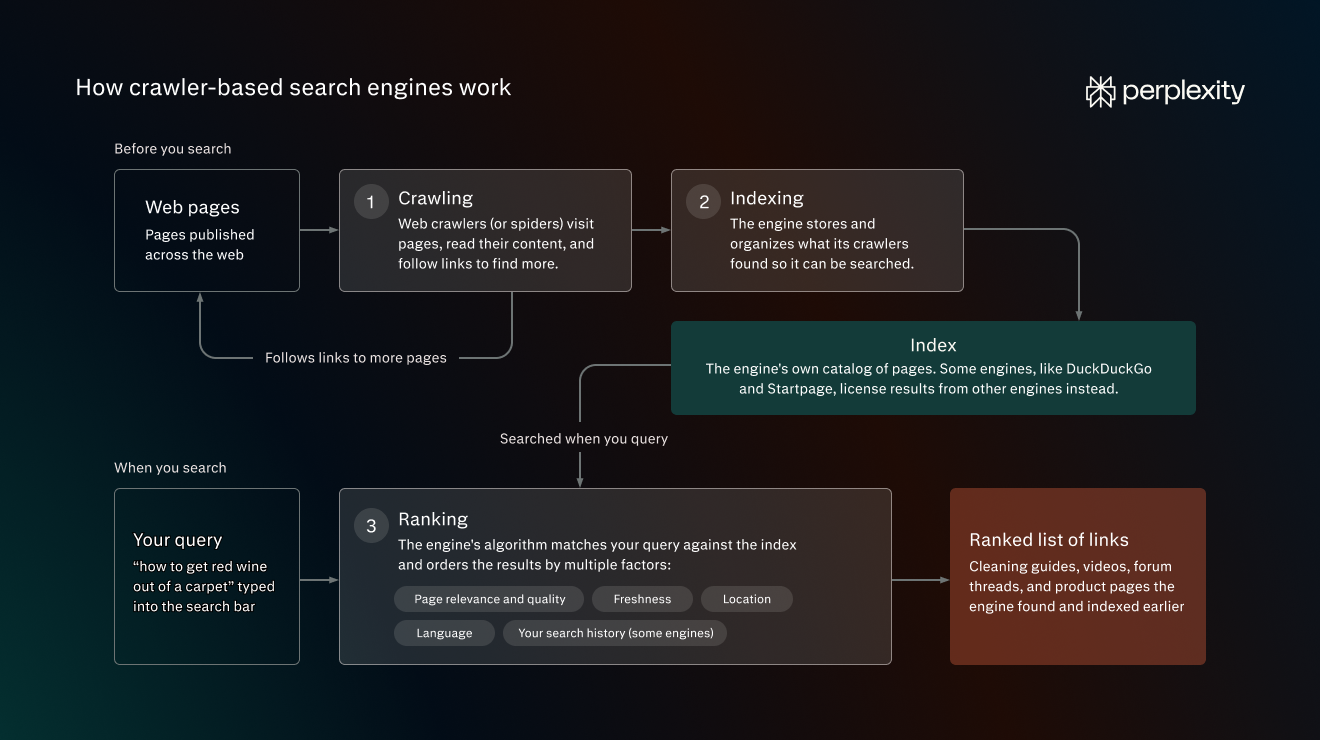
クローラー型検索エンジンの仕組みは次のとおりです。
- クロール:ウェブクローラー(またはスパイダー)と呼ばれるプログラムがページを訪れ、内容を読み取り、リンクをたどってさらに多くのページを見つけます。
- インデックス作成:エンジンは、クローラーが見つけた情報を検索できるように保存・整理します。
- ランキング:検索を行うと、エンジンのアルゴリズムがクエリをインデックスと照合し、ページの関連性や品質、鮮度、場所、言語、さらに一部のエンジンでは検索履歴など、複数の要素に基づいて結果を並べ替えます。
そのため、検索バーに「カーペットについた赤ワインの落とし方」と入力すると、検索結果ページには、検索エンジンが以前に発見してインデックスに登録した掃除ガイド、動画、フォーラムのスレッド、商品ページがランク付けされて一覧表示されます。
クローラー型エンジンで上位に表示されるように、検索エンジン最適化(SEO)の専門家は、重要なページがすべてクロールやインデックス登録されやすく、キーワードの背後にあるクエリに競合ページよりも的確に答えられるようにします。
検索市場で最大のシェアを持つGoogle検索は、最もよく知られたクローラー型エンジンです。その他にも、Bing、Brave Search、そして英国のMojeekやスウェーデンのMarginaliaといった独立系エンジンがあります。
自らウェブをクロールせず、他のエンジンから結果のライセンス提供を受けているエンジンもあります。たとえば、DuckDuckGoは従来型のリンクの大部分をBingから取得しており(独自のクローラーも併用)、StartpageはGoogleとBingから取得しています。
メタ検索エンジン
メタ検索エンジンは、クエリを他の複数の検索エンジンに送信し、その結果を組み合わせます。たとえば、eTools.chは17種類のデータソースを検索します。
メタ検索エンジンは、次の4つのステップで検索クエリに回答します。
- 複数のエンジンに同時にクエリを送信します。
- 各エンジンから結果を収集します。
- 重複を統合し、スコアを付け直します。たとえば、複数のエンジンがあるページを上位にランク付けしている場合、そのページの順位が上がります。
- ランク付けされた結果を1つのページに表示します。
eTools.chで「カーペットについた赤ワインの落とし方」を検索すると、DuckDuckGo、Yahoo、Googleなどからの結果が表示されます。私たちのテストでは、Googleで1位だった結果が、ここでは4位にとどまりました。
メタ検索エンジンは、より広く検索の網を張りたいときに適していますが、複数のエンジンの応答を(制限時間まで)待つため、読み込みに時間がかかることがあります。
eTools.ch以外の人気のメタ検索エンジンには、SearXNG、MetaGer、Dogpileなどがあります。
DuckDuckGoはメタ検索エンジンの一覧に挙げられることがありますが、複数のエンジンの結果を組み合わせているのではなく、Bingから結果のライセンス提供を受けています。
AI回答エンジン
PerplexityのようなAI検索エンジンは、ソースを検索し、それらを使って具体的な質問に対する回答を作成します。回答には、使用したページへのリンク付きの引用が添えられます。
AI回答エンジンの仕組み:
- 質問を読み取る:大規模言語モデル(LLM)が、長い会話調の質問も含めてクエリを解釈し、複数の検索に分割することがあります。このプロセスはクエリファンアウトと呼ばれます。
- ソースを検索する:それらの検索をウェブインデックスに対して実行するため、モデルの学習後に公開されたページも回答に活用できます。また、ページ全体だけでなく個々のパッセージについても、質問との関連性をスコアリングします。
- 回答を作成する:LLMが、取得したパッセージをもとに回答を作成します。
クローラー型エンジンと同様に、AI回答エンジンも独自またはライセンス提供を受けたインデックスを検索します。たとえば、Perplexityは独自のインデックスを運用しており、ChatGPT Searchは独自のインデックスとサードパーティのインデックスを組み合わせて使用しています。
AI回答エンジンは複数のソースの情報をまとめて回答を作成するため、1つのページでは答えが得られにくい複雑な質問や具体的な質問に最適です。
たとえば、Perplexityに「16歳の娘がイリノイ州で仮免許(ラーナーズパーミット)を持っていますが、3月にアリゾナ州へ引っ越します。今のうちに運転練習時間の記録を続けるべきですか?アリゾナ州ではその時間が認められますか?また、アリゾナ州の自動車局(MVD)には何を持っていく必要がありますか?」と尋ねたところ、15のソースを使って質問の各部分に回答しました。
Googleの従来型のランク付き検索結果(AI による概要なし)では、同じ質問に対してページの一覧が返されるため、各ページを開いて関連情報を自分で探す必要があります。
ただし、LLMは回答を作成する際にハルシネーションを起こす可能性があるため、AIの回答に頼る前に、引用元のページを開いてその内容を確認してください。
AIの回答で引用されるには、ウェブページにも同じSEOの基盤が必要です。ただし、回答エンジン最適化(AEO)では、AI回答エンジンがコンテンツを処理・引用しやすくすることにより重点を置きます。たとえば、文脈から切り離されても、それぞれが1つの具体的な質問に明確に答えるセクションを設けることなどです。
その他の種類の検索エンジン
検索エンジンは、目的、対象ユーザー、ビジネスモデルによって分類することもできます。これらの分類の一部は、3つの主要な種類と重なります。たとえば、プライバシー重視型のエンジンは、独自のインデックスを運用することも、結果のライセンス提供を受けることもあります。
種類 | 特徴 | 最適な用途 | トレードオフ | 例 |
プライバシー重視型 | 個人データを追跡しない | 履歴と結び付けられたくない検索 | パーソナライズされた結果がない | DuckDuckGo、Startpage |
有料型・広告なし | 広告ではなくサブスクリプションで運営 | 広告や広告ターゲティングのない結果 | 短期間の無料トライアル後はサブスクリプションが必要 | Kagi |
バーティカル型 | 1種類のコンテンツを検索 | 専門的なコンテンツと、そのコンテンツ向けのフィルター | そのコレクション以外は対象外 | PubMed、Indeed、YouTube |
地域特化型 | 1つの国や言語に最適化 | その言語での検索や地域情報の検索 | 本拠地の言語・市場以外ではカバー範囲が弱い | Yandex、Seznam、Baidu、Naver |
Webディレクトリまたはハイブリッド | 人間の編集者が選んだサイト。フィルタリングしたクローラーの結果と組み合わせる場合もある | 特定のトピックや対象者向けの、精査された出発点 | 結果がはるかに少なく、更新が遅い | Curlie、MedlinePlus、Kiddle、fragFINN |
エンタープライズ | 組織独自のアプリやファイルを検索する | 社内の文書、メッセージ、記録を見つける | 組織が接続したソースのみが対象 | Coveo、Atlassian Rovo、Onyx |
プライバシー重視の検索エンジン
DuckDuckGoやStartpageなどのプライバシー重視の検索エンジンは、検索内容をあなた個人と結び付けられる形で記録しません。
DuckDuckGoは検索履歴を保存も共有もしません。また、Startpageは、他の検索エンジンが結果のパーソナライズに使用するIPアドレスやその他の個人データを取り除きます。
どちらも大手検索エンジン(DuckDuckGoはBing、StartpageはGoogleとBing)から検索結果のライセンスを受けているため、大規模なインデックスの恩恵を受けつつ、プライバシーも強化されます。
有料・広告なしの検索エンジン
Kagiのような有料検索エンジンは、広告ではなくユーザーのサブスクリプション料金で運営されています。
有料検索エンジンは、ターゲティング広告のために個人データを収集する必要がなく、ページのランク付けの方法も異なる場合があります。
たとえばKagiは、広告やトラッカーの多いページはコンテンツの質の低さと相関関係があることを見出したため、そうしたページの順位を下げ、独立系サイトや個人サイトを優遇しています。
バーティカル検索エンジン
バーティカル検索エンジンは、研究論文、求人、動画など、1種類のコンテンツに特化しています。たとえば、PubMedは生物医学文献を、Indeedは求人情報を検索し、YouTube、TikTok、RedditなどのUGCプラットフォームは自社のコンテンツのみを検索します。
それぞれが1種類のコンテンツを対象としているため、給与範囲や出版物の種類など、一般的な検索エンジンにはない方法で検索結果を絞り込めます。
地域検索エンジン
ロシアのYandex、チェコのSeznam、中国のBaiduのような地域検索エンジンは、特定の国や言語に特化しています。その言語で検索する場合や、近くの店舗やサービスを探すなどのローカル検索を行う場合に、より関連性の高い結果を提供できます。
地域検索エンジンの中には、本拠地の市場で大きなシェアを持つものもあります。たとえばロシアでは、検索リファラルのシェアでYandexが70.22%を占め、Googleの28.36%を上回っています(StatCounter、2026年10月)。
Webディレクトリとハイブリッド検索エンジン
Webディレクトリは、人間の編集者が選んだサイトをトピック別に分類して掲載しています。
たとえば、DMOZの後継としてボランティアが運営するCurlieには、ボランティアの編集者が追加した300万以上のサイトが掲載されています。また、米国国立医学図書館が運営するMedlinePlusは、健康に関するトピックごとに精査されたページを集めています。
ハイブリッド検索エンジンは、Webディレクトリの掲載情報とクローラーの結果を組み合わせます。子ども向け検索エンジンのKiddleは、編集者が確認したページを検索結果の上位に表示し、その後にGoogle SafeSearchでフィルタリングした結果を続けます。また、fragFINNはメディア教育者のチームがホワイトリストに登録したページのみを返します。
エンタープライズ検索エンジン
Coveo、Atlassian Rovo、Onyxのようなエンタープライズ検索エンジンは、ドキュメント、メール、データベースのエントリ、チャットメッセージなど、一般向けの検索エンジンではアクセスできない組織独自のコンテンツを検索します。
エンタープライズ検索エンジンは、Slack、Gmail、Notion、Salesforceなどの組織のアプリからコンテンツとメタデータをプライベートインデックスに同期するか、リアルタイムでクエリを実行します。その後、各ユーザーのアクセス権限に照らして結果をフィルタリングするため、ユーザーは閲覧を許可されたものだけを見ることができます。
最適な検索エンジンの選び方
ニーズに合った最適な検索エンジンを選ぶ際は、次の要素を考慮しましょう:
- 関連性:GoogleとBingは多くの言語に対応していますが、地域検索エンジンのほうが、その本拠地の言語ではより関連性の高い検索結果を返す場合があります。専門的なコンテンツについては、PubMedのようなバーティカル検索エンジンが、一般的な検索エンジンにはない形でコンテンツをインデックス化し、フィルターを提供しています。
- 回答の形式:複雑なクエリや、上位に表示されるコンテンツが乏しい場合は、AIアンサーエンジンのほうが早く答えにたどり着けます。ただし、誤りを含む可能性があるため、重要な判断に回答を使う際は必ず確認してください。
- 速度:クローラー型の検索エンジンは結果を即座に表示し、メタ検索エンジンもわずかに遅いだけです。AIアンサーエンジンは回答の作成に時間がかかりますが、答えを見つけるのに複数の情報源を読む必要がある場合は時間を節約できます。
- プライバシー:検索エンジンの中には、検索履歴やその他の個人データを部分的に基にして結果をランク付けするものもあります。そうしたデータを共有したくない場合や、履歴に結果を左右されたくない場合は、DuckDuckGoやStartpageのようなプライベート検索エンジンを使いましょう。
- 広告:広告を見たくない場合は、Kagiのような有料の検索エンジンを使いましょう。
- 検索体験:フィルターや、結果の見やすさを確認しましょう。GoogleとBingでは画像を使った検索もできるため、特定の画像を含むページを見つけられます。DuckDuckGo、Brave Search、Kagiは、検索を別のサイトの検索結果に直接送るショートカット「bang」に対応しています。
Perplexity:独自の検索インデックスを持つAIアンサーエンジン
Perplexityは、独自のインデックスとリアルタイムのWebを検索し、質問への回答を作成するAIアンサーエンジンです。回答には情報源にリンクする番号付きの引用が付いているため、各主張の出典を確認できます。
Perplexityのクローラー「PerplexityBot」は、インデックス用のページを収集します。質問すると、Perplexityはそれに最も適切に答えられる箇所を選び、それをもとに回答を作成します。また、Perplexityは回答中にページをリアルタイムで開くこともできます。
より詳しい回答が必要な質問には、研究モードが数十回の検索を実行し、数百の情報源を読み込んで、調査結果をPDFやドキュメントとしてエクスポートできる完全なレポートにまとめます。
よくある質問
最も利用されている検索エンジンは?
StatCounterによると、2026年10月の検索リファラルのシェアでは、Googleが91.05%でトップとなり、Bing(4.8%)、Yahoo(1.18%)、Yandex(1.14%)、DuckDuckGo(0.64%)が続いています。
Google以外の人気の検索エンジンは?
Google以外では、PerplexityがAIアンサーエンジンとして人気があり、Bing、DuckDuckGo、Yandex、Baidu、Brave Searchは、ランク付けされたページのリストを返す人気の検索エンジンです。これらの中には、AIが作成した回答を追加するものもあります。
最初の検索エンジンは?
最初のインターネット検索エンジンはArchieで、1989年にAlan Emtageが開発しました。1990年代半ばには、WebCrawlerのようなクローラー型のWeb検索エンジンが続きました。Dogpileは最初期のメタ検索エンジンの1つとして1996年に公開され、Googleは1998年に法人化されました。
検索エンジンにはいくつの種類がありますか?
結果の取得元と得られるものによって分類すると、クローラー型、メタ検索、AIアンサーエンジンの3つの主要な種類があります。現在では多くのクローラー型検索エンジンがAI回答を追加しているため、1つの検索エンジンが複数のカテゴリに属することもあります。
目的、対象者、ビジネスモデルで分類すると、さらに多くの種類があり、プライバシー重視、有料、バーティカル、地域、エンタープライズの各検索エンジンに加え、Webディレクトリもあります。
ビジュアル検索と音声検索は検索エンジンの種類ですか?
ビジュアル検索と音声検索は検索エンジンの種類ではなく、検索の方法です。Google レンズのようなビジュアル検索は言葉ではなく画像から、スマートフォンやスマートホームデバイスでの音声検索は音声から検索を始めますが、多くの場合、文字入力による検索と同じインデックスを検索します。
検索エンジンとアンサーエンジンの違いは?
従来の検索エンジンは、クエリに一致するページをランク付けしたリストを返します。アンサーエンジンはページを読み込み、情報源へのリンク付きの引用を添えて1つの回答を作成します。
現在では、両方に対応している検索エンジンもあります。たとえば、GoogleにはAI モードとAI による概要があり、Bingにも同様の機能があります。