
검색 엔진의 유형: 크롤러, 메타 검색, AI 답변 엔진
크롤러 기반, 메타 검색, AI 답변 엔진이 결과를 찾아 반환하는 방식과 함께 개인정보 보호 중심 및 유료 검색 엔진부터 버티컬, 지역, 엔터프라이즈 검색 엔진까지 다른 유형의 검색 엔진도 살펴봅니다.
검색 엔진 유형 간의 주요 차이점은 정보를 어디에서 가져오는지, 그리고 어떤 종류의 결과를 반환하는지에 있습니다.
크롤러 기반 엔진은 자체적으로 구축한 인덱스를 검색하고, 메타 검색 엔진은 여러 다른 엔진의 결과를 결합합니다. AI 답변 엔진도 인덱싱된 소스를 사용하지만, 다른 유형과 달리 링크 목록을 제공하지 않고 정보를 활용해 맞춤형 답변을 작성합니다.
세 가지 주요 검색 엔진 유형이 어떻게 작동하는지 예시와 함께 살펴봅니다. 그 밖에 접할 수 있는 다른 유형(개인정보 보호 중심, 유료, 버티컬, 지역, 엔터프라이즈 엔진, 그리고 웹 디렉터리)과 검색 엔진을 선택하는 데 도움이 되는 질문도 다룹니다.
검색 엔진이란?
검색 엔진은 검색어와 일치하는 콘텐츠를 찾아 검색 결과로 반환하는 소프트웨어입니다.
Google이나 Bing 같은 인터넷 검색 엔진은 월드 와이드 웹을 검색하고, 다른 검색 엔진은 채용 게시판이나 연구 논문 데이터베이스처럼 특정 컬렉션 내에서 검색합니다.
유형에 따라 검색 결과는 페이지 링크의 순위 목록일 수도 있고, 찾은 소스를 바탕으로 작성된 답변일 수도 있습니다.
검색 엔진과 웹 브라우저의 차이
웹 브라우저는 Perplexity의 Comet, Chrome, Safari, Edge, Firefox처럼 웹 페이지를 열고 표시하는 데 사용하는 앱이고, 검색 엔진은 그런 페이지를 찾아 주는 서비스입니다.
브라우저 주소 표시줄에 웹 주소를 입력하면 해당 페이지로 이동합니다. 대신 검색어를 입력하면, 브라우저 설정에서 기본값을 변경하지 않는 한 브라우저는 이를 기본 검색 엔진(Comet은 Perplexity, Chrome은 Google 검색, Edge는 Bing)으로 보냅니다
검색 엔진의 세 가지 주요 유형
검색 엔진은 결과를 어디에서 가져오는지, 그리고 결과가 어떤 형태인지에 따라 다릅니다. 결과는 엔진 자체 인덱스, 라이선스를 받은 다른 엔진의 인덱스, 또는 여러 엔진에서 동시에 가져올 수 있으며, 페이지의 순위 목록이나 인용이 포함된 답변 형태로 제공됩니다.
크롤러 기반 엔진과 메타 검색 엔진은 모두 링크의 순위 목록을 반환하지만, 결과를 얻는 방식이 다릅니다. 크롤러 기반 엔진은 자체적으로 구축한 인덱스를 검색하는 반면, 메타 검색 엔진은 쿼리를 여러 다른 엔진에 보내고 그 결과를 결합합니다.
AI 답변 엔진도 인덱스를 검색하지만, 기존 검색 엔진처럼 페이지를 나열하는 대신 답변을 작성합니다. 요즘은 두 가지를 모두 하는 엔진도 많습니다. Google, Bing, Brave Search는 순위가 매겨진 링크 위에 AI가 작성한 답변을 추가합니다.
유형 | 결과 출처 | 제공되는 결과 | 적합한 용도 | 단점 | 예시 |
크롤러 기반 | 자체 인덱스 또는 크롤러 기반 엔진에서 라이선스를 받은 인덱스 | 순위 목록(AI 답변을 추가하는 엔진도 많음) | 광범위한 검색, 특정 페이지 찾기 | 한 엔진의 관점으로만 웹을 봄. 페이지는 직접 비교해야 함 | Google, Bing, Brave Search, DuckDuckGo |
메타 검색 | 여러 엔진에서 동시에 | 순위 목록 | 더 폭넓은 결과 | 느림: 제한 시간까지 여러 엔진의 응답을 기다림 | eTools.ch, SearXNG, MetaGer |
AI 답변 엔진 | 자체 인덱스 또는 라이선스를 받은 인덱스 | 인용이 포함된 답변 | 여러 소스가 필요한 복잡한 질문 | 인용된 페이지를 확인해야 함 | Perplexity, Google AI 모드 |
크롤러 기반 검색 엔진
Google이나 Bing 같은 크롤러 기반 검색 엔진은 자체 인덱스에 있는 웹 페이지에서 쿼리에 대한 답을 찾습니다. 광범위한 웹 검색이나 특정 사이트 또는 페이지를 찾는 데 가장 적합합니다.
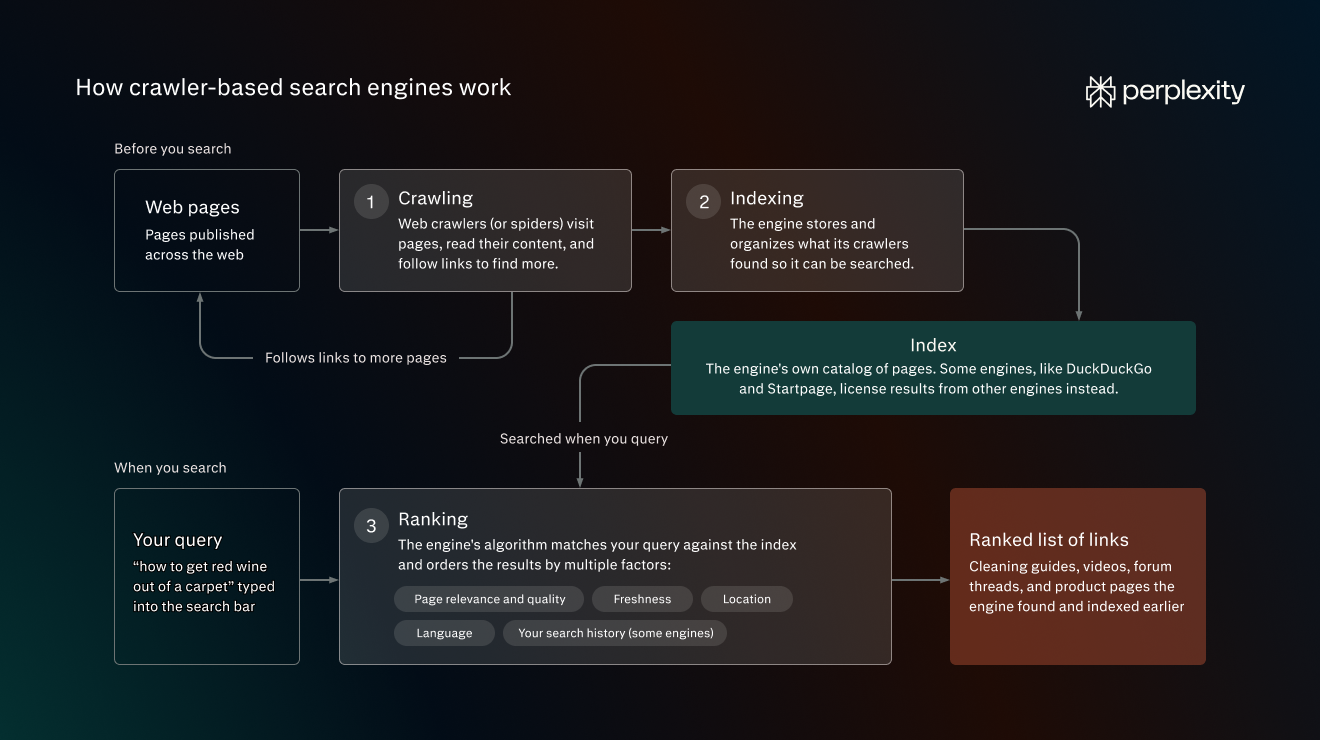
크롤러 기반 검색 엔진의 작동 방식은 다음과 같습니다.
- 크롤링: 웹 크롤러(또는 스파이더)라는 프로그램이 페이지를 방문해 콘텐츠를 읽고, 링크를 따라가 더 많은 페이지를 찾습니다.
- 인덱싱: 엔진은 크롤러가 찾은 내용을 검색할 수 있도록 저장하고 정리합니다.
- 순위 지정: 검색하면 엔진의 알고리즘이 쿼리를 인덱스와 대조하고, 페이지 관련성과 품질, 최신성, 위치, 언어, 그리고 일부 엔진의 경우 검색 기록 등 여러 요소에 따라 결과의 순서를 정합니다.
따라서 검색창에 "how to get red wine out of a carpet"(카펫에서 레드 와인 얼룩 지우는 법)을 입력하면, 검색 결과 페이지에는 검색 엔진이 이전에 발견해 인덱스에 등록해 둔 청소 가이드, 동영상, 포럼 스레드, 제품 페이지가 순위 목록으로 표시됩니다.
크롤러 기반 엔진에서 상위에 노출되도록 검색 엔진 최적화(SEO) 전문가는 모든 중요한 페이지를 쉽게 크롤링하고 인덱싱할 수 있게 만들고, 키워드 이면의 쿼리에 경쟁 페이지보다 더 나은 답을 제공하도록 합니다.
검색 시장에서 가장 큰 점유율을 차지하는 Google 검색은 가장 잘 알려진 크롤러 기반 엔진입니다. 그 밖에 Bing, Brave Search, 그리고 영국의 Mojeek, 스웨덴의 Marginalia 같은 독립 엔진이 있습니다.
일부 엔진은 직접 웹을 크롤링하지 않고 다른 엔진의 결과를 라이선스로 받아 사용합니다. 예를 들어 DuckDuckGo는 기존 링크 결과를 주로 Bing에서 가져오며(자체 크롤러도 함께 사용), Startpage는 Google과 Bing에서 가져옵니다.
메타 검색 엔진
메타 검색 엔진은 쿼리를 여러 다른 검색 엔진에 보내고 그 결과를 결합합니다. 예를 들어 eTools.ch는 17개의 서로 다른 데이터 소스를 검색합니다.
메타 검색 엔진은 다음 네 단계로 검색 쿼리에 답합니다.
- 여러 엔진에 동시에 쿼리를 보냅니다.
- 각 엔진에서 결과를 수집합니다.
- 중복 항목을 병합하고 점수를 다시 매깁니다. 예를 들어 여러 엔진이 어떤 페이지의 순위를 높게 매기면 그 페이지가 위로 올라갑니다.
- 순위가 매겨진 결과를 하나의 페이지에 표시합니다.
eTools.ch에서 "how to get red wine out of a carpet"을 검색하면 DuckDuckGo, Yahoo, Google 등에서 가져온 결과가 표시됩니다. 테스트 결과, Google의 1위 결과가 여기서는 4위에 그쳤습니다.
메타 검색 엔진은 더 넓은 범위로 검색하고 싶을 때 좋은 선택이지만, 여러 엔진의 응답을 (제한 시간까지) 기다리기 때문에 로딩이 더 느릴 수 있습니다.
eTools.ch 외에 많이 쓰이는 메타 검색 엔진으로는 SearXNG, MetaGer, Dogpile이 있습니다.
DuckDuckGo가 메타 검색 엔진 목록에 등장하기도 하지만, 실제로는 여러 엔진의 결과를 결합하는 것이 아니라 Bing에서 라이선스를 받은 결과를 제공합니다.
AI 답변 엔진
Perplexity 같은 AI 검색 엔진은 소스를 검색하고 이를 활용해 사용자의 구체적인 질문에 대한 답변을 작성하며, 사용한 페이지로 연결되는 인용을 함께 제공합니다.
AI 답변 엔진의 작동 방식:
- 질문 읽기: 대규모 언어 모델(LLM)이 길고 대화형인 질문을 포함해 쿼리를 해석하며, 쿼리 팬아웃이라는 과정을 통해 이를 여러 검색으로 나눌 수 있습니다.
- 소스 검색: 이렇게 나눈 검색을 웹 인덱스에서 실행하므로, 모델이 학습된 이후에 게시된 페이지도 답변에 활용할 수 있습니다. 또한 전체 페이지뿐 아니라 개별 구절도 질문과 비교해 점수를 매깁니다.
- 답변 작성: LLM이 검색된 구절을 바탕으로 답변을 작성합니다.
크롤러 기반 엔진과 마찬가지로 AI 답변 엔진도 자체 인덱스나 라이선스를 받은 인덱스를 검색합니다. 예를 들어 Perplexity는 자체 인덱스를 운영하고, ChatGPT Search는 자체 인덱스와 서드파티 인덱스를 함께 사용합니다.
AI 답변 엔진은 여러 소스의 정보를 모아 답변을 작성하므로, 한 페이지만으로는 답을 얻기 어려운 복잡하거나 구체적인 쿼리에 가장 적합합니다.
예를 들어 Perplexity에 "16살 딸이 일리노이주에서 연습 면허를 받았는데, 3월에 애리조나주로 이사할 예정이에요. 지금 연습 시간을 계속 기록해야 할까요? 애리조나주에서 그 시간을 인정해 줄까요? 애리조나 MVD에는 무엇을 가져가야 하나요?"라고 물었더니, 질문의 각 부분에 답하기 위해 15개의 출처를 활용했습니다.
Google의 기존 순위 결과(AI 개요 제외)에서는 같은 질문에 대해 페이지 목록이 반환되므로, 각 페이지를 열어 관련 정보를 직접 찾아야 합니다.
하지만 답변을 작성할 때 LLM이 환각을 일으킬 수 있으므로, 답변을 신뢰하기 전에 인용된 페이지를 열어 AI 답변의 주장을 확인하세요.
AI 답변에 인용되려면 웹페이지에도 동일한 SEO 기반이 필요합니다. 다만 답변 엔진 최적화(AEO)는 AI 답변 엔진이 콘텐츠를 쉽게 처리하고 인용할 수 있도록 하는 데 더 중점을 둡니다. 예를 들어 맥락에서 떼어 내더라도 각 섹션이 하나의 구체적인 질문에 명확하게 답하도록 구성하는 것입니다.
그 밖의 검색 엔진 유형
검색 엔진은 목적, 대상, 비즈니스 모델에 따라 분류할 수도 있습니다. 이러한 분류 중 일부는 세 가지 주요 유형과 겹칩니다. 예를 들어 개인정보 보호 중심 엔진은 자체 인덱스를 운영하거나 결과를 라이선스로 받아 사용할 수 있습니다.
유형 | 차별점 | 적합한 용도 | 단점 | 예시 |
개인정보 보호 중심 | 개인 데이터를 추적하지 않음 | 검색 기록과 연결되기를 원하지 않는 검색 | 맞춤형 결과 없음 | DuckDuckGo, Startpage |
유료, 광고 없음 | 광고가 아닌 구독료로 운영 | 광고나 광고 타기팅이 없는 결과 | 짧은 무료 체험 후 구독 필요 | Kagi |
버티컬 | 한 종류의 콘텐츠만 검색 | 해당 콘텐츠 전용 필터를 갖춘 전문 콘텐츠 | 해당 컬렉션 외부의 콘텐츠는 검색 불가 | PubMed, Indeed, YouTube |
지역 | 특정 국가나 언어에 맞춤화 | 해당 언어로 검색하거나 현지 정보 검색 | 자국 언어와 시장 밖에서는 커버리지가 약함 | Yandex, Seznam, Baidu, Naver |
웹 디렉터리 또는 하이브리드 | 사람 편집자가 고른 사이트로, 필터링된 크롤러 결과가 섞이기도 함 | 특정 주제나 특정 대상을 위한 검증된 출발점 | 결과가 훨씬 적고 업데이트가 느림 | Curlie, MedlinePlus, Kiddle, fragFINN |
엔터프라이즈 | 조직 자체의 앱과 파일을 검색 | 내부 문서, 메시지, 기록 찾기 | 조직에서 연결한 소스만 검색 대상에 포함 | Coveo, Atlassian Rovo, Onyx |
개인정보 보호 중심 검색 엔진
DuckDuckGo나 Startpage 같은 개인정보 보호 중심 검색 엔진은 사용자를 식별할 수 있는 검색 기록을 남기지 않습니다.
DuckDuckGo는 검색 기록을 저장하거나 공유하지 않으며, Startpage는 다른 검색 엔진이 결과를 개인화하는 데 사용하는 IP 주소와 기타 개인 데이터를 제거합니다.
두 검색 엔진 모두 더 큰 검색 엔진의 결과를 라이선스받아 사용하므로(DuckDuckGo는 Bing, Startpage는 Google과 Bing), 대규모 인덱스의 이점을 누리면서도 개인정보를 더 잘 보호할 수 있습니다.
광고 없는 유료 검색 엔진
Kagi 같은 유료 검색 엔진은 광고 대신 사용자의 구독료로 운영됩니다.
유료 검색 엔진은 광고 타기팅을 위해 개인 데이터를 수집할 필요가 없으며, 페이지 순위를 다르게 매길 수도 있습니다.
예를 들어 Kagi는 광고와 트래커가 많은 페이지일수록 콘텐츠 품질이 낮은 경향이 있다는 사실을 확인하여 이러한 페이지의 순위를 낮추고, 독립 사이트와 개인 사이트를 우선 노출합니다.
버티컬 검색 엔진
버티컬 검색 엔진은 연구 논문, 채용 공고, 동영상 등 한 종류의 콘텐츠에 집중합니다. 예를 들어 PubMed는 생물의학 문헌을, Indeed는 채용 공고를 검색하며, YouTube, TikTok, Reddit 같은 UGC 플랫폼은 자체 콘텐츠만 검색합니다.
각 검색 엔진이 한 가지 유형의 콘텐츠만 다루기 때문에 급여 범위나 출판물 유형처럼 일반 검색 엔진에서는 불가능한 방식으로 검색 결과를 필터링할 수 있습니다.
지역 검색 엔진
러시아의 Yandex, 체코의 Seznam, 중국의 Baidu 같은 지역 검색 엔진은 한 국가나 언어에 집중합니다. 해당 언어로 검색하거나 근처 상점, 서비스 등을 찾는 지역 검색을 할 때 더 관련성 높은 결과를 제공할 수 있습니다.
일부 지역 검색 엔진은 자국 시장에서 큰 점유율을 차지합니다. 예를 들어 러시아의 검색 유입 점유율은 Yandex가 70.22%, Google이 28.36%입니다(StatCounter, 2026년 10월).
웹 디렉터리와 하이브리드 검색 엔진
웹 디렉터리는 사람 편집자가 선정하고 주제별로 분류한 사이트를 나열합니다.
예를 들어 자원봉사자가 운영하는 DMOZ의 후속 서비스인 Curlie에는 자원봉사 편집자가 추가한 300만 개 이상의 사이트가 등록되어 있으며, 미국 국립의학도서관이 운영하는 MedlinePlus는 건강 주제별로 검증된 페이지를 모아 제공합니다.
하이브리드 검색 엔진은 웹 디렉터리 목록과 크롤러 결과를 함께 보여 줍니다. 어린이용 검색 엔진인 Kiddle은 편집자가 확인한 페이지를 결과 상단에 배치하고 그 뒤에 Google SafeSearch로 필터링한 결과를 보여 주며, fragFINN은 미디어 교육 전문가 팀이 허용 목록에 등록한 페이지만 반환합니다.
엔터프라이즈 검색 엔진
Coveo, Atlassian Rovo, Onyx 같은 엔터프라이즈 검색 엔진은 문서, 이메일, 데이터베이스 항목, 채팅 메시지 등 공개 검색 엔진이 접근할 수 없는 조직 자체의 콘텐츠를 검색합니다.
엔터프라이즈 검색 엔진은 Slack, Gmail, Notion, Salesforce 같은 조직 앱의 콘텐츠와 메타데이터를 비공개 인덱스로 동기화하거나 실시간으로 쿼리한 다음, 각 사용자의 액세스 권한에 따라 결과를 필터링하여 사용자가 볼 권한이 있는 항목만 표시합니다.
최적의 검색 엔진을 선택하는 방법
필요에 맞는 최적의 검색 엔진을 선택할 때는 다음 요소를 고려하세요.
- 관련성: Google과 Bing은 다양한 언어를 지원하지만, 지역 검색 엔진은 자국 언어에서 더 관련성 높은 검색 결과를 제공할 수 있습니다. 전문 콘텐츠의 경우 PubMed 같은 버티컬 검색 엔진은 일반 검색 엔진이 다루지 않는 콘텐츠를 인덱싱하고 필터를 제공합니다.
- 답변 형식: 복잡한 쿼리이거나 순위를 매길 콘텐츠가 부족한 경우에는 AI 답변 엔진이 더 빠릅니다. 하지만 실수를 할 수 있으므로 중요한 결정을 내릴 때는 반드시 확인한 후에 답변을 활용하세요.
- 속도: 크롤러 기반 검색 엔진은 결과를 즉시 불러오며, 메타 검색 엔진도 아주 약간 느릴 뿐입니다. AI 답변 엔진은 답변을 작성하는 데 시간이 더 걸리지만, 여러 소스를 읽어야 답을 찾을 수 있는 경우에는 시간을 절약해 줍니다.
- 개인정보 보호: 일부 검색 엔진은 검색 기록과 기타 개인 데이터를 부분적으로 반영해 결과 순위를 매깁니다. 이러한 데이터를 공유하고 싶지 않거나 검색 기록이 결과에 영향을 주지 않기를 원한다면 DuckDuckGo, Startpage 같은 비공개 검색 엔진을 사용하세요.
- 광고: 광고를 보고 싶지 않다면 Kagi 같은 유료 검색 엔진을 사용하세요.
- 검색 경험: 필터를 확인하고 결과를 얼마나 쉽게 훑어볼 수 있는지 살펴보세요. Google과 Bing에서는 이미지로도 검색할 수 있어 특정 이미지가 포함된 페이지를 찾을 수 있습니다. DuckDuckGo, Brave Search, Kagi는 검색어를 다른 사이트의 검색 결과로 바로 보내는 단축 명령인 뱅(bang)을 지원합니다.
Perplexity: 자체 검색 인덱스를 갖춘 AI 답변 엔진
Perplexity는 자체 인덱스와 실시간 웹을 검색해 질문에 대한 답변을 작성하는 AI 답변 엔진입니다. 답변에는 소스로 연결되는 번호 인용이 포함되어 있어 각 주장의 출처를 확인할 수 있습니다.
Perplexity의 크롤러인 PerplexityBot이 인덱스에 사용할 페이지를 수집합니다. 질문을 하면 Perplexity는 질문에 가장 잘 답하는 구절을 골라 이를 바탕으로 답변을 작성합니다. 또한 답변하는 도중에 페이지를 실시간으로 열어 볼 수도 있습니다.
더 깊이 있는 답변이 필요한 질문의 경우, 리서치 모드는 수십 번의 검색을 실행하고 수백 개의 소스를 읽은 뒤 결과를 PDF나 문서로 내보낼 수 있는 완전한 보고서로 정리합니다.
자주 묻는 질문
가장 많이 사용되는 검색 엔진은 무엇인가요?
StatCounter에 따르면 2026년 10월 검색 유입 점유율 기준으로 Google이 91.05%로 1위이며, 그 뒤를 Bing(4.8%), Yahoo(1.18%), Yandex(1.14%), DuckDuckGo(0.64%)가 잇고 있습니다.
Google 외에 인기 있는 검색 엔진에는 무엇이 있나요?
Google 외에도 Perplexity는 인기 있는 AI 답변 엔진이며, Bing, DuckDuckGo, Yandex, Baidu, Brave Search는 순위가 매겨진 페이지 목록을 반환하는 인기 검색 엔진입니다. 이 중 일부는 AI가 작성한 답변도 함께 제공합니다.
최초의 검색 엔진은 무엇이었나요?
최초의 인터넷 검색 엔진은 1989년 Alan Emtage가 만든 Archie입니다. 1990년대 중반에는 WebCrawler 같은 크롤러 기반 웹 검색 엔진이 뒤를 이었습니다. Dogpile은 최초의 메타 검색 엔진 중 하나로 1996년에 출시되었으며, Google은 1998년에 법인으로 설립되었습니다.
검색 엔진에는 몇 가지 유형이 있나요?
결과의 출처와 제공되는 결과물을 기준으로 하면 크롤러 기반, 메타 검색, AI 답변 엔진의 세 가지 주요 유형이 있습니다. 현재 많은 크롤러 기반 검색 엔진이 AI 답변을 추가하고 있으므로 하나의 검색 엔진이 둘 이상의 범주에 속할 수도 있습니다.
목적, 대상, 비즈니스 모델별로 분류하면 개인정보 보호 중심, 유료, 버티컬, 지역, 엔터프라이즈 검색 엔진과 웹 디렉터리 등 더 많은 유형이 있습니다.
시각 검색과 음성 검색도 검색 엔진의 유형인가요?
시각 검색과 음성 검색은 검색 엔진의 유형이 아니라 검색 방식입니다. Google Lens 같은 시각 검색은 단어 대신 이미지에서 시작하고, 휴대폰이나 스마트 홈 기기에서 사용하는 음성 검색은 음성에서 시작하지만, 둘 다 텍스트 입력 검색과 같은 인덱스를 검색하는 경우가 많습니다.
검색 엔진과 답변 엔진의 차이점은 무엇인가요?
기존 검색 엔진은 쿼리와 일치하는 페이지의 순위 목록을 반환합니다. 답변 엔진은 페이지를 읽고 소스로 연결되는 인용과 함께 하나의 답변을 작성합니다.
현재 일부 검색 엔진은 두 가지를 모두 제공합니다. 예를 들어 Google에는 AI Mode와 AI Overviews가 있으며, Bing도 마찬가지입니다.