
MI atmiņa: kas tā ir, kā tā darbojas un ko tā glabā
Ceļvedis par MI atmiņu: kā MI asistenti saglabā un atceras informāciju no iepriekšējām sarunām, ko tie glabā, kur atmiņa kļūdās un kā to skatīt, rediģēt vai izslēgt.
MI atmiņa ir informācija, ko sarunvalodas MI asistents saglabā no jūsu iepriekšējām sarunām un izmanto jaunās, lai varētu atcerēties jūsu preferences un kontekstu. Pats modelis neko no tā neglabā. Asistents to uzglabā atsevišķi un pievieno atpakaļ, kad tas ir būtiski, tādējādi nodrošinot modelim pastāvīgu kontekstu, kura tam citādi nebūtu.
Šajā rokasgrāmatā skaidrots, kā asistenti saglabā un atsauc atmiņā šo informāciju, ko tie uzglabā, kāpēc tie dažkārt kļūdās un kā to apskatīt, mainīt vai izslēgt.
Kas ir MI atmiņa?
MI atmiņa, saukta arī par pastāvīgo atmiņu, ir MI asistenta funkcija, kas uzglabā informāciju par jums, piemēram, preferences, faktus un kontekstu no iepriekšējām mijiedarbībām, ko asistents var izmantot vēlākās sarunās.
MI asistents šo uzskaiti var veidot no lietām, ko lūdzat tam atcerēties, detaļām, ko tas pamana pats, un agrākām tērzēšanām, uz kurām tas var atsaukties.
MI atmiņas slānis ļauj MI asistentiem sniegt personalizētas atbildes, jums nekopīgojot savas preferences katrā tērzēšanā. Ja esat asistentam teicis, ka gatavojaties maratonam un dodat priekšroku kilometriem, uz nākamo jautājumu par tempu saņemsiet atbildi kilometros, un jums tas nebūs jāatkārto.
Salīdzinot ar savas situācijas atkārtotu izklāstu katrā tērzēšanā, atmiņa ietaupa rakstīšanu un saglabā uzvedni īsu, un tas ir svarīgi, jo gari ievaddati padara atbildes mazāk precīzas.
Atmiņa nav katras sarunas stenogramma, bet gan galveno faktu kopums par jums. Tāpēc tā atcerēsies, ka dodat priekšroku kilometriem. Tas, vai varēsiet atrast precīzu treniņu plānu, ko tā sagatavoja pagājušajā mēnesī, ir atkarīgs no tā, vai asistents var meklēt arī iepriekšējās tērzēšanas.
MI atmiņas veidi
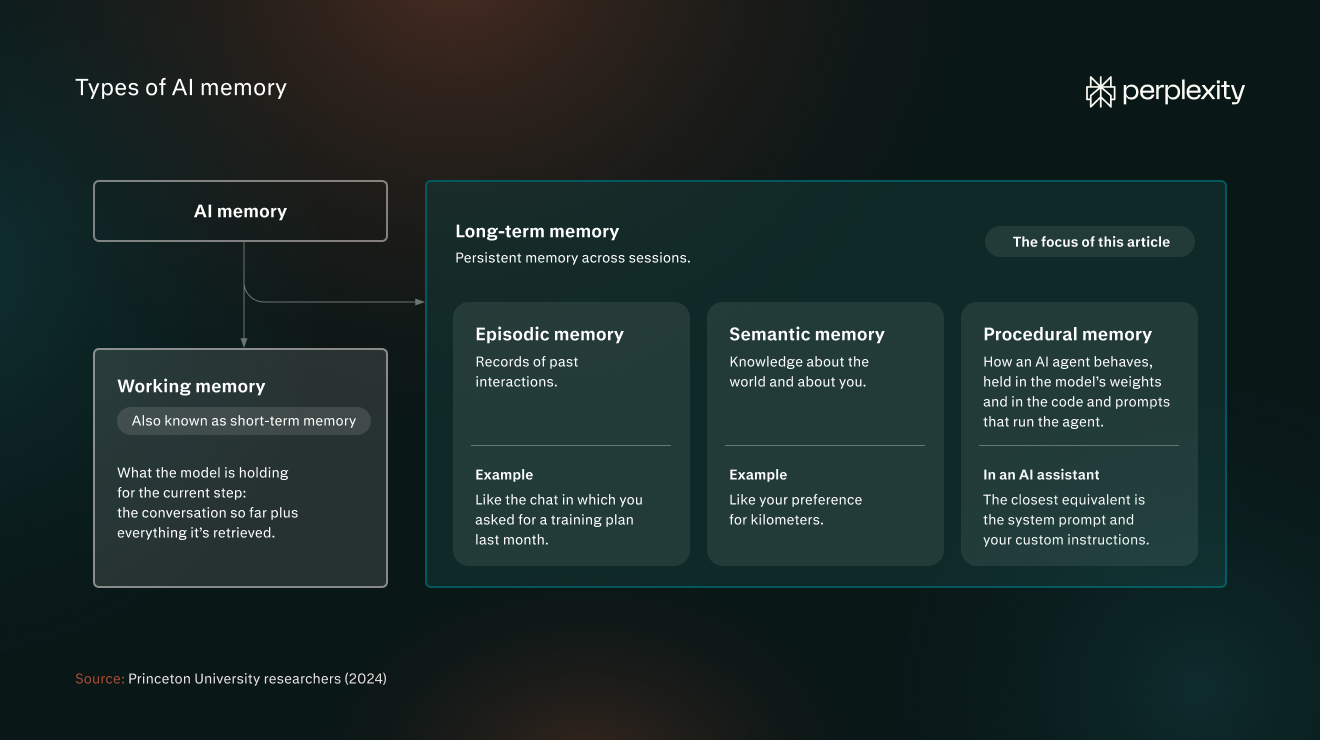
Prinstonas Universitātes pētnieki (2024) ir aizguvuši terminoloģiju no cilvēka atmiņas zinātnes, lai klasificētu MI atmiņas sistēmu veidus. Viņu ietvars nošķir darba atmiņu no ilgtermiņa atmiņas:
- Darba atmiņa: Tas, ko modelis patur pašreizējam solim, proti, līdzšinējā saruna un viss, ko tas ir izguvis. Pazīstama arī kā īstermiņa atmiņa.
- Ilgtermiņa atmiņa: Pastāvīga atmiņa starp sesijām. Tieši par šo atmiņas veidu ir šis raksts.
Ilgtermiņa atmiņa ietver trīs atmiņas veidus:
- Epizodiskā atmiņa: Ieraksti par iepriekšējām mijiedarbībām, piemēram, tērzēšana, kurā pagājušajā mēnesī lūdzāt treniņu plānu.
- Semantiskā atmiņa: Zināšanas par pasauli un par jums, piemēram, priekšroka kilometriem.
- Procedurālā atmiņa: Tas, kā MI aģents uzvedas; tā ir iestrādāta modeļa svaros, kā arī kodā un uzvednēs, kas darbina aģentu. MI asistentā tuvākais ekvivalents ir sistēmas uzvedne un jūsu pielāgotās instrukcijas.
MI asistenta atmiņa salīdzinājumā ar MI aģenta atmiņu
Gan MI asistenta atmiņa, gan MI aģenta atmiņa ir ilgtermiņa atmiņa. MI asistenta atmiņa galvenokārt ir semantiskā atmiņa un uzglabā faktus par jums, lai atbildes jums atbilstu. Aģenta atmiņa, piemēram, Perplexity Brain, uzglabā to, ko aģents darīja un kā tam veicās, tostarp to, kas izdevās un ko jūs labojāt, lai katru jauno uzdevumu tas sāktu no labākas pozīcijas.
MI asistenta atmiņa | MI aģenta atmiņa | |
Ko tā atceras | Jūs | Uzdevums un tā vēsture |
Kam tā paredzēta | Atbildes, kas atbilst jums | Vairāku soļu darba turpināšana, nesākot no jauna |
Piemērs | Atceras, ka dodat priekšroku kilometriem | Atceras jūsu maratona treniņu plānu, korekcijas, ko tas veica, un līdz šim pabeigtos treniņus, lai varētu labāk plānot nākamos posmus |
MI atmiņa salīdzinājumā ar konteksta logiem, apmācības datiem un pielāgotajām instrukcijām
MI atmiņu ir viegli sajaukt ar trim citām lietām, kas veido atbildi: modeļa konteksta logu, apmācības datiem un pielāgotajām instrukcijām. Katra no tām satur atšķirīgu informāciju, saglabājas atšķirīgu laiku, un to kontrolē atšķirīga sistēma.
Konteksta logs ir teksta apjoms, ko lielais valodas modelis (LLM) var nolasīt vienlaikus, un tas aptver pašreizējo sarunu. Tas tiek atiestatīts, kad sākat jaunu tērzēšanu.
Dažiem pašreizējiem modeļiem ir lieli konteksta logi — miljons tokenu vai vairāk, tāpēc tehniski jūs varētu ielīmēt savu galveno informāciju katrā sarunā. Taču visas tās apstrāde palielina aizkavi un izmaksas.
Vairākos pētījumos ir arī konstatēts, ka, ievaddatiem pieaugot, izvades precizitāte samazinās pat tad, ja atbilde ir kontekstā.
2025. gada Ilinoisas Universitātes un Amazon pētījumā tas tika novērots pat tad, kad modeļi spēja atkārtot katru būtisko detaļu: precizitāte samazinājās par 13,9–85%, ievaddatiem pieaugot līdz 30 000 tokenu, kas ir krietni zem modeļu deklarētajiem ierobežojumiem. NoLiMa, Adobe Research un Minhenes LMU 2025. gada etalontests, atklāja, ka 11 no 13 testētajiem modeļiem uzrādīja ievērojami sliktākus rezultātus jau pie 32 000 tokenu, ja jautājumam un atbildei nebija kopīgu atslēgvārdu. Chroma 2025. gada jūlija ziņojumā tas tika novērots 18 modeļiem, tostarp tad, kad tie atbildēja, izmantojot 113 000 tokenu garu tērzēšanas vēsturi.
Apmācības dati ir informācija, kas iestrādāta modeļa svaros pirms tā izlaišanas. Lietotāji to nevar mainīt. Izstrādātāji var precizēt modeli ar jauniem datiem, taču tas ir inženierijas process, nevis lietotāja iestatījums,
Pielāgotās instrukcijas ir asistenta iestatījumos saglabāti noteikumi, kurus jūs paši rakstāt un rediģējat, lai pielāgotu MI asistenta uzvedību un izvades. Piemēram, ar pielāgotajām instrukcijām varat noteikt atbilžu toni un stilu vai to, kādus avotus asistents drīkst izmantot.
Lūk, kā šīs četras lietas salīdzināmas:
Konteksta logs | MI atmiņa | Apmācības dati | Pielāgotās instrukcijas | |
Ko tas satur | Ziņojumi pašreizējā tērzēšanā | Saglabāti fakti un preferences par jums | Tas, ko modelis apguva pirms izlaišanas | Norādījumi, ko rakstāt paši |
Cik ilgi tas saglabājas | Tikai šajā tērzēšanā | Līdz tā tiek atjaunināta vai izdzēsta | Nemainīgi līdz jauna modeļa izlaišanai | Līdz brīdim, kad tās rediģējat |
Kas to kontrolē | Jūs, modeļa nodrošinātāja noteiktā ierobežojuma robežās. | Jūs un asistents | MI uzņēmums | Jūs |
Piemērs | Jautājums par tempu, ko uzdevāt pirms minūtes | Tas, ka dodat priekšroku kilometriem | Kā parasti tiek strukturēti maratona treniņu plāni | Norādījums formatēt treniņu plānus režģī, kurā rindas apzīmē nedēļas, bet kolonnas — nedēļas dienas |
Ko uzglabā MI atmiņa
Asistenti saglabā atlasītas detaļas par jums, piemēram, faktus, preferences un kopsavilkumus, un daži izmanto arī jūsu iepriekšējās tērzēšanas.
- Fakti un preferences, ko lūdzat tam atcerēties: Tās ir detaļas, kuras jūs skaidri lūdzat asistentam saglabāt, piemēram, „atceries, ka dodu priekšroku kilometriem”. Asistents izveido atmiņu, kad to lūdzat, un tā saglabājas, līdz to izdzēšat vai kāda vēlāka saruna to atjaunina.
- Detaļas, ko tas uztver no jūsu sarunām: Asistents tās saglabā, ja iestatījums ir ieslēgts. Perplexity „dod priekšroku lietotāja uzdoto jautājumu un sniegtās informācijas biežumam”, tāpēc kaut kas, ko pieminat bieži, visticamāk, paliks atmiņā labāk nekā tas, ko pieminat vienreiz. Atmiņa saglabājas, līdz tā tiek atjaunināta vai jūs to izdzēšat.
- Atsauces uz jūsu iepriekšējām tērzēšanām: Asistents izmanto agrākās sarunas tieši, nevis saglabātu sarakstu. Perplexity to sauc par meklēšanas vēsturi: jūsu iepriekšējie jautājumi un atbildes, ko izmanto, lai jaunā atbilde būtu atbilstošāka.
Kā darbojas MI atmiņa
MI modelis starp sarunām neko neatceras. To paveic MI atmiņas sistēma: tā glabā atsevišķu uzskaiti par jums un pievieno būtiskās daļas katrai jaunai sarunai. Uzglabāšana un izgūšana notiek fonā, tāpēc modelis šīs daļas nolasa kopā ar jūsu jautājumu.
Šis process norit piecos soļos:
- Saglabāšana: Asistents saglabā atmiņu, kad to lūdzat, vai tad, kad tas nolemj, ka kāda detaļa ir paturēšanas vērta.
- Uzglabāšana: Atmiņas nonāk datubāzē, kas tiek glabāta atsevišķi no modeļa. Daudzās sistēmās tā ir vektoru datubāze, lai atmiņās varētu meklēt pēc nozīmes. Saraksts, ko redzat iestatījumos, ir šīs atmiņas krātuves skats.
- Izgūšana: Kad nosūtāt ziņojumu, asistents nolemj, kuras atmiņas ir piemērojamas. Daudzas sistēmas to dara, pārvēršot jūsu ziņojumu un katru atmiņu iegulumos — nozīmes skaitliskos attēlojumos — un izvēloties tuvākās atbilstības. Tādējādi tās var atsaukt atmiņu pat tad, ja tai nav neviena kopīga vārda ar jūsu jautājumu. Vienkāršākas sistēmas ielādē katru saglabāto atmiņu katrā sarunā.
- Izmantošana: Atsauktās atmiņas tiek ievietotas ievaddatos kā vienkāršs teksts, parasti instrukciju blokā, ko modelis nolasa pirms jūsu ziņojuma. Modelis tās apstrādā tāpat kā jebkuru citu tekstu šajos ievaddatos.
- Atjaunināšana un noņemšana: Asistents iegūst faktus no tērzēšanām, pārmeklē esošās atmiņas un nolemj, vai pievienot faktu kā jaunu, atjaunināt esošu atmiņu, apvienot to ar kādu no tām vai dzēst vecu atmiņu, kas ir pretrunā ar jauniem atklājumiem. Daži asistenti katrai atmiņai pievieno laikspiedolu, lai atšķirtu jaunāku informāciju no vecākas.
MI atmiņas izaicinājumi un riski
MI atmiņas mērķis ir uzlabot atbilžu kvalitāti, taču etalontesti liecina, ka atmiņas izgūšana ne vienmēr atrod būtisku vai aktuālu informāciju, īpaši lielās datubāzēs. Tā rada arī drošības un privātuma riskus.
Bieži sastopamas ar MI atmiņu saistītas uzticamības un drošības problēmas:
- Nepareizi piemērotas atmiņas: Atmiņa var tikt iekļauta atbildē, ar kuru tai nav nekāda sakara. 2026. gada pētījumā 18 modeļi tika pārbaudīti, vai saglabāta atmiņa no vienas dzīves jomas noplūst atbildē par citu. Kļūmju īpatsvara mediāna bija 53%. Pētījumā arī konstatēts, ka tad, kad atmiņā bija lietotāju uzskati vai apgalvota kompetence, gandrīz katrs modelis tos atkārtoja, pat ja jautājums prasīja neitrālu atbildi.
- Novecojušas atmiņas: Asistents turpina rīkoties, balstoties uz kādu detaļu, arī pēc tam, kad vēlāka saruna to padarījusi nepatiesu, īpaši, ja jūs to nekad neesat tieši pateicis. 2026. gada maija etalontestā, kurā tika pārbaudīts, vai modeļi pamana šādas netiešas izmaiņas, labākā modeļa vidējais rezultāts bija 55,2%.
- Atmiņas pārslodze: Jo vairāk asistentam jāpārlasa, jo grūtāk ir izcelt būtisko. LongMemEval, 2024. gada etalontests, atklāja, ka modeļi, kas lasīja aptuveni 115 000 tokenu garu tērzēšanas vēsturi, darbojās par 30–60% sliktāk nekā modeļi, kuriem tika dotas tikai attiecīgās sesijas.
- Atmiņas saindēšana: Nepatiesa informācija vai slēpti norādījumi nonāk asistenta atmiņā, piemēram, ar saturu, ko lūdzat tam izlasīt, izraisot neobjektīvas vai nedrošas atbildes vai datu noplūdes.
- Privātuma riski: Atmiņa saglabā personisku informāciju arī ārpus tērzēšanas, no kuras tā nāk, dažkārt ilgāk, nekā jūs gaidāt. Piemēram, Perplexity drošības un atkļūdošanas nolūkos var glabāt dzēsto atmiņu žurnālu līdz 30 dienām. Datu aizsardzības tiesību akti uzglabātās atmiņas uzskata par personas datiem, tāpēc jums jābūt iespējai tās pārskatīt un dzēst.
Kā apskatīt, rediģēt un izslēgt MI atmiņu
Varat redzēt, ko asistents ir saglabājis, to izdzēst, izslēgt atmiņu vai izmantot privātu tērzēšanu, kas neveido atmiņas.
Atmiņas pārvaldībai pietiek ar dažām vadīklām. Lūk, ko katra no tām dara un kad to izmantot:
Vadīkla | Ko tā dara | Kad to izmantot |
Skatīt, kas ir saglabāts | Atver jūsu atmiņas krātuvi, kurā varat meklēt, filtrēt un pārskatīt atsevišķus ierakstus. | Kad atbildē ir detaļa, ko negaidījāt. |
Dzēst atmiņu | Noņem ierakstu, un asistents pārstāj to izmantot turpmākajās atbildēs (asistenti noteiktu laiku var glabāt notīrīto atmiņu žurnālu). | Kad atmiņa ir nepareiza, novecojusi vai sensitīva. |
Izslēgt atmiņu | Asistents pārstāj izmantot atmiņu turpmākajās atbildēs (tas var neizdzēst jau saglabātās atmiņas — pārbaudiet savā asistentā). | Kad vēlaties atbildes bez personalizācijas |
Izslēgt meklēšanas vēsturi | Asistents pārstāj izmantot jūsu iepriekšējos jautājumus un atbildes. Dzēšot sesiju no meklēšanas vēstures, tiek novērsta tās ietekme uz turpmākajām atbildēm. | Kad iepriekšējās sarunas ietekmē atbildes, bet vēlaties sākt no jauna. |
Izmantojiet inkognito tērzēšanu | Atmiņa un meklēšanas vēsture vienmēr ir izslēgtas, un tur uzdotie jautājumi nekad netiek saglabāti vai izmantoti atmiņā. | Vienreizējām vai sensitīvām tēmām. |
Lai sāktu ar tīru lapu, izslēdziet atmiņu un notīriet saglabāto.
Kā Perplexity pārvalda atmiņu
Perplexity atmiņa darbojas ar visiem tā piedāvātajiem modeļiem.
Perplexity personalizē atbildes, izmantojot divus avotus: atmiņas, t. i., jūsu kopīgotās preferences un informāciju, un jūsu meklēšanas vēsturi. Kad atmiņa ietekmē atbildi, tā tiek parādīta starp šīs atbildes avotiem, lai jūs varētu redzēt, kuras atmiņas tika izmantotas, un dzēst jebkuru no tām.
Atbildes varat personalizēt arī, sniedzot informāciju par sevi un pielāgotus norādījumus projektiem (katram projektam ir savs atmiņas slānis).
Patērētāju kontos Perplexity var izmantot atmiņas saturu savu modeļu uzlabošanai (Enterprise kontos – nekad), ja vien to neizslēdzat (iestatījums „MI datu saglabāšana” sadaļā Iestatījumi → Preferences → Mākslīgais intelekts).
Max un Enterprise Max abonenti saņem arī Brain – kopīgu atmiņas slāni, kas papildina atmiņu, sekojot jūsu projektiem un darbam. Tam ir savs slēdzis, un tas ignorē inkognito sesijas.
Izmēģiniet Perplexity un pārbaudiet, kā atmiņas ietekmē jūsu nākamo atbildi.
Bieži uzdotie jautājumi par MI atmiņu
Kas mākslīgajā intelektā ir ierobežota atmiņa?
IBM definē ierobežotas atmiņas MI kā MI, kas spēj atcerēties pagātnes notikumus un iznākumus un laika gaitā uzraudzīt situācijas, taču nespēj saglabāt šos datus ilgtermiņa pagātnes pieredzes krātuvē. Tā ir viena no četrām kategorijām MI sistēmu taksonomijā, un IBM tajā iekļauj tērzēšanas robotus un virtuālos asistentus.
Asistenta atmiņa ir ārēja atmiņa, ko šīs sistēmas pievieno papildus. Tā saglabājas starp sesijām, tāpēc asistents var izmantot informāciju, ko kopīgojāt kādā iepriekšējā sarunā.
Kuram MI asistentam ir vislabākā atmiņa?
Nav viena asistenta, kas būtu labākais visiem. Laba atmiņa ir tāda, ko varat kontrolēt, tāpēc novērtējiet MI rīkus, uzdodot četrus jautājumus. Vai varat redzēt, ko tas ir saglabājis? Vai varat dzēst atmiņu atsevišķi no tērzēšanas, no kuras tā radusies? Vai apmācība ir no atmiņas atsevišķs iestatījums? Vai ir pagaidu vai inkognito režīms, kurā netiek veidotas atmiņas?
Vai MI modelis mācās no tā, ko tas atceras par jums?
Atmiņas izmantošana atbildē ir citāds process nekā apmācība. Perplexity norāda, ka tas izgūst atbilstošo kontekstu no jūsu atmiņas krātuves, nevis izmanto jūsu vēsturi kā apmācības datus. Tas, vai jūsu saturu var izmantot modeļu uzlabošanai, ir atsevišķs iestatījums. Patērētāju kontos Perplexity var izmantot atmiņas saturu šim nolūkam, un iestatījums „MI datu saglabāšana” to izslēdz.
Ko nevajadzētu glabāt MI atmiņā?
Neglabājiet MI atmiņā neko, ko nevēlētos, lai tiktu saglabāts, izmantots jūsu profilēšanai vai vēlāk atkārtots: identitātes un finanšu datus, veselības informāciju, paroles, citu cilvēku informāciju un jebko par bērniem. Kanādas Privātuma komisāra birojs (2025. gada maijs) un Apvienotās Karalistes Nacionālais kiberdrošības centrs (2023. gada marts) iesaka atturēties no jebkura vaicājuma, kas radītu problēmas, ja tas kļūtu publisks.
Filtri samazina privātuma riskus, taču negarantē, ka jūsu veselības vai finanšu informācija netiks saglabāta vispār, tāpēc pārskatiet savu atmiņas krātuvi un vienreizējiem sensitīviem jautājumiem izmantojiet inkognito režīmu.