
Konteksta degradācija MI aģentos: kāpēc ilgos uzdevumos zūd precizitāte un kā to novērst
Ceļvedis par to, kas uzkrājas MI aģenta kontekstā, kāpēc tas kaitē precizitātei un kā iestatīt uzdevumus, kas paliek uzticami.
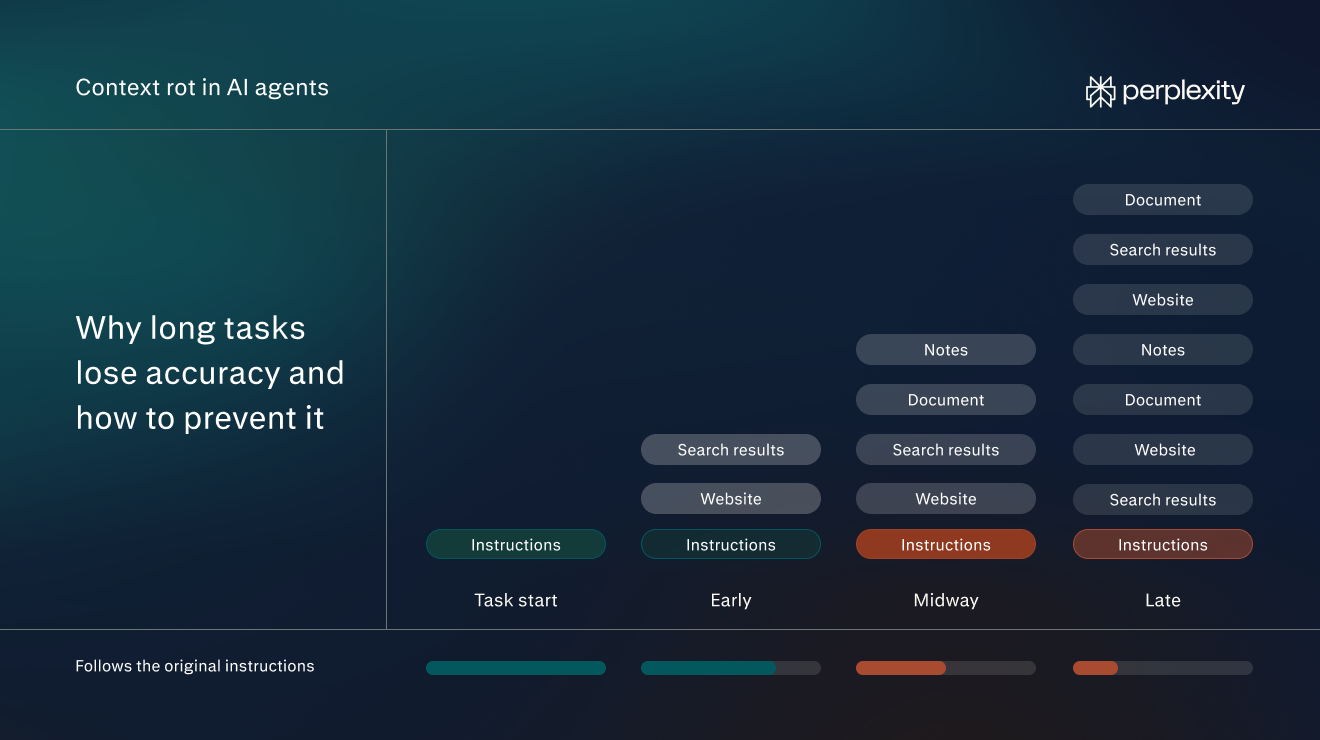
Ko konteksta degradācija nozīmē MI aģentiem
Konteksta degradācija MI aģentos ir pakāpenisks precizitātes zudums, kas iestājas, aģenta kontekstam piepildoties ilga uzdevuma laikā.
Aģenta konteksts ir informācija, kas modelim ir pieejama nākamajam solim. Tajā var būt norādījumi, iepriekšējie ziņojumi, meklēšanas rezultāti un teksts no tīmekļa vietnēm vai failiem. Aģentam strādājot, tas var pievienot vēl vairāk.
Piemēram, pieņemsim, ka aģenta uzdevums ir atrast piegādātājus, kas piegādā divu nedēļu laikā. Sākumā tā kontekstā ir tikai šis pieprasījums. Uzdevuma vidū kontekstā būs arī desmitiem piegādātāju tīmekļa vietņu teksts, vairākas meklēšanas rezultātu lapas un piezīmes par to, kurus piegādātājus aģents jau ir pārbaudījis.
Ir ierobežojums, cik daudz konteksta modelis var ietvert (to sauc par konteksta logu). Logu mēra tokenos — nelielos teksta fragmentos, parasti vārdā vai vārda daļā. Konteksta degradācija pastiprinās, kontekstam augot, tāpēc tā visbiežāk rodas ilgos uzdevumos ar daudziem soļiem.
Konteksta degradācijai pastiprinoties, aģents kļūs mazāk precīzs. Tas var mazāk rūpīgi ievērot sākotnējos norādījumus, nepamanīt detaļas vai sajaukt līdzīga izskata informāciju ar to, kas tam nepieciešama.
Piemēram, aģents var sākt iekļaut piegādātājus, kuriem piegāde aizņem sešas nedēļas, lai gan tam tika uzdots atrast piegādi divu nedēļu laikā. Norādījums joprojām ir tā kontekstā, taču tas vairs neietekmē aģenta izvēles.
Konteksta degradācija nav tas pats, kas vienkārši vietas trūkums konteksta logā. Kad uzdevuma konteksts pārsniedz logu, daļa materiāla tiek nogriezta vai uzdevums neizdodas. Konteksta degradācija sākas krietni pirms šī brīža, kamēr viss vēl ietilpst.
Tā nav arī tas pats, kas konteksta saindēšana (kad aģenta kontekstā nonāk maldinoša vai kaitīga informācija). Arī aģents ar precīzu un pilnīgu informāciju var piedzīvot konteksta degradāciju.
Kāpēc rodas konteksta degradācija
Konteksta degradācija rodas tāpēc, ka modeļa uzmanība ir ierobežota, pat ja tā konteksta logā vēl ir brīva vieta. MI modeļos uzmanība ir tehnisks termins tam, kā modelis izlemj, uz kurām ievades daļām balstīties, rakstot katru atbildes vārdu. Visas konteksta daļas sacenšas par šo uzmanību. Jo vairāk teksta, jo mazāk uzmanības saņem katra daļa.
Piemēram, Chroma publicēja pētījumu par to, kā ievades garums ietekmē MI modeļus. Tajā tika testēti 18 modeļi no Anthropic, OpenAI, Google un Alibaba. Vienā testā pētnieki paslēpa teikumu ar rakstīšanas padomu garā eseju krājumā. Pēc tam viņi jautāja modelim, kāds bija šis padoms.
Viņi atkārtoja testu daudzas reizes, katru reizi pievienojot vairāk eseju teksta. Teikums un jautājums nekad nemainījās. Mainījās tikai to aptverošā teksta apjoms.
Jo vairāk teksta modeļiem bija jāizlasa, jo sliktāk tiem veicās. Šis secinājums apstiprinājās visos ziņojuma testos. Pētnieki prognozē, ka precizitātes kritums būtu vēl lielāks reālā darbā, kas prasa daudzus soļus, kā tas ir vairumā aģentu uzdevumu.
Kā konteksta degradācija var ietekmēt MI aģentus
Konteksta degradācija parasti izpaužas vienā no četriem veidiem:
Sākotnējie norādījumi pazūd no redzesloka
Vienkāršākajā Chroma testā modeļiem lika precīzi nokopēt garu atkārtotu vārdu virkni, kurā kaut kur bija ievietots viens atšķirīgs vārds. Tas bija triviāls uzdevums ar skaidru norādījumu. Tomēr, tekstam kļūstot garākam, visu modeļu veiktspēja pasliktinājās. Daži modeļi sāka ģenerēt vārdus, kuru ievadē vispār nebija.
Aģenta uzdevumā lietotājs parasti jau sākumā nosaka konkrētus ierobežojumus, piemēram, budžetu vai nepieciešamo formātu. Kontekstam augot, aģents tos var piemērot mazāk konsekventi. Cēlonis ir konteksta kopējais garums, nevis norādījuma atrašanās vieta.
Nepamanītas detaļas no uzdevuma vidus
Saskaņā ar 2023. gada Stenfordas pētījumu MI modeļi visuzticamāk izmanto informāciju, ja tā atrodas pašā ievades sākumā vai pašās beigās. Vienā testā pētnieki modeļiem iedeva 20 dokumentu kopu un uzdeva jautājumu, uz kuru atbildi sniedza tikai viens no tiem. Kad šis dokuments bija pirmais vai pēdējais, modeļi parasti atrada atbildi. Kad tas atradās kopas vidū, tie to palaida garām daudz biežāk. Pētnieki to sauc par pozīcijas efektu.
Tā pati likumsakarība attiecas arī uz aģentiem. Informācija, kas atrasta agrāk uzdevuma gaitā, var nonākt garas sarunas vidū, kur dažiem modeļiem ir grūtāk to izmantot. Piegādātāju piemērā galīgajā sarakstā var netikt iekļauts labs piegādātājs, ko aģents pārbaudīja uzdevuma vidusposmā.
Līdzīgas informācijas sajaukšana
Kontekstam augot, aģentiem var kļūt grūtāk atpazīt, kura informācija atbilst to norādījumiem. Piemēram, pieņemsim, ka lietotājs aģentam lika atrast piegādātājus, kas nosūta preces „divu nedēļu laikā”. Kāda piegādātāja tīmekļa vietnē teikts: „piegāde 14 kalendāro dienu laikā no pasūtījuma veikšanas”. Īsā uzdevumā aģents, visticamāk, pamanītu, ka tas nozīmē vienu un to pašu. Ja šī informācija ir apslēpta starp desmitiem citu piegādātāju lapu, lielāka iespēja, ka aģents šo atbilstību nepamanīs.
Vai arī aģents var sākt iekļaut rezultātus, kas nav atbilstoši. Pieņemsim, ka aģents meklē biroja krēslu piegādātājus. Kāda piegādātāja tīmekļa vietnē solīta piegāde divu nedēļu laikā, taču tikai rakstāmgaldiem. Tā krēslu piegāde aizņem sešas nedēļas. Vietnē lietoti tie paši vārdi, kas norādījumā, tāpēc aģents tomēr var pievienot šo piegādātāju savam sarakstam. Pētnieki šādu informāciju sauc par distraktoru. Tā šķiet atbilstoša, bet tāda nav, tāpēc tā konkurē ar informāciju, kurai ir nozīme.
Chroma pētījumā atklājās, ka abas problēmas saasinājās, palielinoties apkārtējā teksta apjomam.
Grūti pamanāmas kļūdas
Konteksta degradācija neizraisa kļūdas ziņojumu. Aģents turpina darbu un atdod rezultātu, kas izskatās pabeigts. Tāpēc tā kļūdas ir viegli palaist garām.
Chroma testos šīs kļūdas izpaudās divos veidos. Dažreiz modelis pārliecinoši sniedza nepareizu atbildi. Piegādātāju izpētes piemērā aģents varētu iesniegt glītu, labi formatētu piegādātāju sarakstu, kurā iekļauts piegādātājs, kura piegādes noteikumus tas izprata nepareizi.
Citreiz modelis apgalvoja, ka nevar atrast informāciju, kas patiesībā tur bija. Piemēram, aģents varētu iesniegt pārskatu, kurā teikts, ka neviens piegādātājs neatbilst divu nedēļu termiņam, lai gan vairāki atbilst.
Kā iestatīt aģenta uzdevumus, lai mazinātu konteksta degradāciju
Pareizi iestatot uzdevumus, var mazināt konteksta degradācijas ietekmi un saglabāt aģenta precizitāti pēc iespējas augstāku visā uzdevuma gaitā. Palīdzēt var šī labā prakse.
Formulējiet uzdevumu kā konkrētu darba uzdevumu
Skaidrs darba uzdevums palīdz saglabāt kontekstu mazāku. Aģents zina, kad darbs ir paveikts, tāpēc pārtrauc vākt materiālu, tiklīdz tā ir pietiekami. Konkrētas prasības arī dod tam kaut ko taustāmu, ar ko salīdzināt katru lapu. Tas aģentam atvieglo pareizās informācijas atrašanu.
Pirms uzdevuma nosūtīšanas pārbaudiet, vai tas aptver trīs lietas:
- Uzdevums: kas aģentam jādara un jāizveido, piemēram, „atrodi piegādātājus un atgriez īso sarakstu”.
- Prasības: fakti, kurus aģents nevar uzminēt, piemēram, budžets, termiņš, piegādes adrese un tas, kam rezultāts paredzēts.
- Rezultāts: formāts, apjoms un struktūra, piemēram, „tabula ar nosaukumu, cenu par krēslu un piegādes laiku”.
Apkopojot visu kopā, piegādātāju uzdevuma vaicājums varētu izskatīties šādi:
„Atrodi 10 piegādātājus, kas divu nedēļu laikā var piegādāt 40 biroja krēslus uz mūsu biroju Čikāgā par mazāk nekā 250 USD par krēslu. Atgriez tabulu ar piegādātāja nosaukumu, cenu par krēslu, piegādes laiku un saiti uz produkta lapu. Saraksts paredzēts mūsu biroja vadītājam, kurš veiks pasūtījumu.”
Saglabājiet katru uzdevumu fokusētu
Viens uzdevums ar vienu skaidru mērķi ļauj saglabāt kontekstu mazu. Turklāt ilgi uzdevumi izmaksā vairāk. Katrā solī tiek apstrādāts viss līdz šim savāktais, tāpēc pārpildīta konteksta dēļ katrā solī tiek iztērēti papildu krediti.
Ja projektam ir vairākas daļas, sadaliet to:
- Uzskaitiet atsevišķos nododamos rezultātus, piemēram, piegādātāju meklēšanu, cenu salīdzinājumu un e-pastu izvēlētajam piegādātājam.
- Katru nododamo rezultātu veidojiet kā atsevišķu uzdevumu.
- Nododiet nākamajam uzdevumam tikai iepriekšējā uzdevuma gatavo rezultātu. Piemēram, augšupielādējiet piegādātāju tabulu kā failu, lai sāktu salīdzināšanas uzdevumu, nevis turpiniet pavedienā, kurā tā tika izveidota.
Tad salīdzināšanas uzdevums sākas ar vienu tabulu, nevis ar visām lapām.
Norādiet aģentam pareizos avotus
Katra lapa, ko aģents izlasa, papildina tā kontekstu, ieskaitot izvēlnes, reklāmas un šablona tekstu ap noderīgo daļu. Ja avotus aģentam norādāt tieši, šis troksnis samazinās.
Augšupielādējiet failus, no kuriem uzdevums ir atkarīgs, piemēram, apstiprināto piegādātāju sarakstu, pievienojot tos vaicājumam. Ja aģentam jāmeklē tīmeklī, nosauciet vietnes, kurās vērts meklēt, piemēram, divus uzticamus piegādātāju katalogus.
Pievienojiet rīkus, kuros atrodas informācija. Piemēram, Perplexity Computer sānjoslā atveriet sadaļu Savienotāji un iespējojiet uzdevumam nepieciešamās lietotnes, piemēram, Google Drive vai Slack. Pēc tam pieminiet tās vaicājumā: „Izmanto krēslu specifikācijas mūsu Google Drive.” Pievienojiet tikai atbilstošās lietotnes, jo katrs savienotājs aizņem daļu no aģenta konteksta.
Ja informācija atrodas lietotnē, kuras nav savienotāju sarakstā, to joprojām var būt iespējams pievienot. Daudzās lietotnēs ir pieejams MCP (Model Context Protocol) savienotājs — standarta veids, kā MI rīki var pieslēgties citai programmatūrai. Computer var tos izmantot līdztekus saviem iebūvētajiem savienotājiem. Uzņēmuma kontā administratoram tie, iespējams, vispirms būs jāiespējo.
Lūdziet noslēgumā pārbaudīt atbilstību norādījumiem
Noslēdziet vaicājumu ar pārskatīšanas soli, kurā nosaukti svarīgākie ierobežojumi:
„Pirms pabeigšanas pārbaudi katru piegādātāju atbilstoši šīm prasībām: piegāde divu nedēļu laikā, mazāk nekā 250 USD par krēslu. Atzīmē visus, kas šīm prasībām neatbilst, nevis izlaid tos.”
Ierobežojumi joprojām atrodas konteksta sākumā. Pārskatīšanas solis dod aģentam iemeslu salīdzināt savu galīgo rezultātu ar ierobežojumiem, nevis paļauties uz to, ka norādījumi saglabās ietekmi visos soļos.
Savukārt, ja lūdzat atzīmēt problēmas, nevis vienkārši izmest attiecīgos rezultātus, kļūdas ir vieglāk pamanīt (piemēram, ja tiek noraidīts piegādātājs, kas sola piegādi 14 kalendāro dienu laikā, jo tas neizmanto vārdus „divas nedēļas”).
Pārskatiet darbu kontrolpunktos
Ilgākiem uzdevumiem iekļaujiet vaicājumā kontrolpunktu:
„Sāc, atrodot 20 piegādātāju kandidātus, un tad apstājies. Es apstiprināšu sarakstu, pirms tu vāc cenas.”
Pārbaudiet īso sarakstu atbilstoši sākotnējiem norādījumiem. Izlabojiet nepilnības papildu ziņojumā, tad ļaujiet aģentam turpināt. Šajā posmā pamanītās kļūdas nepāries uz visiem nākamajiem soļiem.
Sāciet jaunu uzdevumu, ja esošais novirzās no kursa
Ja aģents pēc labojumiem atkārto to pašu kļūdu, sāciet jaunu uzdevumu. Katrs labojums pievieno vēl vairāk teksta jau tā garajam kontekstam. Tā vietā izveidojiet jaunu uzdevumu. Atkārtojiet norādījumus, augšupielādējiet visu labo rezultātu no pirmā mēģinājuma un sāciet no jauna.
Daži aģenti automātiski dara kaut ko līdzīgu — šo procesu sauc par kompaktēšanu. Uzdevumam kļūstot garam, aģents aizstāj vecāku materiālu, piemēram, sākumā izlasīto lapu pilno tekstu, ar īsu kopsavilkumu par atrasto. Perplexity Portable Computer šādi kompaktē savu kontekstu, lai modelis paliktu apjoma robežās, ar ko tas var labi tikt galā.
Tāpat ir svarīgi sākt jaunu uzdevumu, ja mainās mērķis. Pavediens, kas sākās kā piegādātāju meklēšana, nedrīkstētu kļūt arī par līguma pārskatīšanu.
Pārvērtiet atkārtotus norādījumus par Skill
Daži norādījumi atkārtojas katrā noteikta veida uzdevumā, piemēram, vēlamais tabulas formāts, piegādātāju saraksts, no kuriem izvairīties, vai standarta pārskatīšanas solis. Rīkā Computer tos var saglabāt kā Skill — atkārtoti izmantojamu norādījumu kopu, ko aģents ievēro katru reizi. Skill iestrādā pārējo labo praksi katrā uzdevumā, kurā tas tiek izmantots.
Lai to iestatītu:
- Izvēlieties uzdevumu, kas atkārtojas bieži, piemēram, piegādātāju izpēti.
- Pierakstiet norādījumus, ko sniedzat katru reizi: formātu, pārbaudes, avotus, kurus izmantot vai no kuriem izvairīties.
- Saglabājiet tos kā Skill. Norādījumus, kas jau uzrakstīti Markdown formātā, var importēt tieši.
- Turpmākajos vaicājumos nosauciet Skill: „Izmanto piegādātāju izpētes Skill, lai atrastu krēslu piegādātājus Denveras birojam.”
Kā Perplexity pārvalda kontekstu aģentu darbā
Perplexity Computer apstrādā ilgus uzdevumus tā, lai katra modeļa konteksts būtu neliels un atbilstošs. Trīs tā dizaina elementi ierobežo, cik daudz modelim jāizlasa vienlaikus.
Darba sadalīšana starp apakšaģentiem
Computer sadala pieprasījumu uzdevumos un apakšuzdevumos, pēc tam izveido apakšaģentus to izpildei. Katrs apakšaģents strādā pie vienas darba daļas savā kontekstā. Piegādātāju uzdevumā viens apakšaģents var izpētīt cenas, kamēr cits pārbauda piegādes noteikumus. Nevienam no tiem nav jāizlasa viss, ko izlasīja otrs.
Darba glabāšana failos
Katram Computer uzdevumam ir sava darbvieta ar saviem failiem, tīmekļa pārlūku un rīkiem. Aģents var saglabāt savu darbu failā, piemēram, pastāvīgi papildinātā tabulā ar jau pārbaudītajiem piegādātājiem. Pēc tam tas atver šo failu tikai tad, kad tas ir nepieciešams.
Atbilstošu fragmentu atlase no meklēšanas rezultātiem
Tīmekļa lapas ir pilnas ar materiālu, kas modelim nav vajadzīgs, piemēram, izvēlnēm, reklāmām, metadatiem un tekstu par citām tēmām. Vaicājumam pielāgota konteksta saspiešana to izņem. Pirms lapa nonāk līdz modelim, Perplexity saglabā tikai tos teikumus, kas attiecas uz vaicājumu.
Izpētiet Perplexity Computer padomus, ceļvežus un uzdevumu piemērus, lai šos soļus īstenotu praksē.
Biežāk uzdotie jautājumi
Vai konteksta degradācija ir tas pats, kas halucinācija?
Nē, taču tās ir saistītas. Halucinācija ir jebkura atbilde, kurā apgalvots kaut kas nepatiess vai nepamatots. Konteksta degradācija ir viens no apstākļiem, kas palielina halucināciju iespējamību, kā arī citu kļūdu, piemēram, ignorētu norādījumu un nepamanītu detaļu, iespējamību.
Vai labāks vaicājums var novērst konteksta degradāciju?
Skaidrs vaicājums mazina konteksta degradāciju, palīdzot saglabāt uzdevuma fokusu. Tomēr tas nevar apturēt konteksta augšanu. Pietiekami ilgā uzdevumā aģents joprojām savāc vairāk, nekā spēj labi izmantot, tāpēc darba sadalīšana un tā pārbaude pa ceļam ir tikpat svarīga kā pats vaicājums.
Vai konteksta degradācija ietekmē arī parastas MI tērzēšanas, ne tikai aģentus?
Jā. Tērzēšanā konteksts ir visa līdzšinējā saruna, ieskaitot katru ziņojumu un visus tajā ielīmētos vai augšupielādētos dokumentus. Pavediens, kas turpinājies stundām ilgi par vairākām tēmām, var radīt tādas pašas kļūdas kā ilgs aģenta uzdevums. Sākot jaunu pavedienu katrai jaunai tēmai, katra saruna paliek fokusēta.
Cik ilgs var būt uzdevums, pirms sākas konteksta degradācija?
Fiksēta sliekšņa nav. Tas ir atkarīgs no modeļa un uzdevuma. Piemēram, ierīcē darbināmiem modeļiem ar 260 000 tokenu konteksta logiem grūtības sākas, pārsniedzot aptuveni 100 000 tokenu, krietni pirms to robežas. Turklāt kritums ir pakāpenisks, nevis pēkšņs.