
शोध इंजिनांचे प्रकार: क्रॉलर, मेटा शोध आणि AI उत्तर इंजिने
क्रॉलर-आधारित, मेटा शोध आणि AI उत्तर इंजिने परिणाम कसे शोधतात आणि देतात, तसेच गोपनीयता-केंद्रित आणि सशुल्क ते व्हर्टिकल, प्रादेशिक आणि एंटरप्राइझ असे शोध इंजिनांचे इतर प्रकार.
सर्च इंजिनच्या प्रकारांमधील मुख्य फरक म्हणजे ते माहिती कुठून मिळवतात आणि कोणत्या प्रकारचे निकाल देतात.
क्रॉलर-आधारित इंजिन स्वतः तयार केलेल्या इंडेक्समध्ये शोध घेतात, तर मेटा सर्च इंजिन इतर अनेक इंजिनांचे निकाल एकत्र करतात. AI उत्तर इंजिनदेखील इंडेक्स केलेले स्रोत वापरतात, पण इतर प्रकारांच्या विपरीत, ते तुम्हाला लिंक्सची यादी देत नाहीत; ते त्या माहितीचा वापर करून तुमच्यासाठी खास तयार केलेले उत्तर लिहितात.
सर्च इंजिनचे तीन मुख्य प्रकार कसे काम करतात, ते उदाहरणांसह येथे दिले आहे. तुम्हाला आढळणारे इतर प्रकार (गोपनीयता-केंद्रित, सशुल्क, व्हर्टिकल, प्रादेशिक आणि एंटरप्राइझ इंजिन, तसेच वेब डिरेक्टरी) आणि एखादे इंजिन निवडण्यास मदत करणारे प्रश्नही आम्ही मांडले आहेत.
सर्च इंजिन म्हणजे काय?
सर्च इंजिन हे एक सॉफ्टवेअर आहे, जे तुमच्या शोध क्वेरीशी जुळणारा मजकूर शोधते आणि तो शोध निकालांच्या स्वरूपात दाखवते.
Google किंवा Bing सारखी इंटरनेट सर्च इंजिन वर्ल्ड वाइड वेबवर शोध घेतात, तर इतर इंजिन जॉब बोर्ड किंवा संशोधन निबंधांच्या डेटाबेससारख्या संग्रहांमध्ये शोध घेतात.
प्रकारानुसार, शोध निकाल म्हणजे पेजेसच्या लिंक्सची क्रमवार यादी असू शकते किंवा सापडलेल्या स्रोतांवरून तयार केलेले लिखित उत्तर असू शकते.
सर्च इंजिन विरुद्ध वेब ब्राउझर
वेब ब्राउझर म्हणजे वेब पेजेस उघडण्यासाठी आणि दाखवण्यासाठी तुम्ही वापरता ते ॲप, जसे की Perplexity चे Comet, Chrome, Safari, Edge किंवा Firefox, तर सर्च इंजिन ही तुमच्यासाठी ती पेजेस शोधणारी सेवा आहे.
ब्राउझरच्या ॲड्रेस बारमध्ये तुम्ही वेब पत्ता टाइप करता, तेव्हा तो तुम्हाला त्या पेजवर घेऊन जातो. त्याऐवजी तुम्ही शोध शब्द टाइप करता, तेव्हा ब्राउझर तो त्याच्या डीफॉल्ट सर्च इंजिनकडे पाठवतो (Comet साठी Perplexity, Chrome साठी Google Search, Edge साठी Bing), जोपर्यंत तुम्ही ब्राउझरच्या सेटिंग्जमध्ये डीफॉल्ट बदलत नाही
सर्च इंजिनचे तीन मुख्य प्रकार
सर्च इंजिनमधील फरक त्यांचे निकाल कुठून येतात आणि ते कसे दिसतात यात असतो. निकाल इंजिनच्या स्वतःच्या इंडेक्समधून, परवान्याअंतर्गत दुसऱ्या इंजिनच्या इंडेक्समधून किंवा एकाच वेळी अनेक इंजिनांमधून येऊ शकतात, आणि ते पेजेसची क्रमवार यादी किंवा संदर्भांसह लिखित उत्तर असतात.
क्रॉलर-आधारित आणि मेटा सर्च इंजिन दोन्ही लिंक्सची क्रमवार यादी देतात, पण ते निकाल वेगवेगळ्या प्रकारे मिळवतात: क्रॉलर-आधारित इंजिन स्वतः तयार केलेल्या इंडेक्समध्ये शोध घेते, तर मेटा सर्च इंजिन तुमची क्वेरी इतर अनेक इंजिनांकडे पाठवते आणि त्यांनी दिलेले निकाल एकत्र करते.
AI उत्तर इंजिनदेखील इंडेक्समध्ये शोध घेतात, पण पारंपरिक सर्च इंजिनप्रमाणे पेजेसची यादी देण्याऐवजी ते उत्तर लिहितात. आता अनेक इंजिन दोन्ही करतात. Google, Bing आणि Brave Search त्यांच्या क्रमवार लिंक्सच्या वर AI-लिखित उत्तरे जोडतात.
प्रकार | निकाल कुठून येतात | तुम्हाला काय मिळते | कशासाठी सर्वोत्तम | तडजोड | उदाहरणे |
क्रॉलर-आधारित | स्वतःचा इंडेक्स किंवा क्रॉलर-आधारित इंजिनकडून परवान्याने घेतलेला इंडेक्स | क्रमवार यादी (अनेक इंजिन AI उत्तरेही जोडतात) | व्यापक शोध, विशिष्ट पेज शोधणे | वेबकडे पाहण्याचा एकाच इंजिनचा दृष्टिकोन; पेजेसची तुलना तुम्हाला स्वतः करावी लागते | Google, Bing, Brave Search, DuckDuckGo |
मेटा सर्च | एकाच वेळी अनेक इंजिन | क्रमवार यादी | निकालांची अधिक व्यापक श्रेणी | हळू: ठरावीक वेळेच्या मर्यादेपर्यंत अनेक इंजिनांच्या प्रतिसादाची वाट पाहते | eTools.ch, SearXNG, MetaGer |
AI उत्तर इंजिन | स्वतःचा किंवा परवान्याने घेतलेला इंडेक्स | संदर्भांसह लिखित उत्तर | अनेक स्रोतांची गरज असलेले गुंतागुंतीचे प्रश्न | संदर्भ दिलेली पेजेस तपासा | Perplexity, Google AI Mode |
क्रॉलर-आधारित सर्च इंजिन
Google किंवा Bing सारखे क्रॉलर-आधारित सर्च इंजिन तुमच्या क्वेरीची उत्तरे स्वतःच्या इंडेक्समधील वेब पेजेसवर शोधते. व्यापक वेब शोधांसाठी किंवा विशिष्ट साइट किंवा पेज शोधण्यासाठी ते सर्वोत्तम आहे.
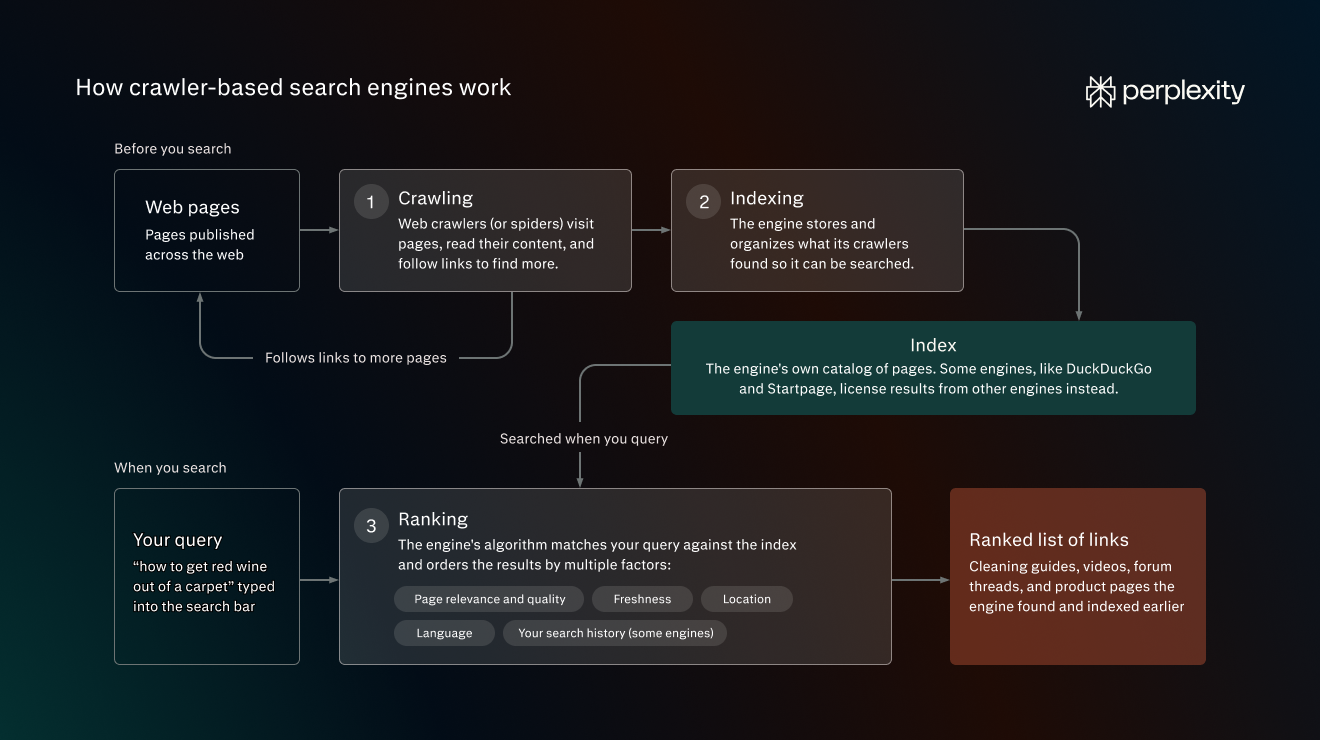
क्रॉलर-आधारित सर्च इंजिन असे काम करतात:
- क्रॉलिंग: वेब क्रॉलर (किंवा स्पायडर) नावाचे प्रोग्राम पेजेसना भेट देतात, त्यांचा मजकूर वाचतात आणि आणखी पेजेस शोधण्यासाठी लिंक्सचे अनुसरण करतात.
- इंडेक्सिंग: क्रॉलरना जे सापडले त्यात शोध घेता यावा यासाठी इंजिन ते साठवते आणि व्यवस्थित करते.
- रँकिंग: तुम्ही शोध घेता, तेव्हा इंजिनचा अल्गोरिदम तुमची क्वेरी इंडेक्सशी जुळवतो आणि पेजची प्रासंगिकता व गुणवत्ता, ताजेपणा, स्थान, भाषा आणि काही इंजिनांच्या बाबतीत तुमचा शोध इतिहास अशा अनेक घटकांनुसार निकालांचा क्रम ठरवतो.
त्यामुळे, तुम्ही सर्च बारमध्ये "कार्पेटवरील रेड वाइनचा डाग कसा काढायचा" असे टाइप करता, तेव्हा शोध निकालांच्या पेजवर स्वच्छतेविषयक मार्गदर्शक, व्हिडिओ, फोरम थ्रेड्स आणि उत्पादन पेजेसची क्रमवार यादी दिसते, जी सर्च इंजिनने आधीच शोधून आपल्या इंडेक्समध्ये नोंदवलेली असतात.
क्रॉलर-आधारित इंजिनमध्ये रँक मिळवण्यासाठी, सर्च इंजिन ऑप्टिमायझेशन (SEO) तज्ज्ञ प्रत्येक महत्त्वाचे पेज क्रॉल आणि इंडेक्स करण्यास सोपे असेल आणि कीवर्डमागील क्वेरीचे उत्तर स्पर्धक पेजेसपेक्षा अधिक चांगल्या प्रकारे देईल याची खात्री करतात.
शोध बाजारपेठेतील सर्वात मोठा वाटा असलेले Google Search हे सर्वात सुप्रसिद्ध क्रॉलर-आधारित इंजिन आहे. इतर इंजिनांमध्ये Bing, Brave Search आणि यूकेमधील Mojeek व स्वीडनमधील Marginalia सारख्या स्वतंत्र इंजिनांचा समावेश आहे.
काही इंजिन स्वतः वेब क्रॉल करत नाहीत, तर इतरांकडून परवान्याने निकाल घेतात. उदाहरणार्थ, DuckDuckGo त्याच्या पारंपरिक लिंक्स मुख्यतः Bing कडून (तसेच स्वतःच्या क्रॉलरकडून) मिळवते, आणि Startpage त्या Google आणि Bing कडून मिळवते.
मेटा सर्च इंजिन
मेटा सर्च इंजिन तुमची क्वेरी इतर अनेक सर्च इंजिनांकडे पाठवते आणि त्यांचे निकाल एकत्र करते. उदाहरणार्थ, eTools.ch 17 वेगवेगळ्या डेटा स्रोतांमध्ये शोध घेते.
मेटा सर्च इंजिन चार टप्प्यांत शोध क्वेरींची उत्तरे देतात:
- एकाच वेळी अनेक इंजिनांकडे क्वेरी पाठवतात.
- प्रत्येक इंजिनकडून निकाल गोळा करतात.
- डुप्लिकेट निकाल एकत्र करून त्यांना पुन्हा गुण देतात. उदाहरणार्थ, अनेक इंजिनांनी एखाद्या पेजला वरचे स्थान दिले असल्यास, ते पेज वर सरकते.
- क्रमवार निकालांसह एकच पेज दाखवतात.
तुम्ही eTools.ch वर "कार्पेटवरील रेड वाइनचा डाग कसा काढायचा" असा शोध घेता, तेव्हा तुम्हाला DuckDuckGo, Yahoo, Google आणि इतर इंजिनांचे निकाल मिळतात. आमच्या चाचणीत, Google चा #1 निकाल येथे फक्त #4 वर आहे.
तुम्हाला शोधाचे जाळे अधिक व्यापक पसरवायचे असेल, तेव्हा मेटा सर्च इंजिन हा चांगला पर्याय आहे, पण ते अनेक इंजिनांच्या प्रतिसादाची (ठरावीक वेळेच्या मर्यादेपर्यंत) वाट पाहत असल्याने ते लोड होण्यास अधिक वेळ लागू शकतो.
eTools.ch व्यतिरिक्त, लोकप्रिय मेटा सर्च इंजिनांमध्ये SearXNG, MetaGer आणि Dogpile यांचा समावेश आहे.
DuckDuckGo कधीकधी मेटा सर्च इंजिनच्या यादीत दिसते, पण ते अनेक इंजिनांचे निकाल एकत्र करण्याऐवजी Bing कडून परवान्याने निकाल घेते.
AI उत्तर इंजिन
Perplexity सारखे AI सर्च इंजिन स्रोत शोधते आणि त्यांचा वापर करून तुमच्या विशिष्ट प्रश्नाचे उत्तर लिहिते, ज्यात त्याने वापरलेल्या पेजेसच्या लिंक्स असलेले संदर्भ दिलेले असतात.
AI उत्तर इंजिन कसे काम करतात:
- प्रश्न वाचते: लार्ज लँग्वेज मॉडेल (LLM) तुमच्या क्वेरीचा अर्थ लावते, ज्यात लांबलचक, संवादात्मक प्रश्नांचाही समावेश असतो, आणि क्वेरी फॅन-आउट नावाच्या प्रक्रियेत ती अनेक शोधांमध्ये विभागू शकते.
- स्रोत शोधते: ते हे शोध वेब इंडेक्सवर चालवते, त्यामुळे मॉडेलला प्रशिक्षित केल्यानंतर प्रकाशित झालेल्या पेजेसचाही उत्तरात वापर होऊ शकतो, आणि ते केवळ संपूर्ण पेजेसनाच नव्हे, तर स्वतंत्र परिच्छेदांनाही प्रश्नाच्या आधारे गुण देते.
- उत्तर लिहिते: LLM मिळवलेल्या परिच्छेदांवरून उत्तर लिहिते.
क्रॉलर-आधारित इंजिनप्रमाणेच, AI उत्तर इंजिनदेखील स्वतःच्या किंवा परवान्याने घेतलेल्या इंडेक्समध्ये शोध घेतात. उदाहरणार्थ, Perplexity स्वतःचा इंडेक्स चालवते, तर ChatGPT Search स्वतःच्या इंडेक्ससोबत तृतीय-पक्ष इंडेक्सचा वापर करते.
AI उत्तर इंजिन अनेक स्रोतांमधील माहितीवरून उत्तरे तयार करतात, त्यामुळे एकाच पेजवर ज्यांचे उत्तर मिळण्याची शक्यता कमी असते, अशा गुंतागुंतीच्या किंवा विशिष्ट क्वेरींसाठी ते सर्वोत्तम असतात.
उदाहरणार्थ, आम्ही Perplexity ला विचारले, "माझ्या 16 वर्षांच्या मुलीकडे इलिनॉयमध्ये लर्नर्स परमिट आहे, पण आम्ही मार्चमध्ये ॲरिझोनाला स्थलांतर करत आहोत. तिने आता सरावाचे तास नोंदवणे सुरू ठेवावे का, ॲरिझोना ते तास ग्राह्य धरेल का आणि तिला ॲरिझोना MVD कडे काय घेऊन जावे लागेल?" तेव्हा प्रश्नाच्या प्रत्येक भागाचे उत्तर देण्यासाठी त्याने 15 स्रोतांचा वापर केला.
Google च्या पारंपरिक क्रमवार निकालांमध्ये (AI Overview शिवाय), याच प्रश्नासाठी पेजेसची यादी मिळते, त्यामुळे तुम्हाला प्रत्येक पेज उघडून संबंधित माहिती स्वतः शोधावी लागते.
मात्र, उत्तर लिहिताना LLM चुकीची काल्पनिक माहिती (हॅल्युसिनेशन) देऊ शकतात, त्यामुळे AI उत्तरावर अवलंबून राहण्यापूर्वी संदर्भ दिलेली पेजेस उघडा आणि AI उत्तरातील दावे तपासा.
AI उत्तरांमध्ये संदर्भ म्हणून स्थान मिळवण्यासाठी वेबपेजेसना त्याच SEO पायाची गरज असते. मात्र, आन्सर इंजिन ऑप्टिमायझेशन (AEO) मजकूर AI उत्तर इंजिनांना प्रक्रिया करण्यास आणि संदर्भ म्हणून वापरण्यास सोपा बनवण्यावर अधिक भर देते, उदाहरणार्थ, असे विभाग तयार करून, ज्यातील प्रत्येक विभाग संदर्भापासून वेगळा काढला तरीही एका विशिष्ट प्रश्नाचे स्पष्ट उत्तर देतो.
सर्च इंजिनचे इतर प्रकार
सर्च इंजिनचे उद्देश, वापरकर्ते किंवा व्यवसाय मॉडेलनुसारही गट करता येतात. यांपैकी काही गट तीन मुख्य प्रकारांमध्येही मोडतात. उदाहरणार्थ, गोपनीयता-केंद्रित इंजिन स्वतःचा इंडेक्स चालवू शकते किंवा परवान्याने निकाल घेऊ शकते.
प्रकार | त्याचे वेगळेपण | कशासाठी सर्वोत्तम | तडजोड | उदाहरणे |
गोपनीयता-केंद्रित | वैयक्तिक डेटा ट्रॅक करत नाही | तुमच्या इतिहासाशी जोडले जाऊ नयेत असे शोध | वैयक्तिकृत निकाल नाहीत | DuckDuckGo, Startpage |
सशुल्क, जाहिरातमुक्त | जाहिरातींऐवजी सबस्क्रिप्शनद्वारे निधी | जाहिराती किंवा जाहिरात लक्ष्यीकरणाशिवाय निकाल | छोट्या विनामूल्य चाचणीनंतर सबस्क्रिप्शन | Kagi |
व्हर्टिकल | एकाच प्रकारच्या कंटेंटमध्ये शोध घेते | विशेष कंटेंट, त्या कंटेंटसाठी फिल्टर्ससह | त्या संग्रहाबाहेरचे काहीही नाही | PubMed, Indeed, YouTube |
प्रादेशिक | एका देशासाठी किंवा भाषेसाठी अनुकूलित | त्या भाषेत किंवा स्थानिक माहितीसाठी शोध घेणे | मूळ भाषेबाहेर आणि मूळ बाजारपेठेबाहेर कमकुवत व्याप्ती | Yandex, Seznam, Baidu, Naver |
वेब डिरेक्टरी किंवा हायब्रिड | मानवी संपादकांनी निवडलेल्या साइट्स, कधीकधी फिल्टर केलेल्या क्रॉलर परिणामांसह मिश्रित | एका विषयासाठी किंवा एका प्रेक्षकवर्गासाठी तपासलेला, विश्वासार्ह प्रारंभबिंदू | खूपच कमी परिणाम, अपडेट होण्यास वेळ लागतो | Curlie, MedlinePlus, Kiddle, fragFINN |
एंटरप्राइझ | संस्थेच्या स्वतःच्या ॲप्स आणि फाइल्समध्ये शोध घेते | अंतर्गत दस्तऐवज, संदेश आणि नोंदी शोधणे | फक्त तुमच्या संस्थेने कनेक्ट केलेले स्रोतच समाविष्ट करते | Coveo, Atlassian Rovo, Onyx |
गोपनीयता-केंद्रित शोध इंजिने
DuckDuckGo किंवा Startpage सारखे गोपनीयता-केंद्रित शोध इंजिन तुम्ही काय शोधता याची अशी कोणतीही नोंद ठेवत नाही, जिचा माग तुमच्यापर्यंत काढता येईल.
DuckDuckGo तुमचा शोध इतिहास जतन किंवा शेअर करत नाही, आणि इतर इंजिने परिणाम वैयक्तिकृत करण्यासाठी वापरतात तो तुमचा IP पत्ता आणि इतर वैयक्तिक डेटा Startpage काढून टाकते.
दोन्ही इंजिने त्यांचे परिणाम मोठ्या इंजिनांकडून परवान्याने घेतात (DuckDuckGo साठी Bing, Startpage साठी Google आणि Bing), त्यामुळे तुम्हाला मोठ्या इंडेक्सचा लाभ मिळतोच, पण अतिरिक्त गोपनीयतेसह.
सशुल्क, जाहिरातमुक्त शोध इंजिने
Kagi सारख्या सशुल्क शोध इंजिनला जाहिरातींऐवजी वापरकर्त्यांच्या सदस्यता शुल्कातून निधी मिळतो.
सशुल्क शोध इंजिनांना जाहिरात लक्ष्यीकरणासाठी वैयक्तिक डेटा गोळा करण्याची गरज नसते, आणि ती पृष्ठांची क्रमवारी वेगळ्या पद्धतीने लावू शकतात.
उदाहरणार्थ, जाहिराती आणि ट्रॅकर्सने भरलेल्या पृष्ठांना Kagi क्रमवारीत खाली ठेवते, कारण अशा पृष्ठांचा संबंध कमी दर्जाच्या आशयाशी असतो असे त्याला आढळले आहे, आणि ते स्वतंत्र व वैयक्तिक साइट्सना प्राधान्य देते.
व्हर्टिकल शोध इंजिने
व्हर्टिकल शोध इंजिन संशोधन लेख, नोकऱ्या किंवा व्हिडिओ यांसारख्या एकाच प्रकारच्या आशयावर लक्ष केंद्रित करते. उदाहरणार्थ, PubMed जैववैद्यकीय साहित्यात शोध घेते, Indeed नोकरीच्या जाहिरातींमध्ये शोध घेते, आणि YouTube, TikTok किंवा Reddit सारखे UGC प्लॅटफॉर्म फक्त त्यांच्या स्वतःच्या आशयात शोध घेतात.
प्रत्येक इंजिन एकाच प्रकारचा आशय समाविष्ट करत असल्यामुळे, ते तुम्हाला सामान्य इंजिनमध्ये शक्य नसलेल्या पद्धतींनी शोध परिणाम फिल्टर करू देते, जसे की पगार श्रेणी किंवा प्रकाशन प्रकारानुसार.
प्रादेशिक शोध इंजिने
रशियातील Yandex, चेक प्रजासत्ताकातील Seznam किंवा चीनमधील Baidu सारखे प्रादेशिक शोध इंजिन एकाच देशावर किंवा भाषेवर लक्ष केंद्रित करते. तुम्ही त्या भाषेत शोध घेता किंवा जवळपासची दुकाने किंवा सेवा यांसारखा स्थानिक शोध घेता, तेव्हा ही इंजिने अधिक सुसंगत परिणाम देऊ शकतात.
काही प्रादेशिक शोध इंजिनांचा त्यांच्या मूळ बाजारपेठेत मोठा वाटा आहे. उदाहरणार्थ, रशियातील शोध रेफरलपैकी 70.22% वाटा Yandex चा आहे, तर Google चा वाटा 28.36% आहे (StatCounter, ऑक्टोबर 2026).
वेब डिरेक्टरीज आणि हायब्रिड शोध इंजिने
वेब डिरेक्टरीमध्ये मानवी संपादकांनी निवडलेल्या आणि विषयानुसार वर्गीकृत केलेल्या साइट्सची यादी असते.
उदाहरणार्थ, DMOZ चा स्वयंसेवकांद्वारे चालवला जाणारा उत्तराधिकारी Curlie, स्वयंसेवक संपादकांनी जोडलेल्या 30 लाखांहून अधिक साइट्सची यादी देतो, आणि US National Library of Medicine द्वारे चालवले जाणारे MedlinePlus प्रत्येक आरोग्य विषयावरील तपासलेली पृष्ठे एकत्र करते.
हायब्रिड इंजिने वेब डिरेक्टरीमधील सूची क्रॉलर परिणामांसोबत एकत्र करतात. मुलांसाठीचे शोध इंजिन Kiddle संपादकांनी तपासलेली पृष्ठे परिणामांच्या सर्वात वर ठेवते, त्यानंतर Google SafeSearch द्वारे फिल्टर केलेले परिणाम दाखवते, आणि fragFINN फक्त माध्यम शिक्षकांच्या टीमने मंजूर यादीत समाविष्ट केलेली पृष्ठेच दाखवते.
एंटरप्राइझ शोध इंजिने
Coveo, Atlassian Rovo किंवा Onyx सारखे एंटरप्राइझ शोध इंजिन संस्थेच्या स्वतःच्या आशयात शोध घेते, जसे की दस्तऐवज, ईमेल, डेटाबेस नोंदी आणि चॅट संदेश, ज्यांच्यापर्यंत सार्वजनिक शोध इंजिने पोहोचू शकत नाहीत.
एंटरप्राइझ शोध इंजिने Slack, Gmail, Notion किंवा Salesforce सारख्या संस्थेच्या ॲप्समधील आशय आणि मेटाडेटा खाजगी इंडेक्समध्ये सिंक करतात किंवा त्यांना थेट क्वेरी करतात, आणि नंतर प्रत्येक वापरकर्त्याच्या ॲक्सेस परवानग्यांनुसार परिणाम फिल्टर करतात, जेणेकरून लोकांना फक्त तेच दिसते जे पाहण्याची त्यांना परवानगी आहे.
सर्वोत्तम शोध इंजिन कसे निवडावे
तुमच्या गरजांसाठी सर्वोत्तम शोध इंजिन निवडताना, हे घटक विचारात घ्या:
- सुसंगतता: Google आणि Bing अनेक भाषा समाविष्ट करतात, परंतु प्रादेशिक इंजिन त्याच्या मूळ भाषेत अधिक सुसंगत शोध परिणाम देऊ शकते. विशेषीकृत आशयासाठी, PubMed सारखे व्हर्टिकल इंजिन आशय इंडेक्स करते आणि सामान्य इंजिनमध्ये नसलेले फिल्टर्स देते.
- उत्तराचे स्वरूप: गुंतागुंतीच्या क्वेरींसाठी किंवा क्रमवारीत येणारा आशय तुटपुंजा असताना, AI उत्तर इंजिन अधिक जलद ठरते. तथापि, त्याच्याकडून चुका होऊ शकतात, त्यामुळे महत्त्वाच्या निर्णयांसाठी उत्तरे तपासल्याशिवाय कधीही वापरू नका.
- वेग: क्रॉलर-आधारित इंजिने त्यांचे परिणाम त्वरित लोड करतात, आणि मेटा शोध इंजिने त्यांच्यापेक्षा केवळ किंचित मंद असतात. AI उत्तर इंजिनांना उत्तर लिहिण्यास अधिक वेळ लागतो, परंतु उत्तर शोधण्यासाठी अनेक स्रोत वाचावे लागत असतील तेव्हा ती वेळ वाचवतात.
- गोपनीयता: काही इंजिने परिणामांची क्रमवारी अंशतः तुमच्या शोध इतिहासावर आणि इतर वैयक्तिक डेटावर आधारित ठरवतात. तुम्हाला तो डेटा शेअर करायचा नसेल, किंवा तुमच्या इतिहासाचा परिणामांवर प्रभाव पडू नये असे वाटत असेल, तर DuckDuckGo आणि Startpage सारखी खाजगी शोध इंजिने वापरा.
- जाहिराती: तुम्हाला जाहिराती पाहायच्या नसतील, तर Kagi सारखे सशुल्क इंजिन वापरा.
- शोध अनुभव: फिल्टर्स आणि परिणामांवर नजर फिरवणे किती सोपे आहे ते तपासा. Google आणि Bing वापरकर्त्यांना प्रतिमा वापरूनही शोध घेऊ देतात, त्यामुळे तुम्ही विशिष्ट दृश्य असलेली पृष्ठे शोधू शकता. DuckDuckGo, Brave Search आणि Kagi हे bangs ला सपोर्ट करतात, म्हणजे असे शॉर्टकट जे शोध थेट दुसऱ्या साइटच्या परिणामांकडे पाठवतात.
Perplexity: स्वतःचा शोध इंडेक्स असलेले AI उत्तर इंजिन
Perplexity हे एक AI उत्तर इंजिन आहे, जे त्याच्या इंडेक्समध्ये आणि थेट वेबवर शोध घेऊन तुमच्या प्रश्नाचे उत्तर लिहिते, ज्यात स्रोतांशी लिंक केलेले क्रमांकित संदर्भ असतात, जेणेकरून प्रत्येक दावा कुठून आला आहे हे तुम्ही तपासू शकता.
Perplexity चा क्रॉलर, PerplexityBot, त्याच्या इंडेक्ससाठी पृष्ठे गोळा करतो. तुम्ही प्रश्न विचारता तेव्हा, Perplexity त्याचे सर्वोत्तम उत्तर देणारे उतारे निवडते आणि त्यांच्या आधारे उत्तर लिहिते. उत्तर देताना Perplexity एखादे पृष्ठ थेट उघडूही शकते.
ज्या प्रश्नांना अधिक सखोल उत्तराची आवश्यकता असते, त्यांच्यासाठी संशोधन मोड डझनभर शोध घेतो, शेकडो स्रोत वाचतो आणि निष्कर्षांचे रूपांतर संपूर्ण अहवालात करतो, जो तुम्ही PDF किंवा दस्तऐवज म्हणून एक्सपोर्ट करू शकता.
वारंवार विचारले जाणारे प्रश्न
सर्वाधिक वापरली जाणारी शोध इंजिने कोणती आहेत?
StatCounter नुसार, ऑक्टोबर 2026 मधील शोध रेफरलच्या वाट्यानुसार Google 91.05% सह आघाडीवर आहे, त्यानंतर Bing (4.8%), Yahoo (1.18%), Yandex (1.14%) आणि DuckDuckGo (0.64%) यांचा क्रमांक लागतो.
Google व्यतिरिक्त काही लोकप्रिय शोध इंजिने कोणती आहेत?
Google व्यतिरिक्त, Perplexity हे एक लोकप्रिय AI उत्तर इंजिन आहे, तर Bing, DuckDuckGo, Yandex, Baidu आणि Brave Search ही क्रमवारी लावलेल्या पृष्ठांच्या याद्या देणारी लोकप्रिय शोध इंजिने आहेत. त्यांपैकी काही AI ने लिहिलेली उत्तरेही जोडतात.
पहिली शोध इंजिने कोणती होती?
पहिले इंटरनेट शोध इंजिन Archie होते, जे Alan Emtage यांनी 1989 मध्ये तयार केले. त्यानंतर 1990 च्या दशकाच्या मध्यात WebCrawler सारखी क्रॉलर-आधारित वेब शोध इंजिने आली. पहिल्या मेटा शोध इंजिनांपैकी एक म्हणून Dogpile 1996 मध्ये लाँच झाले, आणि Google ची कंपनी म्हणून स्थापना 1998 मध्ये झाली.
शोध इंजिनांचे किती वेगवेगळे प्रकार आहेत?
परिणाम कुठून येतात आणि तुम्हाला काय मिळते यानुसार तीन मुख्य प्रकार आहेत: क्रॉलर-आधारित, मेटा शोध आणि AI उत्तर इंजिने. एखादे इंजिन एकापेक्षा अधिक श्रेणींमध्ये मोडू शकते, कारण अनेक क्रॉलर-आधारित इंजिने आता AI उत्तरेही देतात.
उद्देश, प्रेक्षकवर्ग किंवा व्यवसाय मॉडेलनुसार वर्गीकरण केल्यास आणखी प्रकार आहेत, ज्यात गोपनीयता-केंद्रित, सशुल्क, व्हर्टिकल, प्रादेशिक आणि एंटरप्राइझ इंजिने, तसेच वेब डिरेक्टरीज यांचा समावेश आहे.
व्हिज्युअल शोध आणि व्हॉइस शोध हे शोध इंजिनांचे प्रकार आहेत का?
व्हिज्युअल शोध आणि व्हॉइस शोध हे शोध इंजिनांचे प्रकार नसून शोध घेण्याच्या पद्धती आहेत. Google Lens सारखा व्हिज्युअल शोध शब्दांऐवजी प्रतिमेपासून सुरू होतो, आणि तुमच्या फोनवरील किंवा स्मार्ट होम डिव्हाइसेसवरील व्हॉइस शोध बोलण्यापासून सुरू होतो, परंतु ते बहुतेकदा टाइप केलेल्या शोधाप्रमाणेच त्याच इंडेक्समध्ये शोध घेतात.
शोध इंजिन आणि उत्तर इंजिन यांच्यात काय फरक आहे?
पारंपरिक शोध इंजिन तुमच्या क्वेरीशी जुळणाऱ्या पृष्ठांची क्रमवारी लावलेली यादी देते. उत्तर इंजिन पृष्ठे वाचते आणि त्याच्या स्रोतांशी लिंक केलेल्या संदर्भांसह एकच उत्तर लिहिते.
काही शोध इंजिने आता दोन्ही करतात. उदाहरणार्थ, Google कडे AI Mode आणि AI Overviews आहेत, आणि Bing कडेही आहेत.