
Degradacja kontekstu w agentach AI: dlaczego długie zadania tracą na dokładności i jak temu zapobiegać
Przewodnik o tym, co gromadzi się w kontekście agenta AI, dlaczego obniża to dokładność i jak konfigurować zadania, które pozostają niezawodne.
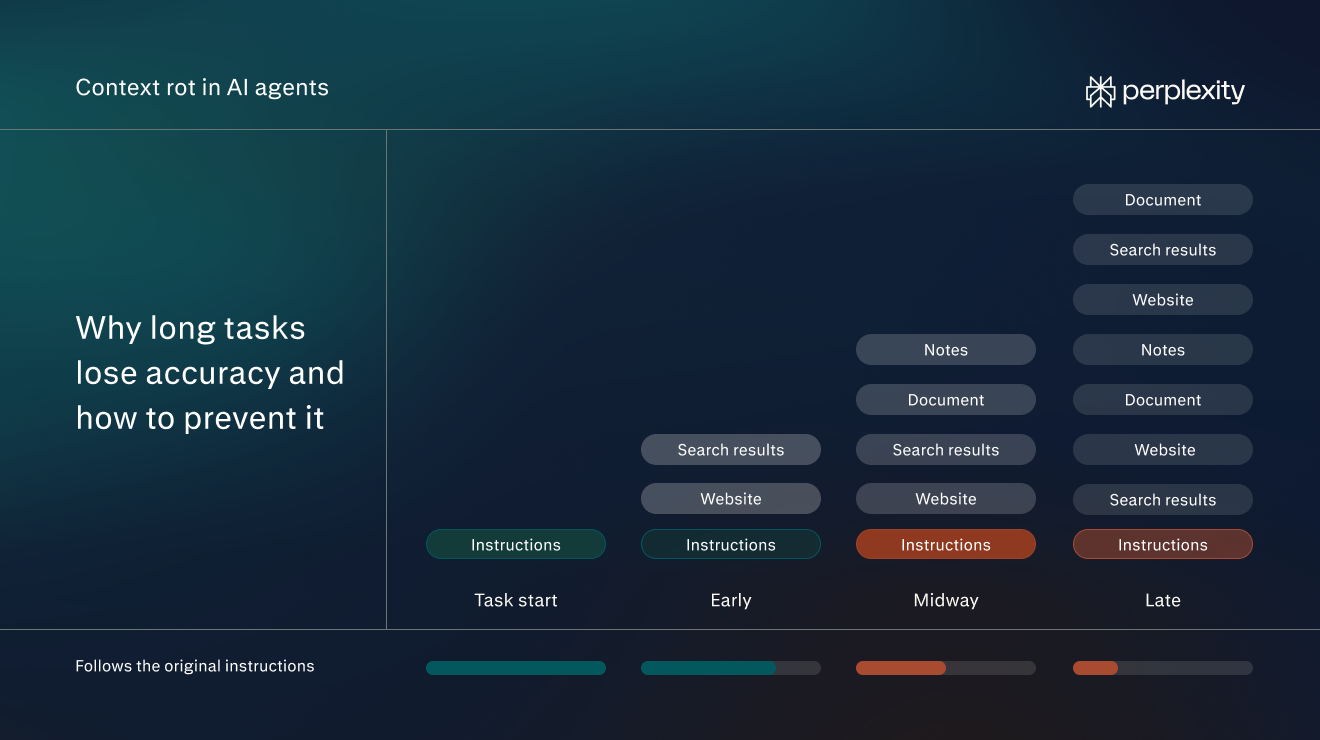
Co oznacza degradacja kontekstu dla agentów AI
Degradacja kontekstu (ang. context rot) w agentach AI to stopniowa utrata dokładności, która pojawia się w miarę zapełniania się kontekstu agenta podczas długiego zadania.
Kontekst agenta to informacje, którymi model dysponuje przy kolejnym kroku. Mogą to być instrukcje, wcześniejsze wiadomości, wyniki wyszukiwania oraz tekst ze stron internetowych lub plików. W trakcie pracy agent może dodawać do niego kolejne elementy.
Załóżmy na przykład, że zadaniem agenta jest znalezienie dostawców, którzy realizują dostawy w ciągu dwóch tygodni. Na początku jego kontekst zawiera tylko to polecenie. W połowie zadania kontekst będzie obejmował również tekst z dziesiątek stron internetowych dostawców, kilka stron wyników wyszukiwania oraz notatki o tym, których dostawców agent już sprawdził.
Istnieje limit tego, ile kontekstu może pomieścić model (tzw. okno kontekstowe). Okno mierzy się w tokenach, czyli niewielkich fragmentach tekstu – zwykle słowach lub ich częściach. Degradacja kontekstu nasila się wraz z jego wzrostem, dlatego najczęściej występuje w długich zadaniach składających się z wielu kroków.
Wraz z nasilaniem się degradacji kontekstu agent staje się mniej dokładny. Może mniej ściśle trzymać się pierwotnych instrukcji, przeoczać szczegóły lub mylić podobnie wyglądające informacje z tymi, których potrzebuje.
Agent może na przykład zacząć uwzględniać dostawców, którzy potrzebują sześciu tygodni, mimo że polecono mu szukać dostawy w ciągu dwóch tygodni. Instrukcja nadal znajduje się w jego kontekście, ale przestaje wpływać na decyzje agenta.
Degradacja kontekstu to nie to samo co zwykłe wyczerpanie miejsca w oknie kontekstowym. Gdy kontekst zadania przekroczy rozmiar okna, część materiału zostaje obcięta albo zadanie kończy się niepowodzeniem. Degradacja kontekstu zaczyna się na długo przed tym momentem, gdy wszystko wciąż się mieści.
Nie jest to też to samo co zatruwanie kontekstu (gdy do kontekstu agenta trafiają mylące lub szkodliwe informacje). Agent dysponujący dokładnymi i kompletnymi informacjami nadal może doświadczać degradacji kontekstu.
Dlaczego dochodzi do degradacji kontekstu
Do degradacji kontekstu dochodzi, ponieważ uwaga modelu jest ograniczona, nawet gdy w jego oknie kontekstowym wciąż jest wolne miejsce. W modelach AI uwaga (ang. attention) to termin techniczny określający sposób, w jaki model decyduje, z których części danych wejściowych korzystać, pisząc każde słowo odpowiedzi. Wszystkie części kontekstu konkurują o tę uwagę. Im więcej tekstu, tym mniej uwagi przypada na każdą jego część.
Firma Chroma opublikowała na przykład badanie dotyczące tego, jak długość danych wejściowych wpływa na modele AI. Przetestowano w nim 18 modeli firm Anthropic, OpenAI, Google i Alibaba. W jednym z testów badacze ukryli zdanie zawierające radę dotyczącą pisania w długim zbiorze esejów. Następnie zapytali model, na czym polegała ta rada.
Test powtarzano wielokrotnie, za każdym razem dodając więcej tekstu esejów. Zdanie i pytanie nigdy się nie zmieniały. Zmieniała się tylko ilość otaczającego je tekstu.
Im więcej tekstu modele musiały przeczytać, tym gorzej sobie radziły. Ta prawidłowość potwierdziła się we wszystkich testach opisanych w raporcie. Badacze przewidują, że spadek dokładności byłby jeszcze większy w rzeczywistej pracy wymagającej wielu kroków, takiej jak większość zadań agentów.
Jak degradacja kontekstu może wpływać na agentów AI
Degradacja kontekstu zwykle objawia się na jeden z czterech sposobów:
Gubienie pierwotnych instrukcji
W najprostszym teście Chroma modele miały dokładnie skopiować długi ciąg powtarzających się słów, w którym w pewnym miejscu wstawiono jedno inne słowo. Było to banalne zadanie z jednoznaczną instrukcją. Mimo to skuteczność wszystkich modeli spadała wraz z wydłużaniem się tekstu. Niektóre modele zaczęły generować słowa, których w ogóle nie było w danych wejściowych.
W zadaniu agenta użytkownik zwykle określa na początku konkretne ograniczenia, takie jak budżet czy wymagany format. W miarę wzrostu kontekstu agent może stosować je coraz mniej konsekwentnie. Przyczyną jest ogólna długość kontekstu, a nie miejsce, w którym znajduje się instrukcja.
Pominięte szczegóły ze środkowej części zadania
Według badania Uniwersytetu Stanforda z 2023 roku modele AI najrzetelniej korzystają z informacji, które znajdują się na samym początku lub na samym końcu danych wejściowych. W jednym z testów badacze przekazali modelom zestaw 20 dokumentów i zadali pytanie, na które odpowiadał tylko jeden z nich. Gdy ten dokument był pierwszy lub ostatni, modele zwykle znajdowały odpowiedź. Gdy znajdował się w środku zestawu, pomijały ją znacznie częściej. Badacze nazywają to efektem pozycji.
Ten sam wzorzec dotyczy agentów. Informacje znalezione na wcześniejszym etapie zadania mogą trafić do środka długiej rozmowy, gdzie niektórym modelom trudniej z nich korzystać. W przykładzie z dostawcami na ostatecznej liście mogłoby zabraknąć dobrego dostawcy, którego agent sprawdził w połowie zadania.
Mylenie podobnych informacji
Wraz ze wzrostem kontekstu agenci mogą coraz gorzej rozpoznawać, które informacje pasują do ich instrukcji. Załóżmy na przykład, że użytkownik polecił agentowi znaleźć dostawców, którzy wysyłają towar „w ciągu dwóch tygodni”. Na stronie internetowej dostawcy widnieje informacja: „dostawa w ciągu 14 dni kalendarzowych od złożenia zamówienia”. W krótkim zadaniu agent prawdopodobnie zauważyłby, że oznacza to to samo. Gdy ta informacja jest ukryta wśród dziesiątek innych stron dostawców, agent łatwiej przeoczy to dopasowanie.
Agent może też zacząć uwzględniać wyniki, które nie są istotne. Załóżmy, że agent szuka dostawców krzeseł biurowych. Strona internetowa jednego z dostawców obiecuje dostawę w ciągu dwóch tygodni, ale tylko w przypadku biurek. Na krzesła trzeba czekać sześć tygodni. Strona używa tych samych słów co instrukcja, więc agent i tak może dodać tego dostawcę do listy. Badacze nazywają takie informacje dystraktorami. Wyglądają na istotne, ale takie nie są, więc konkurują z informacjami, które mają znaczenie.
Badanie Chroma wykazało, że oba problemy nasilały się wraz ze wzrostem ilości otaczającego tekstu.
Błędy, które trudno zauważyć
Degradacja kontekstu nie powoduje wyświetlenia komunikatu o błędzie. Agent pracuje dalej i zwraca wynik, który wygląda na gotowy. Dlatego jego błędy łatwo przeoczyć.
W testach Chroma błędy te przybierały dwie formy. Czasami model udzielał pewnej siebie, ale błędnej odpowiedzi. W przykładzie z wyszukiwaniem dostawców agent mógłby dostarczyć schludną, dobrze sformatowaną listę, na której znalazłby się dostawca, którego warunki dostawy agent źle odczytał.
Innym razem model twierdził, że nie może znaleźć informacji, które w rzeczywistości były dostępne. Agent mógłby na przykład dostarczyć raport stwierdzający, że żaden dostawca nie mieści się w dwutygodniowym terminie, podczas gdy kilku go spełnia.
Jak konfigurować zadania agentów, aby ograniczyć degradację kontekstu
Prawidłowe skonfigurowanie zadań zminimalizuje wpływ degradacji kontekstu i pozwoli agentowi zachować jak największą dokładność przez cały czas trwania zadania. Pomocne mogą być poniższe sprawdzone praktyki.
Sformułuj zadanie jak zlecenie
Jasne zlecenie pozwala utrzymać mniejszy kontekst. Agent wie, kiedy skończył, więc przestaje zbierać materiały, gdy ma ich wystarczająco dużo. Konkretne wymagania dają mu też konkretny punkt odniesienia, z którym może porównać każdą stronę. Dzięki temu łatwiej mu wychwycić właściwe informacje.
Przed wysłaniem zadania sprawdź, czy obejmuje ono trzy elementy:
- Zadanie: co agent ma zrobić i dostarczyć, na przykład „znajdź dostawców i przygotuj krótką listę”.
- Wymagania: fakty, których agent nie może odgadnąć, takie jak budżet, termin, adres dostawy i odbiorca wyniku.
- Wynik: format, długość i struktura, na przykład „tabela z nazwą, ceną za krzesło i czasem dostawy”.
Po połączeniu tych elementów zapytanie w zadaniu wyszukania dostawców może wyglądać tak:
„Znajdź 10 dostawców, którzy w ciągu dwóch tygodni mogą dostarczyć 40 krzeseł biurowych do naszego biura w Chicago w cenie poniżej 250 USD za krzesło. Przygotuj tabelę z nazwą dostawcy, ceną za krzesło, czasem dostawy i linkiem do strony produktu. Lista jest przeznaczona dla naszego kierownika biura, który złoży zamówienie.”
Skup każde zadanie na jednym celu
Jedno zadanie z jednym jasnym celem pozwala utrzymać mały kontekst. Długie zadania są też droższe. Na każdym kroku przetwarzane jest wszystko, co dotąd zebrano, więc rozdęty kontekst zużywa więcej kredytów na każdym kroku.
Jeśli projekt składa się z kilku części, podziel go:
- Wypisz poszczególne rezultaty, na przykład wyszukanie dostawców, porównanie cen i e-mail do wybranego dostawcy.
- Realizuj każdy rezultat jako osobne zadanie.
- Przekazuj z jednego zadania do następnego tylko gotowy wynik. Na przykład prześlij tabelę dostawców jako plik, aby rozpocząć zadanie porównania, zamiast kontynuować w wątku, w którym ją utworzono.
Zadanie porównania zaczyna się wtedy od jednej tabeli, a nie od wszystkich stron.
Wskaż agentowi właściwe źródła
Każda strona, którą czyta agent, powiększa jego kontekst – łącznie z menu, reklamami i szablonowymi treściami otaczającymi przydatną część. Bezpośrednie wskazanie agentowi źródeł ogranicza ten szum.
Prześlij pliki, od których zależy zadanie, na przykład listę zatwierdzonych dostawców, dołączając je do zapytania. Jeśli agent musi przeszukać internet, podaj strony warte przeszukania, na przykład dwa zaufane katalogi dostawców.
Połącz narzędzia, w których znajdują się potrzebne informacje. Na przykład w Perplexity Computer otwórz Łączniki na pasku bocznym i włącz aplikacje potrzebne do zadania, takie jak Google Drive lub Slack. Następnie wspomnij o nich w zapytaniu: „Użyj specyfikacji krzeseł z naszego Google Drive”. Łącz tylko istotne aplikacje, ponieważ każdy łącznik zajmuje część kontekstu agenta.
Jeśli informacje znajdują się w aplikacji, której nie ma na liście Łączniki, nadal może być możliwe jej połączenie. Wiele aplikacji oferuje łącznik MCP (Model Context Protocol) – standardowy sposób podłączania narzędzi AI do innego oprogramowania. Computer może korzystać z takich łączników równolegle z wbudowanymi łącznikami. W przypadku konta firmowego może być konieczne, aby administrator najpierw je włączył.
Poproś o końcowe sprawdzenie zgodności z instrukcjami
Zakończ zapytanie krokiem weryfikacji, w którym wymienisz najważniejsze ograniczenia:
„Przed zakończeniem sprawdź każdego dostawcę pod kątem tych wymagań: dostawa w ciągu dwóch tygodni, cena poniżej 250 USD za krzesło. Oznacz tych, którzy nie spełniają tych wymagań, zamiast ich pomijać.”
Ograniczenia nadal znajdują się na początku kontekstu. Krok weryfikacji daje agentowi powód, by porównać ostateczny wynik z ograniczeniami, zamiast polegać na tym, że instrukcje zachowają swój wpływ na każdym kroku.
Z kolei prośba o oznaczanie problemów zamiast zwykłego odrzucania takich wyników ułatwia wychwycenie błędów (takich jak odrzucenie dostawcy, który obiecuje dostawę w ciągu 14 dni kalendarzowych, tylko dlatego, że nie używa słów „dwa tygodnie”).
Sprawdzaj pracę w punktach kontrolnych
W przypadku dłuższych zadań uwzględnij w zapytaniu punkt kontrolny:
„Zacznij od znalezienia 20 potencjalnych dostawców, a potem się zatrzymaj. Zatwierdzę listę, zanim zaczniesz zbierać ceny.”
Porównaj krótką listę z pierwotnymi instrukcjami. W kolejnej wiadomości popraw wszystko, co się nie zgadza, a następnie pozwól agentowi kontynuować. Błędy wychwycone na tym etapie nie przeniosą się na wszystkie kolejne kroki.
Rozpocznij nowe zadanie, gdy obecne zbacza z kursu
Jeśli agent powtarza ten sam błąd mimo poprawek, rozpocznij nowe zadanie. Każda poprawka dodaje kolejny tekst do i tak już długiego kontekstu. Zamiast tego utwórz nowe zadanie. Ponownie przedstaw instrukcje, prześlij wartościowe wyniki z pierwszej próby i zacznij od nowa.
Niektórzy agenci robią coś podobnego automatycznie – ten proces nazywa się kompaktowaniem (ang. compaction). Gdy zadanie się wydłuża, agent zastępuje starsze materiały, takie jak pełny tekst stron przeczytanych na początku, krótkim podsumowaniem tego, co znalazł. Portable Computer od Perplexity kompaktuje swój kontekst w ten sposób, dzięki czemu model nie przekracza ilości danych, z którą dobrze sobie radzi.
Ważne jest też rozpoczęcie nowego zadania, gdy zmienia się cel. Wątek, który zaczął się jako wyszukiwanie dostawców, nie powinien przekształcić się dodatkowo w przegląd umowy.
Zamień powtarzające się instrukcje w Skill
Niektóre instrukcje pojawiają się w każdym zadaniu określonego rodzaju, na przykład preferowany format tabeli, lista dostawców, których należy unikać, czy standardowy krok weryfikacji. W Computer można je zapisać jako Skill, czyli zestaw instrukcji wielokrotnego użytku, którymi agent kieruje się za każdym razem. Skill wbudowuje pozostałe sprawdzone praktyki w każde zadanie, w którym jest używany.
Aby go skonfigurować:
- Wybierz zadanie, które często się powtarza, na przykład wyszukiwanie dostawców.
- Zapisz instrukcje, które podajesz za każdym razem: format, sprawdzenia oraz źródła, z których należy korzystać lub których należy unikać.
- Zapisz je jako Skill. Instrukcje napisane już w formacie Markdown można zaimportować bezpośrednio.
- W kolejnych zapytaniach odwołuj się do Skill po nazwie: „Użyj Skill do wyszukiwania dostawców, aby znaleźć dostawców krzeseł do biura w Denver”.
Jak Perplexity podchodzi do kontekstu w pracy agentów
Perplexity Computer obsługuje długie zadania w taki sposób, aby kontekst każdego modelu był mały i istotny. Trzy elementy jego konstrukcji ograniczają ilość tekstu, którą model musi przeczytać naraz.
Podział pracy między subagentów
Computer dzieli polecenie na zadania i podzadania, a następnie tworzy subagentów, którzy je realizują. Każdy subagent pracuje nad jedną częścią zadania we własnym kontekście. W zadaniu dotyczącym dostawców jeden subagent może badać ceny, a inny sprawdzać warunki dostawy. Żaden z nich nie musi czytać wszystkiego, co przeczytał drugi.
Przechowywanie pracy w plikach
Każde zadanie Computer otrzymuje własny obszar roboczy z własnymi plikami, przeglądarką internetową i narzędziami. Agent może zapisywać swoją pracę w pliku, na przykład w bieżąco aktualizowanej tabeli sprawdzonych dostawców. Później otwiera ten plik ponownie tylko wtedy, gdy go potrzebuje.
Wybieranie istotnych fragmentów z wyników wyszukiwania
Strony internetowe są pełne materiałów, których model nie potrzebuje, takich jak menu, reklamy, metadane i teksty na inne tematy. Kompresja kontekstu uwzględniająca zapytanie usuwa te elementy. Zanim strona trafi do modelu, Perplexity zachowuje tylko zdania związane z zapytaniem.
Zapoznaj się z poradami, przewodnikami i przykładowymi zadaniami dla Perplexity Computer, aby wprowadzić te kroki w życie.
Często zadawane pytania
Czy degradacja kontekstu to to samo co halucynacja?
Nie, ale te zjawiska są ze sobą powiązane. Halucynacja to każda odpowiedź, która zawiera fałszywe lub niepoparte niczym twierdzenie. Degradacja kontekstu jest jednym z czynników, które zwiększają prawdopodobieństwo halucynacji, a także innych błędów, takich jak ignorowanie instrukcji czy pomijanie szczegółów.
Czy lepsze zapytanie może wyeliminować degradację kontekstu?
Jasne zapytanie ogranicza degradację kontekstu, ponieważ pozwala skupić zadanie na celu. Nie może jednak powstrzymać wzrostu kontekstu. W wystarczająco długim zadaniu agent i tak zbiera więcej informacji, niż jest w stanie dobrze wykorzystać. Dlatego podział pracy i sprawdzanie jej na bieżąco są równie ważne jak samo zapytanie.
Czy degradacja kontekstu dotyczy również zwykłych czatów z AI, a nie tylko agentów?
Tak. W czacie kontekstem jest cała dotychczasowa rozmowa, w tym każda wiadomość i wszelkie dokumenty wklejone lub przesłane do niej. Wątek, który trwa od wielu godzin i dotyczy kilku tematów, może prowadzić do tych samych błędów co długie zadanie agenta. Rozpoczynanie nowego wątku dla nowego tematu pozwala skupić każdą rozmowę na jednym temacie.
Jak długie może być zadanie, zanim pojawi się degradacja kontekstu?
Nie ma stałej granicy. Zależy to od modelu i zadania. Na przykład modele działające na urządzeniu z oknami kontekstowymi o rozmiarze 260 000 tokenów zaczynają mieć trudności powyżej około 100 000 tokenów, czyli na długo przed osiągnięciem swojego limitu. Spadek jest też stopniowy, a nie nagły.