
Inżynieria harnessu: czym jest i jak działa
Przystępny przewodnik po tym, czym są harnessy AI i jak inżynieria harnessu kształtuje możliwości agentów AI.
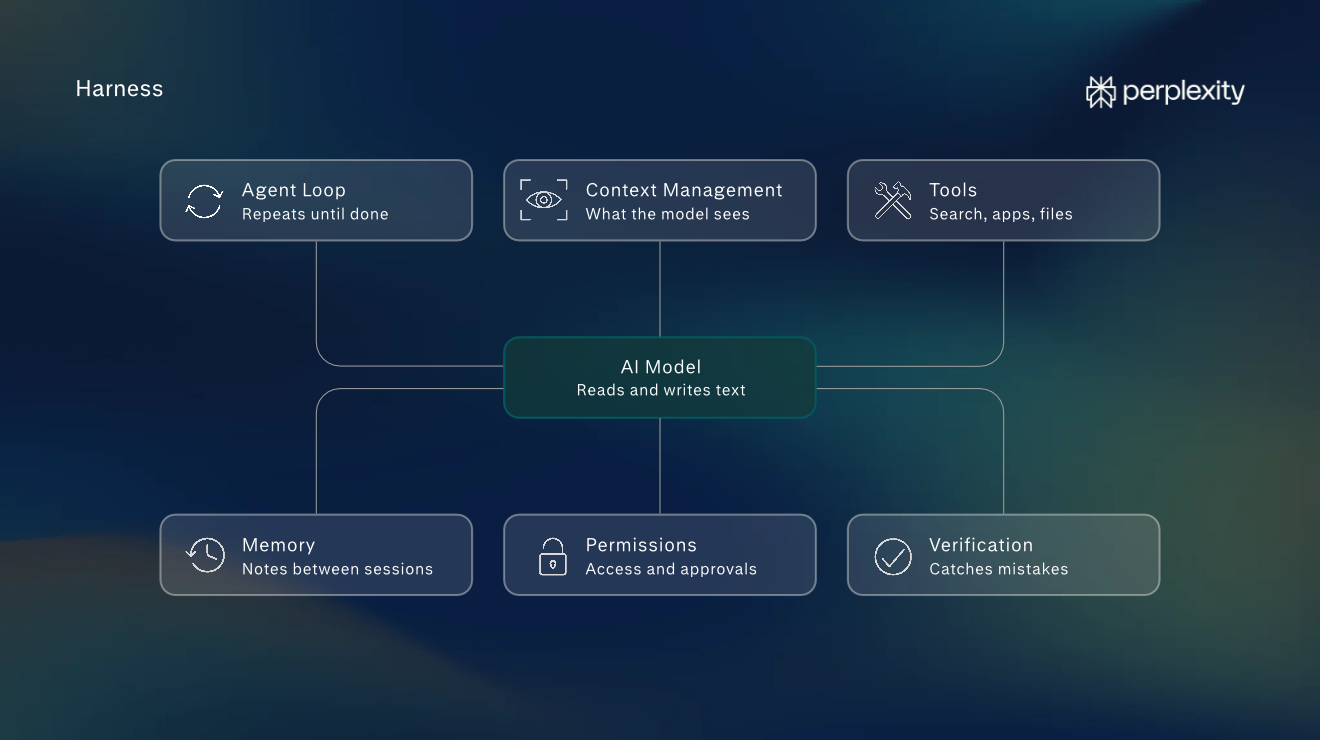
Na czym polega inżynieria harnessu
Inżynieria harnessu (ang. harness engineering) to budowanie harnessu narzędzia AI, czyli wszystkich elementów narzędzia poza samym modelem AI.
Model to system AI wytrenowany na dużych ilościach tekstu, dzięki czemu potrafi czytać i pisać w języku naturalnym. Przykładami modeli AI są GPT firmy OpenAI, Claude firmy Anthropic i Gemini firmy Google.
Sam model może jedynie przyjmować tekst (a czasem obrazy lub dźwięk) i odpowiadać tekstem. Nie pamięta wcześniejszych rozmów, nie może wyszukiwać aktualnych informacji ani uruchamiać kodu. Dlatego potrzebuje harnessu, który decyduje, jakie informacje trafiają do modelu, z jakich aplikacji może on korzystać, co wolno mu robić i jak sprawdzana jest jego praca.
Harnessu potrzebuje nawet prosty asystent czatu. Model zapomina każdą wymianę zdań, gdy tylko udzieli odpowiedzi, więc to harness przechowuje zapis rozmowy. Jeśli ktoś zapyta o Paryż, a potem dopyta: „ile wynosi jego populacja?”, harness wyśle modelowi oba pytania razem. Dzięki temu model wie, że „jego” odnosi się do Paryża.
Inżynieria harnessu to jeden z powodów, dla których dwa narzędzia zbudowane na tym samym modelu mogą działać tak różnie. Na przykład w jednym niezależnym teście badacze pozostawili ten sam model (GPT5) i zmienili wyłącznie harness, a wynik modelu w teście programistycznym zmienił się nawet o 11%.
Twórcy modeli AI, tacy jak Anthropic i OpenAI, budują harnessy dla własnych produktów AI, takich jak Claude Code i Codex. Z kolei firmy tworzące produkty AI projektują harnessy dla wybranych przez siebie modeli bazowych. Część harnessu kształtują też sami użytkownicy narzędzi AI. Wiele narzędzi pozwala im dodawać stałe instrukcje, łączyć aplikacje i wybierać, które działania wymagają ich zatwierdzenia, zanim narzędzie je wykona.
Inżynieria harnessu dla agentów AI
Każde narzędzie AI ma harness, ale inżynieria harnessu nabiera szczególnego znaczenia w pracy z agentami AI. Agenci samodzielnie wykonują wieloetapowe zadania, takie jak analiza konkurencji i zebranie wyników w arkuszu kalkulacyjnym, a harness obsługuje każdy z tych etapów. Jeśli więc harness popełni błąd, na przykład pobierze ceny z zeszłego roku, wpłynie to również na wszystkie kolejne etapy.
Większość harnessów agentów składa się z sześciu głównych elementów:
1. Pętla agenta
Pętla agenta to kod w harnessie, który krok po kroku popycha zadanie naprzód.
Model AI decyduje, jaki kolejny krok jest potrzebny do wykonania zadania, i tworzy wywołanie narzędzia: krótkie żądanie, które wskazuje narzędzie w harnessie, na przykład wyszukiwanie w internecie, oraz to, co to narzędzie ma zrobić.
Harness wychwytuje to żądanie, uruchamia wyszukiwanie i dodaje wyniki do tego, co widzi model. Model je czyta i decyduje, co zrobić dalej.
2. Zarządzanie kontekstem
Model zdobywa wiedzę ogólną podczas treningu, ale wiedza ta sięga tylko do momentu zakończenia treningu. Nie obejmuje niczego, co dotyczy konkretnego zadania, na przykład plików firmy, dzisiejszych wiadomości czy tego, co powiedziano wcześniej w rozmowie.
Wszystkie te informacje model czerpie ze swojego okna kontekstowego, czyli tekstu, który harness przekazuje mu przed każdą odpowiedzią, obejmującego m.in. instrukcje, zapytanie, dotychczasową rozmowę i wyniki wyszukiwania.
Okno mieści tylko określoną ilość tekstu. A nawet zanim się zapełni, modele czasem pomijają informacje ukryte w środkowej części długich danych wejściowych.
Dlatego to harness zajmuje się zarządzaniem kontekstem i wybiera tylko te informacje, których potrzebuje dany krok. Jeśli na przykład zadanie polega na porównaniu cenników pięciu konkurentów, harness może dołączyć stronę z cennikiem każdej firmy zamiast całej jej witryny. Przy długich zadaniach harness może też zastąpić szczegółowy zapis wcześniejszych kroków krótkim podsumowaniem, dzięki czemu model wie, co już zrobił, a historia nie zapełnia okna.
3. Narzędzia
Narzędzia to kod, który wykonuje działania, o które prosi model. Każde narzędzie obsługuje jeden rodzaj działania, na przykład wyszukiwanie w internecie, otwieranie i czytanie strony internetowej, uruchamianie kodu lub edycję pliku. Gdy model utworzy wywołanie narzędzia, harness przekazuje je do właściwego narzędzia i zwraca wynik.
Wiele harnessów zawiera też łączniki, czyli narzędzia, które łączą agenta z konkretną aplikacją, taką jak poczta e-mail, kalendarz czy dysk współdzielony, na podstawie dostępu przyznanego przez użytkownika. Dzięki łącznikowi kalendarza agent może na przykład sprawdzić czyjąś dostępność, zanim zaproponuje termin spotkania.
4. Pamięć
Pamięć to zapisane informacje przenoszone z jednej sesji do następnej. Podczas sesji harness zapisuje krótkie notatki, na przykład o preferencjach danej osoby lub o stanie projektu. Na początku kolejnej sesji harness dodaje te notatki do okna kontekstowego, więc model czyta je, zanim przeczyta nowe zapytanie. Dzięki temu agent może na przykład kontynuować cotygodniowy raport w miejscu, w którym skończył, zamiast zaczynać od nowa.
5. Uprawnienia
Uprawnienia to reguły określające, do czego agent ma dostęp i co może robić. Reguły dostępu określają, które pliki, aplikacje lub strony internetowe może otwierać. Reguły zatwierdzania określają, które działania muszą poczekać na zgodę człowieka, na przykład wysłanie wiadomości lub dokonanie zakupu.
Część tych reguł firma tworząca agenta ustala w kodzie harnessu. Administratorzy organizacji mogą następnie dodać własne, a poszczególni użytkownicy mogą decydować na przykład o tym, które konta połączyć.
6. Weryfikacja
Weryfikacja to kod, który sprawdza pracę agenta, zanim trafi ona do człowieka. Wykorzystuje dwa rodzaje kontroli:
- Stałe reguły, czyli konkretne testy, które za każdym razem dają ten sam wynik – pozytywny lub negatywny – na przykład potwierdzenie, że każda liczba w raporcie występuje w dokumencie, który agent faktycznie przeczytał.
- Przegląd wykonany przez inny model AI, który czyta wynik pracy i go ocenia. Może wychwycić problemy, które trudno ująć w regułę, na przykład podsumowanie pomijające ważną kwestię.
Żadna pojedyncza kontrola nie wychwyci wszystkiego, dlatego harnessy zwykle łączą oba rodzaje. Gdy kontrola wykryje problem, harness dodaje jego opis do okna kontekstowego modelu i ponownie przepuszcza zadanie przez pętlę agenta. Model usuwa problem i próbuje jeszcze raz, dzięki czemu wiele błędów zostaje naprawionych, zanim użytkownik zobaczy wynik.
Przykłady inżynierii harnessu
Przygotowanie do spotkania z klientem
Zadanie: Opiekun klienta prosi agenta o przygotowanie briefingu na jutrzejsze spotkanie z klientem, obejmującego otwarte kwestie i wstępną agendę.
Co robi harness:
- Za pomocą łącznika poczty e-mail agent wyszukuje w skrzynce odbiorczej opiekuna korespondencję z klientem.
- Uprawnienia pozwalają mu czytać wiadomości e-mail, ale nie wysyłać żadnych.
- Zarządzanie kontekstem przekazuje modelowi tylko wiadomości z tym klientem z ostatnich trzech miesięcy, a nie całą skrzynkę odbiorczą.
- Pętla agenta wykonuje kilka rund wyszukiwania i czytania, a model porządkuje znalezione informacje w listę otwartych kwestii.
- Następnie weryfikacja sprawdza, czy każda kwestia w briefingu odsyła do rzeczywistej wiadomości e-mail.
Możliwy wynik: Opiekun otrzymuje jednostronicowy briefing, w którym każdy punkt można powiązać z wiadomością e-mail, z której pochodzi.
Aktualizacja miesięcznego raportu sprzedaży
Zadanie: Kierownik ds. operacyjnych prosi agenta o zaktualizowanie miesięcznego raportu sprzedaży o dane z bieżącego miesiąca.
Co robi harness:
- Pamięć wczytuje notatki z sesji z zeszłego miesiąca, w tym format raportu i prośbę kierownika o zaokrąglanie liczb do pełnych tysięcy.
- Narzędzie do obsługi plików otwiera arkusz sprzedaży na dysku współdzielonym zespołu.
- Uprawnienia pozwalają agentowi edytować wersję roboczą raportu, ale nie arkusz źródłowy, więc pierwotnych danych nie da się przypadkiem zmienić.
- Weryfikacja sprawdza, czy sumy w raporcie zgadzają się z arkuszem.
Możliwy wynik: Raport ma ten sam format co w zeszłym miesiącu, a użytkownik nie musi go ponownie objaśniać.
Porządkowanie wspólnej skrzynki odbiorczej
Zadanie: Zespół wsparcia prosi agenta o posortowanie porannych zgłoszeń według tematu i przygotowanie wersji roboczych odpowiedzi na te najczęstsze.
Co robi harness:
- Pętla agenta przetwarza skrzynkę odbiorczą wiadomość po wiadomości.
- Dla każdej z nich model wybiera etykietę tematu, a harness nadaje ją za pomocą łącznika poczty e-mail.
- Na początku zadania harness dodaje do okna kontekstowego zatwierdzone przez zespół szablony odpowiedzi jako wzorce, więc model opiera każdą wersję roboczą na szablonie.
- Reguła zatwierdzania zatrzymuje każdą odpowiedź jako wersję roboczą, dopóki ktoś z zespołu jej nie sprawdzi i nie wyśle.
Możliwy wynik: Zespół zaczyna dzień z posortowanymi zgłoszeniami i odpowiedziami czekającymi na sprawdzenie.
Naprawa błędu w witrynie internetowej
Zadanie: Programista prosi agenta programistycznego o naprawienie błędu, przez który nie działa przycisk finalizacji zakupu.
Co robi harness:
- Agent pracuje w piaskownicy, czyli odizolowanej kopii kodu, w której jego zmiany nie mogą wpłynąć na działającą witrynę.
- Narzędzie do obsługi kodu pozwala modelowi czytać i edytować pliki.
- Po każdej zmianie weryfikacja uruchamia automatyczne testy projektu.
- Wszelkie nieudane testy trafiają z powrotem do modelu jako nowe informacje.
Możliwy wynik: Agent dopracowuje poprawkę, dopóki testy nie zakończą się powodzeniem. Następnie programista sprawdza zmianę, zanim zostanie ona wdrożona.
Inżynieria harnessu a inżynieria promptów i inżynieria kontekstu
Inżynieria promptów to tworzenie i optymalizowanie pojedynczego zapytania. Inżynieria kontekstu to zarządzanie wszystkim, co widzi model. Inżynieria harnessu to projektowanie i ulepszanie całego systemu, w którym model działa.
Termin | Kto zwykle się tym zajmuje | Przykład z zadania analizy konkurencji |
Inżynieria promptów | Każdy, kto pisze zapytanie | Prośba o „jeden wiersz na konkurenta, jedna kolumna na plan cenowy” |
Inżynieria kontekstu | Osoby budujące harness oraz użytkownicy, którzy dołączają pliki lub szablony | Przekazanie modelowi strony z cennikiem każdego konkurenta oraz szablonu arkusza zespołu |
Inżynieria harnessu | Firmy tworzące produkty AI oraz zespoły i użytkownicy, którzy wybierają ustawienia i preferencje oraz przesyłają informacje | Decydowanie, z jakich narzędzi może korzystać agent, które działania wymagają zatwierdzenia i jak sprawdzana jest jego praca |
Jak użytkownicy mogą wpływać na harness AI
Większość harnessu agenta pochodzi od firmy, która tworzy agenta, ale wiele produktów AI pozwala użytkownikom dostosować jego część za pomocą ustawień, takich jak niestandardowe instrukcje, połączone aplikacje i zatwierdzenia.
Użytkownicy mogą kształtować harness agenta i poprawiać wyniki jego pracy na cztery sposoby:
1. Stałe instrukcje
Stałe instrukcje to notatki, które użytkownik pisze raz, aby harness mógł dodawać je do okna kontekstowego na początku każdego zadania. Warto je skonfigurować dla wszystkiego, co w przeciwnym razie trzeba by powtarzać w kolejnych zapytaniach: kim jest dana osoba i czym się zajmuje, jakiego stylu pisania oczekuje albo jakie zasady obowiązują w cyklicznym zadaniu, takim jak miesięczny raport dla klienta.
Wiele produktów AI oferuje stałe instrukcje na dwóch poziomach. Instrukcje dla całego konta sprawdzają się w przypadku zasad dotyczących każdej pracy, takich jak preferencje pisowni. Instrukcje projektu dotyczą jednego klienta lub przepływu pracy, dzięki czemu wskazówki dla jednego nie przenoszą się na inny.
Stałe instrukcje działają tak samo w asystentach czatu i w agentach, ale agenci są od nich bardziej zależni. W czacie można poprawić AI po każdej odpowiedzi. Agent może wykonać wiele kroków, zanim ktokolwiek zobaczy jego pracę, więc instrukcje podane z góry są jednym z niewielu sposobów, by kierować nim po drodze.
Jak pisać skuteczne stałe instrukcje
- Zacznij od krótkiej instrukcji, na przykład: „Jestem menedżerem ds. marketingu w firmie produkującej oprogramowanie. Pisz prostym językiem angielskim, ograniczaj podsumowania do 200 słów i stosuj amerykańską pisownię”.
- Uzupełniaj je, gdy AI popełni błąd. Jeśli AI wciąż zaokrągla liczby, a zespół potrzebuje dokładnych wartości, dodaj wiersz, który to określa.
- Formułuj instrukcje konkretnie: „Podawaj dokładne liczby, nigdy zaokrąglone” sprawdza się lepiej niż „Bądź dokładny”.
- Pilnuj, by lista była krótka, i usuwaj wiersze, gdy przestaną być przydatne, bo każdy wiersz zajmuje miejsce w oknie kontekstowym.
2. Połączone aplikacje
Połączone aplikacje łączą produkt AI z narzędziami, z których dana osoba już korzysta, takimi jak poczta e-mail, kalendarz czy dysk współdzielony. Po połączeniu aplikacji AI może pracować na własnych informacjach użytkownika, a nie tylko na tym, co wklejono do czatu.
Warto skonfigurować połączenia, gdy zadanie zależy od informacji przechowywanych w tych aplikacjach, na przykład przy przygotowywaniu briefingu przed spotkaniem na podstawie wątków e-mail lub podsumowywaniu dokumentów na dysku współdzielonym.
Jak bezpiecznie łączyć aplikacje
- Łącz tylko te aplikacje, których wymaga zadanie, ponieważ każde połączenie zwiększa ryzyko błędów.
- Wybieraj dostęp tylko do odczytu, jeśli produkt go oferuje. Na przykład agent przygotowujący briefingi przed spotkaniami musi czytać pocztę e-mail, ale nie musi jej wysyłać.
- Konfiguruj połączenia dla poszczególnych projektów, jeśli produkt na to pozwala. Na przykład w Perplexity można wybrać, z których łączników korzysta każdy projekt.
- Pamiętaj o odłączaniu aplikacji, których już nie używasz.
3. Ustawienia zatwierdzania
Ustawienia zatwierdzania określają, które działania muszą poczekać na zgodę człowieka, zanim AI je wykona. Niektóre zatwierdzenia są wbudowane w produkt, a w niektórych produktach można wybrać, które inne działania również wymagają zatwierdzenia.
Jak ustalić reguły zatwierdzania
- Wymagaj zatwierdzenia działań, których nie da się cofnąć, takich jak wysłanie wiadomości, dokonanie zakupu czy usunięcie pliku.
- Lista działań wymagających zatwierdzenia powinna być krótka. Jeśli agent prosi o akceptację każdego drobnego kroku, ludzie zaczynają zatwierdzać bez czytania.
4. Standardy i kontrole
Większość produktów AI ma wbudowane pewne standardy. Perplexity na przykład dołącza do odpowiedzi cytowania źródeł, dzięki czemu każde twierdzenie można zweryfikować. Standardy ustalane przez użytkownika uzupełniają to, czego produkt nie może wiedzieć sam z siebie, na przykład preferowany przez zespół format raportów.
Jak ustalić standardy pracy wykonywanej przez AI
- Przygotuj szablon do powtarzalnych zadań, aby AI miała stałą strukturę do wypełnienia.
- Udostępnij przykład wcześniejszej pracy, która spodobała się zespołowi, aby AI mogła dopasować do niej ton i poziom szczegółowości.
- Poproś o link do źródła przy każdej podanej liczbie.
- Uważnie sprawdzaj pierwsze wyniki, a powtarzające się braki zamieniaj w nowe stałe instrukcje.
Podejście Perplexity do harnessów agentów
Perplexity Computer działa w oparciu o harness niezależny od modelu, który łączy ponad 20 zaawansowanych modeli w jednym systemie. Dzieli każde zadanie na podzadania, przekazuje je subagentom (oddzielnym agentom, z których każdy zajmuje się jedną częścią) i kieruje każdy fragment pracy do modelu, który najlepiej się do niego nadaje.
Z przewodnika po projektach w Perplexity dowiesz się, jak skonfigurować instrukcje, pliki i łączniki.
Często zadawane pytania
Kim jest inżynier harnessu?
Inżynier harnessu projektuje i utrzymuje system, który pozwala modelowi AI niezawodnie wykonywać pracę. Może to oznaczać dodanie nowego narzędzia, z którego agent będzie korzystał, ustalenie, dlaczego agent wciąż popełnia ten sam błąd, albo zaostrzenie kontroli, które przeprowadza przed zakończeniem zadania. Nie jest to standardowa nazwa stanowiska, choć może się to zmienić. Tę pracę zwykle wykonują inżynierowie oprogramowania w firmach zajmujących się AI lub w zespołach budujących agentów. W przemyśle angielska nazwa „harness engineer” oznacza osobę projektującą wiązki przewodów, czyli połączone ze sobą kable w samochodach i maszynach.
Czym jest harness agenta?
Harness agenta to zwykle wszystko, co składa się na agenta AI poza samym modelem. Obejmuje to kod, który uruchamia pętlę agenta, zarządza kontekstem, wykonuje wywołania narzędzi, przechowuje pamięć, egzekwuje uprawnienia i sprawdza pracę agenta, zanim trafi ona do człowieka.
Czy każde narzędzie AI ma harness?
Tak. Nawet prosty asystent czatu korzysta z harnessu, aby śledzić przebieg rozmowy, ponieważ model sam z siebie nie pamięta wcześniejszych wiadomości.
Programiści mogą też korzystać z modelu, wysyłając do niego żądania z własnego oprogramowania przez API (połączenie, które pozwala jednemu programowi wysyłać żądania do innego). W takim przypadku zadanie harnessu wykonuje własny kod programisty.
Czy lepsze modele sprawią, że harnessy staną się zbędne?
Lepsze modele mogą potrzebować mniej wskazówek krok po kroku, więc część tego, co dziś robią harnessy, może się zmniejszyć. Jednak sam model jedynie przekształca tekst w tekst. Nie ma połączenia z internetem ani dostępu do innych aplikacji. Dostęp do plików, wykonywanie działań i egzekwowanie reguł zatwierdzania odbywają się w oprogramowaniu otaczającym model, więc ta praca najprawdopodobniej pozostanie po stronie harnessu bez względu na to, jak zaawansowane staną się modele.