
Jak śledzić i kontrolować wydatki zespołu na tokeny
Jak zespoły mogą sprawdzać zużycie tokenów w panelach i raportach, które rodzaje pracy z AI zużywają najwięcej tokenów oraz jak ograniczać to zużycie za pomocą mechanizmów kontroli.
Czym są wydatki na tokeny
Wydatki na tokeny to liczba tokenów, które zespół zużywa, korzystając z AI, oraz koszt tych tokenów. Token to jednostka tekstu, na przykład słowo, część słowa lub znak interpunkcyjny, którą model AI odczytuje lub zapisuje. W języku angielskim 1 token to mniej więcej 4 znaki. Tokeny nie są ujednolicone między modelami ani dostawcami, więc ten sam tekst może dawać różną liczbę tokenów w różnych narzędziach.
Raporty użycia zwykle dzielą tokeny na kilka typów:
- Tokeny wejściowe to wszystko, co model odczytuje w ramach żądania. Obejmuje to zapytanie, dołączony tekst oraz historię rozmowy z wcześniejszej części tego samego wątku, którą model ponownie wykorzystuje.
- Tokeny wyjściowe to odpowiedź, którą pisze model. Często kosztują więcej niż tokeny wejściowe. W cenniku API Perplexity niektóre modele naliczają za dane wyjściowe sześć razy więcej.
- Tokeny rozumowania to tekst, który model generuje wewnętrznie, aby przepracować problem przed udzieleniem odpowiedzi. Nie pojawiają się w odpowiedzi, więc dłuższa widoczna odpowiedź niekoniecznie oznacza, że model zużył łącznie więcej tokenów.
Zespoły korzystające z narzędzi AI w ramach subskrypcji rzadko widzą opłaty za pojedyncze tokeny. Tokeny nadal jednak wpływają na to, co otrzymują, ponieważ bardziej wymagające zadania szybciej zużywają kredyty lub prędzej wyczerpują limity użycia. Zespoły, które budują własne narzędzia na bazie modelu AI, zazwyczaj płacą natomiast za tokeny w ramach rozliczenia opartego na użyciu.
Jak śledzić wydatki na tokeny
Śledzenie wydatków na tokeny w planie subskrypcyjnym
Narzędzia subskrypcyjne zwykle nie pokazują liczby tokenów. Zamiast tego wiele planów korzysta z kredytów, czyli przedpłaconych jednostek, które plan zużywa w miarę wykonywania pracy. Kredyty to nie to samo co tokeny, ponieważ jeden kredyt może obejmować tekst, obrazy lub inną pracę. Zadania zużywające więcej tokenów zwykle zużywają jednak także więcej kredytów, dlatego kredyty są najlepszą wskazówką co do wydatków na tokeny w ramach subskrypcji. Użytkownicy mogą śledzić własne zużycie kredytów, a niektóre plany oferują też panel administratora, który pokazuje zużycie kredytów przez cały zespół.
Na przykład w Perplexity zwykłe wyszukiwania nie zużywają kredytów. Korzysta z nich tylko Perplexity Computer, asystent obsługujący zadania wieloetapowe. Osoby korzystające z Computer mogą sprawdzić, ile kredytów zużyły i na co. Każde zadanie Computer pokazuje też własną sumę kredytów w menu „Użycie” danej rozmowy.
W planach Enterprise administratorzy mogą sprawdzić w panelu Insights, ile osób korzysta z Perplexity i ile zapytań wykonują każdego tygodnia (funkcja dostępna dla organizacji z co najmniej 50 stanowiskami lub co najmniej jednym członkiem Enterprise Max).
Śledzenie wydatków na tokeny w raportach użycia API
Raporty użycia dostawcy API pokazują liczbę tokenów bezpośrednio, zwykle z podziałem na ich typy. Na przykład konsola Perplexity API Platform pozwala użytkownikom śledzić na stronie rozliczeń takie wskaźniki jak wydatki na tokeny wejściowe, wyjściowe i tokeny rozumowania.
Dlaczego wydatki na tokeny rosną
Agenci wykonują wiele kroków w ramach jednego zadania, a każdy krok to osobne żądanie do modelu. Jedno zadanie może łącznie zużyć setki tysięcy, a nawet miliony tokenów.
Coraz powszechniejsze stają się też modele rozumujące. Model rozumujący zapisuje swój tok myślenia, zanim udzieli odpowiedzi, a każde słowo tego procesu liczy się jako tokeny. Dlatego to samo żądanie zwykle zużywa więcej tokenów w modelu rozumującym niż w standardowym, mimo że odpowiedź na ekranie wydaje się równie długa.
Wreszcie, w miarę jak z AI korzysta coraz więcej osób i przepływów pracy, łączne zużycie tokenów rośnie. Część tego wzrostu wynika również z tokenmaxxingu, czyli zjawiska, w którym inżynierowie uruchamiają agentów głównie po to, by zwiększyć swoją osobistą liczbę tokenów i zająć wyższe miejsce w wewnętrznych rankingach zużycia tokenów.
Jak ograniczyć wydatki na tokeny
W większości przypadków wysokie wydatki na tokeny wynikają z kilku rodzajów pracy, które zużywają więcej tokenów, niż mogłoby się wydawać.
Długie rozmowy i zadania agentów
Za każdym razem, gdy model odpowiada, zwykle ponownie odczytuje całą dotychczasową rozmowę. Każde nowe żądanie obejmuje całą wcześniejszą historię rozmowy oraz bieżącą wiadomość użytkownika. Dlatego krótkie pytanie zadane pod koniec długiego wątku zużywa więcej tokenów niż to samo pytanie w nowym wątku. Zadania agentów działają tak samo, ponieważ każdy krok dodaje swoje wyniki do historii, którą ponownie odczytuje kolejny krok.
Co z tym zrobić
- Rozpoczynaj nową rozmowę, gdy zmienia się temat. Zacznij ją od dwu- lub trzywierszowego podsumowania wszystkiego ze starego wątku, czego model nadal potrzebuje.
- Dziel długie zadania agentów na mniejsze. Uruchamiaj każdą część jako osobne zadanie i przekazuj dalej tylko te wyniki, których potrzebuje kolejna część.
- Sprawdź, czy narzędzia agentowe używane przez zespół stosują kompaktowanie kontekstu. Kompaktowanie automatycznie podsumowuje starsze części zadania, dzięki czemu model musi ponownie odczytywać mniej tekstu. Jeśli narzędzie oferuje je jako ustawienie, włącz je.
Te same dokumenty przetwarzane wielokrotnie
Gdy ktoś dołącza ten sam długi plik, na przykład podręcznik zasad firmy lub katalog produktów, do wielu osobnych zapytań, model za każdym razem odczytuje cały plik. Każdy taki odczyt liczy się jako tokeny wejściowe.
Co z tym zrobić
- Naucz użytkowników, by zamiast dołączać cały plik, kopiowali do żądania odpowiedni fragment podręcznika lub katalogu.
- Przygotuj skrócone wersje dokumentów, z których zespół często korzysta. Jednostronicowe podsumowanie długiego regulaminu może zastąpić pełny dokument w rutynowych zapytaniach.
Ponowne próby i pętle
Gdy odpowiedź nie jest tym, czego ktoś potrzebował, i ta osoba uruchamia zadanie ponownie, każda próba zużywa tokeny. To samo dzieje się, gdy agent utknie, powtarzając w kółko ten sam krok.
Co z tym zrobić
- Już w pierwszym żądaniu jasno określ zadanie, oczekiwany wynik i źródła. Na przykład: „Podsumuj w pięciu punktach główne powody, dla których klienci zrezygnowali w III kwartale, korzystając wyłącznie z dołączonych wyników ankiety”.
- Sprawdzaj kilka pierwszych kroków zadania agenta. Jeśli agent powtarza ten sam krok lub to samo wyszukiwanie, zatrzymaj go i uruchom ponownie z węższym żądaniem.
Duże modele do prostych zadań
Bardziej zaawansowane modele zwykle kosztują więcej za token, więc rutynowa praca, taka jak podsumowania czy zmiana formatowania, może wyczerpywać budżet zespołu szybciej, niż to konieczne.
Co z tym zrobić
- Korzystaj z routingu modeli, który dopasowuje każde zadanie do modelu zdolnego je wykonać. Krótką przeróbkę tekstu lub podsumowanie można przekazać mniejszemu, tańszemu modelowi, a najbardziej zaawansowany model zachować do wieloetapowego rozumowania lub analiz. Takie podejście stosuje API Perplexity w swoich presetach, które przypisują mniejszy model do szybkiego wyszukania informacji, a większy do wyczerpującej analizy.
Skoki po wdrożeniu nowych przepływów pracy
Nowy zautomatyzowany przepływ pracy lub narzędzie wdrożone w całym zespole może z dnia na dzień zwiększyć użycie. Skok sam w sobie nie jest problemem, ale warto wiedzieć, jaka praca go spowodowała.
Co z tym zrobić
- Najpierw testuj nowe przepływy pracy na małej grupie. Obserwuj jej użycie przez tydzień lub dwa, zanim wdrożysz dany przepływ pracy w całym zespole.
- Ustal miesięczny budżet dla każdego zespołu. Oprzyj go na typowym miesięcznym użyciu, aby nagły wzrost był od razu widoczny.
- Wyłącz automatyczne doładowanie. Gdy jest wyłączone, praca zatrzymuje się po wyczerpaniu kredytów, a dodatkowe kredyty nie są kupowane automatycznie.
Jak optymalizować wydatki na tokeny w Perplexity
Do codziennego użytku
Computer zużywa kredyty, ale działa tylko wtedy, gdy go wybierzesz: klikając ikonę Computer, pracując w Projekcie, w którym Computer jest trybem domyślnym, lub korzystając z trybu Work w Comet.
Aby wrócić do zwykłego wyszukiwania, kliknij ikonę Perplexity i przełącz się z powrotem na tryb Ask. Zużycie kredytów użytkownicy mogą sprawdzić w liczniku dostępnym w interfejsie Perplexity.
Zespoły pracujące w Projektach, czyli współdzielonych przestrzeniach roboczych Perplexity, mogą ustawić domyślny tryb każdego Projektu na Search lub Computer. Projekt używany głównie do szybkiego wyszukiwania informacji może domyślnie korzystać z trybu Search, dzięki czemu nikt przypadkowo nie uruchomi zadania Computer.
Dla administratorów Enterprise
- Sprawdź, co obejmuje każde stanowisko. Użytkownicy Enterprise Pro otrzymują miesięczny przydział 500 kredytów, a użytkownicy Enterprise Max – 15 000 kredytów. Kredyty te wygasają na koniec każdego miesięcznego cyklu i nie przechodzą na kolejny.
- Najpierw ustaw domyślny limit użycia. Limit użycia określa, ile dodatkowych kredytów członek może pobrać ze wspólnej puli po wyczerpaniu własnego przydziału.
- Utwórz nazwane limity dla różnych rodzajów użytkowników. Administratorzy mogą skonfigurować limity takie jak „Standardowy”, „Zaawansowany użytkownik” czy „Współpracownik zewnętrzny”, a następnie przypisać je do grup użytkowników lub poszczególnych członków. Grupy mogą być tworzone w Perplexity lub synchronizowane z firmowym dostawcą tożsamości. Jeśli ktoś należy do więcej niż jednej grupy, obowiązuje najwyższy limit.
- W wyjątkowych przypadkach stosuj nadpisania indywidualne. Gdy jedna osoba potrzebuje innego limitu niż jej grupa, nadpisanie indywidualne ma pierwszeństwo przed każdym limitem grupowym lub wspólnym. Przydaje się to na przykład przy krótkim projekcie wymagającym intensywnych badań, bez podnoszenia limitu dla całego zespołu.
- Ustal górną granicę automatycznego doładowania. Automatyczne doładowanie samoczynnie uzupełnia wspólną pulę. Ma konfigurowalny miesięczny limit doładowań, dzięki czemu wydatki nie mogą rosnąć bez ustalonego maksimum.
- Zdecyduj, w jaki sposób członkowie mogą prosić o więcej kredytów. Ustawienie „Zezwalaj członkom na wnioskowanie o dodatkowe kredyty” pozwala osobom, które osiągnęły swój limit, poprosić administratora o więcej kredytów, zamiast od razu blokować im pracę.
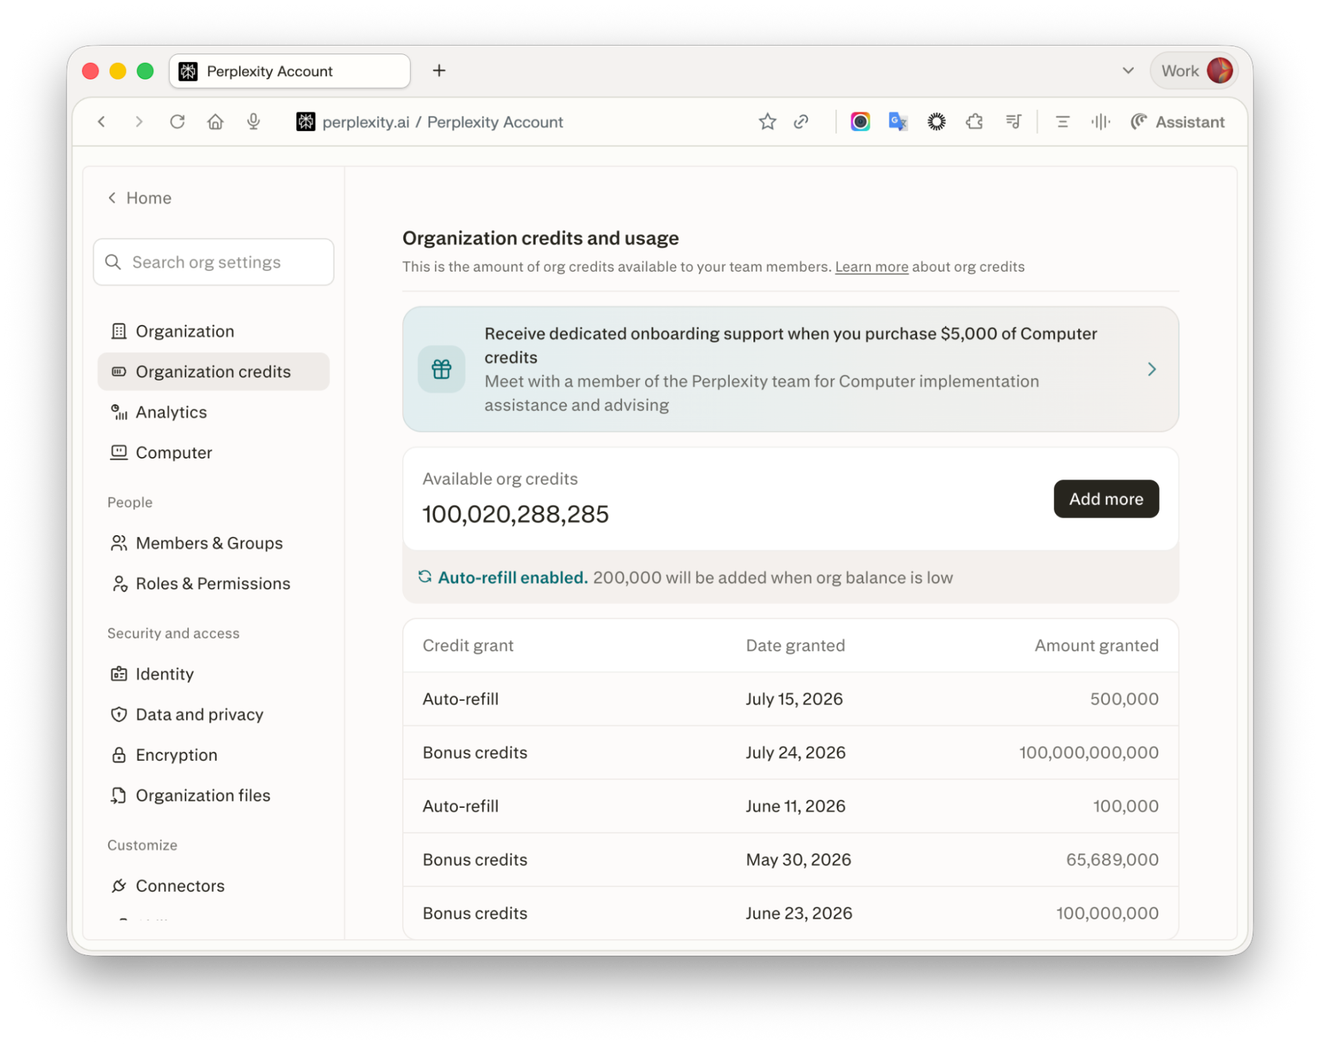
- Co miesiąc przeglądaj użycie. Strona „Kredyty organizacji” pokazuje przyznane, wykorzystane i pozostałe kredyty każdego członka, a także limity grup i saldo puli. W organizacjach z co najmniej 50 stanowiskami lub co najmniej jednym członkiem Enterprise Max panel Insights dodatkowo pokazuje liczbę miesięcznie aktywnych użytkowników i tygodniowych zapytań w czasie. Bardziej szczegółowe informacje zapewniają dzienniki audytu, które rejestrują wykonywanie zadań, korzystanie z łączników, zużycie kredytów i ich przyznawanie.
Dla zespołów budujących rozwiązania w oparciu o API
- Przydziel każdemu narzędziu lub zespołowi osobny klucz API. Perplexity może pokazywać rozliczenia osobno dla każdego klucza, a oddzielne klucze jasno pokazują, które narzędzie generuje użycie.
- Sprawdź na stronie rozliczeń, których tokenów przybywa. Strona pokazuje tokeny wejściowe, wyjściowe i tokeny rozumowania w czasie. Rosnąca liczba tokenów wejściowych zwykle oznacza, że narzędzie wysyła więcej tekstu, niż potrzebuje. Rosnąca liczba tokenów rozumowania oznacza, że zadania są wykonywane przez modele, które długo analizują problemy.
- Korzystaj z Search API, gdy narzędzie potrzebuje wyłącznie wyników wyszukiwania. Zwraca ono wyniki z sieci bez generowania odpowiedzi przez model, a opłata jest naliczana za każde żądanie, bez dodatkowych opłat za tokeny.
- Zaczynaj tworzenie narzędzi agentowych od presetu. Presety Perplexity dopasowują rozmiar modelu do skali zadania i kierują proste żądania z dala od najdroższych modeli
Praca przede wszystkim lokalnie
Niektóre zadania w ogóle nie wymagają płatnego modelu w chmurze. Portable Computer to wersja agenta Perplexity, która działa na komputerze użytkownika i korzysta z modelu AI zapisanego na tym urządzeniu. Ponieważ model działa lokalnie, rutynowa praca nie zużywa płatnych tokenów. Agent łączy się z siecią, połączonymi aplikacjami lub mocniejszym modelem w chmurze tylko wtedy, gdy wymaga tego zadanie, i najpierw pyta użytkownika o zgodę.
Dowiedz się, jak Perplexity Computer obsługuje wieloetapową pracę w sieci, plikach i połączonych narzędziach.
Często zadawane pytania
Czym różnią się wydatki na tokeny od kosztów AI?
Wydatki na tokeny mierzą, ile pracy AI wykonuje zespół, w przeliczeniu na tokeny. Koszty AI obejmują wszystko, za co zespół płaci, aby korzystać z AI, w tym subskrypcje, dodatkowe kredyty i wdrożenie. Wydatki na tokeny decydują o tej części rachunku, która zależy od użycia.
Czy użytkownicy subskrypcji płacą za tokeny?
Zwykle nie bezpośrednio. Narzędzia subskrypcyjne mierzą użycie w wiadomościach, zapytaniach lub kredytach, a zadania zużywające więcej tokenów szybciej je wyczerpują. W Perplexity zwykłe wyszukiwania w ogóle nie zużywają kredytów – zużywają je tylko zadania Computer.
Dlaczego agenci AI zużywają tak wiele tokenów?
Agent wykonuje zadanie w wielu krokach, a każdy krok to osobne żądanie, które ponownie odczytuje dotychczasową pracę. Dlatego długie zadanie zużywa coraz więcej tokenów z każdym kolejnym krokiem.
Skąd biorą się nagłe skoki zużycia tokenów?
Większość skoków następuje po zmianie sposobu pracy zespołu, na przykład po wprowadzeniu nowego zautomatyzowanego przepływu pracy, udostępnieniu narzędzia większej liczbie osób lub uruchomieniu długiego zadania agenta. Porównanie daty skoku z ostatnimi wdrożeniami zwykle pozwala ustalić przyczynę. Testowanie nowych przepływów pracy najpierw na małej grupie pomaga zapobiegać skokom.