
Degradação de contexto em agentes de IA: por que tarefas longas perdem precisão e como evitar isso
Um guia sobre o que se acumula no contexto de um agente de IA, por que isso prejudica a precisão e como configurar tarefas que continuem confiáveis.
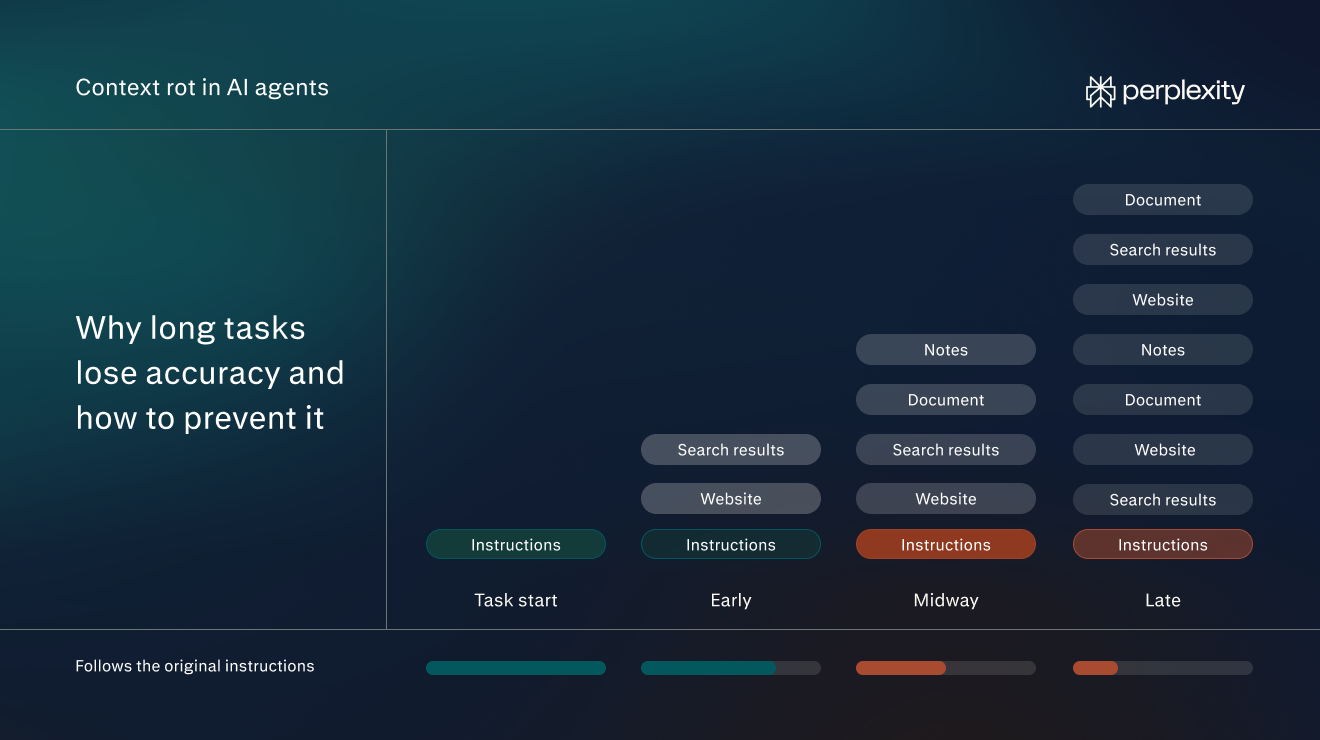
O que a degradação de contexto significa para agentes de IA
A degradação de contexto (context rot) em agentes de IA é a perda gradual de precisão que surge à medida que o contexto de um agente se enche durante uma tarefa longa.
O contexto de um agente é a informação que o modelo tem disponível para a próxima etapa. Ele pode incluir instruções, mensagens anteriores, resultados de pesquisa e texto de sites ou arquivos. À medida que o agente trabalha, ele pode acrescentar mais conteúdo.
Por exemplo, digamos que a tarefa de um agente seja encontrar fornecedores que entreguem em até duas semanas. No início, o contexto contém apenas essa solicitação. No meio da tarefa, o contexto também incluirá o texto de dezenas de sites de fornecedores, várias páginas de resultados de pesquisa e anotações sobre quais fornecedores o agente já verificou.
Há um limite para a quantidade de contexto que um modelo consegue comportar (a chamada janela de contexto). A janela é medida em tokens, que são pequenos trechos de texto, geralmente uma palavra ou parte de uma palavra. A degradação de contexto aumenta à medida que o contexto cresce, e é por isso que é mais provável que ocorra em tarefas longas, com muitas etapas.
À medida que a degradação de contexto se agrava, o agente fica menos preciso. Ele pode seguir as instruções originais com menos rigor, deixar passar detalhes ou confundir informações parecidas com aquilo de que precisa.
Por exemplo, o agente pode começar a incluir fornecedores que levam seis semanas, mesmo tendo recebido a instrução de encontrar entrega em duas semanas. A instrução continua no contexto, mas deixa de orientar as escolhas do agente.
A degradação de contexto não é o mesmo que simplesmente ficar sem espaço na janela de contexto. Quando o contexto de uma tarefa ultrapassa a janela, parte do material é cortada ou a tarefa falha. A degradação de contexto começa bem antes desse ponto, quando tudo ainda cabe.
Também não é a mesma coisa que envenenamento de contexto (quando informações enganosas ou prejudiciais entram no contexto do agente). Um agente com informações precisas e completas ainda pode sofrer degradação de contexto.
Por que a degradação de contexto acontece
A degradação de contexto acontece porque a atenção de um modelo é limitada, mesmo quando sobra espaço na janela de contexto. Em modelos de IA, atenção é o termo técnico para a forma como um modelo decide em quais partes da entrada se basear ao escrever cada palavra de uma resposta. Todas as partes do contexto competem por essa atenção. Quanto mais texto houver, menos atenção cada parte recebe.
Por exemplo, a Chroma publicou um estudo sobre como o tamanho da entrada afeta os modelos de IA. Ele testou 18 modelos da Anthropic, OpenAI, Google e Alibaba. Em um dos testes, os pesquisadores esconderam uma frase com um conselho de escrita dentro de uma longa coletânea de ensaios. Depois, perguntaram ao modelo qual era o conselho.
Eles repetiram o teste muitas vezes, acrescentando mais texto de ensaios a cada rodada. A frase e a pergunta nunca mudaram. Só a quantidade de texto ao redor delas mudou.
Quanto mais texto os modelos precisavam ler, pior era o desempenho. Esse resultado se manteve em todos os testes do relatório. Os pesquisadores preveem que a queda na precisão seria ainda maior em trabalhos reais com muitas etapas, como a maioria das tarefas de agentes.
Como a degradação de contexto pode afetar agentes de IA
A degradação de contexto costuma se manifestar de uma destas quatro formas:
Perder de vista as instruções originais
O teste mais simples da Chroma pedia aos modelos que copiassem exatamente uma longa sequência de palavras repetidas, com uma palavra diferente inserida em algum ponto. Era uma tarefa trivial, com uma instrução explícita. Mesmo assim, o desempenho caiu em todos os modelos à medida que o texto ficava mais longo. Alguns modelos começaram a produzir palavras que nem estavam na entrada.
Em uma tarefa de agente, o usuário costuma definir restrições específicas no início, como um orçamento ou um formato obrigatório. O agente pode aplicá-las de forma menos consistente à medida que o contexto cresce. A causa é o tamanho total do contexto, não a posição da instrução.
Detalhes perdidos no meio de uma tarefa
Os modelos de IA usam as informações de forma mais confiável quando elas estão bem no início ou bem no fim da entrada, segundo um estudo de Stanford de 2023. Em um dos testes, os pesquisadores deram aos modelos um conjunto de 20 documentos e fizeram uma pergunta que só um deles respondia. Quando esse documento vinha em primeiro ou em último lugar, os modelos geralmente encontravam a resposta. Quando ele ficava no meio do conjunto, deixavam de encontrá-la com muito mais frequência. Os pesquisadores chamam isso de efeito de posição.
O mesmo padrão vale para agentes. Informações encontradas em etapas anteriores de uma tarefa podem acabar no meio de uma conversa longa, onde alguns modelos têm mais dificuldade de usá-las. No exemplo dos fornecedores, a lista final pode deixar de fora um bom fornecedor que o agente verificou no meio da tarefa.
Confundir informações semelhantes
À medida que o contexto cresce, os agentes podem ter mais dificuldade para reconhecer quais informações atendem às instruções. Por exemplo, digamos que o usuário tenha pedido ao agente que encontrasse fornecedores que enviam “em até duas semanas”. O site de um fornecedor diz “chega em até 14 dias corridos após o pedido”. Em uma tarefa curta, o agente provavelmente perceberia que as duas coisas significam o mesmo. Enterrado entre dezenas de outras páginas de fornecedores, é mais provável que ele não perceba a correspondência.
Ou então o agente pode começar a incluir resultados que não são relevantes. Digamos que o agente esteja procurando fornecedores de cadeiras de escritório. O site de um fornecedor promete entrega em duas semanas, mas só para mesas. As cadeiras levam seis semanas. O site usa as mesmas palavras da instrução, então o agente pode incluir o fornecedor na lista mesmo assim. Os pesquisadores chamam esse tipo de informação de distrator. Ela parece relevante, mas não é, e por isso compete com as informações que importam.
O estudo da Chroma constatou que os dois problemas pioravam à medida que a quantidade de texto ao redor aumentava.
Erros difíceis de detectar
A degradação de contexto não gera nenhuma mensagem de erro. O agente continua trabalhando e entrega um resultado com aparência de pronto. Isso faz com que os erros passem despercebidos com facilidade.
Nos testes da Chroma, esses erros assumiram duas formas. Às vezes, um modelo dava com confiança uma resposta errada. No exemplo da pesquisa de fornecedores, o agente poderia entregar uma lista de fornecedores organizada e bem formatada que inclui um fornecedor cujas condições de entrega ele interpretou errado.
Em outras vezes, um modelo dizia não conseguir encontrar uma informação que estava lá. Por exemplo, o agente poderia entregar um relatório dizendo que nenhum fornecedor cumpre o prazo de duas semanas quando, na verdade, vários cumprem.
Como configurar tarefas de agente para reduzir a degradação de contexto
Configurar as tarefas corretamente minimiza o impacto da degradação de contexto e mantém o agente o mais preciso possível ao longo da tarefa. As boas práticas a seguir podem ajudar.
Escreva a tarefa como uma atribuição de trabalho
Uma atribuição clara mantém o contexto menor. O agente sabe quando terminou, então para de reunir material assim que tem o suficiente. Requisitos específicos também lhe dão algo concreto para comparar com cada página. Isso facilita que o agente identifique a informação certa.
Antes de enviar uma tarefa, verifique se ela abrange três pontos:
- A tarefa: o que o agente deve fazer e produzir, como “encontrar fornecedores e retornar uma lista de pré-selecionados”.
- Os requisitos: os fatos que o agente não consegue adivinhar, como o orçamento, o prazo, o endereço de entrega e para quem é o resultado.
- O resultado: o formato, o tamanho e a estrutura, como “uma tabela com nome, preço por cadeira e prazo de entrega”.
Juntando tudo, a consulta da tarefa de fornecedores poderia ficar assim:
“Encontre 10 fornecedores que possam entregar 40 cadeiras de escritório no nosso escritório de Chicago em até duas semanas, por menos de US$ 250 por cadeira. Retorne uma tabela com nome do fornecedor, preço por cadeira, prazo de entrega e um link para a página do produto. A lista é para o responsável pelo nosso escritório, que fará o pedido.”
Mantenha cada tarefa focada
Uma tarefa com um objetivo claro mantém o contexto pequeno. Tarefas longas também custam mais. Cada etapa processa tudo o que foi reunido até o momento, por isso um contexto inchado consome mais créditos a cada etapa.
Em um projeto com várias partes, divida-o:
- Liste as entregas separadas, por exemplo, uma pesquisa de fornecedores, uma comparação de preços e um e-mail para o fornecedor escolhido.
- Execute cada entrega como uma tarefa própria.
- Passe apenas o resultado final de uma tarefa para a próxima. Por exemplo, faça upload da tabela de fornecedores como arquivo para iniciar a tarefa de comparação, em vez de continuar no tópico que a gerou.
Assim, a tarefa de comparação começa com uma única tabela, em vez de todas as páginas.
Indique ao agente as fontes certas
Cada página que o agente lê aumenta o contexto, incluindo menus, anúncios e textos padrão em torno da parte útil. Fornecer as fontes diretamente ao agente reduz esse ruído.
Faça upload dos arquivos de que a tarefa depende, como a lista de fornecedores aprovados, anexando-os à consulta. Quando o agente precisar pesquisar na web, indique os sites em que vale a pena pesquisar, como dois diretórios de fornecedores confiáveis.
Conecte as ferramentas onde as informações estão. Por exemplo, no Perplexity Computer, abra Conectores na barra lateral e ative os apps de que a tarefa precisa, como Google Drive ou Slack. Depois, mencione-os na consulta: “Use as especificações das cadeiras no nosso Google Drive.” Conecte apenas os apps relevantes, já que cada conector ocupa parte do contexto do agente.
Se as informações estiverem em um app que não está na lista de Conectores, talvez ainda seja possível conectá-lo. Muitos apps oferecem um conector MCP (Model Context Protocol), uma forma padrão de ferramentas de IA se conectarem a outros softwares. O Computer pode usá-los junto com seus conectores integrados. Em uma conta corporativa, talvez um administrador precise ativá-los primeiro.
Peça uma verificação final em relação às instruções
Termine a consulta com uma etapa de revisão que cite as restrições mais importantes:
“Antes de concluir, verifique cada fornecedor em relação a estes requisitos: entrega em até duas semanas e menos de US$ 250 por cadeira. Sinalize os que não atenderem a esses requisitos, em vez de deixá-los de fora.”
As restrições continuam no início do contexto. A etapa de revisão dá ao agente um motivo para comparar o resultado final com as restrições, em vez de depender de que as instruções mantenham sua influência ao longo de todas as etapas.
Além disso, pedir que ele sinalize problemas, em vez de simplesmente descartar esses resultados, facilita a identificação de erros (como rejeitar um fornecedor que promete chegada em até 14 dias corridos porque ele não usa as palavras “duas semanas”.)
Revise o trabalho em pontos de verificação
Em tarefas mais longas, inclua um ponto de verificação na consulta:
“Comece encontrando 20 fornecedores candidatos e depois pare. Vou confirmar a lista antes de você coletar os preços.”
Compare a lista de pré-selecionados com as instruções originais. Corrija o que estiver errado em uma mensagem de acompanhamento e depois deixe o agente continuar. Erros detectados nesse ponto não se propagam para todas as etapas seguintes.
Inicie uma nova tarefa quando uma sair do rumo
Se o agente repetir o mesmo erro depois das correções, inicie uma nova tarefa. Cada correção acrescenta mais texto a um contexto que já é longo. Em vez disso, crie uma nova tarefa. Reformule as instruções, faça upload de qualquer resultado bom da primeira tentativa e comece de novo.
Alguns agentes fazem uma versão disso automaticamente, um processo chamado compactação. Quando uma tarefa fica longa, o agente substitui o material mais antigo, como o texto completo das páginas que leu no início, por um breve resumo do que encontrou. O Portable Computer da Perplexity compacta o contexto dessa forma, para que o modelo permaneça dentro da quantidade que consegue processar bem.
Também é importante iniciar uma nova tarefa se o objetivo mudar. Um tópico que começou como uma pesquisa de fornecedores não deveria virar também uma revisão de contrato.
Transforme instruções repetidas em uma Skill
Algumas instruções aparecem em todas as tarefas de determinado tipo, como um formato de tabela preferido, uma lista de fornecedores a evitar ou uma etapa de revisão padrão. No Computer, elas podem ser salvas como uma Skill, um conjunto reutilizável de instruções que o agente segue toda vez. Uma Skill incorpora as outras boas práticas a todas as tarefas que a utilizam.
Para configurar uma:
- Escolha uma tarefa recorrente, como a pesquisa de fornecedores.
- Anote as instruções dadas todas as vezes: o formato, as verificações, as fontes a usar ou evitar.
- Salve-as como uma Skill. Instruções já escritas em Markdown podem ser importadas diretamente.
- Cite a Skill em consultas futuras: “Use a Skill de pesquisa de fornecedores para encontrar fornecedores de cadeiras para o escritório de Denver.”
Como a Perplexity aborda o contexto no trabalho de agentes
O Perplexity Computer lida com tarefas longas de maneiras que mantêm o contexto de cada modelo pequeno e relevante. Três aspectos do seu design limitam quanto um modelo precisa ler de uma só vez.
Dividir o trabalho entre subagentes
O Computer divide uma solicitação em tarefas e subtarefas e, em seguida, cria subagentes para executá-las. Cada subagente cuida de uma parte do trabalho em seu próprio contexto. Na tarefa de fornecedores, um subagente pode pesquisar preços enquanto outro verifica as condições de entrega. Nenhum deles precisa ler tudo o que o outro leu.
Manter o trabalho em arquivos
Cada tarefa do Computer tem seu próprio espaço de trabalho, com arquivos, navegador e ferramentas próprios. O agente pode salvar o trabalho em um arquivo, como uma tabela atualizada dos fornecedores que já verificou. Depois, ele só abre esse arquivo de novo quando precisa.
Selecionar trechos relevantes dos resultados de pesquisa
As páginas da web estão cheias de material de que o modelo não precisa, como menus, anúncios, metadados e textos sobre outros assuntos. A compressão de contexto orientada à consulta remove tudo isso. Antes que uma página chegue ao modelo, a Perplexity mantém apenas as frases relacionadas à consulta.
Explore dicas, guias e exemplos de tarefas para o Perplexity Computer para colocar essas etapas em prática.
Perguntas frequentes
A degradação de contexto é o mesmo que alucinação?
Não, mas estão relacionadas. Uma alucinação é qualquer resposta que afirma algo falso ou sem fundamento. A degradação de contexto é uma das condições que tornam mais prováveis as alucinações e outros erros, como instruções ignoradas e detalhes perdidos.
Uma consulta melhor resolve a degradação de contexto?
Uma consulta clara reduz a degradação de contexto ao manter a tarefa focada. Mas ela não impede o contexto de crescer. Em uma tarefa longa o suficiente, o agente ainda reúne mais do que consegue usar bem, e é por isso que dividir o trabalho e verificá-lo ao longo do caminho importa tanto quanto a própria consulta.
A degradação de contexto afeta também os chats comuns com IA, e não apenas os agentes?
Sim. Em um chat, o contexto é toda a conversa até o momento, incluindo cada mensagem e todos os documentos colados ou enviados nela. Um tópico que se estende por horas e passa por vários assuntos pode produzir os mesmos erros que uma tarefa longa de agente. Iniciar um novo tópico para cada novo assunto mantém cada conversa focada.
Quanto uma tarefa pode se estender antes que a degradação de contexto comece?
Não há um ponto fixo. Depende do modelo e da tarefa. Modelos executados no dispositivo com janelas de contexto de 260.000 tokens, por exemplo, começam a ter dificuldades além de cerca de 100.000 tokens, bem abaixo do limite. A queda também é gradual, e não repentina.