
Как отслеживать и контролировать расход токенов в команде
Как командам отслеживать использование токенов на панелях и в отчетах, какие виды работы с ИИ расходуют больше всего токенов и как сократить расход с помощью средств контроля.
Что такое расход токенов
Расход токенов — это количество токенов, которое команда потребляет при работе с ИИ, и стоимость этих токенов. Токен — это единица текста, например слово, часть слова или знак препинания, которую модель ИИ читает или пишет. В английском языке 1 токен — это примерно 4 символа. Токены не стандартизированы для разных моделей и провайдеров, поэтому один и тот же текст в разных инструментах может дать разное количество токенов.
В отчетах об использовании токены обычно делятся на несколько типов:
- Входные токены — это все, что модель читает при обработке запроса. Сюда входят сам запрос, любой прикрепленный текст и история разговора, которую модель повторно использует из предыдущих сообщений в том же треде.
- Выходные токены — это ответ, который пишет модель. Часто они стоят дороже входных. Согласно тарифам API Perplexity, у некоторых моделей выходные токены стоят в шесть раз дороже.
- Токены рассуждения — это текст, который модель генерирует внутри себя, чтобы проработать задачу перед ответом. Они не отображаются в ответе, поэтому более длинный видимый ответ не обязательно означает, что модель в целом израсходовала больше токенов.
Команды, которые пользуются ИИ-инструментами по подписке, редко видят плату за каждый токен. Но токены все равно влияют на то, что они получают: более ресурсоемкие задачи быстрее расходуют кредиты или достигают лимитов использования. Команды, которые создают собственные инструменты на базе модели ИИ, обычно платят за каждый токен в рамках оплаты по факту использования.
Как отслеживать расход токенов
Отслеживание расхода токенов на тарифе с подпиской
Инструменты по подписке обычно не показывают количество токенов. Вместо этого во многих тарифах используются кредиты — предоплаченные единицы, которые списываются по мере выполнения работы. Кредиты — не то же самое, что токены: один кредит может покрывать текст, изображения или другую работу. Но задачи, расходующие больше токенов, обычно расходуют и больше кредитов, поэтому именно по кредитам удобнее всего судить о расходе токенов при подписке. Пользователи могут отслеживать собственный расход кредитов, а в некоторых тарифах есть и панель администратора, где показан расход кредитов всей команды.
Например, в Perplexity обычный поиск не расходует кредиты. Их использует только Perplexity Computer — ассистент, который выполняет многоэтапные задачи. Пользователи Computer могут посмотреть, сколько кредитов они израсходовали и на что. Кроме того, у каждой задачи Computer общее количество кредитов отображается в меню «Использование» соответствующего разговора.
В тарифах Enterprise администраторы могут видеть на панели Insights, сколько людей пользуются Perplexity и сколько запросов они выполняют каждую неделю (панель доступна организациям с 50 и более местами или хотя бы с одним участником Enterprise Max).
Отслеживание расхода токенов в отчетах об использовании API
Отчеты об использовании от провайдера API показывают количество токенов напрямую, обычно с разбивкой по типам. Например, в консоли Perplexity API Platform на странице оплаты можно отслеживать такие показатели, как расход входных и выходных токенов, а также токенов рассуждения.
Почему растет расход токенов
Агенты выполняют множество шагов в рамках одной задачи, и каждый шаг — это отдельный запрос к модели. В сумме одна задача может потребовать сотни тысяч или даже миллионы токенов.
Кроме того, все шире распространяются модели с рассуждением. Такая модель записывает ход своих мыслей перед ответом, и каждое слово при этом учитывается в токенах. Поэтому один и тот же запрос к модели с рассуждением обычно расходует больше токенов, чем к стандартной модели, даже если ответ на экране такой же длины.
Наконец, по мере того как ИИ используют все больше людей и рабочих процессов, суммарный расход токенов растет. Часть этого роста связана и с так называемым токенмаксингом (tokenmaxxing), когда инженеры запускают агентов в основном ради того, чтобы увеличить личный счетчик токенов и подняться выше во внутренних рейтингах по токенам.
Как сократить расход токенов
Высокий расход токенов чаще всего связан с несколькими видами работы, которые потребляют больше токенов, чем кажется.
Длинные разговоры и задачи агентов
Каждый раз, отвечая, модель обычно заново перечитывает весь предыдущий разговор. Каждый новый запрос включает всю историю разговора плюс текущее сообщение пользователя. Поэтому короткий вопрос в конце длинного треда расходует больше токенов, чем тот же вопрос в новом. Задачи агентов устроены так же: каждый шаг добавляет свои результаты в историю, которую перечитывает следующий шаг.
Что с этим делать
- Начинайте новый разговор, когда меняется тема. Откройте его кратким резюме в две-три строки, включив все из старого треда, что еще нужно модели.
- Разбивайте длинные задачи агентов на более мелкие. Запускайте каждую часть как отдельную задачу и передавайте дальше только те результаты, которые нужны следующей части.
- Проверьте, используют ли агентные инструменты команды сжатие контекста. Сжатие автоматически резюмирует более ранние части задачи, чтобы модели приходилось перечитывать меньше. Если инструмент предлагает это в виде настройки, включите ее.
Одни и те же документы, обрабатываемые снова и снова
Когда кто-то прикрепляет один и тот же длинный файл, например справочник по внутренним правилам или каталог продукции, ко множеству отдельных запросов, модель каждый раз читает файл целиком. Каждое такое чтение учитывается как входные токены.
Что с этим делать
- Научите пользователей копировать в запрос нужный раздел справочника или каталога, а не прикреплять весь файл.
- Подготовьте краткие версии документов, которыми команда пользуется часто. Одностраничное резюме длинного регламента может заменить полный документ в рутинных запросах.
Повторные попытки и зацикливания
Когда ответ оказывается не тем, что был нужен, и человек запускает задачу заново, каждая попытка расходует токены. То же происходит, когда агент застревает, повторяя один и тот же шаг.
Что с этим делать
- Четко сформулируйте задачу, ожидаемый результат и источники в первом же запросе. Например: «Кратко изложи в пяти пунктах основные причины, по которым клиенты отказались от услуг в третьем квартале, используя только приложенные результаты опроса».
- Проверяйте первые несколько шагов задачи агента. Если агент повторяет один и тот же шаг или поиск, остановите его и перезапустите с более узким запросом.
Большие модели для простых задач
Более мощные модели обычно стоят дороже за токен, поэтому рутинная работа, например составление резюме или переформатирование, может расходовать бюджет команды быстрее, чем нужно.
Что с этим делать
- Используйте маршрутизацию моделей, при которой каждая задача передается модели, способной с ней справиться. Короткую переработку текста или резюме можно поручить меньшей и более дешевой модели, а самую мощную оставить для многоэтапных рассуждений или анализа. API Perplexity использует этот подход в своих пресетах: быстрый поиск сведений назначается меньшей модели, а исчерпывающий анализ — более крупной.
Всплески после запуска новых рабочих процессов
Новый автоматизированный рабочий процесс или инструмент, развернутый для всей команды, может в одночасье увеличить расход. Сам по себе всплеск — не проблема, но стоит знать, какая работа его вызвала.
Что с этим делать
- Сначала тестируйте новые рабочие процессы на небольшой группе. Понаблюдайте за ее расходом неделю-другую, прежде чем внедрять рабочий процесс для всей команды.
- Установите месячный бюджет для каждой команды. Ориентируйтесь на расход в обычный месяц, чтобы скачок сразу был заметен.
- Отключите автопополнение. Когда автопополнение выключено, работа останавливается при исчерпании кредитов, а новые кредиты не докупаются автоматически.
Как оптимизировать расход токенов в Perplexity
Для повседневного использования
Computer расходует кредиты, но запускается, только когда вы сами его выбираете: нажав значок Computer, работая в проекте, где Computer используется по умолчанию, или используя режим Work в Comet.
Чтобы вернуться к обычному поиску, нажмите значок Perplexity и переключитесь обратно в режим Ask. Чтобы посмотреть расход кредитов, пользователи могут открыть счетчик прямо в интерфейсе Perplexity.
Команды, работающие в проектах — общих рабочих пространствах Perplexity, — могут выбрать для каждого проекта режим по умолчанию: Search или Computer. Для проекта, который в основном используется для быстрых исследований, можно выбрать по умолчанию Search, чтобы никто случайно не запустил задачу Computer.
Для администраторов Enterprise
- Узнайте, что входит в каждое место. Пользователи Enterprise Pro ежемесячно получают 500 кредитов, а пользователи Enterprise Max — 15 000 кредитов. Они сгорают в конце каждого месячного цикла и не переносятся на следующий.
- Сначала установите лимит использования по умолчанию. Лимит использования ограничивает количество дополнительных кредитов, которые участник может взять из общего пула после того, как израсходует собственную квоту.
- Создайте именованные лимиты для разных типов пользователей. Администраторы могут настроить лимиты, например «Стандартный», «Продвинутый пользователь» и «Подрядчик», и назначить их группам пользователей или отдельным участникам. Группы можно создавать в Perplexity или синхронизировать из поставщика удостоверений компании. Если человек входит в несколько групп, действует самый высокий лимит.
- Для исключений используйте персональные переопределения. Когда одному человеку нужен лимит, отличный от лимита его группы, персональное переопределение имеет приоритет над любым групповым или общим лимитом. Это удобно для короткого проекта с большим объемом исследований: не придется повышать лимит для всей команды.
- Ограничьте автопополнение. Автопополнение автоматически пополняет общий пул. Для него можно настроить месячный лимит пополнения, поэтому расходы не будут расти без заданного максимума.
- Решите, как участники будут запрашивать дополнительные кредиты. Настройка «Разрешить участникам запрашивать дополнительные кредиты» позволяет тем, кто достиг лимита, запросить больше кредитов у администратора, а не просто останавливает их работу.
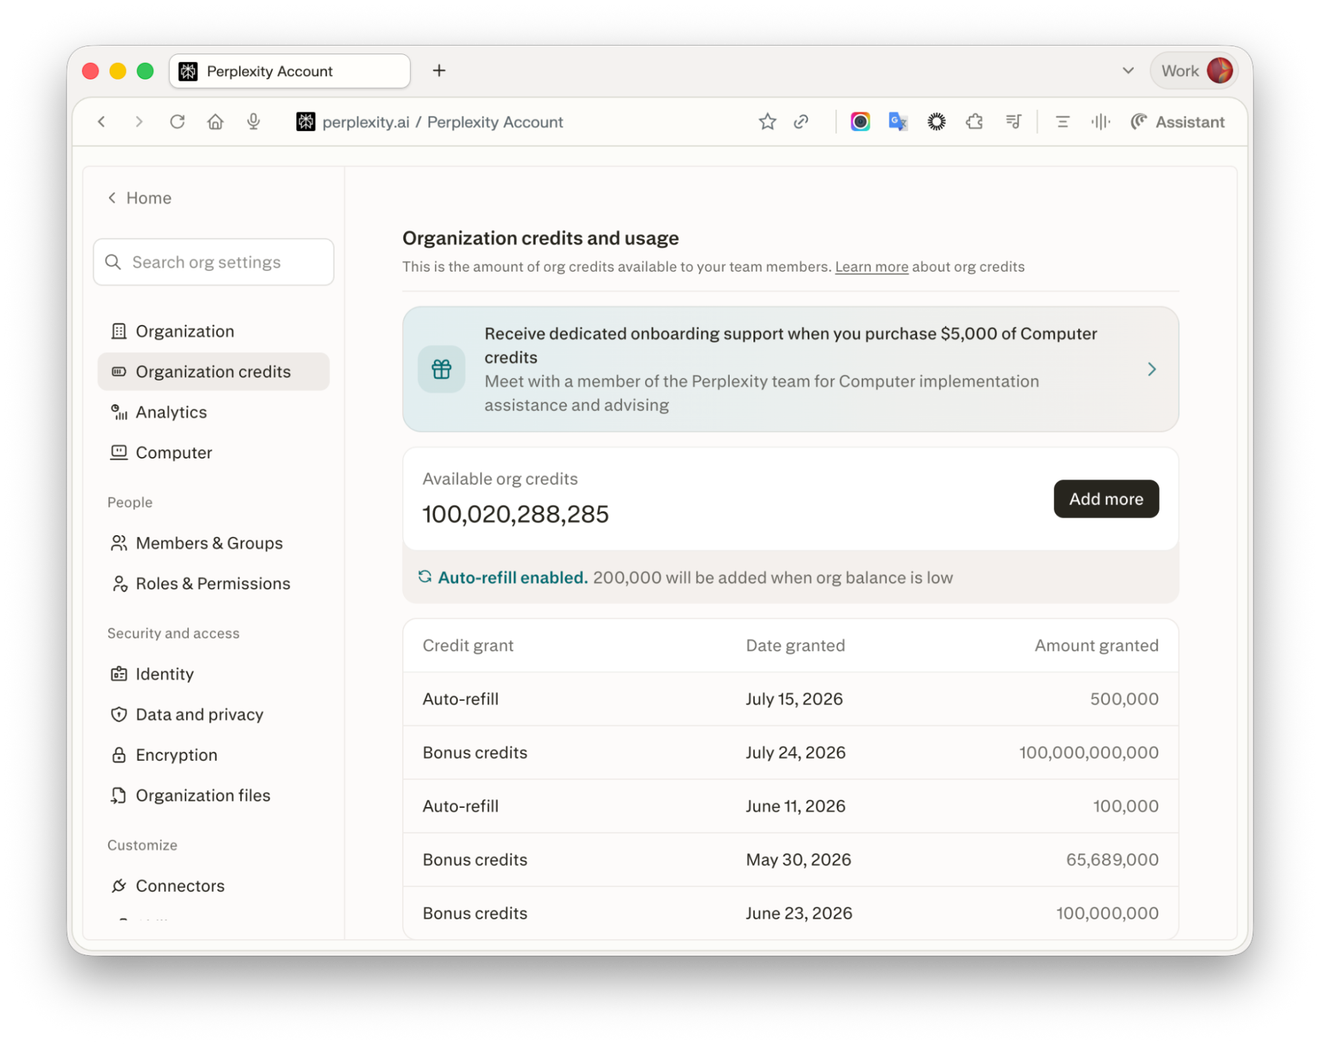
- Ежемесячно проверяйте расход. На странице «Кредиты организации» для каждого участника показаны выделенные, израсходованные и оставшиеся кредиты, а также групповые лимиты и баланс пула. Для организаций с 50 и более местами или хотя бы с одним участником Enterprise Max панель Insights дополнительно показывает активных пользователей за месяц и динамику еженедельных запросов. Для более подробного анализа журналы аудита фиксируют выполнение задач, использование коннекторов, расход кредитов и выдачу кредитов.
Для команд, разрабатывающих решения на базе API
- Выдайте каждому инструменту или команде собственный ключ API. Perplexity может показывать оплату по каждому ключу отдельно, а отдельные ключи позволяют понять, какой инструмент дает основной расход.
- Проверьте на странице оплаты, какой тип токенов растет. Там показана динамика входных и выходных токенов, а также токенов рассуждения. Рост входных токенов обычно означает, что инструмент отправляет больше текста, чем нужно. Рост токенов рассуждения означает, что задачи выполняются на моделях, которые подолгу продумывают решение.
- Используйте Search API, когда инструменту нужны только результаты поиска. Он возвращает результаты из интернета без ответа, написанного моделью, а оплата взимается за каждый запрос без дополнительной платы за токены.
- Запускайте агентные инструменты на основе пресетов. Пресеты Perplexity подбирают размер модели под размер задачи и не допускают отправки простых запросов на самые дорогие модели.
Приоритет локальной работы
Для некоторых задач платная облачная модель вообще не нужна. Portable Computer — это версия агента Perplexity, которая работает на собственном компьютере пользователя и использует модель ИИ, хранящуюся на этом устройстве. Поскольку модель работает локально, рутинная работа не расходует платные токены. Агент обращается к интернету, подключенным приложениям или более мощной облачной модели, только когда это нужно для задачи, и предварительно спрашивает пользователя.
Узнайте, как Perplexity Computer выполняет многоэтапную работу в интернете, с файлами и подключенными инструментами.
Часто задаваемые вопросы
Чем расход токенов отличается от затрат на ИИ?
Расход токенов показывает, какой объем работы с ИИ выполняет команда, в пересчете на токены. Затраты на ИИ включают все, что команда платит за использование ИИ, в том числе подписки, дополнительные кредиты и настройку. От расхода токенов зависит та часть счета, которая рассчитывается по факту использования.
Платят ли пользователи подписки за каждый токен?
Как правило, не напрямую. Инструменты по подписке учитывают использование в сообщениях, запросах или кредитах, и задачи, которые расходуют больше токенов, исчерпывают их быстрее. В Perplexity обычный поиск вообще не расходует кредиты — их расходуют только задачи Computer.
Почему ИИ-агенты расходуют так много токенов?
Агент выполняет задачу в несколько шагов, и каждый шаг — это отдельный запрос, при котором заново перечитывается вся проделанная работа. Поэтому длинная задача с каждым новым шагом расходует все больше токенов.
Почему расход токенов внезапно резко возрастает?
Большинство всплесков следует за изменениями в работе команды: например, за запуском нового автоматизированного рабочего процесса, развертыванием инструмента для большего числа людей или длинной задачей агента. Обычно причину можно найти, сопоставив дату всплеска с недавними запусками. Предварительное тестирование новых рабочих процессов на небольшой группе помогает избежать всплесков.