
การเสื่อมของบริบท (context rot) ในเอเจนต์ AI: ทำไมงานที่ยาวจึงสูญเสียความแม่นยำ และวิธีป้องกัน
คู่มือที่อธิบายว่าอะไรสะสมอยู่ในบริบทของเอเจนต์ AI เหตุใดจึงลดความแม่นยำ และวิธีตั้งค่างานให้เชื่อถือได้อย่างต่อเนื่อง
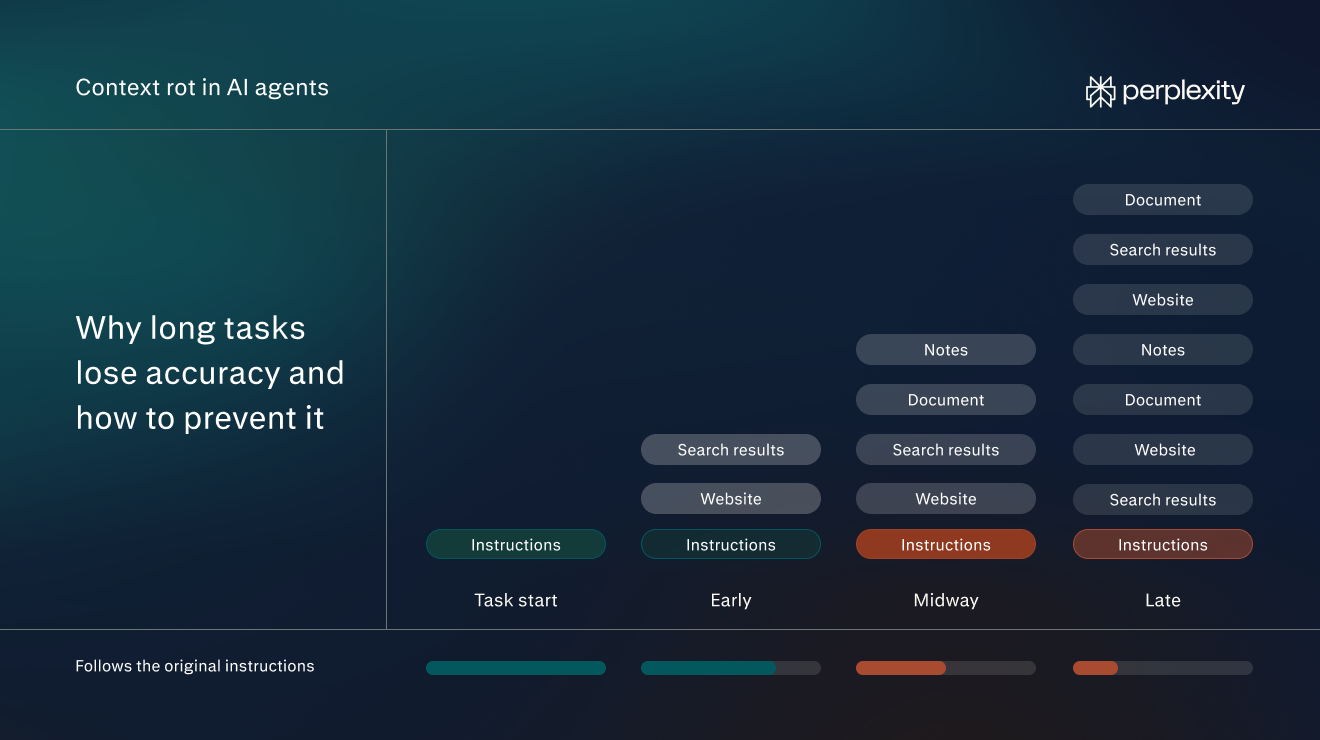
การเสื่อมของบริบท (context rot) มีความหมายอย่างไรต่อเอเจนต์ AI
การเสื่อมของบริบท (context rot) ในเอเจนต์ AI คือการสูญเสียความแม่นยำทีละน้อยซึ่งเกิดขึ้นเมื่อบริบทของเอเจนต์ค่อย ๆ เต็มขึ้นระหว่างการทำงานที่ยาวนาน
บริบทของเอเจนต์คือข้อมูลที่โมเดลมีไว้ใช้สำหรับขั้นตอนถัดไป ซึ่งอาจรวมถึงคำสั่ง ข้อความก่อนหน้า ผลการค้นหา และข้อความจากเว็บไซต์หรือไฟล์ต่าง ๆ ขณะที่เอเจนต์ทำงาน ก็อาจเพิ่มข้อมูลเข้าไปอีก
ตัวอย่างเช่น สมมติว่างานของเอเจนต์คือการหาซัพพลายเออร์ที่จัดส่งได้ภายในสองสัปดาห์ ในตอนเริ่มต้น บริบทของเอเจนต์มีเพียงคำขอนั้น แต่เมื่อทำงานไปได้ครึ่งทาง บริบทจะมีทั้งข้อความจากเว็บไซต์ซัพพลายเออร์หลายสิบแห่ง ผลการค้นหาหลายหน้า และบันทึกว่าเอเจนต์ตรวจสอบซัพพลายเออร์รายใดไปแล้วบ้าง
ปริมาณบริบทที่โมเดลรองรับได้นั้นมีขีดจำกัด (เรียกว่าหน้าต่างบริบทหรือ context window) หน้าต่างนี้วัดเป็นโทเค็น ซึ่งเป็นข้อความชิ้นเล็ก ๆ โดยทั่วไปคือหนึ่งคำหรือส่วนหนึ่งของคำ การเสื่อมของบริบทจะเพิ่มขึ้นเมื่อบริบทขยายใหญ่ขึ้น จึงมีแนวโน้มเกิดขึ้นมากที่สุดในงานที่ยาวและมีหลายขั้นตอน
เมื่อการเสื่อมของบริบทรุนแรงขึ้น เอเจนต์จะแม่นยำน้อยลง อาจทำตามคำสั่งเดิมได้ไม่เคร่งครัดเท่าเดิม มองข้ามรายละเอียด หรือเข้าใจผิดว่าข้อมูลที่ดูคล้ายกันคือสิ่งที่ต้องการ
ตัวอย่างเช่น เอเจนต์อาจเริ่มใส่ซัพพลายเออร์ที่ใช้เวลาจัดส่งหกสัปดาห์ ทั้งที่ได้รับคำสั่งให้หาซัพพลายเออร์ที่จัดส่งภายในสองสัปดาห์ คำสั่งนั้นยังคงอยู่ในบริบท แต่ไม่ได้มีผลต่อการตัดสินใจของเอเจนต์อีกต่อไป
การเสื่อมของบริบทไม่ใช่สิ่งเดียวกับการที่หน้าต่างบริบทมีพื้นที่ไม่พอ เมื่อบริบทของงานขยายเกินหน้าต่าง เนื้อหาบางส่วนจะถูกตัดออกหรืองานจะล้มเหลว แต่การเสื่อมของบริบทเริ่มต้นก่อนถึงจุดนั้นนานมาก ขณะที่ทุกอย่างยังอยู่ในหน้าต่างได้ครบ
นอกจากนี้ยังไม่ใช่สิ่งเดียวกับการปนเปื้อนของบริบท (context poisoning) ซึ่งเป็นกรณีที่ข้อมูลที่ทำให้เข้าใจผิดหรือเป็นอันตรายเข้าไปอยู่ในบริบทของเอเจนต์ เอเจนต์ที่มีข้อมูลถูกต้องและครบถ้วนก็ยังเกิดการเสื่อมของบริบทได้
ทำไมการเสื่อมของบริบทจึงเกิดขึ้น
การเสื่อมของบริบทเกิดขึ้นเพราะความสนใจ (attention) ของโมเดลมีจำกัด แม้หน้าต่างบริบทจะยังมีพื้นที่เหลืออยู่ก็ตาม ในโมเดล AI คำว่า attention เป็นศัพท์เทคนิคที่หมายถึงวิธีที่โมเดลตัดสินใจว่าจะดึงข้อมูลจากส่วนใดของอินพุตมาใช้ขณะเขียนแต่ละคำของคำตอบ ทุกส่วนของบริบทต่างแย่งชิงความสนใจนั้น ยิ่งมีข้อความมาก แต่ละส่วนก็ยิ่งได้รับความสนใจน้อยลง
ตัวอย่างเช่น Chroma ได้เผยแพร่งานศึกษาเรื่องความยาวของอินพุตส่งผลต่อโมเดล AI อย่างไร โดยทดสอบ 18 โมเดลจาก Anthropic, OpenAI, Google และ Alibaba ในการทดสอบหนึ่ง นักวิจัยซ่อนประโยคเกี่ยวกับคำแนะนำด้านการเขียนไว้ในชุดเรียงความขนาดยาว จากนั้นจึงถามโมเดลว่าคำแนะนำนั้นคืออะไร
นักวิจัยทำการทดสอบซ้ำหลายครั้ง โดยเพิ่มข้อความเรียงความเข้าไปทุกครั้ง ประโยคและคำถามไม่เคยเปลี่ยน มีเพียงปริมาณข้อความรอบ ๆ เท่านั้นที่เปลี่ยนไป
ยิ่งโมเดลต้องอ่านข้อความมากเท่าไร ผลลัพธ์ก็ยิ่งแย่ลงเท่านั้น ข้อค้นพบนี้เป็นจริงในทุกการทดสอบในรายงาน นักวิจัยคาดการณ์ว่าความแม่นยำจะลดลงมากกว่านี้อีกในงานจริงที่มีหลายขั้นตอน เช่นเดียวกับงานส่วนใหญ่ของเอเจนต์
การเสื่อมของบริบทส่งผลต่อเอเจนต์ AI ได้อย่างไร
โดยทั่วไป การเสื่อมของบริบทจะแสดงออกมาในรูปแบบใดรูปแบบหนึ่งจากสี่รูปแบบต่อไปนี้:
หลงลืมคำสั่งเดิม
การทดสอบที่ง่ายที่สุดของ Chroma ให้โมเดลคัดลอกชุดคำที่ซ้ำกันยาว ๆ ให้ตรงทุกตัว โดยมีคำที่ต่างออกไปหนึ่งคำแทรกอยู่ที่ใดที่หนึ่ง นี่เป็นงานง่าย ๆ ที่มีคำสั่งชัดเจน แต่ถึงอย่างนั้น ประสิทธิภาพของทุกโมเดลก็ลดลงเมื่อข้อความยาวขึ้น บางโมเดลเริ่มสร้างคำที่ไม่มีอยู่ในอินพุตเลย
ในงานของเอเจนต์ โดยทั่วไปผู้ใช้จะกำหนดข้อจำกัดเฉพาะไว้ตั้งแต่ต้นงาน เช่น งบประมาณหรือรูปแบบที่ต้องการ เอเจนต์อาจปฏิบัติตามข้อจำกัดเหล่านั้นได้สม่ำเสมอน้อยลงเมื่อบริบทขยายขึ้น สาเหตุมาจากความยาวโดยรวมของบริบท ไม่ใช่ตำแหน่งของคำสั่ง
พลาดรายละเอียดจากช่วงกลางของงาน
จากงานศึกษาของ Stanford ในปี 2023 โมเดล AI ใช้ข้อมูลได้อย่างน่าเชื่อถือที่สุดเมื่อข้อมูลอยู่ที่ตอนต้นสุดหรือตอนท้ายสุดของอินพุต ในการทดสอบหนึ่ง นักวิจัยให้ชุดเอกสาร 20 ฉบับแก่โมเดล และถามคำถามที่มีเอกสารเพียงฉบับเดียวที่ตอบได้ เมื่อเอกสารนั้นอยู่ลำดับแรกหรือลำดับสุดท้าย โมเดลมักจะพบคำตอบ แต่เมื่อเอกสารอยู่ตรงกลางชุด โมเดลกลับพลาดบ่อยกว่ามาก นักวิจัยเรียกปรากฏการณ์นี้ว่าผลจากตำแหน่ง (position effect)
รูปแบบเดียวกันนี้เกิดกับเอเจนต์เช่นกัน ข้อมูลที่พบในช่วงต้นของงานอาจไปอยู่ตรงกลางของบทสนทนาที่ยาว ซึ่งบางโมเดลใช้ข้อมูลส่วนนั้นได้ยากกว่า ในตัวอย่างซัพพลายเออร์ รายชื่อสุดท้ายอาจตกหล่นซัพพลายเออร์ที่ดีซึ่งเอเจนต์ตรวจสอบไว้ระหว่างทาง
สับสนข้อมูลที่คล้ายกัน
เมื่อบริบทขยายขึ้น เอเจนต์อาจแยกแยะได้แย่ลงว่าข้อมูลใดตรงกับคำสั่ง ตัวอย่างเช่น สมมติว่าผู้ใช้สั่งให้เอเจนต์หาซัพพลายเออร์ที่จัดส่ง “ภายในสองสัปดาห์” และเว็บไซต์ของซัพพลายเออร์รายหนึ่งระบุว่า “สินค้าถึงภายใน 14 วันตามปฏิทินนับจากวันสั่งซื้อ” ในงานสั้น ๆ เอเจนต์น่าจะสังเกตได้ว่าทั้งสองหมายถึงสิ่งเดียวกัน แต่เมื่อข้อมูลนี้จมอยู่ท่ามกลางหน้าเว็บของซัพพลายเออร์อื่นอีกหลายสิบหน้า เอเจนต์ก็มีแนวโน้มที่จะมองข้ามความตรงกันนี้มากขึ้น
อีกกรณีหนึ่งคือ เอเจนต์อาจเริ่มใส่ผลลัพธ์ที่ไม่เกี่ยวข้อง สมมติว่าเอเจนต์กำลังหาซัพพลายเออร์เก้าอี้สำนักงาน เว็บไซต์ของซัพพลายเออร์รายหนึ่งรับประกันการจัดส่งภายในสองสัปดาห์ แต่เฉพาะโต๊ะทำงานเท่านั้น ส่วนเก้าอี้ใช้เวลาหกสัปดาห์ เว็บไซต์ใช้ถ้อยคำเดียวกับคำสั่ง เอเจนต์จึงอาจเพิ่มซัพพลายเออร์รายนี้ลงในรายชื่ออยู่ดี นักวิจัยเรียกข้อมูลลักษณะนี้ว่าตัวหลอก (distractor) ซึ่งดูเหมือนเกี่ยวข้องแต่ไม่ใช่ จึงแย่งความสนใจไปจากข้อมูลที่สำคัญจริง ๆ
งานศึกษาของ Chroma พบว่าปัญหาทั้งสองแย่ลงเมื่อปริมาณข้อความรอบข้างเพิ่มขึ้น
ข้อผิดพลาดที่สังเกตได้ยาก
การเสื่อมของบริบทไม่ทำให้เกิดข้อความแจ้งข้อผิดพลาด เอเจนต์ยังคงทำงานต่อไปและส่งผลลัพธ์ที่ดูเหมือนเสร็จสมบูรณ์กลับมา ข้อผิดพลาดจึงถูกมองข้ามได้ง่าย
ในการทดสอบของ Chroma ข้อผิดพลาดเหล่านี้มีสองรูปแบบ บางครั้งโมเดลให้คำตอบที่ผิดอย่างมั่นใจ ในตัวอย่างการวิจัยซัพพลายเออร์ เอเจนต์อาจส่งรายชื่อซัพพลายเออร์ที่เรียบร้อยและจัดรูปแบบอย่างดี แต่มีซัพพลายเออร์ที่เอเจนต์อ่านเงื่อนไขการจัดส่งผิดรวมอยู่ด้วย
ในบางครั้ง โมเดลก็บอกว่าหาข้อมูลไม่พบ ทั้งที่ข้อมูลนั้นมีอยู่จริง ตัวอย่างเช่น เอเจนต์อาจส่งรายงานที่ระบุว่าไม่มีซัพพลายเออร์รายใดจัดส่งได้ภายในสองสัปดาห์ ทั้งที่มีอยู่หลายราย
วิธีตั้งค่างานของเอเจนต์เพื่อลดการเสื่อมของบริบท
การตั้งค่างานอย่างถูกต้องจะช่วยลดผลกระทบของการเสื่อมของบริบท และทำให้เอเจนต์แม่นยำที่สุดเท่าที่จะเป็นไปได้ตลอดการทำงาน แนวทางปฏิบัติที่ดีที่สุดต่อไปนี้จะช่วยได้
เขียนงานในรูปแบบของการมอบหมายงาน
การมอบหมายงานที่ชัดเจนช่วยให้บริบทมีขนาดเล็กลง เอเจนต์รู้ว่าเมื่อใดงานเสร็จ จึงหยุดรวบรวมเนื้อหาเมื่อได้ข้อมูลเพียงพอแล้ว ข้อกำหนดที่เจาะจงยังเป็นเกณฑ์ที่เป็นรูปธรรมให้เอเจนต์ใช้ตรวจสอบแต่ละหน้า ทำให้เอเจนต์ระบุข้อมูลที่ถูกต้องได้ง่ายขึ้น
ก่อนส่งงาน ให้ตรวจสอบว่างานครอบคลุมสามสิ่งต่อไปนี้:
- งาน: สิ่งที่เอเจนต์ควรทำและส่งมอบ เช่น “หาซัพพลายเออร์และส่งรายชื่อที่คัดเลือกแล้วกลับมา”
- ข้อกำหนด: ข้อเท็จจริงที่เอเจนต์เดาเองไม่ได้ เช่น งบประมาณ กำหนดเวลา ที่อยู่สำหรับจัดส่ง และผลลัพธ์นี้มีไว้สำหรับใคร
- ผลลัพธ์: รูปแบบ ความยาว และโครงสร้าง เช่น “ตารางที่มีชื่อ ราคาต่อเก้าอี้หนึ่งตัว และระยะเวลาจัดส่ง”
เมื่อรวมทุกอย่างเข้าด้วยกัน คำค้นหาสำหรับงานหาซัพพลายเออร์อาจมีลักษณะดังนี้:
“หาซัพพลายเออร์ 10 รายที่สามารถจัดส่งเก้าอี้สำนักงาน 40 ตัวไปยังสำนักงานของเราในชิคาโกได้ภายในสองสัปดาห์ ในราคาต่ำกว่า $250 ต่อตัว ส่งกลับมาเป็นตารางที่มีชื่อซัพพลายเออร์ ราคาต่อตัว ระยะเวลาจัดส่ง และลิงก์ไปยังหน้าสินค้า รายชื่อนี้มีไว้สำหรับผู้จัดการสำนักงานของเรา ซึ่งจะเป็นผู้สั่งซื้อ”
ให้แต่ละงานมีจุดมุ่งเน้นชัดเจน
งานเดียวที่มีเป้าหมายชัดเจนเพียงหนึ่งเดียวช่วยให้บริบทมีขนาดเล็ก นอกจากนี้ งานที่ยาวยังมีค่าใช้จ่ายสูงกว่า เพราะแต่ละขั้นตอนต้องประมวลผลทุกอย่างที่รวบรวมมาจนถึงตอนนั้น บริบทที่บวมจึงใช้เครดิตมากขึ้นในทุกขั้นตอน
สำหรับโปรเจกต์ที่มีหลายส่วน ให้แบ่งงานออกเป็นส่วน ๆ:
- ระบุชิ้นงานที่ต้องส่งมอบแยกกัน เช่น การค้นหาซัพพลายเออร์ การเปรียบเทียบราคา และอีเมลถึงซัพพลายเออร์ที่เลือก
- ทำชิ้นงานแต่ละชิ้นเป็นงานแยกของตัวเอง
- ส่งต่อเฉพาะผลลัพธ์ที่เสร็จสมบูรณ์จากงานหนึ่งไปยังงานถัดไป ตัวอย่างเช่น อัปโหลดตารางซัพพลายเออร์เป็นไฟล์เพื่อเริ่มงานเปรียบเทียบ แทนที่จะทำต่อในเธรดที่สร้างตารางนั้นขึ้นมา
จากนั้นงานเปรียบเทียบจะเริ่มต้นด้วยตารางเพียงตารางเดียว แทนที่จะเริ่มด้วยทุกหน้า
ชี้แหล่งข้อมูลที่ถูกต้องให้เอเจนต์
ทุกหน้าที่เอเจนต์อ่านจะเพิ่มเข้าไปในบริบท รวมถึงเมนู โฆษณา และข้อความสำเร็จรูปรอบ ๆ ส่วนที่มีประโยชน์ การให้แหล่งข้อมูลแก่เอเจนต์โดยตรงช่วยลดสิ่งรบกวนเหล่านั้น
อัปโหลดไฟล์ที่งานต้องใช้ เช่น รายชื่อผู้ขายที่ได้รับอนุมัติ โดยแนบไฟล์ไปกับคำค้นหา เมื่อเอเจนต์ต้องค้นหาบนเว็บ ให้ระบุเว็บไซต์ที่ควรค้นหา เช่น ไดเรกทอรีซัพพลายเออร์ที่เชื่อถือได้สองแห่ง
เชื่อมต่อเครื่องมือที่เก็บข้อมูลไว้ ตัวอย่างเช่น ใน Perplexity Computer ให้เปิดตัวเชื่อมต่อในแถบด้านข้าง แล้วเปิดใช้งานแอปที่งานต้องใช้ เช่น Google Drive หรือ Slack จากนั้นระบุถึงแอปเหล่านั้นในคำค้นหา: “ใช้สเปกเก้าอี้ใน Google Drive ของเรา” เชื่อมต่อเฉพาะแอปที่เกี่ยวข้องเท่านั้น เพราะตัวเชื่อมต่อแต่ละตัวจะใช้พื้นที่บริบทของเอเจนต์ไปส่วนหนึ่ง
หากข้อมูลอยู่ในแอปที่ไม่มีในรายการตัวเชื่อมต่อ ก็อาจยังเชื่อมต่อได้ แอปจำนวนมากมีตัวเชื่อมต่อ MCP (Model Context Protocol) ซึ่งเป็นวิธีมาตรฐานที่ให้เครื่องมือ AI เชื่อมต่อกับซอฟต์แวร์อื่น Computer สามารถใช้ตัวเชื่อมต่อเหล่านี้ควบคู่กับตัวเชื่อมต่อในตัวได้ สำหรับบัญชีบริษัท ผู้ดูแลระบบอาจต้องเปิดใช้งานตัวเชื่อมต่อเหล่านี้ก่อน
ขอให้ตรวจสอบครั้งสุดท้ายเทียบกับคำสั่ง
ปิดท้ายคำค้นหาด้วยขั้นตอนการตรวจทานที่ระบุข้อจำกัดที่สำคัญที่สุด:
“ก่อนเสร็จงาน ให้ตรวจสอบซัพพลายเออร์ทุกรายเทียบกับข้อกำหนดเหล่านี้: จัดส่งภายในสองสัปดาห์ และราคาต่ำกว่า $250 ต่อตัว ให้ทำเครื่องหมายรายที่ไม่เป็นไปตามข้อกำหนดเหล่านั้น แทนที่จะตัดออกไป”
ข้อจำกัดยังคงอยู่ที่ตอนต้นของบริบท ขั้นตอนการตรวจทานทำให้เอเจนต์มีเหตุผลที่จะเปรียบเทียบผลลัพธ์สุดท้ายกับข้อจำกัดเหล่านั้น แทนที่จะพึ่งพาให้คำสั่งคงอิทธิพลไว้ได้ตลอดทุกขั้นตอน
ในขณะเดียวกัน การขอให้เอเจนต์ทำเครื่องหมายปัญหาแทนที่จะตัดผลลัพธ์เหล่านั้นทิ้งไปเฉย ๆ จะช่วยให้จับข้อผิดพลาดได้ง่ายขึ้น (เช่น การปฏิเสธซัพพลายเออร์ที่รับประกันว่าสินค้าจะถึงภายใน 14 วันตามปฏิทิน เพียงเพราะไม่ได้ใช้คำว่า “สองสัปดาห์”)
ตรวจทานงานที่จุดตรวจสอบ
สำหรับงานที่ยาวขึ้น ให้กำหนดจุดตรวจสอบไว้ในคำค้นหา:
“เริ่มจากหาซัพพลายเออร์ที่เป็นตัวเลือก 20 ราย แล้วหยุด ฉันจะยืนยันรายชื่อก่อนที่คุณจะรวบรวมข้อมูลราคา”
ตรวจสอบรายชื่อที่คัดเลือกแล้วเทียบกับคำสั่งเดิม แก้ไขสิ่งที่ผิดพลาดในข้อความติดตามผล แล้วให้เอเจนต์ทำงานต่อ ข้อผิดพลาดที่ตรวจพบ ณ จุดนี้จะไม่ส่งต่อไปยังทุกขั้นตอนหลังจากนั้น
เริ่มงานใหม่เมื่องานออกนอกเส้นทาง
หากเอเจนต์ยังทำผิดซ้ำเดิมหลังจากได้รับการแก้ไขแล้ว ให้เริ่มงานใหม่ การแก้ไขแต่ละครั้งจะเพิ่มข้อความเข้าไปในบริบทที่ยาวอยู่แล้ว ให้สร้างงานใหม่แทน ระบุคำสั่งอีกครั้ง อัปโหลดผลลัพธ์ที่ดีจากความพยายามครั้งแรก แล้วเริ่มต้นใหม่
เอเจนต์บางตัวทำสิ่งนี้ในรูปแบบหนึ่งโดยอัตโนมัติ ซึ่งเป็นกระบวนการที่เรียกว่าการบีบอัดบริบท (compaction) เมื่องานยาวขึ้น เอเจนต์จะแทนที่เนื้อหาเก่า เช่น ข้อความฉบับเต็มของหน้าที่อ่านไว้ในช่วงแรก ด้วยบทสรุปสั้น ๆ ของสิ่งที่พบ Portable Computer ของ Perplexity บีบอัดบริบทด้วยวิธีนี้ เพื่อให้โมเดลทำงานอยู่ภายในปริมาณที่จัดการได้ดี
การเริ่มงานใหม่ก็สำคัญเช่นกันหากเป้าหมายเปลี่ยนไป เธรดที่เริ่มต้นจากการค้นหาซัพพลายเออร์ไม่ควรกลายเป็นการตรวจทานสัญญาไปด้วย
เปลี่ยนคำสั่งที่ใช้ซ้ำให้เป็น Skill
คำสั่งบางอย่างจะปรากฏในงานประเภทหนึ่งทุกครั้ง เช่น รูปแบบตารางที่ต้องการ รายชื่อผู้ขายที่ควรหลีกเลี่ยง หรือขั้นตอนการตรวจทานมาตรฐาน ใน Computer คุณสามารถบันทึกคำสั่งเหล่านี้เป็น Skill ซึ่งเป็นชุดคำสั่งที่ใช้ซ้ำได้และเอเจนต์จะปฏิบัติตามทุกครั้ง Skill จะผสานแนวทางปฏิบัติที่ดีที่สุดอื่น ๆ เข้าไปในทุกงานที่ใช้ Skill นั้น
วิธีตั้งค่า:
- เลือกงานที่ทำบ่อย เช่น การวิจัยซัพพลายเออร์
- จดคำสั่งที่ให้ทุกครั้ง ได้แก่ รูปแบบ การตรวจสอบ และแหล่งข้อมูลที่ควรใช้หรือควรหลีกเลี่ยง
- บันทึกคำสั่งเหล่านั้นเป็น Skill คำสั่งที่เขียนไว้ในรูปแบบ Markdown อยู่แล้วสามารถนำเข้าได้โดยตรง
- ระบุชื่อ Skill ในคำค้นหาครั้งต่อไป: “ใช้ Skill การวิจัยซัพพลายเออร์เพื่อหาซัพพลายเออร์เก้าอี้สำหรับสำนักงานที่เดนเวอร์”
แนวทางของ Perplexity ในการจัดการบริบทในงานของเอเจนต์
Perplexity Computer จัดการงานที่ยาวด้วยวิธีที่ทำให้บริบทของแต่ละโมเดลมีขนาดเล็กและเกี่ยวข้อง การออกแบบสามส่วนช่วยจำกัดปริมาณข้อมูลที่โมเดลต้องอ่านในคราวเดียว
แบ่งงานให้เอเจนต์ย่อย
Computer แบ่งคำขอออกเป็นงานและงานย่อย จากนั้นจึงสร้างเอเจนต์ย่อยขึ้นมาดำเนินการ เอเจนต์ย่อยแต่ละตัวทำงานในส่วนหนึ่งของงานภายในบริบทของตัวเอง ในงานหาซัพพลายเออร์ เอเจนต์ย่อยตัวหนึ่งอาจค้นคว้าเรื่องราคา ขณะที่อีกตัวตรวจสอบเงื่อนไขการจัดส่ง ไม่มีตัวใดต้องอ่านทุกอย่างที่อีกตัวอ่าน
เก็บงานไว้ในไฟล์
งานแต่ละงานของ Computer จะมีพื้นที่ทำงานของตัวเอง พร้อมไฟล์ เว็บเบราว์เซอร์ และเครื่องมือของตัวเอง เอเจนต์สามารถบันทึกงานลงในไฟล์ได้ เช่น ตารางที่อัปเดตต่อเนื่องของซัพพลายเออร์ที่ตรวจสอบแล้ว จากนั้นจะเปิดไฟล์นั้นอีกครั้งเฉพาะเมื่อจำเป็นเท่านั้น
คัดเลือกข้อความที่เกี่ยวข้องจากผลการค้นหา
หน้าเว็บเต็มไปด้วยเนื้อหาที่โมเดลไม่จำเป็นต้องใช้ เช่น เมนู โฆษณา เมตาดาต้า และข้อความในหัวข้ออื่น การบีบอัดบริบทโดยคำนึงถึงคำค้นหาจะตัดเนื้อหาเหล่านั้นออก ก่อนที่หน้าเว็บจะไปถึงโมเดล Perplexity จะเก็บไว้เฉพาะประโยคที่เกี่ยวข้องกับคำค้นหาเท่านั้น
สำรวจเคล็ดลับ คู่มือ และตัวอย่างงานสำหรับ Perplexity Computer เพื่อนำขั้นตอนเหล่านี้ไปใช้จริง
คำถามที่พบบ่อย
การเสื่อมของบริบทเป็นสิ่งเดียวกับอาการหลอน (hallucination) หรือไม่?
ไม่ใช่ แต่ทั้งสองมีความเกี่ยวข้องกัน อาการหลอนคือคำตอบใดก็ตามที่ระบุสิ่งที่ไม่เป็นความจริงหรือไม่มีหลักฐานรองรับ การเสื่อมของบริบทเป็นหนึ่งในภาวะที่ทำให้เกิดอาการหลอน รวมถึงข้อผิดพลาดอื่น ๆ เช่น การเพิกเฉยต่อคำสั่งและการพลาดรายละเอียด ได้ง่ายขึ้น
คำค้นหาที่ดีขึ้นช่วยแก้ปัญหาการเสื่อมของบริบทได้หรือไม่?
คำค้นหาที่ชัดเจนช่วยลดการเสื่อมของบริบทได้ด้วยการทำให้งานมีจุดมุ่งเน้น แต่ก็ไม่สามารถหยุดไม่ให้บริบทขยายตัวได้ ในงานที่ยาวพอ เอเจนต์ก็ยังรวบรวมข้อมูลมากเกินกว่าที่จะใช้ได้อย่างมีประสิทธิภาพ นี่คือเหตุผลที่การแบ่งงานและการตรวจสอบงานไปตลอดทางมีความสำคัญไม่น้อยไปกว่าตัวคำค้นหาเอง
นอกจากเอเจนต์แล้ว การเสื่อมของบริบทส่งผลต่อการแชทกับ AI ทั่วไปด้วยหรือไม่?
ใช่ ในแชท บริบทคือบทสนทนาทั้งหมดจนถึงตอนนี้ รวมถึงทุกข้อความและเอกสารที่วางหรืออัปโหลดเข้ามา เธรดที่ดำเนินมาหลายชั่วโมงในหลายหัวข้ออาจทำให้เกิดข้อผิดพลาดแบบเดียวกับงานของเอเจนต์ที่ยาว การเริ่มเธรดใหม่สำหรับหัวข้อใหม่ช่วยให้แต่ละบทสนทนามีจุดมุ่งเน้น
งานยาวได้แค่ไหนก่อนที่การเสื่อมของบริบทจะเริ่มเกิดขึ้น?
ไม่มีจุดที่ตายตัว ขึ้นอยู่กับโมเดลและงาน ตัวอย่างเช่น โมเดลที่ทำงานบนอุปกรณ์ซึ่งมีหน้าต่างบริบทขนาด 260,000 โทเค็นเริ่มทำงานได้ไม่ดีเมื่อเกินประมาณ 100,000 โทเค็น ซึ่งยังห่างจากขีดจำกัดอยู่มาก นอกจากนี้ ประสิทธิภาพยังลดลงทีละน้อย ไม่ได้ลดลงอย่างฉับพลัน