
Cách theo dõi và kiểm soát chi tiêu token của nhóm
Cách các nhóm có thể xem mức sử dụng token trong bảng điều khiển và báo cáo, những loại công việc AI nào sử dụng nhiều token nhất và cách dùng các công cụ kiểm soát để giảm mức sử dụng.
Chi tiêu token là gì
Chi tiêu token là số lượng token mà một nhóm tiêu thụ khi sử dụng AI và chi phí của số token đó. Token là một đơn vị văn bản, chẳng hạn như một từ, một phần của từ hoặc một dấu câu, mà mô hình AI đọc hoặc viết. Trong tiếng Anh, 1 token tương đương khoảng 4 ký tự. Token không được chuẩn hóa giữa các mô hình hay nhà cung cấp, vì vậy cùng một đoạn văn bản có thể cho ra số lượng token khác nhau trong các công cụ khác nhau.
Báo cáo mức sử dụng thường chia token thành một vài loại:
- Token đầu vào là mọi thứ mà mô hình đọc cho một yêu cầu. Bao gồm truy vấn, mọi văn bản đính kèm và lịch sử hội thoại mà mô hình sử dụng lại từ các tin nhắn trước đó trong cùng một chuỗi.
- Token đầu ra là phản hồi mà mô hình viết ra. Loại token này thường đắt hơn token đầu vào. Trong bảng giá API của Perplexity, một số mô hình tính phí đầu ra cao gấp sáu lần.
- Token suy luận là văn bản mà mô hình tạo ra nội bộ để giải quyết vấn đề trước khi trả lời. Chúng không xuất hiện trong câu trả lời, vì vậy một phản hồi hiển thị dài hơn không nhất thiết có nghĩa là mô hình đã sử dụng nhiều token hơn về tổng thể.
Các nhóm sử dụng công cụ AI theo gói đăng ký hiếm khi thấy khoản phí tính theo từng token. Tuy vậy, token vẫn quyết định những gì họ nhận được, vì các tác vụ nặng hơn sẽ tiêu hao tín dụng hoặc chạm giới hạn sử dụng nhanh hơn. Ngược lại, các nhóm tự xây dựng công cụ trên một mô hình AI thường trả tiền theo từng token, theo hình thức định giá dựa trên mức sử dụng.
Cách theo dõi chi tiêu token
Theo dõi chi tiêu token trên gói đăng ký
Các công cụ theo gói đăng ký thường không hiển thị số lượng token. Thay vào đó, nhiều gói sử dụng tín dụng, tức là các đơn vị trả trước mà gói sẽ trừ dần khi công việc được thực hiện. Tín dụng không giống với token, vì một tín dụng có thể dùng cho văn bản, hình ảnh hoặc các loại công việc khác. Nhưng các tác vụ sử dụng nhiều token hơn thường cũng tiêu tốn nhiều tín dụng hơn, nên tín dụng là thước đo tốt nhất cho chi tiêu token trên gói đăng ký. Người dùng có thể theo dõi mức sử dụng tín dụng của riêng mình, và một số gói còn có bảng điều khiển quản trị hiển thị mức sử dụng tín dụng của cả nhóm.
Ví dụ, trong Perplexity, các lượt tìm kiếm thông thường không sử dụng tín dụng. Chỉ Perplexity Computer, trợ lý xử lý các tác vụ nhiều bước, mới sử dụng tín dụng. Người dùng Computer có thể xem họ đã sử dụng bao nhiêu tín dụng và đã dùng chúng vào việc gì. Mỗi tác vụ Computer cũng hiển thị tổng số tín dụng riêng trong menu "Mức sử dụng" của cuộc hội thoại tương ứng.
Trên các gói Enterprise, quản trị viên có thể xem có bao nhiêu người sử dụng Perplexity và số lượng truy vấn họ thực hiện mỗi tuần trong bảng điều khiển Insights (dành cho các tổ chức có từ 50 chỗ ngồi trở lên hoặc có ít nhất một thành viên Enterprise Max).
Theo dõi chi tiêu token trong báo cáo mức sử dụng API
Báo cáo mức sử dụng của nhà cung cấp API hiển thị trực tiếp số lượng token, thường được chia theo loại token. Ví dụ, bảng điều khiển API Platform của Perplexity cho phép người dùng theo dõi các chỉ số như chi tiêu token đầu vào, đầu ra và suy luận trên trang Thanh toán.
Vì sao chi tiêu token ngày càng tăng
Các tác nhân chạy nhiều bước cho mỗi tác vụ, và mỗi bước là một yêu cầu riêng gửi đến mô hình. Một tác vụ có thể tiêu tốn tới hàng trăm nghìn, thậm chí hàng triệu token.
Các mô hình suy luận cũng ngày càng phổ biến. Mô hình suy luận viết ra quá trình suy nghĩ của mình trước khi trả lời, và mọi từ trong đó đều được tính là token. Vì vậy, cùng một yêu cầu thường sử dụng nhiều token trên mô hình suy luận hơn so với trên mô hình tiêu chuẩn, dù câu trả lời trên màn hình trông có độ dài như nhau.
Cuối cùng, khi ngày càng có nhiều người và quy trình làm việc sử dụng AI nói chung, mức sử dụng token cũng tăng lên theo. Một phần mức tăng này còn đến từ tokenmaxxing, khi các kỹ sư chạy tác nhân chủ yếu để tăng số lượng token cá nhân và leo hạng trên các bảng xếp hạng token nội bộ.
Cách giảm chi tiêu token
Phần lớn chi tiêu token cao đến từ một vài loại công việc tiêu tốn nhiều token hơn so với vẻ bề ngoài.
Cuộc hội thoại dài và tác vụ của tác nhân
Mỗi lần trả lời, mô hình thường đọc lại toàn bộ cuộc hội thoại tính đến thời điểm đó. Mỗi yêu cầu mới bao gồm toàn bộ lịch sử hội thoại trước đó cùng với tin nhắn hiện tại của người dùng. Vì vậy, một câu hỏi ngắn ở cuối một chuỗi dài sẽ sử dụng nhiều token hơn so với cùng câu hỏi đó trong một chuỗi mới. Tác vụ của tác nhân cũng hoạt động theo cách tương tự, vì mỗi bước sẽ thêm kết quả của nó vào lịch sử mà bước tiếp theo phải đọc lại.
Cách khắc phục
- Bắt đầu cuộc hội thoại mới khi chủ đề thay đổi. Mở đầu bằng một bản tóm tắt dài hai hoặc ba dòng về những thông tin từ chuỗi cũ mà mô hình vẫn cần.
- Chia các tác vụ dài của tác nhân thành những tác vụ nhỏ hơn. Chạy từng phần như một tác vụ riêng và chỉ chuyển tiếp những kết quả mà phần tiếp theo cần.
- Kiểm tra xem các công cụ tác nhân của nhóm có sử dụng tính năng nén ngữ cảnh hay không. Tính năng nén tự động tóm tắt các phần cũ hơn của tác vụ để mô hình phải đọc lại ít hơn. Nếu công cụ cung cấp tùy chọn này trong phần cài đặt, hãy bật tùy chọn đó.
Cùng một tài liệu bị xử lý lặp đi lặp lại
Khi ai đó đính kèm cùng một tệp dài, chẳng hạn như sổ tay chính sách hoặc danh mục sản phẩm, vào nhiều truy vấn riêng biệt, mô hình sẽ đọc toàn bộ tệp mỗi lần. Mỗi lần đọc đều được tính là token đầu vào.
Cách khắc phục
- Hướng dẫn người dùng sao chép phần liên quan của sổ tay hoặc danh mục vào yêu cầu thay vì đính kèm toàn bộ tệp.
- Tạo phiên bản rút gọn của những tài liệu mà nhóm thường xuyên sử dụng. Một bản tóm tắt dài một trang của một chính sách dài có thể thay thế cho tài liệu đầy đủ trong các truy vấn thông thường.
Thử lại và vòng lặp
Khi câu trả lời không đáp ứng đúng nhu cầu và người dùng chạy lại tác vụ, mỗi lần thử đều tiêu tốn token. Điều tương tự cũng xảy ra khi một tác nhân bị kẹt và lặp lại cùng một bước.
Cách khắc phục
- Nêu rõ tác vụ, kết quả mong muốn và nguồn thông tin ngay trong yêu cầu đầu tiên. Ví dụ: "Tóm tắt những lý do chính khiến khách hàng hủy dịch vụ trong quý 3, chỉ sử dụng kết quả khảo sát đính kèm, trình bày trong năm gạch đầu dòng."
- Kiểm tra vài bước đầu tiên của tác vụ tác nhân. Nếu tác nhân lặp lại cùng một bước hoặc cùng một lượt tìm kiếm, hãy dừng lại và khởi động lại với yêu cầu cụ thể hơn.
Dùng mô hình lớn cho tác vụ đơn giản
Các mô hình mạnh hơn thường có giá cao hơn cho mỗi token, nên những công việc thường ngày như tóm tắt hay định dạng lại có thể tiêu hết ngân sách của nhóm nhanh hơn mức cần thiết.
Cách khắc phục
- Sử dụng định tuyến mô hình, tức là ghép mỗi tác vụ với một mô hình có thể xử lý tác vụ đó. Một yêu cầu viết lại hoặc tóm tắt ngắn có thể được chuyển đến một mô hình nhỏ hơn, rẻ hơn, còn mô hình mạnh nhất được dành cho các tác vụ suy luận hoặc phân tích nhiều bước. API của Perplexity áp dụng cách tiếp cận này thông qua các preset, vốn gán một mô hình nhỏ hơn cho các tra cứu nhanh và một mô hình lớn hơn cho các phân tích toàn diện.
Mức tăng đột biến sau khi áp dụng quy trình làm việc mới
Một quy trình làm việc tự động mới, hoặc một công cụ được triển khai cho cả nhóm, có thể khiến mức sử dụng tăng vọt chỉ sau một đêm. Bản thân mức tăng đột biến không phải là vấn đề, nhưng bạn nên biết công việc nào đã gây ra nó.
Cách khắc phục
- Thử nghiệm quy trình làm việc mới với một nhóm nhỏ trước. Kiểm tra mức sử dụng của họ trong một hoặc hai tuần trước khi triển khai quy trình làm việc đó cho cả nhóm.
- Đặt ngân sách hằng tháng cho từng nhóm. Xác định ngân sách dựa trên mức sử dụng của một tháng điển hình để dễ nhận ra khi có mức tăng đột ngột.
- Tắt tính năng tự động nạp lại. Khi tắt tính năng này, công việc sẽ dừng lại khi hết tín dụng thay vì tự động mua thêm tín dụng.
Cách tối ưu hóa chi tiêu token trong Perplexity
Đối với việc sử dụng hằng ngày
Computer sử dụng tín dụng, nhưng chỉ chạy khi bạn chọn dùng, bằng cách chọn biểu tượng Computer, làm việc trong một dự án được đặt mặc định là Computer hoặc sử dụng chế độ Work của Comet.
Để quay lại tìm kiếm thông thường, hãy chọn biểu tượng Perplexity để chuyển về chế độ Hỏi. Để xem mức sử dụng tín dụng, người dùng có thể mở công cụ theo dõi ngay trong giao diện Perplexity.
Các nhóm làm việc trong dự án, không gian làm việc dùng chung của Perplexity, có thể đặt chế độ mặc định của từng dự án là Tìm kiếm hoặc Computer. Một dự án chủ yếu dùng cho nghiên cứu nhanh có thể đặt mặc định là Tìm kiếm, để không ai vô tình bắt đầu một tác vụ Computer.
Dành cho quản trị viên Enterprise
- Nắm rõ quyền lợi đi kèm mỗi chỗ ngồi. Người dùng Enterprise Pro nhận 500 tín dụng mỗi tháng, còn người dùng Enterprise Max nhận 15.000 tín dụng. Số tín dụng này hết hạn vào cuối mỗi chu kỳ hằng tháng và không được chuyển sang chu kỳ sau.
- Trước tiên, hãy đặt giới hạn sử dụng mặc định. Giới hạn sử dụng quy định số tín dụng bổ sung tối đa mà một thành viên có thể lấy từ nguồn tín dụng dùng chung khi đã dùng hết phần được phân bổ của mình.
- Tạo các giới hạn có tên cho những loại người dùng khác nhau. Quản trị viên có thể thiết lập các giới hạn như "Tiêu chuẩn", "Người dùng chuyên sâu" và "Nhà thầu", rồi gán chúng cho các nhóm người dùng hoặc từng thành viên. Nhóm có thể được tạo trong Perplexity hoặc đồng bộ hóa từ nhà cung cấp danh tính của công ty. Nếu một người thuộc nhiều nhóm, giới hạn cao nhất sẽ được áp dụng.
- Sử dụng giới hạn ghi đè cá nhân cho các trường hợp ngoại lệ. Khi một người cần mức giới hạn khác với nhóm của họ, giới hạn ghi đè cá nhân sẽ được ưu tiên hơn mọi giới hạn nhóm hoặc giới hạn dùng chung. Điều này hữu ích cho một dự án ngắn hạn cần nghiên cứu nhiều mà không phải nâng giới hạn cho cả nhóm.
- Đặt mức trần cho tính năng tự động nạp lại. Tính năng tự động nạp lại sẽ tự động bổ sung tín dụng vào nguồn dùng chung. Tính năng này đi kèm giới hạn nạp lại hằng tháng có thể tùy chỉnh, nên chi tiêu không thể tăng vượt quá mức tối đa đã đặt.
- Quyết định cách thành viên yêu cầu thêm tín dụng. Cài đặt Cho phép thành viên yêu cầu thêm tín dụng giúp những người đã chạm giới hạn có thể yêu cầu thêm tín dụng từ quản trị viên, thay vì bị chặn hoàn toàn.
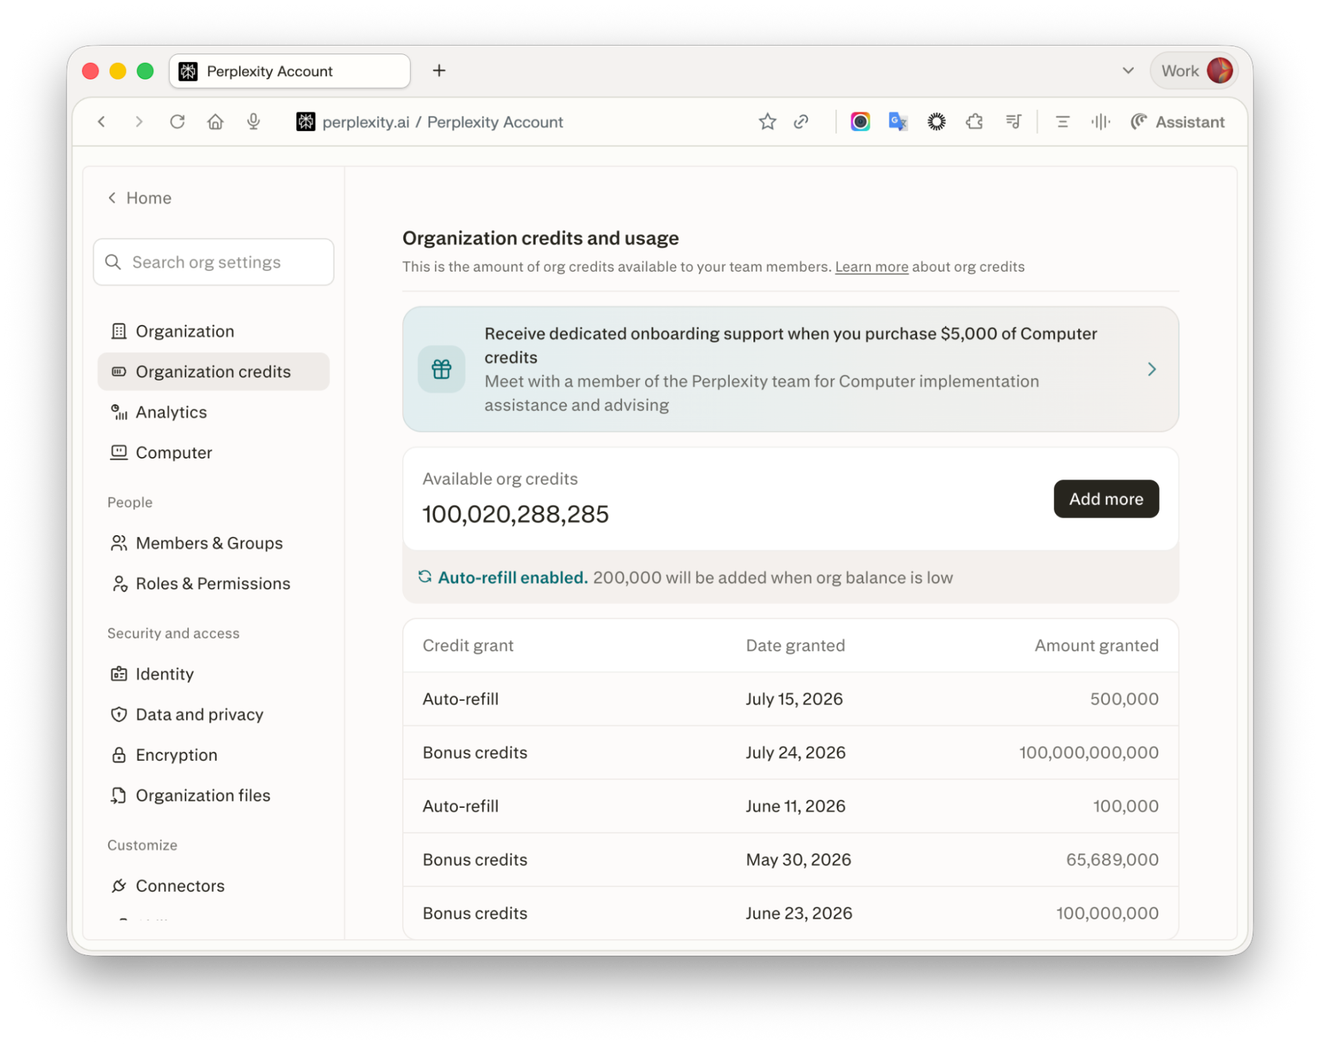
- Xem xét mức sử dụng hằng tháng. Trang Tín dụng của tổ chức hiển thị số tín dụng đã cấp, đã sử dụng và còn lại của từng thành viên, cùng với giới hạn nhóm và số dư của nguồn tín dụng dùng chung. Đối với các tổ chức có từ 50 chỗ ngồi trở lên hoặc có ít nhất một thành viên Enterprise Max, bảng điều khiển Insights còn hiển thị thêm số người dùng hoạt động hằng tháng và số truy vấn hằng tuần theo thời gian. Để biết thêm chi tiết, nhật ký kiểm toán ghi lại việc thực thi tác vụ, mức sử dụng trình kết nối, mức tiêu thụ tín dụng và việc cấp tín dụng.
Dành cho các nhóm xây dựng trên API
- Cấp cho mỗi công cụ hoặc nhóm một khóa API riêng. Perplexity có thể hiển thị thông tin thanh toán riêng cho từng khóa, và các khóa riêng biệt giúp bạn biết rõ công cụ nào đang làm tăng mức sử dụng.
- Kiểm tra trang thanh toán để xem loại token nào đang tăng. Trang này hiển thị token đầu vào, đầu ra và suy luận theo thời gian. Token đầu vào tăng thường có nghĩa là một công cụ đang gửi nhiều văn bản hơn mức cần thiết. Token suy luận tăng có nghĩa là các tác vụ đang chạy trên những mô hình suy luận về vấn đề lâu và kỹ lưỡng hơn.
- Sử dụng Search API khi một công cụ chỉ cần kết quả tìm kiếm. API này trả về kết quả web mà không cần mô hình viết câu trả lời, đồng thời tính phí theo từng yêu cầu và không có thêm khoản phí nào tính theo token.
- Khởi chạy công cụ tác nhân từ một preset. Các preset của Perplexity chọn mô hình có quy mô phù hợp với quy mô của tác vụ và tránh để các yêu cầu đơn giản chạy trên những mô hình đắt nhất.
Làm việc ưu tiên cục bộ
Một số công việc hoàn toàn không cần đến mô hình đám mây trả phí. Portable Computer là một phiên bản tác nhân của Perplexity chạy trên máy tính của chính người dùng, sử dụng mô hình AI được lưu trữ trên máy đó. Vì mô hình chạy cục bộ nên các công việc thường ngày không tiêu tốn token trả phí. Tác nhân chỉ kết nối với web, các ứng dụng được kết nối hoặc một mô hình đám mây mạnh hơn khi tác vụ cần, và sẽ hỏi ý kiến người dùng trước.
Khám phá cách Perplexity Computer xử lý công việc nhiều bước trên web, tệp và các công cụ được kết nối.
Câu hỏi thường gặp
Chi tiêu token khác gì so với chi phí AI?
Chi tiêu token đo lường khối lượng công việc AI mà một nhóm thực hiện, được tính bằng token. Chi phí AI bao gồm mọi khoản mà một nhóm chi trả để sử dụng AI, gồm gói đăng ký, tín dụng bổ sung và chi phí thiết lập. Chi tiêu token quyết định phần tính theo mức sử dụng trong hóa đơn đó.
Người dùng gói đăng ký có trả tiền theo từng token không?
Thường là không trực tiếp. Các công cụ theo gói đăng ký theo dõi mức sử dụng bằng tin nhắn, truy vấn hoặc tín dụng, và các tác vụ sử dụng nhiều token hơn sẽ tiêu hao những hạn mức này nhanh hơn. Trên Perplexity, các lượt tìm kiếm thông thường hoàn toàn không sử dụng tín dụng; chỉ các tác vụ Computer mới sử dụng.
Vì sao tác nhân AI sử dụng nhiều token như vậy?
Tác nhân hoàn thành một tác vụ qua nhiều bước, và mỗi bước là một yêu cầu riêng phải đọc lại toàn bộ công việc đã làm đến thời điểm đó. Vì vậy, một tác vụ dài sẽ sử dụng nhiều token hơn sau mỗi bước.
Vì sao mức sử dụng token đột ngột tăng vọt?
Phần lớn các đợt tăng đột biến xảy ra sau một thay đổi trong cách nhóm làm việc, chẳng hạn như một quy trình làm việc tự động mới, một công cụ được triển khai cho nhiều người hơn hoặc một tác vụ dài của tác nhân. So sánh ngày xảy ra đợt tăng đột biến với các lần ra mắt gần đây thường sẽ cho thấy nguyên nhân. Thử nghiệm quy trình làm việc mới với một nhóm nhỏ trước sẽ giúp ngăn ngừa các đợt tăng đột biến.