
AI 记忆:是什么、如何运作以及存储哪些内容
AI 记忆指南:AI 助手如何保存和调取过往对话中的详细信息、它们会存储哪些内容、记忆会在哪些方面出错,以及如何查看、编辑或关闭记忆。
AI 记忆是对话式 AI 助手从你过去的对话中保存下来、并带入新对话的信息,以便它能记住你的偏好和上下文。模型本身并不保留任何这些信息。助手会单独存储这些信息,并在相关时重新添加进来,从而为模型提供原本缺乏的持久上下文。
本指南介绍助手如何保存和调用这些信息、存储哪些内容、为何有时会出错,以及如何查看、更改或关闭这些信息。
什么是 AI 记忆?
AI 记忆,也称为持久记忆,是指 AI 助手的一项功能,它会存储关于你的信息,例如偏好、事实以及过去互动中的上下文,助手可以在之后的对话中使用这些信息。
AI 助手可以通过以下来源建立这份记录:你要求它记住的内容、它自行获取的细节,以及它可以回溯参考的早期聊天。
AI 记忆层让 AI 助手无需你在每次聊天中重复说明偏好,就能提供个性化的回答。如果你告诉过助手你正在为马拉松训练,并且偏好使用公里,那么下次你询问配速问题时,无需重复说明,就会得到以公里为单位的回答。
与在每次聊天中重新说明自身情况相比,记忆能为你省去输入,并让提示词保持简短。这一点很重要,因为过长的输入会降低回答的准确性。
记忆并不是每次对话的完整记录,而是关于你的关键事实的集合。因此,它会记住你偏好使用公里。至于能否找到它上个月起草的具体训练计划,则取决于助手是否还能查找过去的聊天。
AI 记忆的类型
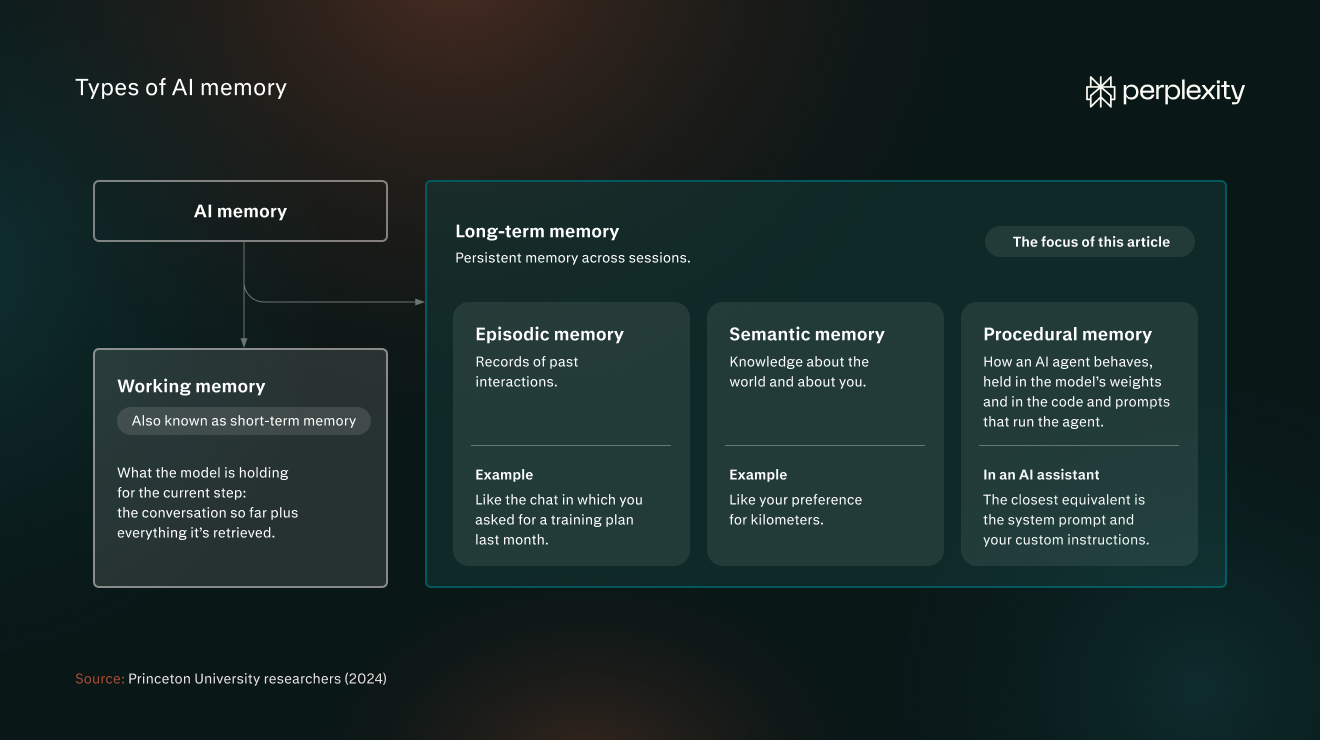
普林斯顿大学的研究人员(2024 年)借用了人类记忆科学的术语,对 AI 记忆系统的类型进行了分类。他们的框架将工作记忆与长期记忆区分开来:
- 工作记忆:模型在当前步骤中保留的内容,即到目前为止的对话以及它检索到的所有内容。也称为短期记忆。
- 长期记忆:跨会话的持久记忆。这正是本文讨论的记忆类型。
长期记忆包括三种记忆类型:
- 情景记忆:过去互动的记录,例如你上个月请求制定训练计划的那次聊天。
- 语义记忆:关于世界和关于你的知识,例如你偏好使用公里。
- 程序记忆:AI 智能体的行为方式,固化在模型权重中,以及运行该智能体的代码和提示词中。在 AI 助手中,最接近的对应物是系统提示词和你的自定义指令。
AI 助手记忆与 AI 智能体记忆
AI 助手记忆和 AI 智能体记忆都属于长期记忆。AI 助手记忆主要是语义记忆,存储关于你的事实,使回答更贴合你。智能体记忆(例如 Perplexity 的 Brain)则存储智能体做了什么以及效果如何,包括哪些做法有效、你纠正了什么,因此它在开始每项新任务时都能处于更有利的起点。
AI 助手记忆 | AI 智能体记忆 | |
记住什么 | 你 | 任务及其历史 |
用途 | 贴合你的回答 | 继续多步骤工作,无需从头开始 |
示例 | 记住你偏好使用公里 | 记住你的马拉松训练计划、它所做的调整以及你目前已完成的训练课,以便更好地规划后续训练周期 |
AI 记忆与上下文窗口、训练数据和自定义指令的比较
AI 记忆很容易与影响回答的另外三样东西混淆:模型的上下文窗口、训练数据和自定义指令。它们各自保存不同的信息,持续时间不同,并由不同的系统控制。
上下文窗口是大语言模型(LLM)一次能够读取的文本量,涵盖当前对话。当你开始新聊天时,它会重置。
一些现有模型拥有一百万个 token 或更大的上下文窗口,因此从技术上讲,你可以把关键信息粘贴到每次对话中。但处理所有这些信息会增加延迟和成本。
多项研究还发现,即使答案就在上下文中,输出准确性也会随着输入增长而下降。
2025 年伊利诺伊大学和亚马逊的一项研究发现,即使模型能够复述每一个相关细节,这种情况依然存在:当输入增长到 30,000 个 token(远低于模型宣称的上限)时,准确率下降了 13.9% 至 85%。NoLiMa 是 Adobe Research 和慕尼黑大学(LMU Munich)于 2025 年推出的基准测试,它发现,只要问题和答案没有共同的关键词,13 个受测模型中就有 11 个在仅 32,000 个 token 时表现明显不佳。Chroma 2025 年 7 月的报告在 18 个模型中都观察到了这一现象,包括它们基于 113,000 个 token 的聊天历史作答时。
训练数据是模型发布前固化在模型权重中的信息。用户无法更改它。开发者可以使用新数据对模型进行微调,但这是一个工程过程,而非用户设置,
自定义指令是保存在助手设置中的规则,由你自己编写和编辑,用于自定义 AI 助手的行为和输出。例如,你可以使用自定义指令来定义回答的语气和风格,或者助手可以使用哪些来源。
以下是这四者的比较:
上下文窗口 | AI 记忆 | 训练数据 | 自定义指令 | |
保存的内容 | 当前聊天中的消息 | 已保存的关于你的事实和偏好 | 模型在发布前学到的内容 | 你自己编写的指导 |
持续时间 | 仅限本次聊天 | 直到被更新或删除 | 固定不变,直到新模型发布 | 直到你编辑它 |
由谁控制 | 你,在模型提供商设定的限制范围内。 | 你和助手 | AI 公司 | 你 |
示例 | 你一分钟前问的配速问题 | 你偏好使用公里 | 马拉松训练计划通常如何构建 | 将训练计划格式化为表格的指令,其中行代表周,列代表一周中的各天 |
AI 记忆存储哪些内容
助手会保留关于你的部分细节,例如事实、偏好和摘要,有些助手还会参考你过去的聊天。
- 你要求它记住的事实和偏好:这些是你明确告诉助手要保存的细节,例如“记住我偏好使用公里”。助手会在你提出要求时创建该记忆,并一直保留,直到你删除它或之后的对话更新了它。
- 它从你的对话中获取的细节:开启该设置后,助手会保存这些细节。Perplexity“更看重用户提问的频率和提供的信息”,因此你经常提到的内容比只提过一次的内容更有可能被记住。该记忆会一直保留,直到被更新或被你删除。
- 对你过去聊天的引用:助手直接参考之前的对话,而不是参考已保存的列表。Perplexity 将其称为搜索历史:即你过去的问题和回答,用于让新的回复更具相关性。
AI 记忆的工作原理
AI 模型在不同对话之间不会记住任何内容。这项工作由 AI 记忆系统完成:它单独保存一份关于你的记录,并将相关部分添加到每次新对话中。存储和检索在后台进行,因此模型会将它们与你的问题一起读取。
该过程分为五个步骤:
- 保存:当你要求助手保存记忆,或助手判断某个细节值得保留时,它就会保存一条记忆。
- 存储:记忆会存入独立于模型的数据库中。在许多系统中,这是一个向量数据库,因此可以按含义搜索这些记忆。你在设置中看到的列表就是该记忆存储的一个视图。
- 检索:当你发送消息时,助手会决定哪些记忆适用。许多系统的做法是将你的消息和每条记忆转换为嵌入(即含义的数值表示),然后挑选最接近的匹配项。正因如此,即使某条记忆与你的问题没有任何共同词语,它们也能调用这条记忆。较简单的系统则会将每条已保存的记忆加载到每次对话中。
- 使用:调用的记忆会以纯文本形式插入到输入中,通常位于模型在读取你的消息之前读取的指令块中。模型会像处理该输入中的任何其他文本一样处理它们。
- 更新和删除:助手从聊天中提取事实,搜索现有记忆,然后决定是将其作为新记忆添加、更新现有记忆、与某条记忆合并,还是删除与新发现相矛盾的旧记忆。有些助手会为每条记忆添加时间戳,以区分较新和较旧的信息。
AI 记忆的挑战和风险
AI 记忆旨在提高回答质量,但基准测试表明,记忆检索并不总能找出相关或最新的信息,尤其是在大型数据库中。它还会带来安全和隐私风险。
与 AI 记忆相关的常见可靠性和安全问题包括:
- 记忆误用:一条记忆可能被引入到与它毫不相关的回答中。2026 年的一项研究测试了 18 个模型,考察保存的某个生活领域的记忆是否会泄露到另一个领域的回答中。失败率中位数为 53%。该研究还发现,一旦记忆中保存了用户的观点或其自称的专业知识,即使问题需要中立的回答,几乎所有模型也都会附和这些内容。
- 过时的记忆:即使之后的对话已经让某个细节不再属实,助手仍会继续依据它行事,尤其是在你从未明确说明的情况下。在2026 年 5 月的一项基准测试中(该测试考察模型能否察觉此类隐性变化),表现最好的模型平均得分为 55.2%。
- 记忆过载:助手需要回读的内容越多,就越难挑出重要信息。2024 年的基准测试 LongMemEval 发现,读取约 115,000 个 token 聊天历史的模型,其表现比只获得相关会话的模型差 30% 至 60%。
- 记忆投毒:虚假信息或隐藏指令进入助手的记忆(例如通过你要求它读取的内容),导致产生有偏见或不安全的回答,或造成数据泄露。
- 隐私风险:记忆会在其来源聊天之外保留个人详细信息,有时保留时间比你预期的更长。例如,出于安全和调试目的,Perplexity 可能会将已删除记忆的日志保留最多 30 天。数据保护法将存储的记忆视为个人数据,因此你应当能够查看和删除它们。
如何查看、编辑和关闭 AI 记忆
你可以查看助手保存了哪些内容、将其删除、关闭记忆,或使用不会创建记忆的私密聊天。
记忆管理归根结底就是几项控制。以下是每项控制的作用及使用时机:
控制项 | 作用 | 使用时机 |
查看已保存的内容 | 打开你的记忆库,你可以在其中搜索、筛选和查看各个条目。 | 当回答中包含你意想不到的细节时。 |
删除记忆 | 删除该条目,助手在之后的回答中将不再使用它(助手可能会在一段时间内保留已清除记忆的日志)。 | 当某条记忆有误、过时或敏感时。 |
关闭记忆 | 让助手在今后的回答中不再参考记忆(这可能不会清除已存储的记忆——请查看你的助手)。 | 当你希望获得非个性化的回答时 |
关闭搜索历史 | 让助手不再使用你过去的问题和回答。从搜索历史中删除某个会话后,它将不再影响之后的回答。 | 如果过往对话正在左右回答,你就需要重新开始。 |
使用无痕聊天 | 记忆和搜索历史始终处于关闭状态,在其中提出的问题永远不会被保留或用于记忆。 | 适用于一次性或敏感话题。 |
若想彻底重新开始,请关闭记忆并清除已存储的内容。
Perplexity 如何处理记忆
Perplexity 记忆适用于其提供的所有模型。
Perplexity 基于两个来源为你个性化回答:记忆(即你分享的偏好和详细信息)以及你的搜索历史。当某条记忆影响了回答时,它会显示在该回答的来源中,因此你可以查看使用了哪些记忆,并删除其中任意一条。
你还可以通过提供关于你自己的详细信息,以及为项目提供自定义指令来个性化你的回答(每个项目都有自己的记忆层)。
Perplexity 可能会使用消费者账户中的记忆内容来改进其模型(绝不会用于 Enterprise 账户),除非你关闭该功能(位于“设置 → 偏好设置 → 人工智能”中的“AI 数据保留”)。
Max 和 Enterprise Max 订阅用户还可使用 Brain,这是一个共享记忆层,它在记忆的基础上进一步追踪你的项目和工作。它有独立的开关,并且会忽略无痕会话。
试用 Perplexity,看看记忆如何影响你的下一个回答。
AI 记忆常见问题
AI 中的有限记忆是什么?
根据 IBM 的定义,有限记忆 AI 是指能够回忆过往事件和结果、持续监测情况,但无法将这些数据保存在长期过往经验库中的 AI。它是 AI 系统分类法中的四个类别之一,IBM 将聊天机器人和虚拟助手归入此类。
助手记忆是这些系统在其基础上额外添加的外部记忆。它可跨会话保留,因此助手可以使用你在之前对话中分享的详细信息。
哪款 AI 助手的记忆功能最好?
没有哪款助手对所有人都是最好的。好的记忆是你能够掌控的记忆,因此评估 AI 工具时,可以问四个问题:你能看到它保存了什么吗?你能否将某条记忆与其来源聊天分开删除?训练是否是独立于记忆的单独设置?是否有不会创建任何记忆的临时模式或无痕模式?
AI 模型会从它记住的关于你的信息中学习吗?
在回答中使用记忆与训练是不同的过程。Perplexity 表示,它会从你的记忆存储中检索相关上下文,而不是将你的历史记录视为训练数据。你的内容是否可用于改进模型,是一项单独的设置。在消费者账户中,Perplexity 可能会将记忆内容用于该目的,而“AI 数据保留”可将其关闭。
哪些内容不应存入 AI 记忆?
任何你不希望被存储、被用于对你进行画像或日后被重复提及的内容,都不应存入 AI 记忆:身份和财务信息、健康信息、密码、他人信息,以及任何与儿童有关的内容。加拿大隐私专员办公室(2025 年 5 月)和英国国家网络安全中心(2023 年 3 月)建议,避免输入任何一旦公开就会引发问题的提示词。
过滤器可以降低隐私风险,但无法保证你的健康或财务信息完全不会被存储,因此请检查你的记忆库,并在提出一次性敏感问题时使用无痕模式。