
AI 智能体中的上下文腐化:长任务为何会丧失准确度,以及如何预防
本指南介绍 AI 智能体的上下文中会积累哪些内容、这些内容为何会损害准确度,以及如何设置能保持可靠的任务。
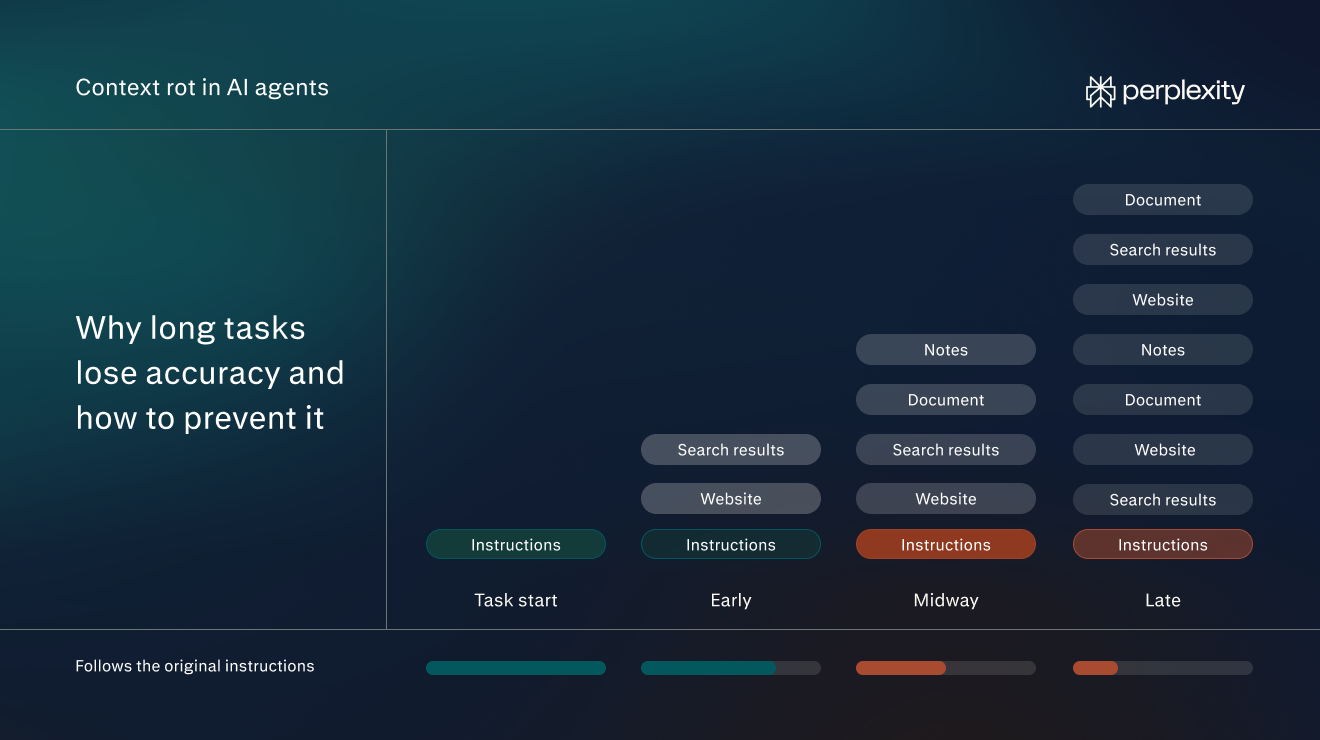
上下文腐化对 AI 智能体意味着什么
AI 智能体中的上下文腐化,是指智能体在执行长任务的过程中,随着上下文逐渐被填满而出现的准确度逐步下降。
智能体的上下文是模型在执行下一步时可用的信息,可能包括指令、之前的消息、搜索结果,以及来自网站或文件的文本。随着智能体不断工作,它还可能添加更多内容。
例如,假设智能体的任务是找到能在两周内交货的供应商。一开始,它的上下文中只有这一请求。任务进行到一半时,上下文中还会包含数十个供应商网站的文本、好几页搜索结果,以及关于智能体已核查过哪些供应商的笔记。
模型能容纳的上下文是有上限的(称为上下文窗口)。窗口以 token 为单位计量,token 是很小的文本片段,通常是一个单词或单词的一部分。上下文腐化会随着上下文增长而加剧,这也是它最常出现在包含许多步骤的长任务中的原因。
随着上下文腐化加剧,智能体的准确度会下降。它可能不再那么严格地遵循最初的指令、忽略细节,或者把看起来相似的信息误当作所需的信息。
例如,即使智能体被要求寻找两周内交货的供应商,它也可能开始把需要六周的供应商纳入其中。这条指令仍在它的上下文中,但已不再左右智能体的选择。
上下文腐化并不等同于上下文窗口空间耗尽。当任务的上下文超出窗口时,部分内容会被截断,或者任务直接失败。而上下文腐化早在那之前、所有内容仍能容纳时就已开始。
它也不同于上下文投毒(即误导性或有害的信息进入智能体的上下文)。即使智能体掌握的信息准确且完整,仍可能出现上下文腐化。
上下文腐化为何会发生
上下文腐化之所以发生,是因为模型的注意力有限,即使其上下文窗口仍有富余空间也是如此。在 AI 模型中,注意力是一个技术术语,指模型在写出回答的每个词时,如何决定借助输入中的哪些部分。上下文的每个部分都在争夺这份注意力。文本越多,每个部分获得的注意力就越少。
例如,Chroma 发表了一项关于输入长度如何影响 AI 模型的研究。该研究测试了来自 Anthropic、OpenAI、Google 和 Alibaba 的 18 个模型。在其中一项测试中,研究人员把一句关于写作建议的话藏在一大批长篇文章中,然后询问模型这条建议是什么。
他们多次进行这项测试,每次都增加更多文章文本。那句话和问题始终不变,变化的只有它们周围的文本量。
模型需要读取的文本越多,表现就越差。这一发现在报告中的每项测试里都成立。研究人员预测,在需要许多步骤的实际工作中(比如大多数智能体任务),准确度的下降幅度还会更大。
上下文腐化会如何影响 AI 智能体
上下文腐化通常会以下列四种方式之一表现出来:
渐渐忘记最初的指令
Chroma 最简单的测试要求模型原样复制一长串重复的单词,其中某处插入了一个不同的单词。这是一项指令明确的简单任务。即便如此,随着文本变长,所有模型的表现都有所下降。有些模型甚至开始输出输入中根本没有的单词。
在智能体任务中,用户通常会在任务开始时设定具体的约束条件,例如预算或所需格式。随着上下文增长,智能体执行这些约束的一致性可能会下降。其原因在于上下文的整体长度,而不在于指令所处的位置。
遗漏任务中段的细节
根据2023 年斯坦福大学的一项研究,当信息位于输入的最开头或最末尾时,AI 模型对其利用得最可靠。在一项测试中,研究人员给模型提供一组 20 份文档,并提出一个只有其中一份文档能够回答的问题。当这份文档排在第一个或最后一个时,模型通常都能找到答案;而当它位于这组文档的中间时,模型漏掉答案的频率要高得多。研究人员将这种现象称为位置效应。
同样的规律也适用于智能体。任务早期找到的信息可能位于一段长对话的中间,一些模型在利用这类信息时会更加困难。在供应商示例中,最终名单可能会遗漏智能体在任务中途核查过的一家优质供应商。
混淆相似的信息
随着上下文增长,智能体可能越来越难以识别哪些信息符合其指令。例如,假设用户让智能体寻找“两周内”发货的供应商。某个供应商的网站上写着“下单后 14 个自然日内送达”。在简短的任务中,智能体很可能会发现两者意思相同。但当这条信息淹没在数十个其他供应商页面中时,它就更有可能错过这一匹配。
另一种情况是,智能体可能开始纳入不相关的结果。假设智能体正在寻找办公椅供应商。某个供应商的网站承诺两周内交货,但仅限于办公桌,其椅子则需要六周。由于该网站使用了与指令相同的措辞,智能体仍可能把这家供应商加入名单。研究人员把这类信息称为干扰项:它看起来相关,实际上并不相关,因而会与真正重要的信息相互竞争。
Chroma 的研究发现,随着周围文本量的增加,这两个问题都会变得更严重。
难以察觉的错误
上下文腐化不会触发错误消息。智能体会继续工作,并交付看似已完成的输出。这使得它的错误很容易被忽视。
在 Chroma 的测试中,这些错误有两种形式。有时,模型会自信地给出错误答案。在供应商调研示例中,智能体可能会交付一份整洁、格式规范的供应商名单,但其中包含一家它误读了交货条款的供应商。
另一些时候,模型会声称找不到实际上存在的信息。例如,智能体可能会交付一份报告,称没有供应商能满足两周的期限,而实际上有好几家都满足。
如何设置智能体任务以减少上下文腐化
正确设置任务可以将上下文腐化的影响降到最低,并让智能体在整个任务过程中尽可能保持准确。以下最佳实践会有所帮助。
像布置工作一样撰写任务
明确的工作要求能让上下文保持精简。智能体知道何时算完成,因此一旦收集到足够的材料就会停止。具体的要求还为它提供了逐页核对的具体标准,使智能体更容易发现正确的信息。
发送任务之前,请确认它涵盖以下三项内容:
- 任务:智能体应该做什么、产出什么,例如“查找供应商并返回一份候选名单”。
- 要求:智能体无法自行猜到的事实,例如预算、截止日期、送货地址以及结果的使用对象。
- 输出:格式、长度和结构,例如“一个包含名称、每把椅子价格和交货时间的表格”。
综合起来,这个供应商任务的查询可能如下所示:
“找到 10 家能在两周内将 40 把办公椅送到我们芝加哥办公室的供应商,每把椅子价格低于 250 美元。返回一个表格,包含供应商名称、每把椅子价格、交货时间和产品页面链接。该名单供我们的办公室经理使用,由其负责下单。”
让每个任务保持聚焦
一个任务只设一个明确目标,可以让上下文保持精简。长任务的成本也更高。每一步都要处理到目前为止收集的所有内容,因此臃肿的上下文在每一步都会消耗更多积分。
如果项目包含多个部分,请将其拆分:
- 列出各项独立的交付成果,例如供应商搜索、价格比较,以及发给选定供应商的电子邮件。
- 将每项交付成果作为单独的任务运行。
- 只将一个任务的最终结果传递给下一个任务。例如,将供应商表格作为文件上传来启动比较任务,而不是在生成该表格的问题中继续操作。
这样,比较任务开始时只有一个表格,而不是所有页面。
为智能体指明正确的来源
智能体读取的每个页面都会增加其上下文,包括有用部分周围的菜单、广告和模板化内容。直接向智能体提供来源,可以减少这类干扰信息。
将任务所依赖的文件(例如已批准的供应商名单)附加到查询中进行上传。当智能体需要搜索网络时,指明值得搜索的网站,例如两个可信的供应商目录。
连接信息所在的工具。例如,在 Perplexity Computer 中,打开侧边栏中的“连接器”,并启用任务所需的应用,例如 Google Drive 或 Slack。然后在查询中提及它们:“使用我们 Google Drive 中的椅子规格。”只连接相关的应用,因为每个连接器都会占用智能体的一部分上下文。
如果信息所在的应用不在“连接器”列表中,仍有可能将其连接。许多应用都提供 MCP(Model Context Protocol,模型上下文协议)连接器,这是 AI 工具接入其他软件的一种标准方式。Computer 可以将这些连接器与其内置连接器一起使用。在公司账户中,可能需要管理员先启用它们。
要求最后对照指令进行检查
在查询末尾加上一个审核步骤,列出最重要的约束条件:
“完成之前,请对照以下要求检查每家供应商:两周内交货,每把椅子低于 250 美元。对于不符合这些要求的供应商,请标记出来,而不是直接将其剔除。”
约束条件仍然位于上下文的开头。审核步骤让智能体有理由将最终输出与约束条件进行比较,而不是指望这些指令在每一步中都保持其影响力。
同时,要求它标记问题而不是直接删除这些结果,可以让错误更容易被发现(例如,仅仅因为某家供应商没有使用“两周”这一措辞,就拒绝了这家承诺在 14 个自然日内送达的供应商)。
在检查点审核工作
对于较长的任务,在查询中设置一个检查点:
“先找出 20 家候选供应商,然后停下来。在你收集报价之前,我会先确认名单。”
对照最初的指令检查候选名单。在后续消息中纠正任何偏差,然后让智能体继续。在这个阶段发现的错误,就不会延续到之后的每一步。
任务偏离方向时,开始新任务
如果智能体在纠正后仍重复同样的错误,请开始一个新任务。每次纠正都会给本已很长的上下文添加更多文本。因此,请改为创建一个新任务:重新说明指令,上传第一次尝试中的优质输出,然后重新开始。
有些智能体会自动执行类似的操作,这一过程称为压缩。当任务变长时,智能体会用其发现内容的简短摘要,替换较早的材料(例如早期读取的页面全文)。Perplexity 的 Portable Computer 就以这种方式压缩上下文,让模型的上下文保持在它能妥善处理的范围之内。
如果目标发生变化,同样有必要开始一个新任务。一个以供应商搜索开始的问题,不应再转而用于合同审核。
将重复使用的指令变成技能
有些指令在某类任务中每次都会出现,例如偏好的表格格式、需要避开的供应商名单或标准审核步骤。在 Computer 中,这些指令可以保存为技能,即智能体每次都会遵循的一套可复用指令。技能会把其他最佳实践融入每个使用它的任务中。
设置方法如下:
- 选择一项经常出现的任务,例如供应商调研。
- 写下每次都会给出的指令:格式、检查项,以及要使用或避开的来源。
- 将它们保存为技能。已用 Markdown 编写的指令可以直接导入。
- 在之后的查询中指明该技能:“使用供应商调研技能,为丹佛办公室寻找椅子供应商。”
Perplexity 如何处理智能体工作中的上下文
Perplexity Computer 处理长任务的方式能让每个模型的上下文保持精简且相关。其设计中有三个部分限制了模型一次需要读取的内容量。
将工作拆分给子智能体
Computer 会将请求拆分为任务和子任务,然后创建子智能体来执行。每个子智能体在各自的上下文中处理工作的一部分。在供应商任务中,一个子智能体可能负责调研价格,另一个则核查交货条款。双方都无需读取对方读过的全部内容。
将工作保存在文件中
每个 Computer 任务都有自己的工作区,包括独立的文件、网页浏览器和工具。智能体可以将工作保存到文件中,例如一份持续更新的已核查供应商表格。之后只有在需要时,它才会再次打开该文件。
从搜索结果中挑选相关段落
网页中充斥着模型不需要的内容,例如菜单、广告、元数据以及其他主题的文本。查询感知的上下文压缩会将这些内容剔除。在页面送达模型之前,Perplexity 只保留与查询相关的句子。
浏览Perplexity Computer 的技巧、指南和示例任务,将这些步骤付诸实践。
常见问题
上下文腐化和幻觉是一回事吗?
不是,但两者有关联。幻觉是指任何陈述错误或缺乏依据内容的回答。上下文腐化是让幻觉更容易出现的条件之一,它同样会让忽略指令、遗漏细节等其他错误更容易发生。
更好的查询能解决上下文腐化吗?
清晰的查询能让任务保持聚焦,从而减少上下文腐化。但它无法阻止上下文增长。任务足够长时,智能体收集的内容仍会超出它能有效利用的范围,这就是为什么拆分工作并在过程中进行检查,与查询本身同样重要。
上下文腐化是否也会影响普通的 AI 聊天,而不仅仅是智能体?
会。在聊天中,上下文就是到目前为止的整段对话,包括每条消息以及粘贴或上传到其中的任何文档。一个持续了数小时、涉及多个话题的问题,可能会产生与长时间智能体任务相同的错误。为新话题开启一个新问题,可以让每段对话保持聚焦。
任务进行到多长时会开始出现上下文腐化?
没有固定的临界点,这取决于模型和任务。例如,上下文窗口为 26 万 token 的端侧模型,在超过约 10 万 token 后就开始吃力,远未达到其上限。而且这种下降是渐进的,而非突然发生。