
如何追踪和控制团队 Token 支出
团队如何在仪表板和报告中查看 token 用量、哪些类型的 AI 工作消耗 token 最多,以及如何利用管控措施降低用量。
什么是 Token 支出
Token 支出是指团队使用 AI 时消耗的 token 数量,以及这些 token 的费用。Token 是 AI 模型读取或写入的文本单位,例如一个单词、单词的一部分或一个标点符号。在英语中,1 个 token 大约相当于 4 个字符。不同模型或提供商对 token 的划分并没有统一标准,因此同一段文本在不同工具中可能会得出不同的计数。
用量报告通常会将 token 分为以下几种类型:
- 输入 token 是模型处理一次请求时读取的全部内容,包括查询本身、所有附加文本,以及模型从同一问题的前文中重复使用的对话历史。
- 输出 token 是模型写出的回复内容,其价格通常高于输入 token。在 Perplexity 的 API 定价中,部分模型的输出价格是输入价格的六倍。
- 推理 token 是模型在回答之前,为解决问题而在内部生成的文本。这些内容不会出现在回答中,因此,可见的回复更长并不一定意味着模型总共使用了更多 token。
以订阅方式使用 AI 工具的团队很少会看到按 token 计算的费用。但 token 仍然会影响他们能获得多少服务,因为更繁重的任务会更快地耗尽积分或触及用量上限。而基于 AI 模型自行构建工具的团队,通常则是在按用量计费模式下按 token 付费。
如何追踪 Token 支出
在订阅方案中追踪 Token 支出
订阅类工具通常不会显示 token 计数。许多方案改用积分,即一种预付单位,方案会随着工作的完成而逐步扣减积分。积分并不等同于 token,因为一个积分可以涵盖文本、图像或其他工作。不过,使用更多 token 的任务通常也会消耗更多积分,因此积分是衡量订阅方案中 token 支出的最佳参考。用户可以追踪自己的积分使用情况,部分方案还提供管理员仪表板,用于显示整个团队的积分使用情况。
以 Perplexity 为例,常规搜索不消耗积分。只有处理多步骤任务的助手 Perplexity Computer 才会消耗积分。使用 Computer 的用户可以查看自己已使用的积分数量以及这些积分的用途。每个 Computer 任务也会在其对话的“用量”菜单中显示该任务的积分总数。
在 Enterprise 方案中,管理员可以在 Insights 仪表板中查看有多少人在使用 Perplexity,以及他们每周运行的查询数量(适用于拥有 50 个或以上席位,或至少有一名 Enterprise Max 成员的组织)。
在 API 用量报告中追踪 Token 支出
API 提供商的用量报告会直接显示 token 计数,并通常按 token 类型分类。例如,在 Perplexity 的 API Platform 控制台中,用户可以在“账单”页面追踪输入、输出和推理 token 支出等指标。
Token 支出为何不断增长
智能体在执行每个任务时会运行许多步骤,而每个步骤都是对模型的一次单独请求。一个任务累计下来可能消耗数十万甚至数百万个 token。
推理模型也日益普及。推理模型会在回答之前写出其思考过程,而其中的每一个字都会计入 token。因此,同一请求在推理模型上消耗的 token 通常比在标准模型上更多,即使屏幕上显示的回答长度看起来相同。
最后,随着越来越多的人员和工作流开始使用 AI,token 用量也会不断累积。其中一部分增长还来自“tokenmaxxing”,即工程师运行智能体主要是为了提高个人 token 计数,从而在内部 token 排行榜上名列前茅。
如何降低 Token 支出
大部分高额 token 支出都来自少数几类工作,它们实际消耗的 token 比表面上看起来要多。
长对话和智能体任务
模型每次回复时,通常都会重新读取截至目前的整个对话。每个新请求都包含之前所有的对话历史以及当前的用户消息。因此,在一个很长的问题中靠后提出的简短提问,会比在新问题中提出同样的提问消耗更多 token。智能体任务也是如此,因为每个步骤都会将其结果添加到历史记录中,供下一步重新读取。
应对方法
- 话题改变时,请开启新对话,并在开头用两三行文字总结旧问题中模型仍需了解的内容。
- 将较长的智能体任务拆分为多个较小的任务。将每个部分作为独立任务运行,并只向下一部分传递其所需的结果。
- 检查团队的智能体工具是否使用上下文压缩。压缩功能会自动总结任务中较早的部分,从而减少模型需要重新读取的内容。如果工具将其作为一项设置提供,请将其开启。
反复处理相同的文档
如果有人在许多单独的查询中附加同一个长文件(例如政策手册或产品目录),模型每次都会读取整个文件。每次读取都会计入输入 token。
应对方法
- 培训用户将手册或目录中的相关章节复制到请求中,而不是附加整个文件。
- 为团队常用的文档制作简短版本。在日常查询中,一份长篇政策的一页摘要即可替代完整文档。
重试和循环
如果回答不符合需求而重新运行任务,每一次尝试都会消耗 token。当智能体陷入重复执行同一步骤的循环时,也会出现同样的情况。
应对方法
- 在第一次请求中就明确说明任务、预期结果和信息来源。例如:“仅根据所附的调查结果,用五个要点总结第三季度客户取消服务的主要原因。”
- 检查智能体任务的前几个步骤。如果智能体重复执行同一步骤或同一搜索,请将其停止,并以范围更窄的请求重新开始。
用大模型处理简单任务
能力更强的模型通常每个 token 的价格更高,因此用它们处理摘要或重新排版等日常工作,可能会不必要地加快团队预算的消耗。
应对方法
- 使用模型路由,为每项任务匹配能够胜任的模型。简短的改写或摘要可以交给更小、更便宜的模型处理,而能力最强的模型则留给多步骤推理或分析使用。Perplexity 的 API 通过其预设采用了这种方法:快速查询分配给较小的模型,详尽分析则分配给较大的模型。
新工作流上线后的用量激增
新的自动化工作流,或向整个团队推出的工具,可能会让用量在一夜之间飙升。激增本身并不是问题,但有必要了解是哪些工作导致了激增。
应对方法
- 先在小范围群体中测试新工作流。在将工作流推广到整个团队之前,先观察他们一到两周的用量。
- 为每个团队设定月度预算。以典型月份的用量为基准,这样一旦用量激增就会很明显。
- 关闭自动充值。关闭自动充值后,积分用完时工作就会停止,而不会自动购买更多积分。
如何在 Perplexity 中优化 Token 支出
日常使用
Computer 会消耗积分,但只有在你选择它时才会运行,方式包括:选择 Computer 图标、在默认使用 Computer 的项目中工作,或使用 Comet 工作模式。
如需返回常规搜索,请选择 Perplexity 图标切换回提问模式。如需查看积分使用情况,用户可以在 Perplexity 界面中打开积分追踪器。
在 Perplexity 的共享工作区项目中工作的团队,可以将每个项目的默认模式设置为搜索或 Computer。主要用于快速研究的项目可以默认使用搜索,这样就不会有人意外启动 Computer 任务。
面向 Enterprise 管理员
- 了解每个席位包含的内容。Enterprise Pro 用户每月可获得 500 积分的配额,Enterprise Max 用户则可获得 15,000 积分。这些积分会在每个月度周期结束时过期,不会结转。
- 首先设置默认用量限额。用量限额用于限制成员在自身配额用完后,可以从共享池中额外提取的积分数量。
- 为不同类型的用户创建命名限额。管理员可以设置“标准”“高级用户”和“承包商”等限额,并将其分配给用户组或个人成员。用户组可以在 Perplexity 中创建,也可以从公司的身份提供商同步。如果某人同时属于多个用户组,则适用最高的限额。
- 针对例外情况使用个人覆盖设置。当某人需要与其所在用户组不同的上限时,个人覆盖设置的优先级高于任何用户组限额或共享限额。这对于需要大量研究的短期项目非常有用,而且无需提高整个团队的上限。
- 为自动充值设置上限。自动充值会自动为共享池补充积分,并提供可配置的每月充值限额,因此支出不会在没有设定上限的情况下持续增长。
- 决定成员如何申请更多积分。启用“允许成员申请更多积分”设置后,达到限额的成员可以向管理员申请更多积分,而不会被直接阻止使用。
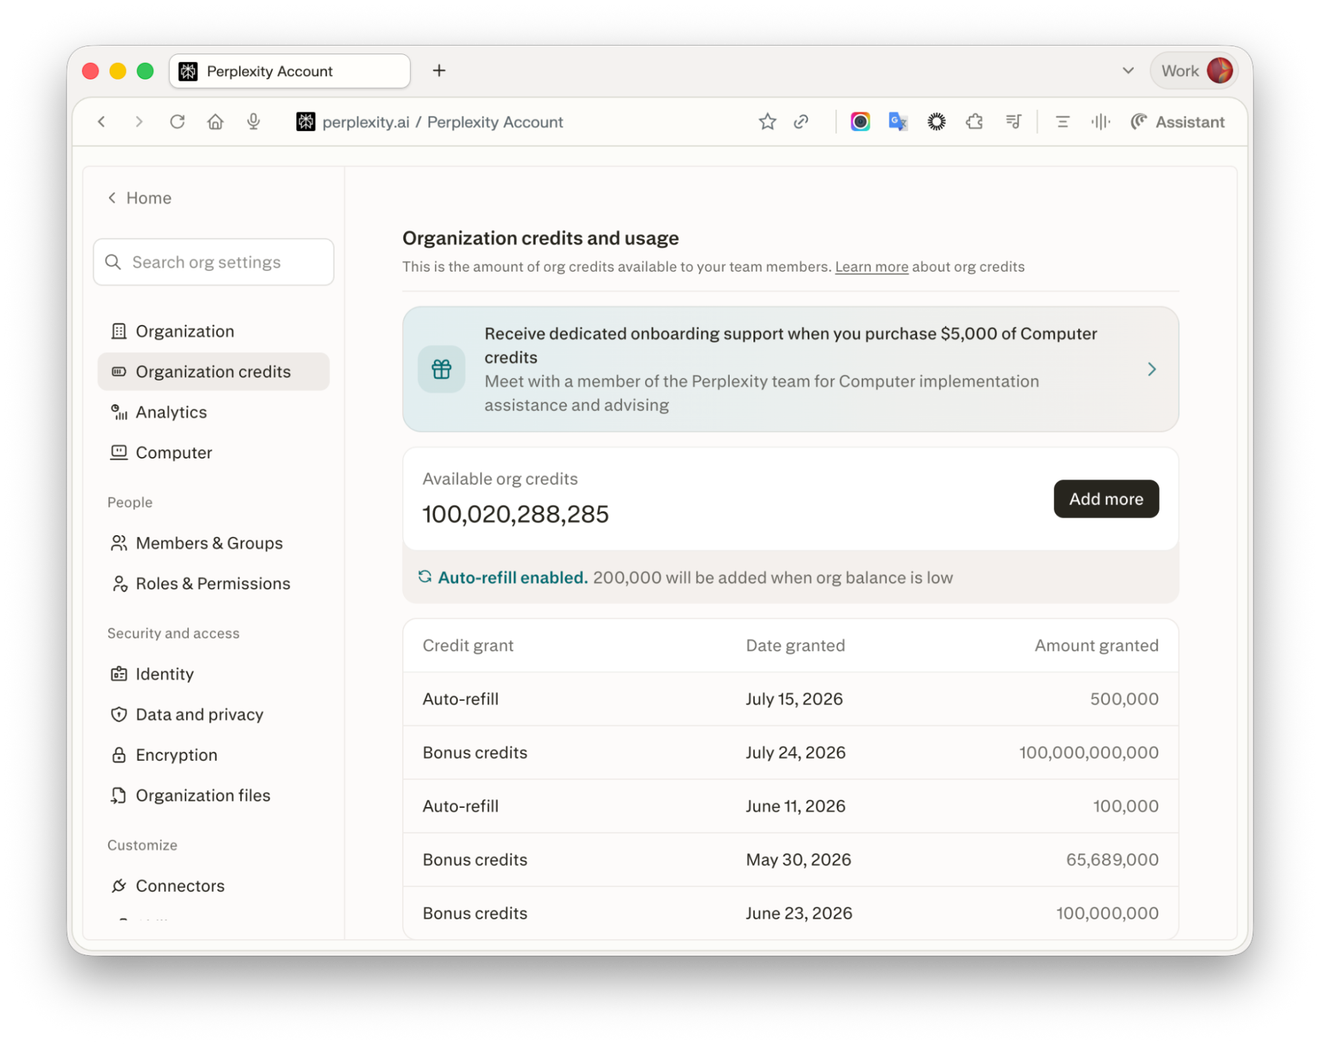
- 每月审查用量。“组织积分”页面会显示每位成员已获得、已使用和剩余的积分,以及用户组限额和积分池余额。对于拥有 50 个或以上席位,或至少有一名 Enterprise Max 成员的组织,Insights 仪表板还会显示月活跃用户数和每周查询数随时间的变化。如需了解更多详情,审计日志会记录任务执行、连接器使用、积分消耗和积分发放情况。
面向基于 API 构建的团队
- 为每个工具或团队分配独立的 API 密钥。Perplexity 可以分别显示每个密钥的账单,而独立的密钥可以清楚地表明是哪个工具在推动用量增长。
- 在账单页面查看哪类 token 在增长。该页面会显示输入、输出和推理 token 随时间的变化。输入 token 增加通常意味着某个工具发送的文本超出了实际需要。推理 token 增加则意味着任务正在使用会对问题进行长时间思考的模型。
- 当工具只需要搜索结果时,请使用 Search API。它会直接返回网页结果,无需模型撰写回答,并且按请求计费,不会额外收取基于 token 的费用。
- 基于预设启动智能体工具。Perplexity 的预设会根据任务规模匹配相应规模的模型,避免将简单请求交给最昂贵的模型处理。
本地优先的工作
有些工作根本不需要付费的云端模型。Portable Computer 是 Perplexity 智能体的一个版本,可在用户自己的电脑上运行,并使用存储在该设备上的 AI 模型。由于模型在本地运行,日常工作不会消耗付费 token。只有在任务需要时,它才会访问网络、已连接的应用或更强大的云端模型,并且会事先征求用户的同意。
探索 Perplexity Computer 如何处理多步骤工作,涵盖网络、文件和已连接的工具等各个方面。
常见问题
Token 支出和 AI 成本有什么区别?
Token 支出衡量的是团队完成了多少 AI 工作,以 token 计算。AI 成本涵盖团队使用 AI 所支付的全部费用,包括订阅费、额外积分和配置部署费用。Token 支出决定了其中按用量计费的那部分费用。
订阅用户需要按 token 付费吗?
通常不会直接按 token 付费。订阅类工具以消息数、查询数或积分来追踪用量,而消耗更多 token 的任务会更快地用完这些额度。在 Perplexity 上,常规搜索完全不消耗积分,只有 Computer 任务才会消耗。
为什么 AI 智能体会消耗这么多 token?
智能体需要通过许多步骤来完成一项任务,而每个步骤都是一次单独的请求,需要重新读取截至目前的工作内容。因此,长任务每多执行一步,消耗的 token 就会更多。
为什么 token 用量会突然激增?
大多数激增都源于团队工作方式的变化,例如新的自动化工作流、向更多人推出的工具,或者长时间运行的智能体任务。将激增的日期与最近的上线情况进行比较,通常就能找到原因。先在小范围群体中测试新工作流,有助于防止用量激增。