
Памет на ИИ: какво представлява, как работи и какво съхранява
Ръководство за паметта на ИИ: как ИИ асистентите запазват и припомнят подробности от минали разговори, какво съхраняват, къде паметта се проваля и как да я преглеждате, редактирате или изключите.
Паметта на ИИ е информацията, която разговорен ИИ асистент запазва от предишните ви разговори и пренася в новите, за да може да помни вашите предпочитания и контекст. Самият модел не съхранява нищо от нея. Асистентът я пази отделно и я добавя отново, когато е релевантна, което дава на модела постоянен контекст, който иначе не би имал.
Това ръководство обяснява как асистентите запазват и извличат тази информация, какво съхраняват, защо понякога грешат и как да я прегледате, промените или изключите.
Какво е памет на ИИ?
Паметта на ИИ, наричана още постоянна памет, е функция на ИИ асистентите, която съхранява информация за вас – например предпочитания, факти и контекст от предишни взаимодействия, – която асистентът може да използва в следващи разговори.
ИИ асистентът може да изгради този запис от неща, които го молите да запомни, подробности, които забелязва сам, и предишни чатове, към които може да се връща.
Слоят памет на ИИ позволява на ИИ асистентите да дават персонализирани отговори, без да споделяте предпочитанията си във всеки чат. Ако сте казали на асистента, че тренирате за маратон и предпочитате километри, следващият ви въпрос за темпото ще получи отговор в километри, без да се налага да го повтаряте.
В сравнение с това да описвате ситуацията си отново във всеки чат, паметта ви спестява писане и поддържа промпта кратък, което е важно, защото дългите входни данни правят отговорите по-малко точни.
Паметта не е стенограма на всеки разговор, а колекция от ключови факти за вас. Така тя ще помни, че предпочитате километри. Дали ще бъде намерен точният тренировъчен план, изготвен миналия месец, зависи от това дали асистентът може да търси и в предишни чатове.
Видове памет на ИИ
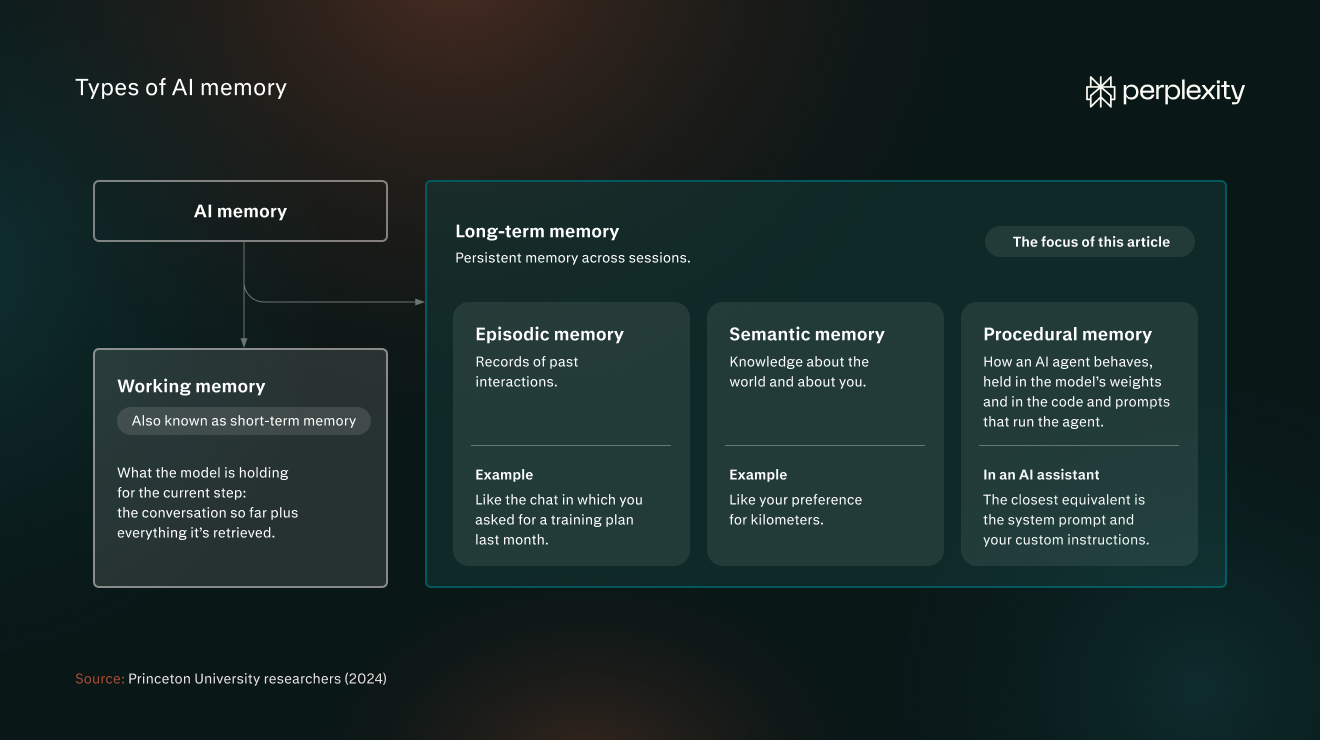
Изследователи от Принстънския университет (2024) са заимствали терминология от науката за човешката памет, за да класифицират видовете системи за памет на ИИ. Тяхната рамка разграничава работната памет от дългосрочната:
- Работна памет: Това, което моделът държи за текущата стъпка – досегашния разговор плюс всичко, което е извлякъл. Известна още като краткосрочна памет.
- Дългосрочна памет: Постоянна памет между сесиите. Това е видът памет, на който е посветена тази статия.
Дългосрочната памет се състои от три вида памет:
- Епизодична памет: Записи на минали взаимодействия, например чатът, в който миналия месец сте поискали тренировъчен план.
- Семантична памет: Знания за света и за вас, например предпочитанието към километри.
- Процедурна памет: Как се държи ИИ агентът – заложено в теглата на модела, както и в кода и промптовете, които управляват агента. При ИИ асистента най-близкият еквивалент са системният промпт и вашите персонализирани инструкции.
Памет на ИИ асистент срещу памет на ИИ агент
И паметта на ИИ асистента, и паметта на ИИ агента са дългосрочна памет. Паметта на ИИ асистента е предимно семантична и съхранява факти за вас, така че отговорите да са съобразени с вас. Паметта на агента, като Brain на Perplexity, съхранява какво е направил агентът и как е протекло, включително какво е проработило и какво сте коригирали, така че той започва всяка нова задача от по-добра позиция.
Памет на ИИ асистент | Памет на ИИ агент | |
Какво помни | Вас | Задачата и нейната история |
За какво служи | Отговори, съобразени с вас | Продължаване на многоетапна работа, без да се започва отначало |
Пример | Помни, че предпочитате километри | Помни вашия тренировъчен план за маратон, промените, които е направил в него, и тренировките, които сте завършили досега, за да може да планира по-добре бъдещите блокове |
Памет на ИИ срещу контекстни прозорци, данни за обучение и персонализирани инструкции
Паметта на ИИ лесно се бърка с три други неща, които оформят отговора: контекстния прозорец на модела, данните за обучение и персонализираните инструкции. Всяко от тях съдържа различна информация, запазва се различно дълго и се управлява от различна система.
Контекстният прозорец е обемът текст, който голям езиков модел (LLM) може да прочете наведнъж, и обхваща текущия разговор. Той се нулира, когато започнете нов чат.
Някои съвременни модели имат големи контекстни прозорци от милион токена или повече, така че технически бихте могли да поставяте ключовата си информация във всеки разговор. Но обработката на цялата тази информация увеличава забавянето и разходите.
Множество проучвания са установили също, че точността на изхода намалява с нарастването на входа, дори когато отговорът се намира в контекста.
Проучване на Университета на Илинойс и Amazon от 2025 г. наблюдава това дори когато моделите могат да възпроизведат всяка релевантна подробност: точността спада с 13,9–85% при нарастване на входа до 30 000 токена – далеч под заявените лимити на моделите. NoLiMa, бенчмарк от 2025 г. на Adobe Research и LMU Мюнхен, установява, че 11 от 13-те тествани модела се представят значително по-слабо още при 32 000 токена, когато въпросът и отговорът нямат общи ключови думи. Докладът на Chroma от юли 2025 г. наблюдава това при 18 модела, включително когато отговарят въз основа на история на чат от 113 000 токена.
Данните за обучение са информацията, заложена в теглата на модела преди пускането му. Потребителите не могат да я променят. Разработчиците могат да дообучат модел с нови данни, но това е инженерен процес, а не потребителска настройка,
Персонализираните инструкции са правила, запазени в настройките на асистента, които сами пишете и редактирате, за да персонализирате поведението и резултатите на ИИ асистента. Например можете да използвате персонализирани инструкции, за да определите тона и стила на отговорите или какви източници може да използва асистентът.
Ето как се сравняват четирите:
Контекстен прозорец | Памет на ИИ | Данни за обучение | Персонализирани инструкции | |
Какво съдържа | Съобщенията в текущия чат | Запазени факти и предпочитания за вас | Какво е научил моделът преди пускането си | Насоки, които пишете сами |
Колко дълго се запазва | Само в този чат | Докато не бъде актуализирана или изтрита | Непроменливи до пускането на нов модел | Докато не ги редактирате |
Кой ги управлява | Вие, в рамките на лимита, зададен от доставчика на модела. | Вие и асистентът | Компанията за ИИ | Вие |
Пример | Въпросът за темпото, който зададохте преди минута | Че предпочитате километри | Как обикновено са структурирани тренировъчните планове за маратон | Инструкция тренировъчните планове да се форматират в таблица, в която редовете представляват седмици, а колоните – дни от седмицата |
Какво съхранява паметта на ИИ
Асистентите пазят избрани подробности за вас, като факти, предпочитания и обобщения, а някои се позовават и на предишните ви чатове.
- Факти и предпочитания, които го молите да запомни: Това са подробности, които изрично казвате на асистента да запази, например „запомни, че предпочитам километри“. Асистентът създава записа в паметта, когато поискате, и той се пази, докато не го изтриете или докато по-късен разговор не го актуализира.
- Подробности, които забелязва от разговорите ви: Асистентът ги запазва, когато настройката е включена. Perplexity „дава предимство на честотата на зададените въпроси и предоставената от потребителя информация“, така че нещо, което споменавате често, е по-вероятно да бъде запомнено, отколкото нещо, споменато веднъж. Записът в паметта се пази, докато не бъде актуализиран или докато не го изтриете.
- Препратки към предишните ви чатове: Асистентът се позовава директно на по-ранни разговори, а не на запазен списък. Perplexity нарича това история на търсенията: предишните ви въпроси и отговори, използвани, за да направят новия отговор по-релевантен.
Как работи паметта на ИИ
ИИ моделът не помни нищо между разговорите. Тази работа се върши от системата за памет на ИИ: тя поддържа отделен запис за вас и добавя релевантните части към всеки нов разговор. Съхранението и извличането се извършват зад кулисите, така че моделът ги чете заедно с вашия въпрос.
Този процес протича в пет стъпки:
- Запазване: Асистентът запазва запис в паметта, когато го помолите, или когато прецени, че дадена подробност си струва да бъде запазена.
- Съхранение: Записите в паметта отиват в база данни, поддържана отделно от модела. В много системи това е векторна база данни, така че в записите може да се търси по смисъл. Списъкът, който виждате в настройките, е изглед на това хранилище за памет.
- Извличане: Когато изпратите съобщение, асистентът решава кои записи в паметта са приложими. Много системи правят това, като преобразуват съобщението ви и всеки запис в ембединги – числови представяния на смисъла – и избират най-близките съвпадения. Така те могат да извлекат запис дори когато той няма общи думи с вашия въпрос. По-простите системи зареждат всички запазени записи в паметта във всеки разговор.
- Използване: Извлечените записи в паметта се вмъкват като обикновен текст във входа, обикновено в блок с инструкции, който моделът чете преди съобщението ви. Моделът ги обработва като всеки друг текст в този вход.
- Актуализиране и премахване: Асистентът извлича факти от чатовете, търси в съществуващите записи в паметта и решава дали да добави факта като нов, да актуализира съществуващ запис, да го обедини с някой от тях или да изтрие стар запис, който противоречи на новите данни. Някои асистенти поставят времеви печат на всеки запис, за да разграничават по-новата информация от по-старата.
Предизвикателства и рискове при паметта на ИИ
Паметта на ИИ има за цел да подобри качеството на отговорите, но бенчмарковете показват, че извличането от паметта не винаги открива релевантна или актуална информация, особено от големи бази данни. Тя също така крие рискове за сигурността и поверителността.
Често срещаните проблеми с надеждността и сигурността, свързани с паметта на ИИ, включват:
- Неправилно приложени записи в паметта: Запис в паметта може да бъде вкаран в отговор, с който няма нищо общо. Проучване от 2026 г. тества 18 модела за това дали запазен запис от една сфера на живота „изтича“ в отговор от друга. Медианният процент на неуспех е 53%. Проучването установява също, че щом паметта съдържа убежденията на потребителите или заявена от тях експертиза, почти всеки модел ги повтаря, дори ако въпросът изисква неутрален отговор.
- Остарели записи в паметта: Асистентът продължава да действа въз основа на подробност, след като по-късен разговор я е направил невярна, особено когато никога не сте го казали изрично. В бенчмарк от май 2026 г., който проверява дали моделите забелязват такива имплицитни промени, най-добрият модел постига средно 55,2%.
- Претоварване на паметта: Колкото повече асистентът трябва да препрочете, толкова по-трудно му е да отличи важното. LongMemEval, бенчмарк от 2024 г., установява, че модели, които четат история на чат от около 115 000 токена, се представят с 30% до 60% по-зле от модели, получили само релевантните сесии.
- Отравяне на паметта: Невярна информация или скрити инструкции попадат в паметта на асистента, например чрез съдържание, което го молите да прочете, което води до пристрастни или опасни отговори или до изтичане на данни.
- Рискове за поверителността: Паметта пази лични подробности извън чата, от който произхождат, понякога по-дълго, отколкото очаквате. Perplexity например може да пази дневник на изтритите записи в паметта до 30 дни за целите на безопасността и отстраняването на грешки. Законодателството за защита на данните третира съхранените записи в паметта като лични данни, така че би трябвало да можете да ги преглеждате и изтривате.
Как да прегледате, редактирате и изключите паметта на ИИ
Можете да видите какво е запазил асистентът, да го изтриете, да изключите паметта или да използвате частен чат, който не създава записи в паметта.
Управлението на паметта се свежда до няколко функции. Ето какво прави всяка от тях и кога да я използвате:
Функция | Какво прави | Кога да я използвате |
Преглед на запазеното | Отваря хранилището на паметта ви, където можете да търсите, филтрирате и преглеждате отделни записи. | Когато отговорът съдържа подробност, която не сте очаквали. |
Изтриване на запис в паметта | Премахва записа и асистентът спира да го използва в следващи отговори (асистентите може да пазят дневник на изчистените записи в паметта за определен период). | Когато записът в паметта е грешен, остарял или чувствителен. |
Изключване на паметта | Спира използването на паметта от асистента в бъдещи отговори (възможно е вече съхранените записи да не бъдат изчистени – проверете във вашия асистент). | Когато искате отговори без персонализация |
Изключване на историята на търсенията | Спира използването на предишните ви въпроси и отговори от асистента. Изтриването на сесия от историята на търсенията премахва влиянието ѝ върху следващите отговори. | Когато предишни разговори влияят на отговорите, е време да започнете начисто. |
Използвайте чат в режим инкогнито | Паметта и историята на търсенията са винаги изключени, а зададените там въпроси никога не се запазват и не се използват в паметта. | За еднократни или чувствителни теми. |
За да започнете на чисто, изключете паметта и изчистете съхраненото.
Как Perplexity работи с паметта
Паметта на Perplexity работи с всички модели, които предлага.
Perplexity персонализира отговорите въз основа на два източника: спомените, т.е. предпочитанията и подробностите, които споделяте, и историята на търсенията ви. Когато даден спомен повлияе на отговор, той се показва сред източниците на този отговор, така че можете да видите кои спомени са използвани и да изтриете всеки от тях.
Можете също да персонализирате отговорите си, като предоставите информация за себе си и персонализирани инструкции за Проекти (всеки проект има собствен слой памет).
Perplexity може да използва съдържанието на паметта, за да подобрява моделите си, при потребителските акаунти (никога при акаунтите Enterprise), освен ако не изключите това („Запазване на данни за ИИ“ в Настройки → Предпочитания → Изкуствен интелект).
Абонатите на Max и Enterprise Max получават и Brain – споделен слой памет, който надгражда паметта, като проследява вашите проекти и работа. Той има собствен превключвател и игнорира сесиите в режим инкогнито.
Опитайте Perplexity и вижте как спомените оформят следващия ви отговор.
Често задавани въпроси за паметта на ИИ
Какво е ограничена памет при ИИ?
IBM определя ИИ с ограничена памет като ИИ, който може да припомня минали събития и резултати и да следи ситуации във времето, но не може да съхранява тези данни в дългосрочна библиотека от минали преживявания. Това е една от четирите категории в класификацията на системите с ИИ и IBM причислява към нея чатботовете и виртуалните асистенти.
Паметта на асистентите е външна памет, която тези системи добавят допълнително. Тя се запазва между сесиите, така че асистентът може да използва подробности, които сте споделили в по-ранен разговор.
Кой ИИ асистент има най-добрата памет?
Няма асистент, който да е най-добрият за всички. Добрата памет е тази, която можете да контролирате, затова оценявайте инструментите с ИИ, като си зададете четири въпроса: Можете ли да видите какво е запазил? Можете ли да изтриете спомен отделно от чата, от който произлиза? Обучението отделна настройка ли е от паметта? Има ли временен режим или режим инкогнито, който не създава спомени?
Учи ли се моделът на ИИ от това, което помни за вас?
Използването на паметта в отговор е процес, различен от обучението. Perplexity посочва, че извлича подходящ контекст от хранилището на паметта ви, вместо да третира историята ви като данни за обучение. Дали съдържанието ви може да се използва за подобряване на моделите, е отделна настройка. При потребителските акаунти Perplexity може да използва съдържанието на паметта за тази цел, а „Запазване на данни за ИИ“ изключва това.
Какво не бива да попада в паметта на ИИ?
Не допускайте в паметта на ИИ нищо, което не бихте искали да бъде съхранено, използвано за профилирането ви или повторено по-късно: данни за самоличност и финанси, здравна информация, пароли, информация за други хора и всичко, свързано с деца. Службата на комисаря по защита на личния живот на Канада (май 2025 г.) и Националният център за киберсигурност на Обединеното кралство (март 2023 г.) препоръчват да пропускате всяка заявка, която би създала проблеми, ако стане публична.
Филтрите намаляват рисковете за поверителността, но не гарантират, че здравната или финансовата ви информация изобщо няма да бъде съхранена, затова преглеждайте банката на паметта си и използвайте режим инкогнито за еднократни чувствителни въпроси.