
Paměť AI: co to je, jak funguje a co ukládá
Průvodce pamětí AI: jak asistenti AI ukládají a vybavují si údaje z minulých konverzací, co ukládají, kde paměť selhává a jak ji zobrazit, upravit nebo vypnout.
Paměť AI jsou informace, které si konverzační asistent AI ukládá z vašich minulých konverzací a přenáší je do nových, aby si mohl vybavit vaše preference a kontext. Samotný model si z toho nic neuchovává. Asistent tyto informace ukládá odděleně a přidává je zpět, když jsou relevantní, čímž modelu poskytuje trvalý kontext, který by jinak neměl.
Tento průvodce vysvětluje, jak si asistenti tyto informace ukládají a vybavují, co ukládají, proč se někdy mýlí a jak je můžete zobrazit, změnit nebo vypnout.
Co je paměť AI?
Paměť AI, označovaná také jako trvalá paměť, je funkce asistenta AI, která ukládá informace o vás, jako jsou preference, fakta a kontext z minulých interakcí, a asistent je pak může využít v pozdějších konverzacích.
Asistent AI může tento záznam sestavit z toho, co si má na vaši žádost zapamatovat, z podrobností, které zachytí sám, a z dřívějších chatů, ke kterým se může vrátit.
Vrstva paměti AI umožňuje asistentům AI nabízet personalizované odpovědi, aniž byste museli v každém chatu znovu sdílet své preference. Pokud jste asistentovi řekli, že trénujete na maraton a dáváte přednost kilometrům, na vaši další otázku ohledně tempa dostanete odpověď v kilometrech, aniž byste to museli opakovat.
Ve srovnání s opakovaným popisováním vaší situace v každém chatu vám paměť ušetří psaní a udrží prompt krátký, což je důležité, protože dlouhé vstupy snižují přesnost odpovědí.
Paměť není přepisem každé konverzace, ale souborem klíčových faktů o vás. Zapamatuje si tedy, že dáváte přednost kilometrům. Zda dohledá přesný tréninkový plán, který připravil minulý měsíc, závisí na tom, jestli asistent umí prohledávat i minulé chaty.
Typy paměti AI
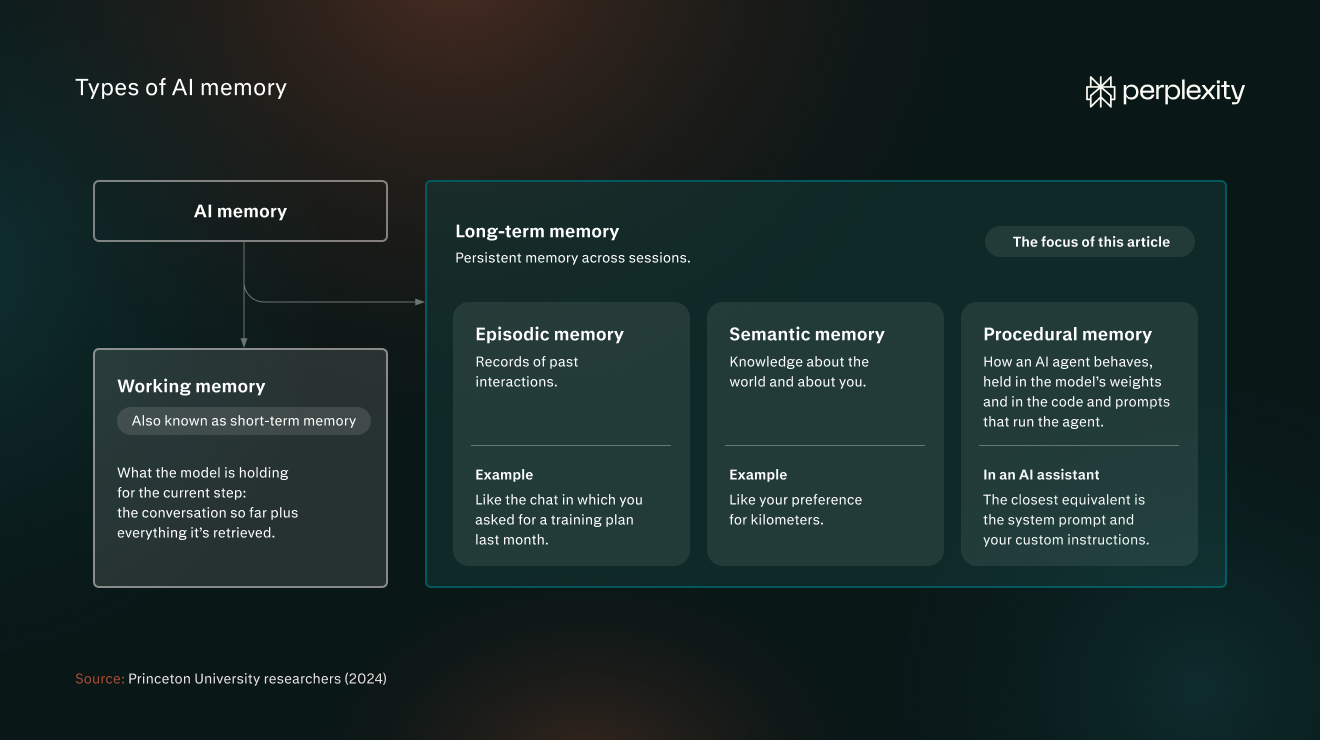
Výzkumníci z Princetonské univerzity (2024) si vypůjčili terminologii z vědy o lidské paměti, aby klasifikovali typy paměťových systémů AI. Jejich rámec odlišuje pracovní paměť od dlouhodobé paměti:
- Pracovní paměť: To, co model drží pro aktuální krok, tedy dosavadní konverzace a vše, co načetl. Označuje se také jako krátkodobá paměť.
- Dlouhodobá paměť: Trvalá paměť napříč relacemi. Právě o tomto typu paměti je tento článek.
Dlouhodobá paměť se skládá ze tří typů paměti:
- Epizodická paměť: Záznamy minulých interakcí, například chat, ve kterém jste minulý měsíc žádali o tréninkový plán.
- Sémantická paměť: Znalosti o světě a o vás, například preference kilometrů.
- Procedurální paměť: Způsob, jakým se agent AI chová, zakotvený ve vahách modelu a v kódu a promptech, které agenta řídí. U asistenta AI jsou jejím nejbližším ekvivalentem systémový prompt a vaše vlastní pokyny.
Paměť asistenta AI vs. paměť agenta AI
Paměť asistenta AI i paměť agenta AI jsou dlouhodobou pamětí. Paměť asistenta AI je převážně sémantická a ukládá fakta o vás, aby vám odpovědi seděly. Paměť agenta, například Brain od Perplexity, ukládá, co agent udělal a jak to dopadlo, včetně toho, co fungovalo a co jste opravili, takže každý nový úkol začíná z lepší pozice.
Paměť asistenta AI | Paměť agenta AI | |
Co si pamatuje | Vás | Úkol a jeho historii |
K čemu slouží | Odpovědi přizpůsobené vám | Pokračování ve vícekrokové práci bez nutnosti začínat znovu |
Příklad | Pamatuje si, že dáváte přednost kilometrům | Pamatuje si váš tréninkový plán na maraton, úpravy, které v něm provedl, a dosud absolvované tréninky, aby mohl lépe naplánovat další tréninkové bloky |
Paměť AI vs. kontextová okna, trénovací data a vlastní pokyny
Paměť AI lze snadno zaměnit se třemi dalšími věcmi, které ovlivňují odpověď: kontextovým oknem modelu, trénovacími daty a vlastními pokyny. Každá z nich obsahuje jiné informace, vydrží jinou dobu a řídí ji jiný systém.
Kontextové okno je množství textu, které velký jazykový model (LLM) dokáže přečíst najednou, a pokrývá aktuální konverzaci. Při zahájení nového chatu se resetuje.
Některé současné modely mají velká kontextová okna s milionem tokenů či více, takže technicky byste mohli do každé konverzace vložit své klíčové informace. Zpracování všech těchto dat však zvyšuje latenci i náklady.
Řada studií také zjistila, že přesnost výstupu s rostoucím vstupem klesá, i když je odpověď v kontextu obsažena.
Studie University of Illinois a Amazonu z roku 2025 tento jev zaznamenala, i když modely dokázaly zopakovat každý relevantní detail: přesnost klesla o 13,9–85 %, jakmile vstupy narostly na 30 000 tokenů, což je hluboko pod limity deklarovanými pro tyto modely. NoLiMa, benchmark z roku 2025 od Adobe Research a LMU Mnichov, zjistil, že 11 ze 13 testovaných modelů dosahovalo výrazně horších výsledků už při 32 000 tokenech, kdykoli otázka a odpověď neměly žádná společná klíčová slova. Zpráva společnosti Chroma z července 2025 to zaznamenala u 18 modelů, a to i tehdy, když odpovídaly na základě historie chatu o délce 113 000 tokenů.
Trénovací data jsou informace zakotvené ve vahách modelu před jeho vydáním. Uživatelé je nemohou změnit. Vývojáři mohou model dotrénovat na nových datech, ale jde o inženýrský proces, nikoli o uživatelské nastavení,
Vlastní pokyny jsou pravidla uložená v nastavení asistenta, která sami píšete a upravujete, abyste přizpůsobili chování a výstupy asistenta AI. Pomocí vlastních pokynů můžete například určit tón a styl odpovědí nebo zdroje, které asistent smí používat.
Zde je srovnání všech čtyř:
Kontextové okno | Paměť AI | Trénovací data | Vlastní pokyny | |
Co obsahuje | Zprávy v aktuálním chatu | Uložená fakta a preference o vás | Co se model naučil před vydáním | Pokyny, které si napíšete sami |
Jak dlouho vydrží | Pouze tento chat | Do aktualizace nebo smazání | Neměnná až do vydání nového modelu | Dokud je neupravíte |
Kdo to ovládá | Vy, v rámci limitu stanoveného poskytovatelem modelu. | Vy a asistent | Společnost vyvíjející AI | Vy |
Příklad | Otázka ohledně tempa, kterou jste položili před minutou | Že dáváte přednost kilometrům | Jak jsou tréninkové plány na maraton obecně strukturované | Pokyn formátovat tréninkové plány do mřížky, kde řádky představují týdny a sloupce dny v týdnu |
Co paměť AI ukládá
Asistenti si o vás uchovávají vybrané údaje, jako jsou fakta, preference a shrnutí, a někteří čerpají také z vašich minulých chatů.
- Fakta a preference, které si má zapamatovat: Jde o údaje, které asistentovi výslovně řeknete, aby si uložil, například „pamatuj si, že dávám přednost kilometrům“. Asistent vytvoří záznam v paměti, když o to požádáte, a ten vydrží, dokud ho nesmažete nebo ho neaktualizuje pozdější konverzace.
- Údaje, které zachytí z vašich konverzací: Asistent je ukládá, když je toto nastavení zapnuté. Perplexity „upřednostňuje četnost otázek kladených uživatelem a informací, které uživatel poskytuje“, takže něco, co zmiňujete často, se uchytí spíše než to, co zmíníte jen jednou. Záznam v paměti vydrží, dokud není aktualizován nebo dokud ho nesmažete.
- Odkazy na vaše minulé chaty: Asistent čerpá přímo z dřívějších konverzací, nikoli z uloženého seznamu. Perplexity tomu říká historie vyhledávání: vaše minulé otázky a odpovědi, které slouží k tomu, aby nová odpověď byla relevantnější.
Jak paměť AI funguje
Model AI si mezi konverzacemi nic nepamatuje. Tuto práci odvádí paměťový systém AI: uchovává o vás samostatný záznam a do každé nové konverzace přidává jeho relevantní části. Ukládání a načítání probíhá na pozadí, takže model tyto informace čte spolu s vaší otázkou.
Tento proces probíhá v pěti krocích:
- Ukládání: Asistent uloží záznam do paměti, když ho o to požádáte nebo když usoudí, že danou podrobnost stojí za to si ponechat.
- Uchovávání: Záznamy v paměti se ukládají do databáze oddělené od modelu. V mnoha systémech jde o vektorovou databázi, takže je lze vyhledávat podle významu. Seznam, který vidíte v nastavení, je pohledem do tohoto úložiště paměti.
- Načítání: Když odešlete zprávu, asistent rozhodne, které záznamy v paměti se jí týkají. Mnoho systémů to dělá tak, že vaši zprávu i každý záznam převede na embeddingy, tedy číselné reprezentace významu, a vybere nejbližší shody. Díky tomu si dokážou vybavit záznam, i když nemá s vaší otázkou žádné společné slovo. Jednodušší systémy načítají do každé konverzace všechny uložené záznamy.
- Použití: Vybavené záznamy se vkládají jako prostý text do vstupu, obvykle do bloku pokynů, který model čte před vaší zprávou. Model je zpracovává jako jakýkoli jiný text v tomto vstupu.
- Aktualizace a odstraňování: Asistent extrahuje z chatů fakta, prohledá existující záznamy v paměti a rozhodne, zda fakt přidá jako nový, aktualizuje existující záznam, sloučí ho s některým z nich, nebo smaže starý záznam, který je v rozporu s novými zjištěními. Někteří asistenti opatřují každý záznam časovým razítkem, aby odlišili novější informace od starších.
Výzvy a rizika paměti AI
Paměť AI má zlepšovat kvalitu odpovědí, ale benchmarky ukazují, že načítání z paměti ne vždy přinese relevantní nebo aktuální informace, zejména z velkých databází. Představuje také rizika pro bezpečnost a soukromí.
Mezi běžné problémy se spolehlivostí a zabezpečením související s pamětí AI patří:
- Nesprávně použité záznamy v paměti: Záznam v paměti se může dostat do odpovědi, se kterou nemá nic společného. Studie z roku 2026 testovala 18 modelů na to, zda uložený záznam z jedné oblasti života pronikne do odpovědi z jiné oblasti. Medián míry selhání činil 53 %. Studie také zjistila, že jakmile paměť obsahovala přesvědčení uživatelů nebo jimi deklarovanou odbornost, téměř každý model je opakoval, i když otázka vyžadovala neutrální odpověď.
- Zastaralé záznamy v paměti: Asistent se dál řídí údajem i poté, co ho pozdější konverzace učinila neplatným, zejména pokud jste to nikdy výslovně neřekli. V benchmarku z května 2026, který testoval, zda si modely takových implicitních změn všimnou, dosáhl nejlepší model průměrně 55,2 %.
- Přetížení paměti: Čím víc toho musí asistent zpětně přečíst, tím těžší je vybrat, na čem záleží. LongMemEval, benchmark z roku 2024, zjistil, že modely čtoucí historii chatu o délce přibližně 115 000 tokenů dosahovaly o 30 % až 60 % horších výsledků než modely, které dostaly pouze relevantní relace.
- Otrávení paměti: Do paměti asistenta se dostanou nepravdivé informace nebo skryté pokyny, například prostřednictvím obsahu, který mu zadáte k přečtení, což vede ke zkresleným nebo nebezpečným odpovědím či k únikům dat.
- Rizika pro soukromí: Paměť uchovává osobní údaje i mimo chat, ze kterého pocházejí, někdy déle, než očekáváte. Perplexity si například může uchovávat protokol smazaných záznamů v paměti až 30 dní z bezpečnostních důvodů a pro účely ladění. Právo na ochranu osobních údajů považuje uložené záznamy v paměti za osobní údaje, takže byste měli mít možnost je zkontrolovat a smazat.
Jak zobrazit, upravit a vypnout paměť AI
Můžete zjistit, co si asistent uložil, smazat to, vypnout paměť nebo použít soukromý chat, který nevytváří záznamy v paměti.
Správa paměti se omezuje na několik ovládacích prvků. Zde je, co každý z nich dělá a kdy ho použít:
Ovládací prvek | Co dělá | Kdy ho použít |
Zobrazit, co je uloženo | Otevře vaši banku paměti, kde můžete vyhledávat, filtrovat a kontrolovat jednotlivé záznamy. | Když odpověď obsahuje údaj, který jste nečekali. |
Smazat záznam v paměti | Odstraní záznam a asistent ho přestane používat v dalších odpovědích (asistenti si mohou po určitou dobu uchovávat protokol vymazaných záznamů v paměti). | Když je záznam v paměti nesprávný, zastaralý nebo citlivý. |
Vypnout paměť | Asistent přestane v budoucích odpovědích využívat paměť (nemusí tím vymazat již uložené záznamy – ověřte si to u svého asistenta). | Když chcete odpovědi bez personalizace |
Vypnout historii vyhledávání | Asistent přestane využívat vaše minulé otázky a odpovědi. Smazáním relace z historie vyhledávání odstraníte její vliv na pozdější odpovědi. | Když odpovědi ovlivňují dřívější konverzace, je dobré začít nanovo. |
Použijte anonymní chat | Paměť a historie vyhledávání jsou v něm vždy vypnuté a otázky, které v něm položíte, se nikdy neuchovávají ani nepoužívají v paměti. | Pro jednorázová nebo citlivá témata. |
Chcete-li začít s čistým štítem, vypněte paměť a vymažte, co je v ní uloženo.
Jak Perplexity pracuje s pamětí
Paměť Perplexity funguje napříč všemi modely, které Perplexity nabízí.
Perplexity přizpůsobuje odpovědi na základě dvou zdrojů: vzpomínek, tedy preferencí a údajů, které sdílíte, a vaší historie vyhledávání. Když vzpomínka ovlivní odpověď, zobrazí se mezi zdroji dané odpovědi, takže vidíte, které vzpomínky byly použity, a kteroukoli z nich můžete smazat.
Odpovědi si můžete přizpůsobit také tím, že uvedete údaje o sobě a zadáte vlastní pokyny pro projekty (každý projekt má vlastní vrstvu paměti).
Perplexity může u spotřebitelských účtů (nikdy ne u účtů Enterprise) používat obsah paměti ke zlepšování svých modelů, pokud to nevypnete (Uchovávání dat AI v Nastavení → Předvolby → Umělá inteligence).
Předplatitelé Max a Enterprise Max navíc získávají Brain, sdílenou vrstvu paměti, která na paměť navazuje tím, že sleduje vaše projekty a práci. Má vlastní přepínač a anonymní relace ignoruje.
Vyzkoušejte Perplexity a podívejte se, jak vzpomínky ovlivní vaši příští odpověď.
Časté dotazy k paměti AI
Co je AI s omezenou pamětí?
IBM definuje AI s omezenou pamětí jako AI, která si dokáže vybavit minulé události a výsledky a sledovat situace v čase, ale nedokáže tato data uchovávat v dlouhodobé knihovně minulých zkušeností. Jde o jednu ze čtyř kategorií v taxonomii systémů AI a IBM do ní řadí chatboty a virtuální asistenty.
Paměť asistenta je externí paměť, kterou tyto systémy přidávají navíc. Přetrvává napříč relacemi, takže asistent může využít údaje, které jste sdíleli v dřívější konverzaci.
Který asistent AI má nejlepší paměť?
Žádný asistent není nejlepší pro každého. Dobrá paměť je taková, kterou můžete ovládat, proto nástroje AI hodnoťte podle čtyř otázek: Vidíte, co si uložil? Můžete smazat vzpomínku odděleně od chatu, ze kterého pochází? Je trénování samostatné nastavení oddělené od paměti? Existuje dočasný nebo anonymní režim, který nevytváří žádné vzpomínky?
Učí se model AI z toho, co si o vás pamatuje?
Použití paměti v odpovědi je jiný proces než trénování. Perplexity uvádí, že načítá relevantní kontext z vašeho úložiště paměti a vaši historii nepoužívá jako trénovací data. Zda lze váš obsah použít ke zlepšování modelů, určuje samostatné nastavení. U spotřebitelských účtů může Perplexity k tomuto účelu používat obsah paměti a nastavení Uchovávání dat AI to vypíná.
Co byste do paměti AI neměli ukládat?
Do paměti AI neukládejte nic, co byste nechtěli mít uložené, použité k vytvoření vašeho profilu nebo později zopakované: údaje o totožnosti a financích, zdravotní informace, hesla, informace o jiných lidech a cokoli o dětech. Kanadský úřad komisaře pro ochranu soukromí (květen 2025) a britské Národní centrum kybernetické bezpečnosti (březen 2023) doporučují vynechat jakoukoli výzvu, která by způsobila problémy, kdyby se dostala na veřejnost.
Filtry snižují rizika pro soukromí, ale nezaručují, že se vaše zdravotní nebo finanční informace vůbec neuloží. Kontrolujte proto obsah své paměti a pro jednorázové citlivé dotazy používejte anonymní režim.