
Degradace kontextu u AI agentů: proč dlouhé úkoly ztrácejí přesnost a jak tomu předejít
Průvodce tím, co se hromadí v kontextu AI agenta, proč to snižuje přesnost a jak nastavit úkoly, které zůstanou spolehlivé.
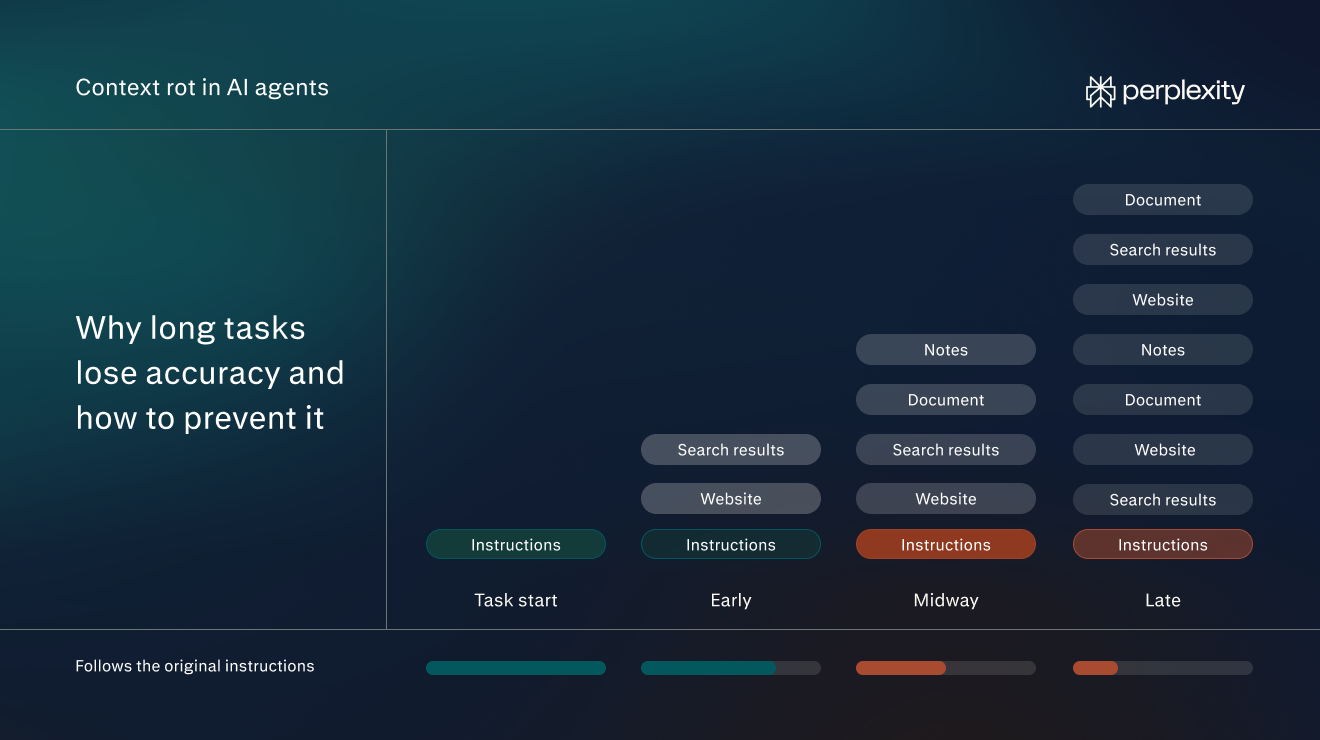
Co znamená degradace kontextu pro AI agenty
Degradace kontextu (context rot) u AI agentů je postupná ztráta přesnosti, ke které dochází, když se kontext agenta během dlouhého úkolu zaplňuje.
Kontext agenta tvoří informace, které má model k dispozici pro svůj další krok. Může zahrnovat pokyny, dřívější zprávy, výsledky vyhledávání a text z webových stránek nebo souborů. Během práce může agent přidávat další.
Řekněme například, že úkolem agenta je najít dodavatele, kteří doručí do dvou týdnů. Na začátku obsahuje jeho kontext pouze tento požadavek. V polovině úkolu bude kontext obsahovat také text desítek webů dodavatelů, několik stránek výsledků vyhledávání a poznámky o tom, které dodavatele už agent zkontroloval.
Množství kontextu, které model pojme, je omezené (tento limit se nazývá kontextové okno). Okno se měří v tokenech, což jsou malé kousky textu, obvykle slovo nebo část slova. Degradace kontextu se s rostoucím kontextem zhoršuje, a proto k ní nejčastěji dochází u dlouhých úkolů s mnoha kroky.
S postupující degradací kontextu bude agent méně přesný. Může se méně důsledně držet původních pokynů, přehlížet podrobnosti nebo si plést podobně vypadající informace s tím, co potřebuje.
Agent může například začít zahrnovat dodavatele, u kterých doručení trvá šest týdnů, přestože měl najít doručení do dvou týdnů. Pokyn je stále v jeho kontextu, ale už neovlivňuje rozhodování agenta.
Degradace kontextu není totéž co prosté vyčerpání místa v kontextovém okně. Když kontext úkolu přeroste okno, část materiálu se odřízne nebo úkol selže. Degradace kontextu začíná dlouho předtím, ve chvíli, kdy se ještě vše vejde.
Není to ani totéž co otrávení kontextu (kdy se do kontextu agenta dostanou zavádějící nebo škodlivé informace). I agent s přesnými a úplnými informacemi může trpět degradací kontextu.
Proč k degradaci kontextu dochází
K degradaci kontextu dochází, protože pozornost modelu je omezená, i když má jeho kontextové okno ještě volné místo. U AI modelů je pozornost (attention) odborný termín pro to, jak model rozhoduje, ze kterých částí vstupu bude čerpat při psaní každého slova odpovědi. Všechny části kontextu o tuto pozornost soupeří. Čím více textu je, tím méně pozornosti každá část dostane.
Společnost Chroma například zveřejnila studii o tom, jak délka vstupu ovlivňuje AI modely. Testovala v ní 18 modelů od společností Anthropic, OpenAI, Google a Alibaba. V jednom testu výzkumníci ukryli větu s radou ohledně psaní do dlouhé sbírky esejí. Poté se modelu zeptali, jaká ta rada byla.
Test spustili mnohokrát a pokaždé přidali další text esejí. Věta ani otázka se nikdy neměnily. Měnilo se pouze množství textu kolem nich.
Čím více textu musely modely přečíst, tím hůře si vedly. Toto zjištění platilo ve všech testech ve zprávě. Výzkumníci předpokládají, že pokles přesnosti by byl ještě větší při skutečné práci o mnoha krocích, jakou představuje většina úkolů agentů.
Jak může degradace kontextu ovlivnit AI agenty
Degradace kontextu se obvykle projeví jedním ze čtyř způsobů:
Ztráta přehledu o původních pokynech
V nejjednodušším testu společnosti Chroma měly modely přesně zkopírovat dlouhý řetězec opakujících se slov, do kterého bylo někam vloženo jedno odlišné slovo. Šlo o triviální úkol s jednoznačným pokynem. Přesto s prodlužujícím se textem výkon všech modelů klesal. Některé modely začaly generovat slova, která ve vstupu vůbec nebyla.
U úkolu pro agenta uživatel obvykle na začátku stanoví konkrétní omezení, například rozpočet nebo požadovaný formát. S rostoucím kontextem je agent může uplatňovat méně důsledně. Příčinou je celková délka kontextu, nikoli to, kde se pokyn nachází.
Přehlédnuté podrobnosti z průběhu úkolu
Podle studie Stanfordovy univerzity z roku 2023 využívají AI modely informace nejspolehlivěji, když se nacházejí na samém začátku nebo na samém konci jejich vstupu. V jednom testu výzkumníci dali modelům sadu 20 dokumentů a položili otázku, na kterou odpovídal jen jeden z nich. Když byl tento dokument první nebo poslední, modely odpověď obvykle našly. Když se nacházel uprostřed sady, přehlédly ji mnohem častěji. Výzkumníci tento jev nazývají poziční efekt.
Stejný vzorec platí i pro agenty. Informace nalezené dříve během úkolu se mohou ocitnout uprostřed dlouhé konverzace, kde je některé modely využívají hůře. V příkladu s dodavateli může v konečném seznamu chybět dobrý dodavatel, kterého agent zkontroloval v průběhu úkolu.
Záměna podobných informací
S rostoucím kontextem mohou agenti hůře rozpoznávat, které informace odpovídají jejich pokynům. Řekněme například, že uživatel agentovi zadal najít dodavatele, kteří zboží odešlou „do dvou týdnů“. Na webu jednoho dodavatele stojí „doručení do 14 kalendářních dnů od objednávky“. U krátkého úkolu by agent pravděpodobně poznal, že obojí znamená totéž. Když je tato informace zahrabaná mezi desítkami dalších stránek dodavatelů, je pravděpodobnější, že shodu přehlédne.
Agent také může začít zahrnovat výsledky, které nejsou relevantní. Řekněme, že agent hledá dodavatele kancelářských židlí. Web jednoho dodavatele slibuje doručení do dvou týdnů, ale pouze u stolů. Na jeho židle se čeká šest týdnů. Web používá stejná slova jako pokyn, takže agent může dodavatele do seznamu přesto přidat. Výzkumníci takovým informacím říkají distraktor. Vypadá relevantně, ale není, a proto soupeří s informacemi, na kterých záleží.
Studie společnosti Chroma zjistila, že oba problémy se s rostoucím množstvím okolního textu zhoršovaly.
Chyby, které se těžko odhalují
Degradace kontextu nevyvolá chybovou zprávu. Agent pracuje dál a odevzdá výstup, který vypadá hotově. Proto se jeho chyby snadno přehlédnou.
V testech společnosti Chroma měly tyto chyby dvě podoby. Někdy model sebejistě podal špatnou odpověď. V příkladu s průzkumem dodavatelů může agent dodat úhledný, dobře naformátovaný seznam, který obsahuje dodavatele, jehož dodací podmínky špatně pochopil.
Jindy model tvrdil, že nemůže najít informace, které tam ve skutečnosti byly. Agent může například odevzdat zprávu, že limit dvou týdnů nesplňuje žádný dodavatel, přestože jej několik splňuje.
Jak nastavit úkoly pro agenty, aby se omezila degradace kontextu
Správné nastavení úkolů minimalizuje dopad degradace kontextu a udrží agenta po celou dobu úkolu co nejpřesnější. Pomoci mohou následující osvědčené postupy.
Formulujte úkol jako zadání
Jasné zadání udržuje kontext menší. Agent ví, kdy je hotový, takže přestane shromažďovat materiál, jakmile ho má dost. Konkrétní požadavky mu také dávají něco hmatatelného, s čím může každou stránku porovnat. Agent tak snáze najde správné informace.
Před odesláním úkolu zkontrolujte, zda zahrnuje tři věci:
- Úkol: co má agent udělat a vytvořit, například „najdi dodavatele a vrať užší výběr“.
- Požadavky: fakta, která agent nemůže uhodnout, například rozpočet, termín, doručovací adresa a pro koho je výsledek určen.
- Výstup: formát, délka a struktura, například „tabulka s názvem, cenou za židli a dobou doručení“.
Dohromady může dotaz pro úkol s dodavateli vypadat takto:
„Najdi 10 dodavatelů, kteří dokážou do dvou týdnů doručit 40 kancelářských židlí do naší kanceláře v Chicagu za méně než 250 $ za židli. Vrať tabulku s názvem dodavatele, cenou za židli, dobou doručení a odkazem na stránku produktu. Seznam je pro našeho správce kanceláře, který objednávku zadá.“
Udržujte každý úkol zaměřený
Jeden úkol s jedním jasným cílem udržuje kontext malý. Dlouhé úkoly jsou navíc dražší. Každý krok zpracovává vše, co se dosud nashromáždilo, takže nafouknutý kontext spotřebuje v každém kroku více kreditů.
Projekt o několika částech rozdělte:
- Vypište jednotlivé výstupy, například vyhledání dodavatelů, porovnání cen a e-mail vybranému dodavateli.
- Každý výstup zpracujte jako samostatný úkol.
- Z jednoho úkolu do dalšího předávejte pouze hotový výsledek. Například nahrajte tabulku dodavatelů jako soubor a zahajte jím úkol porovnání, místo abyste pokračovali ve vlákně, ve kterém vznikla.
Úkol porovnání pak začíná s jednou tabulkou místo se všemi stránkami.
Nasměrujte agenta ke správným zdrojům
Každá stránka, kterou agent přečte, rozšiřuje jeho kontext, včetně nabídek, reklam a standardního textu kolem užitečné části. Když agentovi poskytnete zdroje přímo, tento šum omezíte.
Soubory, na kterých úkol závisí, například seznam schválených dodavatelů, nahrajte tak, že je připojíte k dotazu. Pokud musí agent vyhledávat na webu, uveďte weby, které stojí za prohledání, například dva důvěryhodné katalogy dodavatelů.
Připojte nástroje, ve kterých se informace nacházejí. Například v Perplexity Computer otevřete na postranním panelu Konektory a povolte aplikace, které úkol potřebuje, například Google Drive nebo Slack. Poté je zmiňte v dotazu: „Použij specifikace židlí z našeho Google Drive.“ Připojujte pouze relevantní aplikace, protože každý konektor zabírá část kontextu agenta.
Pokud se informace nacházejí v aplikaci, která v seznamu Konektory není, může být přesto možné ji připojit. Mnoho aplikací nabízí konektor MCP (Model Context Protocol), což je standardní způsob, jak propojit AI nástroje s jiným softwarem. Computer je může používat spolu se svými vestavěnými konektory. Ve firemním účtu je možná bude nejprve muset povolit administrátor.
Požádejte o závěrečnou kontrolu podle pokynů
Zakončete dotaz krokem kontroly, který uvádí nejdůležitější omezení:
„Před dokončením zkontroluj každého dodavatele podle těchto požadavků: doručení do dvou týdnů, cena pod 250 $ za židli. Dodavatele, kteří tyto požadavky nesplňují, označ, místo abys je vynechal.“
Omezení jsou stále na začátku kontextu. Krok kontroly dává agentovi důvod porovnat svůj konečný výstup s omezeními, místo aby spoléhal na to, že si pokyny udrží vliv v každém kroku.
Když agenta navíc požádáte, aby problémy označil, a ne aby takové výsledky jednoduše vyřadil, chyby se snáze odhalí (například vyřazení dodavatele, který slibuje doručení do 14 kalendářních dnů, protože nepoužívá slova „dva týdny“).
Kontrolujte práci v kontrolních bodech
U delších úkolů zabudujte do dotazu kontrolní bod:
„Začni tím, že najdeš 20 potenciálních dodavatelů, a pak se zastav. Než začneš zjišťovat ceny, seznam potvrdím.“
Zkontrolujte užší výběr podle původních pokynů. Cokoli, co nesedí, opravte v navazující zprávě a pak nechte agenta pokračovat. Chyby zachycené v této fázi se nepřenesou do všech následujících kroků.
Když se úkol odchýlí od cíle, začněte nový
Pokud agent i po opravách opakuje stejnou chybu, začněte nový úkol. Každá oprava přidává další text do už tak dlouhého kontextu. Místo toho vytvořte nový úkol. Zopakujte pokyny, nahrajte jakýkoli dobrý výstup z prvního pokusu a začněte znovu.
Někteří agenti dělají něco podobného automaticky – jde o proces zvaný kompakce (compaction). Jak se úkol prodlužuje, agent nahrazuje starší materiál, například úplný text stránek, které četl na začátku, krátkým shrnutím toho, co zjistil. Portable Computer od Perplexity takto kompaktuje svůj kontext, aby model zůstal v rozsahu, který dokáže dobře zvládnout.
Nový úkol je důležité začít také tehdy, když se změní cíl. Vlákno, které začalo jako vyhledávání dodavatelů, by se nemělo změnit také v revizi smlouvy.
Proměňte opakované pokyny ve Skill
Některé pokyny se objevují v každém úkolu určitého typu, například preferovaný formát tabulky, seznam dodavatelů, kterým je třeba se vyhnout, nebo standardní krok kontroly. V nástroji Computer je lze uložit jako Skill, opakovaně použitelnou sadu pokynů, kterou agent pokaždé dodržuje. Skill začlení ostatní osvědčené postupy do každého úkolu, který ho používá.
Postup nastavení:
- Vyberte úkol, který se často opakuje, například průzkum dodavatelů.
- Sepište pokyny, které pokaždé zadáváte: formát, kontroly a zdroje, které se mají používat nebo kterým je třeba se vyhnout.
- Uložte je jako Skill. Pokyny, které už máte napsané ve formátu Markdown, lze importovat přímo.
- V budoucích dotazech Skill uveďte jménem: „Použij Skill pro průzkum dodavatelů a najdi dodavatele židlí pro kancelář v Denveru.“
Jak Perplexity přistupuje ke kontextu při práci agentů
Perplexity Computer zvládá dlouhé úkoly tak, aby kontext každého modelu zůstal malý a relevantní. Tři části jeho návrhu omezují, kolik toho musí model najednou přečíst.
Rozdělení práce mezi subagenty
Computer rozdělí požadavek na úkoly a dílčí úkoly a poté vytvoří subagenty, kteří je provedou. Každý subagent pracuje na jedné části práce ve vlastním kontextu. V úkolu s dodavateli může jeden subagent zjišťovat ceny, zatímco jiný kontroluje dodací podmínky. Žádný z nich nemusí číst vše, co přečetl ten druhý.
Uchovávání práce v souborech
Každý úkol v nástroji Computer dostane vlastní pracovní prostor s vlastními soubory, webovým prohlížečem a nástroji. Agent může svou práci ukládat do souboru, například do průběžně aktualizované tabulky dodavatelů, které už zkontroloval. Tento soubor pak znovu otevře, jen když ho potřebuje.
Výběr relevantních pasáží z výsledků vyhledávání
Webové stránky jsou plné materiálu, který model nepotřebuje, například nabídek, reklam, metadat a textu na jiná témata. Komprese kontextu zohledňující dotaz tento materiál odstraní. Než se stránka dostane k modelu, Perplexity z ní ponechá pouze věty, které souvisejí s dotazem.
Prozkoumejte tipy, návody a ukázkové úkoly pro Perplexity Computer a vyzkoušejte si tyto kroky v praxi.
Časté dotazy
Je degradace kontextu totéž co halucinace?
Ne, ale souvisejí spolu. Halucinace je jakákoli odpověď, která uvádí něco nepravdivého nebo nepodloženého. Degradace kontextu je jednou z podmínek, které zvyšují pravděpodobnost halucinací, stejně jako dalších chyb, například ignorovaných pokynů a přehlédnutých podrobností.
Dokáže lepší dotaz degradaci kontextu vyřešit?
Jasný dotaz omezuje degradaci kontextu tím, že udržuje úkol zaměřený. Nedokáže však zabránit růstu kontextu. U dostatečně dlouhého úkolu agent stále shromáždí víc, než dokáže dobře využít, a proto je rozdělení práce a její průběžná kontrola stejně důležité jako samotný dotaz.
Ovlivňuje degradace kontextu i běžné chaty s AI, nejen agenty?
Ano. V chatu tvoří kontext celá dosavadní konverzace, včetně všech zpráv a dokumentů, které do ní byly vloženy nebo nahrány. Vlákno, které běží celé hodiny a zahrnuje několik témat, může vést ke stejným chybám jako dlouhý úkol agenta. Když pro nové téma začnete nové vlákno, každá konverzace zůstane zaměřená.
Jak dlouhý může úkol být, než nastane degradace kontextu?
Žádná pevná hranice neexistuje. Záleží na modelu a úkolu. Například modely běžící přímo v zařízení s kontextovým oknem 260 000 tokenů začínají mít potíže nad zhruba 100 000 tokeny, tedy hluboko pod svým limitem. Pokles je navíc spíše postupný než náhlý.