
זיכרון בבינה מלאכותית: מה זה, איך זה עובד ומה נשמר בו
מדריך לזיכרון בבינה מלאכותית: איך עוזרי בינה מלאכותית שומרים פרטים משיחות קודמות ונזכרים בהם, מה הם שומרים, איפה הזיכרון משתבש ואיך לצפות בו, לערוך אותו או לכבות אותו.
זיכרון AI הוא מידע שעוזר AI שיחתי שומר מהשיחות הקודמות שלך ומביא לשיחות חדשות, כדי שיוכל לזכור את ההעדפות וההקשר שלך. המודל עצמו לא שומר דבר מזה. העוזר מאחסן את המידע בנפרד ומוסיף אותו מחדש כשהוא רלוונטי, וכך מעניק למודל הקשר מתמשך שאחרת לא היה לו.
מדריך זה מסביר כיצד עוזרים שומרים את המידע הזה ונזכרים בו, מה הם מאחסנים, מדוע הם טועים לפעמים, וכיצד אפשר לראות אותו, לשנות אותו או לכבות אותו.
מהו זיכרון AI?
זיכרון AI, המכונה גם זיכרון מתמשך, הוא תכונה של עוזר AI שמאחסנת מידע עליך, כגון העדפות, עובדות והקשר מאינטראקציות קודמות, שבו העוזר יכול להשתמש בשיחות מאוחרות יותר.
עוזר AI יכול לבנות את התיעוד הזה מדברים שביקשת ממנו לזכור, מפרטים שהוא קולט בעצמו ומצ׳אטים קודמים שהוא יכול לחזור אליהם.
שכבת הזיכרון של AI מאפשרת לעוזרי AI להציע תשובות מותאמות אישית בלי שתצטרך לשתף את ההעדפות שלך בכל צ׳אט. אם סיפרת לעוזר שאתה מתאמן למרתון ומעדיף קילומטרים, השאלה הבאה שלך על קצב הריצה תקבל תשובה בקילומטרים בלי שתצטרך לחזור על כך.
לעומת תיאור המצב שלך מחדש בכל צ׳אט, הזיכרון חוסך לך הקלדה ושומר על הנחיה קצרה, וזה חשוב כי קלט ארוך פוגע בדיוק התשובות.
זיכרון אינו תמליל של כל שיחה, אלא אוסף של עובדות מפתח עליך. לכן הוא יזכור שאתה מעדיף קילומטרים. היכולת למצוא את תוכנית האימונים המדויקת שהוא ניסח בחודש שעבר תלויה בכך שהעוזר יוכל גם לחפש בצ׳אטים קודמים.
סוגי זיכרון AI
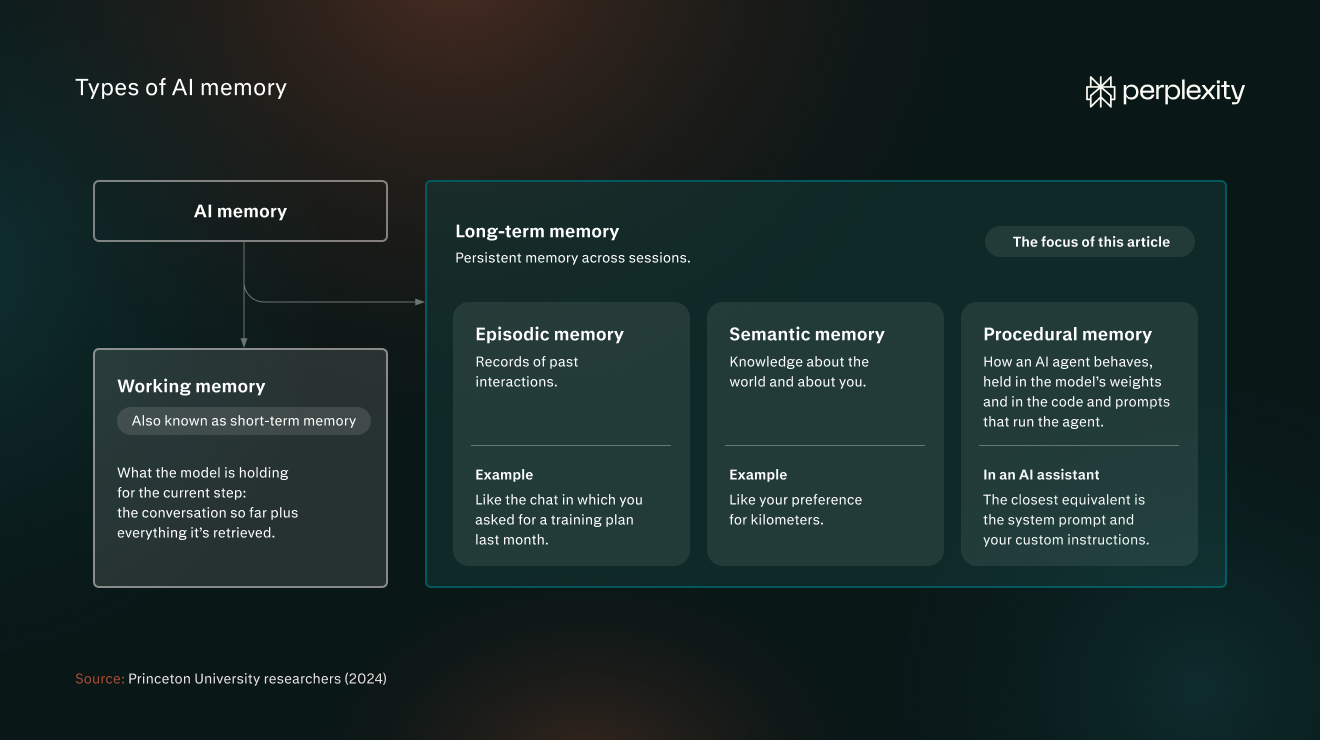
חוקרים מאוניברסיטת פרינסטון (2024) שאלו מונחים ממדעי הזיכרון האנושי כדי לסווג סוגים של מערכות זיכרון AI. המסגרת שלהם מבחינה בין זיכרון עבודה לזיכרון לטווח ארוך:
- זיכרון עבודה: מה שהמודל מחזיק עבור השלב הנוכחי, כלומר השיחה עד כה וכל מה שהוא אחזר. מוכר גם בשם זיכרון לטווח קצר.
- זיכרון לטווח ארוך: זיכרון מתמשך בין הפעלות. זהו סוג הזיכרון שבו עוסק מאמר זה.
זיכרון לטווח ארוך מורכב משלושה סוגי זיכרון:
- זיכרון אפיזודי: תיעוד של אינטראקציות קודמות, כמו הצ׳אט שבו ביקשת תוכנית אימונים בחודש שעבר.
- זיכרון סמנטי: ידע על העולם ועליך, כמו ההעדפה לקילומטרים.
- זיכרון פרוצדורלי: האופן שבו סוכן AI מתנהג, המוטמע במשקלים של המודל ובקוד ובהנחיות שמפעילים את הסוכן. בעוזר AI, המקבילה הקרובה ביותר היא הנחיית המערכת וההוראות המותאמות אישית שלך.
זיכרון של עוזר AI לעומת זיכרון של סוכן AI
זיכרון של עוזר AI וזיכרון של סוכן AI הם שניהם זיכרון לטווח ארוך. זיכרון של עוזר AI הוא בעיקר זיכרון סמנטי ומאחסן עובדות עליך, כדי שהתשובות יתאימו לך. זיכרון של סוכן, כמו ה-Brain של Perplexity, מאחסן את מה שהסוכן עשה ואיך זה הלך, כולל מה עבד ומה תיקנת, כך שהוא מתחיל כל משימה חדשה מנקודת פתיחה טובה יותר.
זיכרון של עוזר AI | זיכרון של סוכן AI | |
מה הוא זוכר | אותך | את המשימה ואת ההיסטוריה שלה |
למה הוא משמש | תשובות שמתאימות לך | המשך עבודה רב-שלבית בלי להתחיל מחדש |
דוגמה | זוכר שאתה מעדיף קילומטרים | זוכר את תוכנית האימונים שלך למרתון, את השינויים שהוא ערך בה ואת האימונים שהשלמת עד כה, כדי שיוכל לתכנן טוב יותר את שלבי האימון הבאים |
זיכרון AI לעומת חלונות הקשר, נתוני אימון והוראות מותאמות אישית
קל לבלבל בין זיכרון AI לבין שלושה דברים אחרים שמעצבים תשובה: חלון ההקשר של המודל, נתוני האימון וההוראות המותאמות אישית. כל אחד מהם מחזיק מידע שונה, נשמר לפרק זמן שונה ונשלט על ידי מערכת אחרת.
חלון הקשר הוא כמות הטקסט שמודל שפה גדול (LLM) יכול לקרוא בבת אחת, והוא מכסה את השיחה הנוכחית. הוא מתאפס כשמתחילים צ׳אט חדש.
לחלק מהמודלים הנוכחיים יש חלונות הקשר גדולים של מיליון טוקנים או יותר, כך שמבחינה טכנית אפשר להדביק את המידע החשוב שלך בכל שיחה. אבל עיבוד של כל המידע הזה מוסיף זמן השהיה ועלות.
מחקרים רבים מצאו גם שדיוק הפלט יורד ככל שהקלט גדל, גם כשהתשובה נמצאת בהקשר.
מחקר של אוניברסיטת אילינוי ו-Amazon משנת 2025 הבחין בכך גם כשהמודלים יכלו לצטט כל פרט רלוונטי: הדיוק ירד ב-13.9% עד 85% כשהקלט גדל ל-30,000 טוקנים, הרבה מתחת למגבלות המוצהרות של המודלים. NoLiMa, מדד ביצועים משנת 2025 של Adobe Research ו-LMU מינכן, מצא ש-11 מתוך 13 המודלים שנבדקו הציגו ביצועים נמוכים משמעותית כבר ב-32,000 טוקנים בלבד, בכל פעם שלשאלה ולתשובה לא היו מילות מפתח משותפות. הדוח של Chroma מיולי 2025 הבחין בכך ב-18 מודלים, כולל כשהם ענו מתוך היסטוריית צ׳אט של 113,000 טוקנים.
נתוני אימון הם המידע שמוטמע במשקלים של המודל לפני השקתו. משתמשים לא יכולים לשנות אותם. מפתחים יכולים לבצע כוונון עדין (fine-tuning) למודל על נתונים חדשים, אבל זה תהליך הנדסי, לא הגדרת משתמש,
הוראות מותאמות אישית הן כללים שנשמרים בהגדרות העוזר, שאתה כותב ועורך בעצמך כדי להתאים אישית את ההתנהגות והפלטים של עוזר ה-AI. לדוגמה, אפשר להשתמש בהוראות מותאמות אישית כדי להגדיר את הטון והסגנון של התשובות או באילו מקורות העוזר יכול להשתמש.
הנה השוואה בין הארבעה:
חלון הקשר | זיכרון AI | נתוני אימון | הוראות מותאמות אישית | |
מה הוא מכיל | ההודעות בצ׳אט הנוכחי | עובדות והעדפות שמורות עליך | מה שהמודל למד לפני השקתו | הנחיות שאתה כותב בעצמך |
כמה זמן הוא נשמר | בצ׳אט הזה בלבד | עד שהוא מתעדכן או נמחק | קבוע עד להשקת מודל חדש | עד שתערוך אותן |
מי שולט בו | אתה, במסגרת המגבלה שספק המודל קובע. | אתה והעוזר | חברת ה-AI | אתה |
דוגמה | שאלת הקצב ששאלת לפני דקה | שאתה מעדיף קילומטרים | איך תוכניות אימונים למרתון בנויות בדרך כלל | הוראה לעצב תוכניות אימונים בטבלה שבה השורות מייצגות שבועות והעמודות את ימי השבוע |
מה זיכרון AI מאחסן
עוזרים שומרים פרטים נבחרים עליך, כגון עובדות, העדפות וסיכומים, וחלקם גם נעזרים בצ׳אטים הקודמים שלך.
- עובדות והעדפות שאתה מבקש ממנו לזכור: אלה פרטים שאתה אומר לעוזר במפורש לשמור, כמו "תזכור שאני מעדיף קילומטרים." העוזר יוצר את הזיכרון כשאתה מבקש, והוא נשמר עד שתמחק אותו או ששיחה מאוחרת יותר תעדכן אותו.
- פרטים שהוא קולט מהשיחות שלך: העוזר שומר אותם כשההגדרה מופעלת. Perplexity "מעדיפה את תדירות השאלות שנשאלו והמידע שנמסר על ידי המשתמש," כך שדבר שאתה מזכיר לעיתים קרובות צפוי להישמר יותר מדבר שאתה מזכיר פעם אחת. הזיכרון נשמר עד שהוא מתעדכן או עד שתמחק אותו.
- הפניות לצ׳אטים הקודמים שלך: העוזר נעזר ישירות בשיחות קודמות במקום ברשימה שמורה. Perplexity מכנה זאת היסטוריית חיפוש: השאלות והתשובות הקודמות שלך, שמשמשות כדי להפוך תגובה חדשה לרלוונטית יותר.
איך זיכרון AI עובד
מודל ה-AI לא זוכר דבר בין שיחות. מערכת זיכרון ה-AI עושה את העבודה הזו: היא שומרת תיעוד נפרד עליך ומוסיפה את החלקים הרלוונטיים לכל שיחה חדשה. האחסון והאחזור מתבצעים מאחורי הקלעים, כך שהמודל קורא אותם לצד השאלה שלך.
התהליך הזה מתבצע בחמישה שלבים:
- שמירה: העוזר שומר זיכרון כשאתה מבקש ממנו, או כשהוא מעריך שפרט מסוים שווה שמירה.
- אחסון: הזיכרונות נכנסים למסד נתונים שנשמר בנפרד מהמודל. במערכות רבות זהו מסד נתונים וקטורי, כך שאפשר לחפש בהם לפי משמעות. הרשימה שמוצגת לך בהגדרות היא תצוגה של מאגר הזיכרון הזה.
- אחזור: כששולחים הודעה, העוזר מחליט אילו זיכרונות רלוונטיים. מערכות רבות עושות זאת על ידי המרת ההודעה שלך וכל זיכרון להטמעות (embeddings), ייצוגים מספריים של משמעות, ובחירת ההתאמות הקרובות ביותר. כך הן יכולות להיזכר בזיכרון גם כשאין לו מילים משותפות עם השאלה שלך. מערכות פשוטות יותר טוענות כל זיכרון שמור לכל שיחה.
- שימוש: הזיכרונות שאוחזרו מוכנסים כטקסט פשוט לקלט, בדרך כלל בבלוק של הוראות שהמודל קורא לפני ההודעה שלך. המודל מעבד אותם כמו כל טקסט אחר באותו קלט.
- עדכון והסרה: העוזר מחלץ עובדות מצ׳אטים, מחפש בזיכרונות הקיימים ומחליט אם להוסיף עובדה כזיכרון חדש, לעדכן זיכרון קיים, למזג אותה עם זיכרון קיים או למחוק זיכרון ישן שסותר ממצאים חדשים. חלק מהעוזרים מצמידים חותמת זמן לכל זיכרון כדי להבחין בין מידע חדש יותר לישן יותר.
אתגרים וסיכונים של זיכרון AI
זיכרון AI נועד לשפר את איכות התשובות, אבל מדדי ביצועים מראים שאחזור זיכרון לא תמיד מעלה מידע רלוונטי או עדכני, במיוחד ממסדי נתונים גדולים. הוא גם מציב סיכוני אבטחה ופרטיות.
בעיות אמינות ואבטחה נפוצות הקשורות לזיכרון AI כוללות:
- זיכרונות שמיושמים שלא במקומם: זיכרון עלול להישלף לתוך תשובה שאין לו שום קשר אליה. מחקר משנת 2026 בדק 18 מודלים כדי לראות אם זיכרון שמור מתחום אחד בחיים דולף לתשובה בתחום אחר. שיעור הכישלון החציוני היה 53%. המחקר מצא גם שברגע שהזיכרון הכיל את האמונות של המשתמשים או מומחיות שהם טענו לה, כמעט כל מודל הדהד אותן, גם אם השאלה דרשה תשובה ניטרלית.
- זיכרונות לא עדכניים: העוזר ממשיך לפעול לפי פרט מסוים גם אחרי ששיחה מאוחרת יותר הפכה אותו ללא נכון, במיוחד כשמעולם לא אמרת זאת במפורש. במדד ביצועים ממאי 2026, שבדק אם מודלים מבחינים בשינויים מרומזים כאלה, המודל הטוב ביותר השיג ממוצע של 55.2%.
- עומס זיכרון: ככל שעוזר צריך לקרוא יותר מידע, כך קשה לו יותר לזהות מה חשוב. LongMemEval, מדד ביצועים משנת 2024, מצא שמודלים שקראו היסטוריית צ׳אט של כ-115,000 טוקנים הציגו ביצועים גרועים ב-30% עד 60% ממודלים שקיבלו רק את ההפעלות הרלוונטיות.
- הרעלת זיכרון: מידע כוזב או הוראות נסתרות חודרים לזיכרון של העוזר, למשל דרך תוכן שאתה מבקש ממנו לקרוא, ומובילים לתשובות מוטות או לא בטוחות או לדליפות נתונים.
- סיכוני פרטיות: הזיכרון שומר פרטים אישיים מעבר לצ׳אט שממנו הם הגיעו, לפעמים לזמן ארוך יותר ממה שציפית. Perplexity, למשל, עשויה לשמור יומן של זיכרונות שנמחקו למשך עד 30 יום לצורכי בטיחות וניפוי באגים. חוקי הגנת המידע מתייחסים לזיכרונות מאוחסנים כמידע אישי, ולכן אמורה להיות לך אפשרות לבדוק ולמחוק אותם.
איך להציג, לערוך ולכבות את זיכרון ה-AI
אפשר לראות מה עוזר שמר, למחוק את זה, לכבות את הזיכרון או להשתמש בצ׳אט פרטי שלא יוצר זיכרונות.
ניהול זיכרון מסתכם בקומץ פקדים. הנה מה שכל אחד מהם עושה ומתי להשתמש בו:
פקד | מה הוא עושה | מתי להשתמש בו |
צפייה במה שנשמר | פותח את מאגר הזיכרון שלך, שבו אפשר לחפש, לסנן ולבדוק רשומות בודדות. | כשתשובה כוללת פרט שלא ציפית לו. |
מחיקת זיכרון | מסיר את הרשומה, והעוזר מפסיק להשתמש בה בתשובות הבאות (עוזרים עשויים לשמור יומן של זיכרונות שנמחקו לפרק זמן מסוים). | כשזיכרון שגוי, לא עדכני או רגיש. |
כיבוי הזיכרון | מונע מהעוזר להסתמך על הזיכרון בתשובות עתידיות (ייתכן שהוא לא ימחק זיכרונות שכבר מאוחסנים - כדאי לבדוק את העוזר שלך). | כשרוצים תשובות ללא התאמה אישית |
כיבוי היסטוריית החיפוש | מונע מהעוזר להשתמש בשאלות ובתשובות הקודמות שלך. מחיקת הפעלה מהיסטוריית החיפוש מבטלת את השפעתה על תשובות מאוחרות יותר. | כששיחות קודמות משפיעות על התשובות, כדאי להתחיל מחדש. |
שימוש בצ׳אט בגלישה בסתר | הזיכרון והיסטוריית החיפושים תמיד כבויים, והשאלות שנשאלות שם אף פעם לא נשמרות ולא משמשות בזיכרון. | לנושאים חד־פעמיים או רגישים. |
כדי להתחיל מדף חלק, כבו את הזיכרון ומחקו את מה שנשמר.
איך Perplexity מנהלת את הזיכרון
הזיכרון של Perplexity פועל בכל המודלים שהיא מציעה.
Perplexity מתאימה אישית את התשובות על סמך שני מקורות: זיכרונות, כלומר ההעדפות והפרטים שאתם משתפים, והיסטוריית החיפושים שלכם. כשזיכרון משפיע על תשובה, הוא מופיע בין המקורות של אותה תשובה, כך שתוכלו לראות באילו זיכרונות נעשה שימוש ולמחוק כל אחד מהם.
אפשר גם להתאים אישית את התשובות באמצעות פרטים עליכם ובאמצעות הוראות מותאמות אישית עבור פרויקטים (לכל פרויקט יש שכבת זיכרון משלו).
Perplexity עשויה להשתמש בתוכן הזיכרון כדי לשפר את המודלים שלה בחשבונות צרכנים (אף פעם לא בחשבונות Enterprise), אלא אם תכבו את האפשרות הזו ("שמירת נתוני AI" בהגדרות ← העדפות ← בינה מלאכותית).
מנויי Max ו-Enterprise Max מקבלים גם את Brain, שכבת זיכרון משותפת שמרחיבה את הזיכרון באמצעות מעקב אחר הפרויקטים והעבודה שלכם. יש לה מתג משלה, והיא מתעלמת מסשנים בגלישה בסתר.
נסו את Perplexity ובדקו איך זיכרונות מעצבים את התשובה הבאה שלכם.
שאלות נפוצות על זיכרון בבינה מלאכותית
מהו זיכרון מוגבל בבינה מלאכותית?
IBM מגדירה בינה מלאכותית עם זיכרון מוגבל כבינה מלאכותית שיכולה להיזכר באירועים ובתוצאות מהעבר ולעקוב אחר מצבים לאורך זמן, אך אינה יכולה לשמור את הנתונים האלה בספרייה ארוכת טווח של חוויות עבר. זוהי אחת מארבע קטגוריות בטקסונומיה של מערכות בינה מלאכותית, ו-IBM משייכת אליה צ׳אטבוטים ועוזרים וירטואליים.
זיכרון של עוזר הוא זיכרון חיצוני שהמערכות האלה מוסיפות מעליהן. הוא נשמר בין סשנים, כך שעוזר יכול להשתמש בפרטים ששיתפתם בשיחה קודמת.
לאיזה עוזר בינה מלאכותית יש את הזיכרון הטוב ביותר?
אין עוזר אחד שהוא הטוב ביותר לכולם. זיכרון טוב הוא זיכרון שאפשר לשלוט בו, לכן כדאי להעריך כלי בינה מלאכותית באמצעות ארבע שאלות: האם אפשר לראות מה הוא שמר? האם אפשר למחוק זיכרון בנפרד מהצ׳אט שממנו הוא הגיע? האם האימון הוא הגדרה נפרדת מהזיכרון? האם יש מצב זמני או מצב גלישה בסתר שלא יוצר זיכרונות?
האם מודל בינה מלאכותית לומד ממה שהוא זוכר עליכם?
שימוש בזיכרון בתשובה הוא תהליך שונה מאימון. Perplexity מציינת שהיא מאחזרת הקשר רלוונטי ממאגר הזיכרון שלכם במקום להתייחס להיסטוריה שלכם כנתוני אימון. האפשרות להשתמש בתוכן שלכם לשיפור מודלים היא הגדרה נפרדת. בחשבונות צרכנים, Perplexity עשויה להשתמש בתוכן הזיכרון למטרה זו, ו"שמירת נתוני AI" מכבה את האפשרות הזו.
מה לא כדאי לשמור בזיכרון של בינה מלאכותית?
כדאי להרחיק מהזיכרון של הבינה המלאכותית כל דבר שלא הייתם רוצים שיישמר, שישמש ליצירת פרופיל עליכם או שיחזור מאוחר יותר: פרטי זהות ופרטים פיננסיים, מידע רפואי, סיסמאות, מידע על אנשים אחרים וכל דבר שקשור לילדים. משרד נציב הפרטיות של קנדה (מאי 2025) והמרכז הלאומי לאבטחת סייבר של בריטניה (מרץ 2023) ממליצים לוותר על כל הנחיה שעלולה לגרום לבעיות אם תתפרסם.
מסננים מפחיתים סיכוני פרטיות, אבל לא מבטיחים שהמידע הרפואי או הפיננסי שלכם לא יישמר כלל, לכן כדאי לעבור על מאגר הזיכרונות שלכם ולהשתמש בגלישה בסתר לשאלות רגישות חד־פעמיות.