
AI मेमोरी: यह क्या है, कैसे काम करती है, और क्या स्टोर करती है
AI मेमोरी की एक गाइड: AI असिस्टेंट पिछली बातचीत के विवरण कैसे सहेजते और याद करते हैं, वे क्या स्टोर करते हैं, मेमोरी में कहाँ गड़बड़ी होती है, और इसे कैसे देखें, संपादित करें या बंद करें।
AI मेमोरी वह जानकारी है जिसे एक संवादात्मक AI असिस्टेंट आपकी पिछली बातचीत से सहेजता है और नई बातचीत में साथ लाता है, ताकि वह आपकी प्राथमिकताओं और संदर्भ को याद रख सके। मॉडल खुद इसमें से कुछ भी नहीं रखता। असिस्टेंट इसे अलग से संग्रहीत करता है और प्रासंगिक होने पर इसे वापस जोड़ देता है, जिससे मॉडल को वह स्थायी संदर्भ मिलता है जो उसके पास अन्यथा नहीं होता।
यह गाइड बताती है कि असिस्टेंट उस जानकारी को कैसे सहेजते और याद करते हैं, वे क्या संग्रहीत करते हैं, वे कभी-कभी गलती क्यों करते हैं, और आप इसे कैसे देख, बदल या बंद कर सकते हैं।
AI मेमोरी क्या है?
AI मेमोरी, जिसे स्थायी मेमोरी भी कहा जाता है, AI असिस्टेंट की एक ऐसी सुविधा है जो आपके बारे में जानकारी संग्रहीत करती है, जैसे पिछली बातचीत से मिली प्राथमिकताएँ, तथ्य और संदर्भ, जिनका उपयोग असिस्टेंट बाद की बातचीत में कर सकता है।
AI असिस्टेंट यह रिकॉर्ड उन बातों से बना सकता है जिन्हें याद रखने के लिए आप उससे कहते हैं, उन विवरणों से जिन्हें वह खुद समझ लेता है, और उन पिछली चैट से जिनका वह दोबारा हवाला दे सकता है।
AI मेमोरी लेयर की मदद से AI असिस्टेंट आपको हर चैट में अपनी प्राथमिकताएँ बताए बिना व्यक्तिगत जवाब दे पाते हैं। अगर आपने असिस्टेंट को बताया है कि आप मैराथन की तैयारी कर रहे हैं और किलोमीटर पसंद करते हैं, तो पेसिंग से जुड़े आपके अगले सवाल का जवाब आपके दोबारा बताए बिना किलोमीटर में मिलेगा।
हर चैट में अपनी स्थिति दोबारा बताने की तुलना में, मेमोरी आपको टाइप करने से बचाती है और प्रॉम्प्ट को छोटा रखती है, जो इसलिए मायने रखता है क्योंकि लंबे इनपुट से जवाबों की सटीकता कम हो जाती है।
मेमोरी हर बातचीत का ट्रांसक्रिप्ट नहीं, बल्कि आपके बारे में मुख्य तथ्यों का संग्रह है। इसलिए उसे याद रहेगा कि आप किलोमीटर पसंद करते हैं। पिछले महीने उसके द्वारा तैयार किया गया सटीक ट्रेनिंग प्लान ढूँढ पाना इस पर निर्भर करता है कि असिस्टेंट पिछली चैट भी खोज सकता है या नहीं।
AI मेमोरी के प्रकार
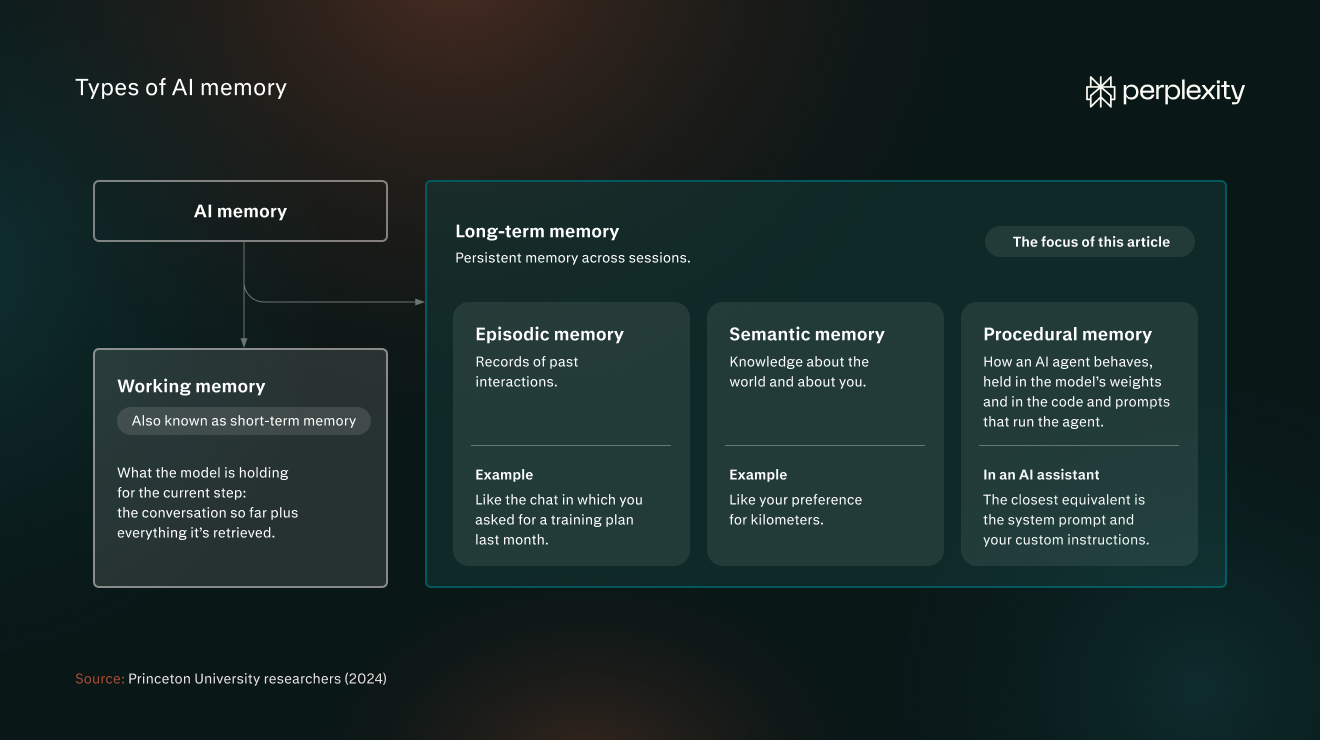
प्रिंसटन विश्वविद्यालय के शोधकर्ताओं (2024) ने AI मेमोरी सिस्टम के प्रकारों को वर्गीकृत करने के लिए मानव स्मृति विज्ञान से शब्दावली ली है। उनका फ़्रेमवर्क वर्किंग मेमोरी को दीर्घकालिक मेमोरी से अलग करता है:
- वर्किंग मेमोरी: मॉडल वर्तमान चरण के लिए जो कुछ रखे हुए है, यानी अब तक की बातचीत और उसके द्वारा प्राप्त की गई हर जानकारी। इसे अल्पकालिक मेमोरी भी कहा जाता है।
- दीर्घकालिक मेमोरी: सत्रों के पार बनी रहने वाली स्थायी मेमोरी। यह लेख इसी प्रकार की मेमोरी के बारे में है।
दीर्घकालिक मेमोरी में तीन प्रकार की मेमोरी होती हैं:
- एपिसोडिक मेमोरी: पिछली बातचीत के रिकॉर्ड, जैसे वह चैट जिसमें आपने पिछले महीने ट्रेनिंग प्लान माँगा था।
- सिमेंटिक मेमोरी: दुनिया के बारे में और आपके बारे में ज्ञान, जैसे किलोमीटर के लिए आपकी पसंद।
- प्रोसीजरल मेमोरी: कोई AI एजेंट कैसे व्यवहार करता है, जो मॉडल के वेट्स में और एजेंट को चलाने वाले कोड और प्रॉम्प्ट में निहित होता है। AI असिस्टेंट में इसका सबसे करीबी समकक्ष सिस्टम प्रॉम्प्ट और आपके कस्टम निर्देश हैं।
AI असिस्टेंट मेमोरी बनाम AI एजेंट मेमोरी
AI असिस्टेंट मेमोरी और AI एजेंट मेमोरी, दोनों दीर्घकालिक मेमोरी हैं। AI असिस्टेंट मेमोरी ज़्यादातर सिमेंटिक मेमोरी होती है और आपके बारे में तथ्य संग्रहीत करती है, ताकि जवाब आपके अनुरूप हों। एजेंट मेमोरी, जैसे Perplexity का Brain, यह संग्रहीत करती है कि एजेंट ने क्या किया और वह कैसा रहा, जिसमें यह भी शामिल है कि क्या कारगर रहा और आपने क्या सुधारा, ताकि वह हर नया काम बेहतर स्थिति से शुरू करे।
AI असिस्टेंट मेमोरी | AI एजेंट मेमोरी | |
यह क्या याद रखती है | आपको | काम और उसका इतिहास |
यह किसलिए है | आपके अनुरूप जवाब | दोबारा शुरुआत किए बिना कई चरणों वाला काम जारी रखना |
उदाहरण | याद रखती है कि आप किलोमीटर पसंद करते हैं | आपका मैराथन ट्रेनिंग प्लान, उसमें किए गए अपने बदलाव और अब तक आपके पूरे किए गए सत्र याद रखती है, ताकि आगे के ब्लॉक का बेहतर प्लान बना सके |
AI मेमोरी बनाम कॉन्टेक्स्ट विंडो, ट्रेनिंग डेटा और कस्टम निर्देश
AI मेमोरी को आसानी से उन तीन अन्य चीज़ों के साथ भ्रमित किया जा सकता है जो किसी जवाब को आकार देती हैं: मॉडल की कॉन्टेक्स्ट विंडो, ट्रेनिंग डेटा और कस्टम निर्देश। हर एक में अलग जानकारी होती है, वह अलग-अलग समय तक बनी रहती है, और उसे एक अलग सिस्टम नियंत्रित करता है।
कॉन्टेक्स्ट विंडो टेक्स्ट की वह मात्रा है जिसे एक लार्ज लैंग्वेज मॉडल (LLM) एक बार में पढ़ सकता है, और इसमें वर्तमान बातचीत शामिल होती है। जब आप नई चैट शुरू करते हैं, तो यह रीसेट हो जाती है।
कुछ मौजूदा मॉडल में दस लाख या उससे अधिक टोकन की बड़ी कॉन्टेक्स्ट विंडो होती है, इसलिए तकनीकी रूप से आप अपनी मुख्य जानकारी हर बातचीत में पेस्ट कर सकते हैं। लेकिन इस सबको प्रोसेस करने से लेटेंसी और लागत बढ़ती है।
कई अध्ययनों में यह भी पाया गया है कि इनपुट बढ़ने के साथ आउटपुट की सटीकता घटती है, भले ही जवाब कॉन्टेक्स्ट में मौजूद हो।
2025 के इलिनॉय विश्वविद्यालय और Amazon के एक अध्ययन में ऐसा तब भी देखा गया जब मॉडल हर प्रासंगिक विवरण दोहरा सकते थे: इनपुट के 30,000 टोकन तक बढ़ने पर सटीकता 13.9% से 85% तक गिर गई, जो मॉडल की दावा की गई सीमाओं से बहुत कम है। Adobe Research और LMU Munich के 2025 के बेंचमार्क NoLiMa ने पाया कि जब भी प्रश्न और उत्तर में कोई साझा कीवर्ड नहीं था, तो परीक्षण किए गए 13 में से 11 मॉडल ने सिर्फ़ 32,000 टोकन पर ही काफ़ी कमज़ोर प्रदर्शन किया। Chroma की जुलाई 2025 की रिपोर्ट में यह 18 मॉडल में देखा गया, जिसमें वह स्थिति भी शामिल थी जब उन्होंने 1,13,000 टोकन के चैट इतिहास से जवाब दिया।
ट्रेनिंग डेटा वह जानकारी है जो रिलीज़ से पहले मॉडल के वेट्स में निहित कर दी जाती है। उपयोगकर्ता इसे बदल नहीं सकते। डेवलपर नए डेटा पर किसी मॉडल को फ़ाइन-ट्यून कर सकते हैं, लेकिन वह एक इंजीनियरिंग प्रक्रिया है, उपयोगकर्ता सेटिंग नहीं।
कस्टम निर्देश असिस्टेंट सेटिंग्स में सहेजे गए नियम हैं, जिन्हें आप AI असिस्टेंट के व्यवहार और आउटपुट को कस्टमाइज़ करने के लिए खुद लिखते और संपादित करते हैं। उदाहरण के लिए, आप कस्टम निर्देशों का उपयोग जवाबों का लहजा और शैली तय करने के लिए, या यह तय करने के लिए कर सकते हैं कि असिस्टेंट किन स्रोतों का उपयोग कर सकता है।
चारों की तुलना इस प्रकार है:
कॉन्टेक्स्ट विंडो | AI मेमोरी | ट्रेनिंग डेटा | कस्टम निर्देश | |
इसमें क्या होता है | वर्तमान चैट के संदेश | आपके बारे में सहेजे गए तथ्य और प्राथमिकताएँ | रिलीज़ से पहले मॉडल ने जो सीखा | आपके द्वारा खुद लिखे गए दिशानिर्देश |
यह कितने समय तक रहता है | केवल यही चैट | जब तक इसे अपडेट या डिलीट नहीं किया जाता | नया मॉडल रिलीज़ होने तक स्थिर | जब तक आप इसे संपादित नहीं करते |
इसे कौन नियंत्रित करता है | आप, मॉडल प्रदाता द्वारा तय की गई सीमा के भीतर। | आप और असिस्टेंट | AI कंपनी | आप |
उदाहरण | पेसिंग से जुड़ा वह सवाल जो आपने एक मिनट पहले पूछा था | यह कि आप किलोमीटर पसंद करते हैं | मैराथन ट्रेनिंग प्लान की सामान्य संरचना कैसी होती है | ट्रेनिंग प्लान को एक ग्रिड में फ़ॉर्मैट करने का निर्देश, जिसमें पंक्तियाँ सप्ताह और कॉलम सप्ताह के दिन दर्शाते हैं |
AI मेमोरी क्या संग्रहीत करती है
असिस्टेंट आपके बारे में चुनिंदा विवरण रखते हैं, जैसे तथ्य, प्राथमिकताएँ और सारांश, और कुछ आपकी पिछली चैट का भी उपयोग करते हैं।
- वे तथ्य और प्राथमिकताएँ जिन्हें आप याद रखने के लिए कहते हैं: ये वे विवरण हैं जिन्हें सहेजने के लिए आप असिस्टेंट से स्पष्ट रूप से कहते हैं, जैसे "याद रखना कि मुझे किलोमीटर पसंद हैं।" जब आप कहते हैं, तब असिस्टेंट मेमोरी बनाता है, और यह तब तक बनी रहती है जब तक आप इसे डिलीट नहीं करते या बाद की कोई बातचीत इसे अपडेट नहीं करती।
- आपकी बातचीत से समझे गए विवरण: सेटिंग चालू होने पर असिस्टेंट इन्हें सहेजता है। Perplexity "उपयोगकर्ता द्वारा पूछे गए प्रश्नों और दी गई जानकारी की आवृत्ति को प्राथमिकता देता है," इसलिए जिस बात का आप अक्सर ज़िक्र करते हैं, उसके याद रहने की संभावना उस बात से ज़्यादा होती है जिसका ज़िक्र आप एक बार करते हैं। मेमोरी तब तक बनी रहती है जब तक इसे अपडेट नहीं किया जाता या आप इसे डिलीट नहीं करते।
- आपकी पिछली चैट के संदर्भ: असिस्टेंट किसी सहेजी गई सूची के बजाय सीधे पिछली बातचीत का उपयोग करता है। Perplexity इसे खोज इतिहास कहता है: आपके पिछले प्रश्न और उत्तर, जिनका उपयोग नए जवाब को अधिक प्रासंगिक बनाने के लिए किया जाता है।
AI मेमोरी कैसे काम करती है
AI मॉडल बातचीत के बीच कुछ भी याद नहीं रखता। यह काम AI मेमोरी सिस्टम करता है: वह आपके बारे में एक अलग रिकॉर्ड रखता है और हर नई बातचीत में उसके प्रासंगिक हिस्से जोड़ता है। स्टोरेज और रिट्रीवल पर्दे के पीछे होते हैं, इसलिए मॉडल उन्हें आपके प्रश्न के साथ पढ़ता है।
यह प्रक्रिया पाँच चरणों में चलती है:
- सहेजना: जब आप कहते हैं, या जब असिस्टेंट किसी विवरण को रखने लायक समझता है, तब वह एक मेमोरी सहेजता है।
- संग्रहीत करना: मेमोरी मॉडल से अलग रखे गए एक डेटाबेस में जाती हैं। कई सिस्टम में यह एक वेक्टर डेटाबेस होता है, ताकि उन्हें अर्थ के आधार पर खोजा जा सके। सेटिंग्स में आपको जो सूची दिखती है, वह उसी मेमोरी स्टोर का एक व्यू है।
- रिट्रीवल: जब आप कोई संदेश भेजते हैं, तो असिस्टेंट तय करता है कि कौन-सी मेमोरी लागू होती हैं। कई सिस्टम ऐसा आपके संदेश और हर मेमोरी को एम्बेडिंग, यानी अर्थ के संख्यात्मक निरूपण, में बदलकर और सबसे करीबी मिलान चुनकर करते हैं। इसी वजह से वे किसी मेमोरी को तब भी याद कर पाते हैं जब उसमें और आपके प्रश्न में कोई शब्द साझा न हो। सरल सिस्टम हर सहेजी गई मेमोरी को हर बातचीत में लोड कर देते हैं।
- उपयोग: याद की गई मेमोरी को सादे टेक्स्ट के रूप में इनपुट में जोड़ा जाता है, आम तौर पर निर्देशों के एक ब्लॉक में, जिसे मॉडल आपके संदेश से पहले पढ़ता है। मॉडल उन्हें उस इनपुट के किसी भी अन्य टेक्स्ट की तरह प्रोसेस करता है।
- अपडेट करना और हटाना: असिस्टेंट चैट से तथ्य निकालता है, मौजूदा मेमोरी खोजता है, और तय करता है कि उसे नई मेमोरी के रूप में जोड़ना है, किसी मौजूदा मेमोरी को अपडेट करना है, किसी के साथ मर्ज करना है, या नई जानकारी से विरोधाभासी किसी पुरानी मेमोरी को डिलीट करना है। कुछ असिस्टेंट नई जानकारी को पुरानी से अलग पहचानने के लिए हर मेमोरी पर टाइमस्टैम्प लगाते हैं।
AI मेमोरी की चुनौतियाँ और जोखिम
AI मेमोरी का उद्देश्य जवाबों की गुणवत्ता सुधारना है, लेकिन बेंचमार्क दिखाते हैं कि मेमोरी रिट्रीवल हमेशा प्रासंगिक या ताज़ा जानकारी सामने नहीं लाता, खासकर बड़े डेटाबेस से। इससे सुरक्षा और गोपनीयता के जोखिम भी पैदा होते हैं।
AI मेमोरी से जुड़ी आम विश्वसनीयता और सुरक्षा समस्याओं में ये शामिल हैं:
- गलत तरीके से लागू मेमोरी: किसी मेमोरी को ऐसे जवाब में खींचा जा सकता है जिससे उसका कोई लेना-देना नहीं है। 2026 के एक अध्ययन में 18 मॉडल का परीक्षण किया गया कि क्या जीवन के एक क्षेत्र से सहेजी गई मेमोरी किसी दूसरे क्षेत्र के जवाब में लीक हो जाती है। मीडियन विफलता दर 53% थी। अध्ययन में यह भी पाया गया कि जब मेमोरी में उपयोगकर्ताओं की मान्यताएँ या उनकी दावा की गई विशेषज्ञता दर्ज हो जाती थी, तो लगभग हर मॉडल उन्हें दोहराता था, भले ही प्रश्न के लिए तटस्थ जवाब ज़रूरी हो।
- पुरानी पड़ चुकी मेमोरी: बाद की किसी बातचीत से कोई विवरण गलत साबित हो जाने के बाद भी असिस्टेंट उसी के आधार पर काम करता रहता है, खासकर तब जब आपने यह बात कभी स्पष्ट रूप से नहीं कही। मई 2026 के एक बेंचमार्क में, जिसने यह परखा कि क्या मॉडल ऐसे अप्रत्यक्ष बदलावों को पहचानते हैं, सबसे अच्छे मॉडल का औसत स्कोर 55.2% रहा।
- मेमोरी ओवरलोड: असिस्टेंट को जितना ज़्यादा दोबारा पढ़ना पड़ता है, उसके लिए यह पहचानना उतना ही मुश्किल होता है कि क्या ज़रूरी है। 2024 के बेंचमार्क LongMemEval ने पाया कि लगभग 1,15,000 टोकन का चैट इतिहास पढ़ने वाले मॉडल ने उन मॉडल की तुलना में 30% से 60% तक खराब प्रदर्शन किया, जिन्हें केवल प्रासंगिक सत्र दिए गए थे।
- मेमोरी पॉइज़निंग: गलत जानकारी या छिपे हुए निर्देश असिस्टेंट की मेमोरी में पहुँच जाते हैं, उदाहरण के लिए, उस कंटेंट के ज़रिए जिसे आप उसे पढ़ने के लिए कहते हैं, जिससे पक्षपाती या असुरक्षित जवाब मिलते हैं या डेटा लीक होता है।
- गोपनीयता जोखिम: मेमोरी व्यक्तिगत विवरणों को उस चैट के बाद भी रखती है जिससे वे आए थे, कभी-कभी आपकी अपेक्षा से अधिक समय तक। उदाहरण के लिए, Perplexity सुरक्षा और डीबगिंग के लिए डिलीट की गई मेमोरी का लॉग 30 दिनों तक रख सकता है। डेटा-संरक्षण कानून संग्रहीत मेमोरी को व्यक्तिगत डेटा मानता है, इसलिए आपको उन्हें देखने और डिलीट करने में सक्षम होना चाहिए।
AI मेमोरी को कैसे देखें, संपादित करें और बंद करें
आप देख सकते हैं कि असिस्टेंट ने क्या सहेजा है, उसे डिलीट कर सकते हैं, मेमोरी बंद कर सकते हैं, या ऐसी निजी चैट का उपयोग कर सकते हैं जो मेमोरी नहीं बनाती।
मेमोरी प्रबंधन कुछ ही नियंत्रणों पर निर्भर करता है। यहाँ बताया गया है कि हर एक क्या करता है और उसका उपयोग कब करें:
नियंत्रण | यह क्या करता है | इसका उपयोग कब करें |
देखें कि क्या सहेजा गया है | आपका मेमोरी बैंक खोलता है, जहाँ आप अलग-अलग एंट्री को खोज, फ़िल्टर और देख सकते हैं। | जब किसी जवाब में कोई ऐसा विवरण हो जिसकी आपको उम्मीद नहीं थी। |
मेमोरी डिलीट करें | एंट्री को हटा देता है, और असिस्टेंट बाद के जवाबों में उसका उपयोग बंद कर देता है (असिस्टेंट कुछ समय तक हटाई गई मेमोरी का लॉग रख सकते हैं)। | जब कोई मेमोरी गलत, पुरानी या संवेदनशील हो। |
मेमोरी बंद करें | असिस्टेंट को भविष्य के जवाबों में मेमोरी का संदर्भ लेने से रोकता है (हो सकता है कि यह पहले से संग्रहीत मेमोरी को न हटाए - अपना असिस्टेंट जाँचें)। | जब आप पर्सनलाइज़ेशन के बिना जवाब चाहते हों |
खोज इतिहास बंद करें | असिस्टेंट को आपके पिछले प्रश्नों और उत्तरों का उपयोग करने से रोकता है। अपने खोज इतिहास से किसी सत्र को डिलीट करने पर बाद के जवाबों पर उसका प्रभाव खत्म हो जाता है। | जब पिछली बातचीत उत्तरों को प्रभावित कर रही हो और आप नए सिरे से शुरुआत करना चाहें। |
गुप्त चैट का उपयोग करें | मेमोरी और खोज इतिहास हमेशा बंद रहते हैं, और वहाँ पूछे गए प्रश्न न तो कभी सहेजे जाते हैं और न ही मेमोरी में उपयोग किए जाते हैं। | एक बार के या संवेदनशील विषयों के लिए। |
पूरी तरह नई शुरुआत के लिए, मेमोरी बंद करें और जो कुछ सहेजा गया है उसे साफ़ करें।
Perplexity मेमोरी को कैसे संभालता है
Perplexity मेमोरी उसके द्वारा उपलब्ध कराए गए हर मॉडल में काम करती है।
Perplexity दो स्रोतों से उत्तरों को वैयक्तिकृत करता है: मेमोरी, यानी वे प्राथमिकताएँ और विवरण जो आप साझा करते हैं, और आपका खोज इतिहास। जब कोई मेमोरी किसी उत्तर को आकार देती है, तो वह उस उत्तर के स्रोतों में दिखाई देती है, ताकि आप देख सकें कि कौन-सी मेमोरी उपयोग की गईं और उनमें से किसी को भी हटा सकें।
आप अपने बारे में विवरण देकर और प्रोजेक्ट के लिए कस्टम निर्देश देकर भी अपने उत्तरों को वैयक्तिकृत कर सकते हैं (हर प्रोजेक्ट की अपनी मेमोरी लेयर होती है)।
Perplexity उपभोक्ता खातों पर अपने मॉडलों को बेहतर बनाने के लिए मेमोरी सामग्री का उपयोग कर सकता है (Enterprise खातों पर कभी नहीं), जब तक कि आप इसे बंद न करें (सेटिंग्स → प्राथमिकताएँ → आर्टिफ़िशियल इंटेलिजेंस में AI डेटा प्रतिधारण)।
Max और Enterprise Max सब्सक्राइबर्स को Brain भी मिलता है, जो एक साझा मेमोरी लेयर है और आपके प्रोजेक्ट और काम को ट्रैक करके मेमोरी को और आगे ले जाता है। इसका अपना टॉगल है और यह गुप्त सत्रों को अनदेखा करता है।
Perplexity आज़माएँ और देखें कि मेमोरी आपके अगले उत्तर को कैसे आकार देती है।
AI मेमोरी से जुड़े अक्सर पूछे जाने वाले प्रश्न
AI में सीमित मेमोरी क्या है?
IBM की परिभाषा के अनुसार, सीमित मेमोरी AI वह AI है जो पिछली घटनाओं और परिणामों को याद रख सकता है और समय के साथ स्थितियों की निगरानी कर सकता है, लेकिन उस डेटा को पिछले अनुभवों की दीर्घकालिक लाइब्रेरी में नहीं रख सकता। यह AI सिस्टम के एक वर्गीकरण की चार श्रेणियों में से एक है, और IBM चैटबॉट और वर्चुअल असिस्टेंट को इसी श्रेणी में रखता है।
असिस्टेंट मेमोरी वह बाहरी मेमोरी है जिसे ये सिस्टम ऊपर से जोड़ते हैं। यह सभी सत्रों में बनी रहती है, इसलिए असिस्टेंट उन विवरणों का उपयोग कर सकता है जो आपने किसी पिछली बातचीत में साझा किए थे।
किस AI असिस्टेंट की मेमोरी सबसे अच्छी है?
कोई एक असिस्टेंट सबके लिए सबसे अच्छा नहीं होता। अच्छी मेमोरी वह है जिसे आप नियंत्रित कर सकें, इसलिए AI टूल्स का मूल्यांकन ये चार प्रश्न पूछकर करें: क्या आप देख सकते हैं कि उसने क्या सहेजा है? क्या आप किसी मेमोरी को उस चैट से अलग हटा सकते हैं जिससे वह बनी थी? क्या ट्रेनिंग की सेटिंग मेमोरी से अलग है? क्या कोई अस्थायी या गुप्त मोड है जो कोई मेमोरी नहीं बनाता?
क्या कोई AI मॉडल आपके बारे में याद रखी गई बातों से सीखता है?
किसी उत्तर में मेमोरी का उपयोग करना ट्रेनिंग से अलग प्रक्रिया है। Perplexity के अनुसार, वह आपके इतिहास को ट्रेनिंग डेटा मानने के बजाय आपके मेमोरी स्टोर से प्रासंगिक संदर्भ प्राप्त करता है। आपकी सामग्री का उपयोग मॉडलों को बेहतर बनाने के लिए किया जा सकता है या नहीं, यह एक अलग सेटिंग है। उपभोक्ता खातों पर Perplexity इस उद्देश्य के लिए मेमोरी सामग्री का उपयोग कर सकता है, और AI डेटा प्रतिधारण इसे बंद कर देता है।
आपको किन चीज़ों को AI मेमोरी से दूर रखना चाहिए?
ऐसी कोई भी चीज़ AI मेमोरी से दूर रखें जिसे आप सहेजा जाना, अपनी प्रोफ़ाइल बनाने के लिए उपयोग किया जाना, या बाद में दोहराया जाना नहीं चाहेंगे: पहचान और वित्तीय विवरण, स्वास्थ्य संबंधी जानकारी, पासवर्ड, अन्य लोगों की जानकारी, और बच्चों से जुड़ी कोई भी बात। कनाडा का ऑफ़िस ऑफ़ द प्राइवेसी कमिश्नर (मई 2025) और UK नेशनल साइबर सिक्योरिटी सेंटर (मार्च 2023) ऐसे किसी भी प्रॉम्प्ट से बचने की सलाह देते हैं जो सार्वजनिक होने पर समस्या पैदा कर सकता है।
फ़िल्टर गोपनीयता जोखिमों को कम करते हैं, लेकिन इस बात की गारंटी नहीं देते कि आपकी स्वास्थ्य या वित्तीय जानकारी बिल्कुल भी सहेजी नहीं जाएगी, इसलिए अपने मेमोरी बैंक की समीक्षा करें और एक बार के संवेदनशील प्रश्नों के लिए गुप्त मोड का उपयोग करें।