
सर्च इंजन के प्रकार: क्रॉलर, मेटा सर्च और AI उत्तर इंजन
क्रॉलर-आधारित, मेटा सर्च और AI उत्तर इंजन परिणाम कैसे ढूँढते और दिखाते हैं, साथ ही सर्च इंजन के अन्य प्रकार भी, गोपनीयता-केंद्रित और सशुल्क से लेकर वर्टिकल, क्षेत्रीय और एंटरप्राइज़ तक।
सर्च इंजन के प्रकारों में मुख्य अंतर यह है कि वे जानकारी कहाँ से लेते हैं और किस तरह के नतीजे दिखाते हैं।
क्रॉलर-आधारित इंजन अपने बनाए इंडेक्स में खोज करते हैं, जबकि मेटा सर्च इंजन कई दूसरे इंजनों के नतीजों को मिलाकर दिखाते हैं। AI आंसर इंजन भी इंडेक्स किए गए स्रोतों का इस्तेमाल करते हैं, लेकिन बाकी प्रकारों से अलग, वे आपको लिंक की सूची नहीं देते; वे उस जानकारी से आपके लिए खास तौर पर तैयार किया गया जवाब लिखते हैं।
यहाँ उदाहरणों के साथ जानिए कि तीन मुख्य प्रकार के सर्च इंजन कैसे काम करते हैं। हम उन दूसरे प्रकारों के बारे में भी बताते हैं जो आपको देखने को मिलेंगे (प्राइवेसी-केंद्रित, पेड, वर्टिकल, क्षेत्रीय और एंटरप्राइज़ इंजन, साथ ही वेब डायरेक्टरी), और ऐसे सवाल भी, जो आपको इनमें से कोई एक चुनने में मदद करेंगे।
सर्च इंजन क्या है?
सर्च इंजन एक सॉफ़्टवेयर है जो आपकी सर्च क्वेरी से मेल खाने वाला कंटेंट ढूंढता है और उसे सर्च नतीजों के रूप में दिखाता है।
इंटरनेट सर्च इंजन, जैसे Google या Bing, वर्ल्ड वाइड वेब पर खोज करते हैं, जबकि कुछ दूसरे इंजन किसी खास संग्रह के भीतर खोज करते हैं, जैसे कोई जॉब बोर्ड या रिसर्च पेपर डेटाबेस।
प्रकार के आधार पर, सर्च नतीजा पेजों के लिंक की रैंक की गई सूची हो सकता है या मिले हुए स्रोतों से तैयार किया गया लिखित जवाब।
सर्च इंजन बनाम वेब ब्राउज़र
वेब ब्राउज़र वह ऐप है जिससे आप वेब पेज खोलते और देखते हैं, जैसे Perplexity का Comet, Chrome, Safari, Edge या Firefox, जबकि सर्च इंजन एक ऐसी सेवा है जो आपके लिए वे पेज ढूंढती है।
जब आप ब्राउज़र के एड्रेस बार में कोई वेब पता टाइप करते हैं, तो वह आपको उस पेज पर ले जाता है। अगर आप इसके बजाय कोई सर्च टर्म टाइप करते हैं, तो ब्राउज़र उसे अपने डिफ़ॉल्ट सर्च इंजन को भेज देता है (Comet के लिए Perplexity, Chrome के लिए Google Search, Edge के लिए Bing), जब तक कि आप अपने ब्राउज़र की सेटिंग में डिफ़ॉल्ट न बदल दें
सर्च इंजन के तीन मुख्य प्रकार
सर्च इंजन इस बात में अलग होते हैं कि उनके नतीजे कहाँ से आते हैं और वे कैसे दिखते हैं। नतीजे इंजन के अपने इंडेक्स से, लाइसेंस के तहत किसी दूसरे इंजन के इंडेक्स से, या एक साथ कई इंजनों से आ सकते हैं, और वे पेजों की रैंक की गई सूची या उद्धरणों के साथ लिखा गया जवाब होते हैं।
क्रॉलर-आधारित और मेटा सर्च इंजन, दोनों लिंक की रैंक की गई सूची दिखाते हैं, लेकिन वे अपने नतीजे अलग-अलग तरीके से पाते हैं: क्रॉलर-आधारित इंजन अपने बनाए इंडेक्स में खोज करता है, जबकि मेटा सर्च इंजन आपकी क्वेरी कई दूसरे इंजनों को भेजता है और उनसे मिले नतीजों को मिला देता है।
AI आंसर इंजन भी इंडेक्स में खोज करते हैं, लेकिन पारंपरिक सर्च इंजनों की तरह पेजों की सूची देने के बजाय, वे एक जवाब लिखते हैं। अब कई इंजन दोनों काम करते हैं। Google, Bing और Brave Search अपने रैंक किए गए लिंक के ऊपर AI द्वारा लिखे गए जवाब जोड़ते हैं।
प्रकार | नतीजे कहाँ से आते हैं | आपको क्या मिलता है | किसके लिए सबसे अच्छा | कमी | उदाहरण |
क्रॉलर-आधारित | अपना इंडेक्स, या किसी क्रॉलर-आधारित इंजन से लाइसेंस पर लिया गया इंडेक्स | रैंक की गई सूची (कई इंजन AI जवाब भी जोड़ते हैं) | व्यापक खोजें, किसी खास पेज को ढूंढना | वेब पर सिर्फ़ एक इंजन का नज़रिया; पेजों की तुलना आपको खुद करनी होती है | Google, Bing, Brave Search, DuckDuckGo |
मेटा सर्च | एक साथ कई इंजन | रैंक की गई सूची | नतीजों का ज़्यादा व्यापक दायरा | धीमा: कई इंजनों का इंतज़ार करता है, एक तय समय-सीमा तक | eTools.ch, SearXNG, MetaGer |
AI आंसर इंजन | अपना इंडेक्स या लाइसेंस पर लिया गया इंडेक्स | उद्धरणों के साथ लिखा गया जवाब | ऐसे जटिल सवाल जिनके लिए कई स्रोतों की ज़रूरत होती है | उद्धृत पेजों की जाँच करें | Perplexity, Google AI Mode |
क्रॉलर-आधारित सर्च इंजन
क्रॉलर-आधारित सर्च इंजन, जैसे Google या Bing, आपकी क्वेरी के जवाब अपने इंडेक्स के वेब पेजों में ढूंढता है। यह व्यापक वेब खोजों या किसी खास साइट या पेज को ढूंढने के लिए सबसे अच्छा है।
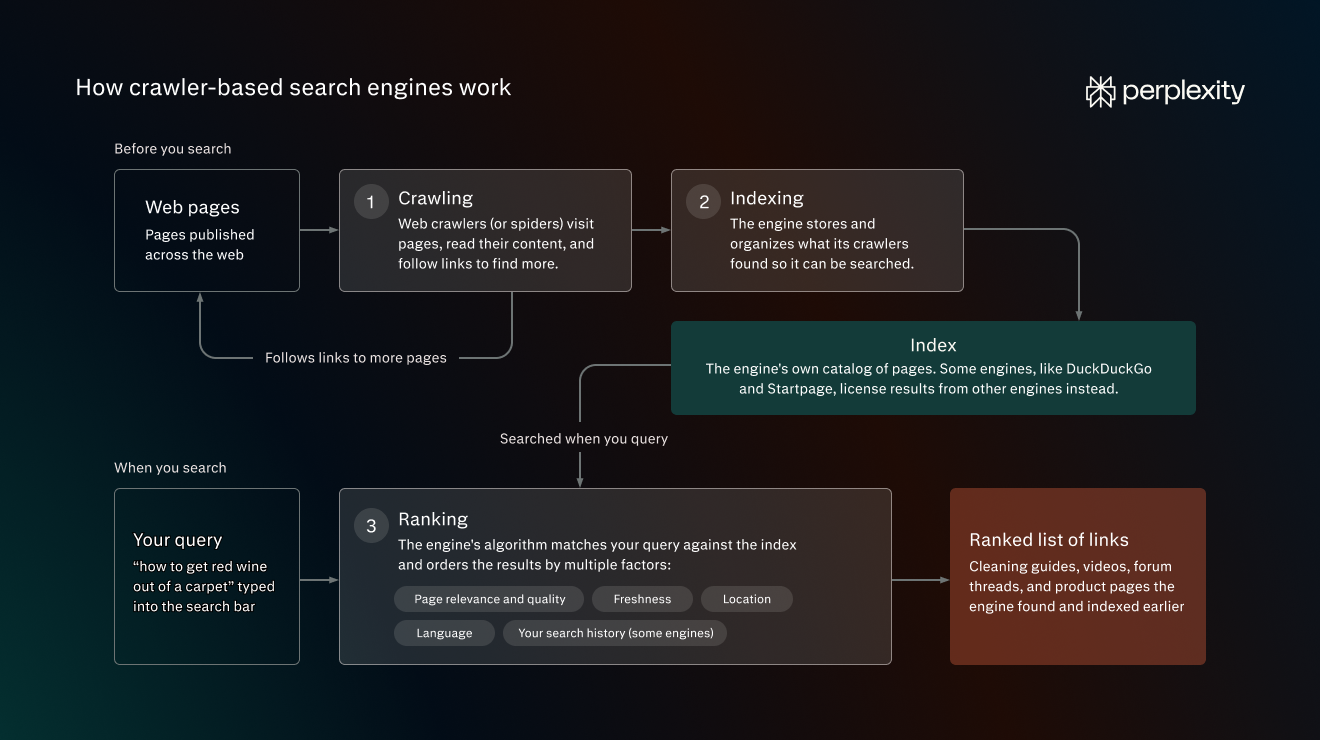
क्रॉलर-आधारित सर्च इंजन इस तरह काम करते हैं:
- क्रॉलिंग: वेब क्रॉलर (या स्पाइडर) कहे जाने वाले प्रोग्राम पेजों पर जाते हैं, उनका कंटेंट पढ़ते हैं, और ज़्यादा पेज ढूंढने के लिए लिंक को फ़ॉलो करते हैं।
- इंडेक्सिंग: इंजन अपने क्रॉलर को मिली जानकारी को स्टोर और व्यवस्थित करता है, ताकि उसमें खोज की जा सके।
- रैंकिंग: जब आप खोज करते हैं, तो इंजन का एल्गोरिदम आपकी क्वेरी को इंडेक्स से मिलाता है और कई कारकों के आधार पर नतीजों को क्रम में लगाता है, जैसे पेज की प्रासंगिकता और गुणवत्ता, ताज़गी, लोकेशन, भाषा और, कुछ इंजनों में, आपकी सर्च हिस्ट्री।
तो, जब आप सर्च बार में “कालीन से रेड वाइन का दाग कैसे हटाएँ” टाइप करते हैं, तो सर्च नतीजों वाले पेज पर सफ़ाई गाइड, वीडियो, फ़ोरम थ्रेड और प्रोडक्ट पेजों की रैंक की गई सूची दिखती है, जिन्हें सर्च इंजन पहले ही खोजकर अपने इंडेक्स में दर्ज कर चुका है।
क्रॉलर-आधारित इंजनों में रैंक पाने के लिए, सर्च इंजन ऑप्टिमाइज़ेशन (SEO) विशेषज्ञ यह पक्का करते हैं कि हर ज़रूरी पेज को आसानी से क्रॉल और इंडेक्स किया जा सके, और वह कीवर्ड के पीछे छिपी क्वेरी का जवाब प्रतिस्पर्धी पेजों से बेहतर तरीके से दे।
Google Search, जिसकी सर्च मार्केट में सबसे बड़ी हिस्सेदारी है, सबसे जाना-माना क्रॉलर-आधारित इंजन है। दूसरे इंजनों में Bing, Brave Search, और स्वतंत्र इंजन, जैसे UK का Mojeek और स्वीडन का Marginalia, शामिल हैं।
कुछ इंजन खुद वेब को क्रॉल नहीं करते, बल्कि दूसरों से नतीजे लाइसेंस पर लेते हैं। उदाहरण के लिए, DuckDuckGo अपने पारंपरिक लिंक ज़्यादातर Bing से (साथ ही अपने क्रॉलर से) लेता है, और Startpage, Google और Bing से।
मेटा सर्च इंजन
मेटा सर्च इंजन आपकी क्वेरी कई दूसरे सर्च इंजनों को भेजता है और उनके नतीजों को मिला देता है। उदाहरण के लिए, eTools.ch 17 अलग-अलग डेटा स्रोतों में खोज करता है।
मेटा सर्च इंजन चार चरणों में सर्च क्वेरी का जवाब देते हैं:
- एक साथ कई इंजनों को क्वेरी भेजना।
- हर इंजन से नतीजे इकट्ठा करना।
- डुप्लिकेट को मिलाना और उन्हें फिर से स्कोर करना। उदाहरण के लिए, अगर कई इंजन किसी पेज को ऊँची रैंक देते हैं, तो वह ऊपर आ जाता है।
- रैंक किए गए नतीजों के साथ एक ही पेज दिखाना।
जब आप eTools.ch पर “कालीन से रेड वाइन का दाग कैसे हटाएँ” खोजते हैं, तो आपको DuckDuckGo, Yahoo, Google और दूसरे इंजनों से नतीजे मिलते हैं। हमारे टेस्ट में, Google का #1 नतीजा यहाँ सिर्फ़ #4 पर रैंक करता है।
जब आप खोज का दायरा बढ़ाना चाहते हैं, तब मेटा सर्च इंजन एक अच्छा विकल्प हैं, लेकिन वे धीरे लोड हो सकते हैं, क्योंकि वे कई इंजनों के जवाब का इंतज़ार करते हैं (एक तय समय-सीमा तक)।
eTools.ch के अलावा, लोकप्रिय मेटा सर्च इंजनों में SearXNG, MetaGer और Dogpile शामिल हैं।
DuckDuckGo कभी-कभी मेटा सर्च इंजनों की सूचियों में दिखता है, लेकिन यह कई इंजनों के नतीजों को मिलाने के बजाय अपने नतीजे Bing से लाइसेंस पर लेता है।
AI आंसर इंजन
AI सर्च इंजन, जैसे Perplexity, स्रोत खोजता है और उनका इस्तेमाल करके आपके खास सवाल का जवाब लिखता है, साथ ही उन पेजों से लिंक करने वाले उद्धरण देता है जिनका उसने इस्तेमाल किया।
AI आंसर इंजन कैसे काम करते हैं:
- सवाल पढ़ता है: एक लार्ज लैंग्वेज मॉडल (LLM) आपकी क्वेरी को समझता है, जिसमें लंबे, बातचीत वाले सवाल भी शामिल हैं, और उसे कई खोजों में बाँट सकता है। इस प्रक्रिया को क्वेरी फ़ैन-आउट कहा जाता है।
- स्रोत खोजता है: यह उन खोजों को एक वेब इंडेक्स पर चलाता है, ताकि जवाब में उन पेजों की जानकारी भी शामिल हो सके जो मॉडल की ट्रेनिंग के बाद प्रकाशित हुए हैं, और यह सवाल के आधार पर सिर्फ़ पूरे पेजों को ही नहीं, बल्कि अलग-अलग अंशों को भी स्कोर करता है।
- जवाब लिखता है: LLM प्राप्त किए गए अंशों से जवाब लिखता है।
क्रॉलर-आधारित इंजनों की तरह, AI आंसर इंजन भी किसी इंडेक्स में खोज करते हैं, चाहे वह उनका अपना हो या लाइसेंस पर लिया गया। उदाहरण के लिए, Perplexity अपना इंडेक्स चलाता है, जबकि ChatGPT Search अपने इंडेक्स के साथ थर्ड-पार्टी इंडेक्स का भी इस्तेमाल करता है।
AI आंसर इंजन कई स्रोतों की जानकारी से जवाब तैयार करते हैं, इसलिए वे ऐसी जटिल या खास क्वेरी के लिए सबसे अच्छे हैं, जिनका जवाब किसी एक पेज पर मिलने की संभावना कम होती है।
उदाहरण के लिए, जब हमने Perplexity से पूछा, “मेरी 16 साल की बेटी के पास इलिनॉय का लर्नर्स परमिट है, लेकिन हम मार्च में एरिज़ोना शिफ़्ट हो रहे हैं। क्या उसे अभी प्रैक्टिस के घंटे दर्ज करते रहना चाहिए, क्या एरिज़ोना उन्हें गिनेगा, और उसे एरिज़ोना MVD में क्या-क्या ले जाना होगा?”, तो उसने सवाल के हर हिस्से का जवाब देने के लिए 15 स्रोतों का इस्तेमाल किया।
Google के क्लासिक रैंक किए गए नतीजों में (AI Overview के बिना), यही सवाल पेजों की एक सूची दिखाता है, इसलिए आपको हर पेज खोलकर प्रासंगिक जानकारी खुद ढूंढनी पड़ती है।
हालाँकि, जवाब लिखते समय LLM हैलुसिनेट कर सकते हैं, इसलिए AI जवाब पर भरोसा करने से पहले उद्धृत पेज खोलें और उसके दावों की जाँच करें।
AI जवाबों में उद्धृत होने के लिए, वेबपेजों को उसी SEO बुनियाद की ज़रूरत होती है। हालाँकि, आंसर इंजन ऑप्टिमाइज़ेशन (AEO) कंटेंट को AI आंसर इंजनों के लिए प्रोसेस और उद्धृत करने में आसान बनाने पर ज़्यादा ध्यान देता है, उदाहरण के लिए, ऐसे सेक्शन के ज़रिए जिनमें से हर एक किसी एक खास सवाल का स्पष्ट जवाब दे, भले ही उसे संदर्भ से अलग करके निकाला जाए।
सर्च इंजन के दूसरे प्रकार
सर्च इंजनों को उनके उद्देश्य, दर्शकों या बिज़नेस मॉडल के आधार पर भी समूहों में बाँटा जा सकता है। इनमें से कुछ समूह तीन मुख्य प्रकारों से आंशिक रूप से मेल खाते हैं। उदाहरण के लिए, कोई प्राइवेसी-केंद्रित इंजन अपना इंडेक्स चला सकता है या अपने नतीजे लाइसेंस पर ले सकता है।
प्रकार | इसे क्या अलग बनाता है | किसके लिए सबसे अच्छा | कमी | उदाहरण |
प्राइवेसी-केंद्रित | व्यक्तिगत डेटा ट्रैक नहीं करता | ऐसी खोजें जिन्हें आप अपनी हिस्ट्री से नहीं जोड़ना चाहते | कोई पर्सनलाइज़्ड नतीजे नहीं | DuckDuckGo, Startpage |
पेड, विज्ञापन-मुक्त | विज्ञापनों से नहीं, सब्सक्रिप्शन से चलता है | विज्ञापनों या विज्ञापन टारगेटिंग के बिना नतीजे | छोटे फ़्री ट्रायल के बाद सब्सक्रिप्शन | Kagi |
वर्टिकल | एक ही तरह के कंटेंट में खोज करता है | विशेषज्ञ कंटेंट, उसी कंटेंट के लिए फ़िल्टर के साथ | उस संग्रह के बाहर कुछ नहीं | PubMed, Indeed, YouTube |
क्षेत्रीय | किसी एक देश या भाषा के हिसाब से तैयार | उस भाषा में या स्थानीय जानकारी के लिए खोज करना | अपनी मूल भाषा और बाज़ार के बाहर कमज़ोर कवरेज | Yandex, Seznam, Baidu, Naver |
वेब डायरेक्टरी या हाइब्रिड | मानव संपादकों द्वारा चुनी गई साइटें, कभी-कभी फ़िल्टर किए गए क्रॉलर परिणामों के साथ मिलाकर | किसी एक विषय या एक दर्शक वर्ग के लिए जाँचा-परखा शुरुआती बिंदु | बहुत कम परिणाम, अपडेट होने में धीमा | Curlie, MedlinePlus, Kiddle, fragFINN |
एंटरप्राइज़ | किसी संगठन के अपने ऐप्स और फ़ाइलें खोजता है | आंतरिक दस्तावेज़, संदेश और रिकॉर्ड ढूँढना | केवल उन्हीं स्रोतों को कवर करता है जिन्हें आपका संगठन कनेक्ट करता है | Coveo, Atlassian Rovo, Onyx |
गोपनीयता-केंद्रित सर्च इंजन
DuckDuckGo या Startpage जैसा गोपनीयता-केंद्रित सर्च इंजन आपकी खोजों का ऐसा कोई रिकॉर्ड नहीं रखता जिससे उनका पता आप तक लगाया जा सके।
DuckDuckGo न तो आपका सर्च इतिहास सहेजता है और न ही उसे साझा करता है, और Startpage आपका IP पता और वह अन्य व्यक्तिगत डेटा हटा देता है जिसका उपयोग दूसरे इंजन परिणामों को वैयक्तिकृत करने के लिए करते हैं।
दोनों अपने परिणाम बड़े इंजनों से लाइसेंस पर लेते हैं (DuckDuckGo के लिए Bing, Startpage के लिए Google और Bing), इसलिए आपको बड़े इंडेक्स का लाभ तो मिलता ही है, साथ में अतिरिक्त गोपनीयता भी।
सशुल्क, विज्ञापन-मुक्त सर्च इंजन
Kagi जैसा सशुल्क सर्च इंजन विज्ञापनों के बजाय उपयोगकर्ताओं की सदस्यता से वित्तपोषित होता है।
सशुल्क सर्च इंजनों को विज्ञापन टार्गेटिंग के लिए व्यक्तिगत डेटा इकट्ठा करने की ज़रूरत नहीं होती, और वे पेजों को अलग तरीके से रैंक कर सकते हैं।
उदाहरण के लिए, Kagi उन पेजों को नीचे रैंक करता है जिनमें बहुत ज़्यादा विज्ञापन और ट्रैकर होते हैं, क्योंकि उसने पाया है कि इनका संबंध कम गुणवत्ता वाली सामग्री से होता है, और वह स्वतंत्र और व्यक्तिगत साइटों को बढ़ावा देता है।
वर्टिकल सर्च इंजन
वर्टिकल सर्च इंजन एक ही तरह की सामग्री पर ध्यान केंद्रित करता है, जैसे शोध पत्र, नौकरियाँ या वीडियो। उदाहरण के लिए, PubMed बायोमेडिकल साहित्य खोजता है, Indeed नौकरी की लिस्टिंग खोजता है, और YouTube, TikTok या Reddit जैसे UGC प्लेटफ़ॉर्म केवल अपनी सामग्री खोजते हैं।
चूँकि हर इंजन एक ही प्रकार की सामग्री को कवर करता है, इसलिए यह आपको सर्च परिणामों को ऐसे तरीकों से फ़िल्टर करने देता है जो एक सामान्य इंजन नहीं देता, जैसे वेतन सीमा या प्रकाशन के प्रकार के अनुसार।
क्षेत्रीय सर्च इंजन
क्षेत्रीय सर्च इंजन, जैसे रूस में Yandex, चेक गणराज्य में Seznam या चीन में Baidu, किसी एक देश या भाषा पर ध्यान केंद्रित करता है। जब आप उस भाषा में खोजते हैं या कोई स्थानीय खोज करते हैं, जैसे आस-पास की दुकानों या सेवाओं के लिए, तो ये ज़्यादा प्रासंगिक परिणाम दे सकते हैं।
कुछ क्षेत्रीय सर्च इंजनों की अपने घरेलू बाज़ार में बड़ी हिस्सेदारी है। उदाहरण के लिए, रूस में सर्च रेफ़रल में Yandex की हिस्सेदारी 70.22% है, जबकि Google की 28.36% (StatCounter, अक्टूबर 2026)।
वेब डायरेक्टरी और हाइब्रिड सर्च इंजन
वेब डायरेक्टरी उन साइटों की सूची होती है जिन्हें मानव संपादक चुनते हैं और विषय के अनुसार वर्गीकृत करते हैं।
उदाहरण के लिए, DMOZ का स्वयंसेवकों द्वारा संचालित उत्तराधिकारी Curlie, स्वयंसेवक संपादकों द्वारा जोड़ी गई 30 लाख से ज़्यादा साइटों को सूचीबद्ध करता है, और अमेरिकी नेशनल लाइब्रेरी ऑफ़ मेडिसिन द्वारा संचालित MedlinePlus हर स्वास्थ्य विषय पर जाँचे-परखे पेज इकट्ठा करता है।
हाइब्रिड इंजन वेब डायरेक्टरी लिस्टिंग को क्रॉलर परिणामों के साथ मिलाते हैं। बच्चों का सर्च इंजन Kiddle अपने परिणामों में सबसे ऊपर संपादकों द्वारा जाँचे गए पेज रखता है, उसके बाद Google SafeSearch से फ़िल्टर किए गए परिणाम आते हैं, और fragFINN केवल वही पेज दिखाता है जिन्हें मीडिया शिक्षकों की एक टीम ने व्हाइटलिस्ट किया है।
एंटरप्राइज़ सर्च इंजन
Coveo, Atlassian Rovo या Onyx जैसा एंटरप्राइज़ सर्च इंजन किसी संगठन की अपनी सामग्री खोजता है, जैसे दस्तावेज़, ईमेल, डेटाबेस एंट्री और चैट संदेश, जिन तक सार्वजनिक सर्च इंजन नहीं पहुँच सकते।
एंटरप्राइज़ सर्च इंजन संगठन के ऐप्स, जैसे Slack, Gmail, Notion या Salesforce, से सामग्री और मेटाडेटा को एक निजी इंडेक्स में सिंक करते हैं या उनसे लाइव क्वेरी करते हैं, फिर हर उपयोगकर्ता की एक्सेस अनुमतियों के आधार पर परिणामों को फ़िल्टर करते हैं, ताकि लोग केवल वही देखें जिसे देखने के लिए वे अधिकृत हैं।
सबसे अच्छा सर्च इंजन कैसे चुनें
अपनी ज़रूरतों के लिए सबसे अच्छा सर्च इंजन चुनते समय इन बातों पर ध्यान दें:
- प्रासंगिकता: Google और Bing कई भाषाओं को कवर करते हैं, लेकिन कोई क्षेत्रीय इंजन अपनी मूल भाषा में ज़्यादा प्रासंगिक सर्च परिणाम दे सकता है। विशेषज्ञ सामग्री के लिए, PubMed जैसा वर्टिकल इंजन ऐसी सामग्री को इंडेक्स करता है और ऐसे फ़िल्टर देता है जो एक सामान्य इंजन नहीं देता।
- उत्तर का प्रारूप: जटिल क्वेरी के लिए या जब रैंक करने लायक सामग्री कम हो, तब AI उत्तर इंजन ज़्यादा तेज़ होता है। हालाँकि, इससे गलतियाँ हो सकती हैं, इसलिए जाँच किए बिना कभी भी इसके उत्तरों का उपयोग अहम फ़ैसलों के लिए न करें।
- गति: क्रॉलर-आधारित इंजन अपने परिणाम तुरंत लोड करते हैं, और मेटा सर्च इंजन बस थोड़े ही धीमे होते हैं। AI उत्तर इंजनों को उत्तर लिखने में ज़्यादा समय लगता है, लेकिन जब उत्तर ढूँढने के लिए कई स्रोत पढ़ने पड़ते हैं, तो ये समय बचाते हैं।
- गोपनीयता: कुछ इंजन परिणामों को आंशिक रूप से आपके सर्च इतिहास और अन्य व्यक्तिगत डेटा के आधार पर रैंक करते हैं। अगर आप वह डेटा साझा नहीं करना चाहते, या नहीं चाहते कि आपका इतिहास परिणामों को प्रभावित करे, तो DuckDuckGo और Startpage जैसे निजी सर्च इंजन का उपयोग करें।
- विज्ञापन: अगर आप विज्ञापन नहीं देखना चाहते, तो Kagi जैसे सशुल्क इंजन का उपयोग करें।
- सर्च अनुभव: फ़िल्टर देखें और यह भी कि परिणामों पर नज़र डालना कितना आसान है। Google और Bing उपयोगकर्ताओं को इमेज के ज़रिए भी खोजने देते हैं, ताकि आप ऐसे पेज ढूँढ सकें जिनमें कोई खास विज़ुअल शामिल हो। DuckDuckGo, Brave Search और Kagi बैंग्स (bangs) का समर्थन करते हैं, यानी ऐसे शॉर्टकट जो सर्च को सीधे किसी दूसरी साइट के परिणामों पर भेज देते हैं।
Perplexity: अपने खुद के सर्च इंडेक्स वाला AI उत्तर इंजन
Perplexity एक AI उत्तर इंजन है जो अपने इंडेक्स और लाइव वेब पर खोज करता है और आपके प्रश्न का उत्तर लिखता है, जिसमें स्रोतों से लिंक करने वाले क्रमांकित उद्धरण होते हैं, ताकि आप जाँच सकें कि हर दावा कहाँ से आया है।
Perplexity का क्रॉलर, PerplexityBot, उसके इंडेक्स के लिए पेज इकट्ठा करता है। जब आप कोई प्रश्न पूछते हैं, तो Perplexity उन अंशों को चुनता है जो उसका सबसे अच्छा उत्तर देते हैं और उन्हीं से उत्तर लिखता है। उत्तर देते समय Perplexity किसी पेज को लाइव भी खोल सकता है।
जिन प्रश्नों के लिए ज़्यादा गहन उत्तर चाहिए, उनके लिए शोध मोड दर्जनों खोजें चलाता है, सैकड़ों स्रोत पढ़ता है और निष्कर्षों को एक पूरी रिपोर्ट में बदल देता है, जिसे आप PDF या दस्तावेज़ के रूप में एक्सपोर्ट कर सकते हैं।
अक्सर पूछे जाने वाले प्रश्न
सबसे ज़्यादा इस्तेमाल किए जाने वाले सर्च इंजन कौन-से हैं?
StatCounter के अनुसार, अक्टूबर 2026 में सर्च रेफ़रल की हिस्सेदारी के हिसाब से Google 91.05% के साथ सबसे आगे है, उसके बाद Bing (4.8%), Yahoo (1.18%), Yandex (1.14%) और DuckDuckGo (0.64%) हैं।
Google के अलावा कुछ लोकप्रिय सर्च इंजन कौन-से हैं?
Google के अलावा, Perplexity एक लोकप्रिय AI उत्तर इंजन है, जबकि Bing, DuckDuckGo, Yandex, Baidu और Brave Search लोकप्रिय सर्च इंजन हैं जो रैंक किए गए पेजों की सूची दिखाते हैं। इनमें से कुछ AI द्वारा लिखे गए उत्तर भी जोड़ते हैं।
पहले सर्च इंजन कौन-से थे?
पहला इंटरनेट सर्च इंजन Archie था, जिसे एलन एमटेज ने 1989 में बनाया था। WebCrawler जैसे क्रॉलर-आधारित वेब सर्च इंजन 1990 के दशक के मध्य में आए। Dogpile 1996 में शुरुआती मेटा सर्च इंजनों में से एक के रूप में लॉन्च हुआ, और Google 1998 में एक कंपनी के रूप में पंजीकृत हुआ।
सर्च इंजन कितने अलग-अलग प्रकार के होते हैं?
परिणाम कहाँ से आते हैं और आपको क्या मिलता है, इसके आधार पर तीन मुख्य प्रकार हैं: क्रॉलर-आधारित, मेटा सर्च और AI उत्तर इंजन। कोई इंजन एक से ज़्यादा श्रेणियों में आ सकता है, क्योंकि कई क्रॉलर-आधारित इंजन अब AI उत्तर भी जोड़ते हैं।
उद्देश्य, ऑडियंस या बिज़नेस मॉडल के आधार पर वर्गीकृत करें, तो और भी प्रकार हैं, जिनमें गोपनीयता-केंद्रित, सशुल्क, वर्टिकल, क्षेत्रीय और एंटरप्राइज़ इंजन के साथ-साथ वेब डायरेक्टरी भी शामिल हैं।
क्या विज़ुअल सर्च और वॉइस सर्च, सर्च इंजन के प्रकार हैं?
विज़ुअल सर्च और वॉइस सर्च, सर्च इंजन के प्रकार नहीं हैं, बल्कि खोजने के तरीके हैं। विज़ुअल सर्च, जैसे Google Lens, शब्दों के बजाय किसी इमेज से शुरू होता है, और वॉइस सर्च, आपके फ़ोन या स्मार्ट होम डिवाइस पर, बोली गई बात से शुरू होता है, लेकिन ये अक्सर उसी इंडेक्स में खोजते हैं जिसमें टाइप करके की गई खोज होती है।
सर्च इंजन और उत्तर इंजन में क्या अंतर है?
पारंपरिक सर्च इंजन आपकी क्वेरी से मेल खाने वाले पेजों की रैंक की गई सूची दिखाता है। उत्तर इंजन पेज पढ़ता है और एक उत्तर लिखता है, जिसमें उसके स्रोतों से लिंक करने वाले उद्धरण होते हैं।
कुछ सर्च इंजन अब दोनों काम करते हैं। उदाहरण के लिए, Google में AI Mode और AI Overviews हैं, और Bing में भी।