
MI-memória: mi ez, hogyan működik, és mit tárol
Útmutató az MI-memóriához: hogyan mentik és idézik fel az MI-asszisztensek a korábbi beszélgetések részleteit, mit tárolnak, hol hibázhat a memória, és hogyan tekintheted meg, szerkesztheted vagy kapcsolhatod ki.
Az MI-memória olyan információ, amelyet egy beszélgetős MI-asszisztens a korábbi beszélgetéseidből elment, és átvisz az újakba, hogy emlékezzen a preferenciáidra és a kontextusra. Maga a modell ebből semmit sem őriz meg. Az asszisztens külön tárolja, és akkor adja hozzá újra, amikor releváns, így a modell olyan tartós kontextushoz jut, amely egyébként hiányozna neki.
Ez az útmutató elmagyarázza, hogyan mentik el és idézik fel az asszisztensek ezeket az információkat, mit tárolnak, miért tévednek néha, és hogyan tekintheted meg, módosíthatod vagy kapcsolhatod ki ezt a funkciót.
Mi az MI-memória?
Az MI-memória, más néven tartós memória, az MI-asszisztensek olyan funkciója, amely információkat tárol rólad – például preferenciákat, tényeket és a korábbi interakciókból származó kontextust –, amelyeket az asszisztens a későbbi beszélgetésekben felhasználhat.
Egy MI-asszisztens ezt a nyilvántartást abból építheti fel, amit megkérsz, hogy jegyezzen meg, a magától észrevett részletekből, valamint a korábbi csevegésekből, amelyekre visszautalhat.
Az MI-memóriaréteg lehetővé teszi, hogy az MI-asszisztensek személyre szabott válaszokat adjanak anélkül, hogy minden csevegésben meg kellene osztanod a preferenciáidat. Ha elmondtad egy asszisztensnek, hogy maratonra készülsz, és a kilométert részesíted előnyben, a következő tempóval kapcsolatos kérdésedre kilométerben kapsz választ anélkül, hogy ezt újra el kellene mondanod.
Ahhoz képest, hogy minden csevegésben újra leírnád a helyzetedet, a memória gépelést takarít meg, és rövid marad a prompt, ami azért fontos, mert a hosszú bemenetek pontatlanabbá teszik a válaszokat.
A memória nem minden beszélgetés átirata, hanem a rád vonatkozó legfontosabb tények gyűjteménye. Így emlékezni fog arra, hogy a kilométert részesíted előnyben. Az, hogy megtalálja-e a pontos edzéstervet, amelyet a múlt hónapban készített, attól függ, hogy az asszisztens a korábbi csevegésekben is tud-e keresni.
Az MI-memória típusai
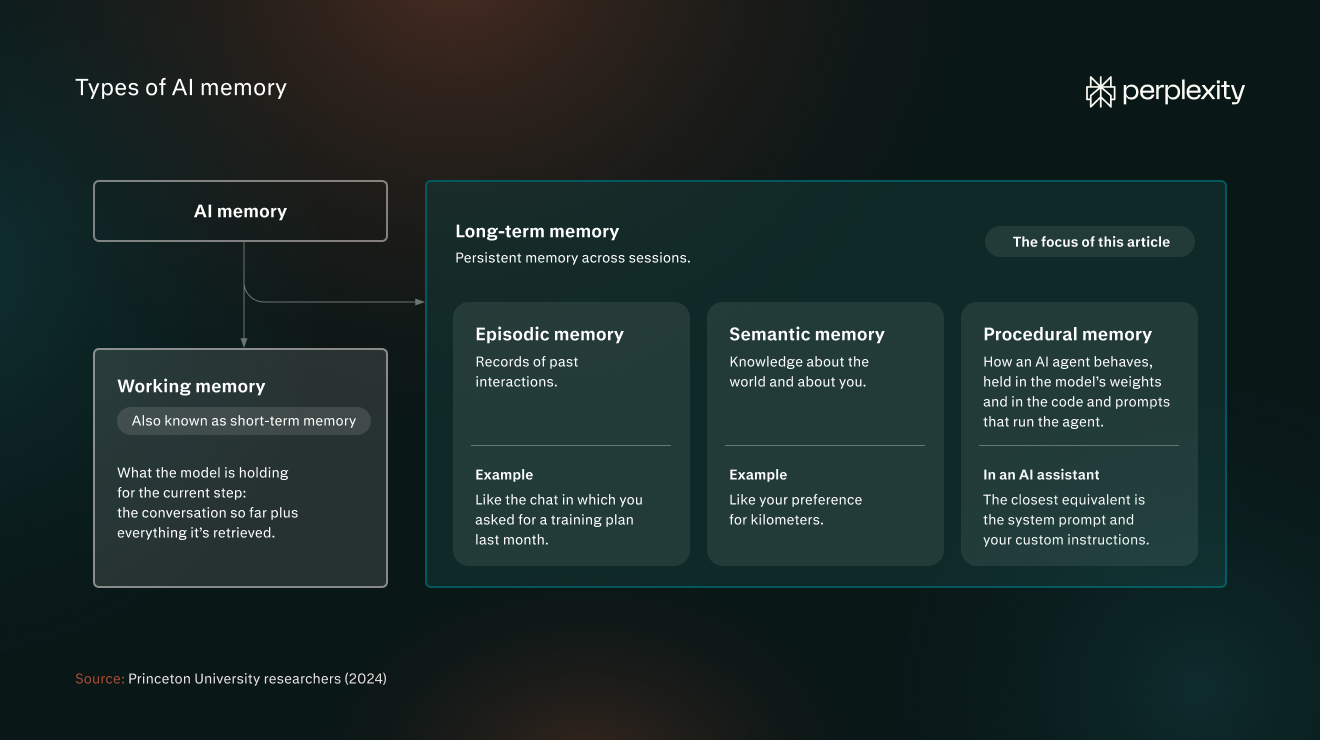
A Princetoni Egyetem kutatói (2024) az emberi memóriakutatás terminológiáját vették át az MI-memóriarendszerek típusainak osztályozására. Keretrendszerük megkülönbözteti a munkamemóriát a hosszú távú memóriától:
- Munkamemória: Amit a modell az aktuális lépéshez fejben tart, vagyis az eddigi beszélgetés és minden, amit lekért. Rövid távú memóriának is nevezik.
- Hosszú távú memória: Munkamenetek között is megmaradó, tartós memória. Ez a cikk ezzel a memóriatípussal foglalkozik.
A hosszú távú memória három memóriatípusból áll:
- Epizodikus memória: A korábbi interakciók feljegyzései, például az a csevegés, amelyben a múlt hónapban edzéstervet kértél.
- Szemantikus memória: A világról és rólad szóló tudás, például hogy a kilométert részesíted előnyben.
- Procedurális memória: Az, ahogyan egy MI-ügynök viselkedik; ez be van építve a modell súlyaiba, valamint az ügynököt futtató kódba és promptokba. Egy MI-asszisztensnél ennek legközelebbi megfelelője a rendszerprompt és az egyéni utasításaid.
Az MI-asszisztensek memóriája és az MI-ügynökök memóriája
Az MI-asszisztensek memóriája és az MI-ügynökök memóriája egyaránt hosszú távú memória. Az MI-asszisztensek memóriája többnyire szemantikus memória, és rólad tárol tényeket, hogy a válaszok hozzád illjenek. Az ügynökmemória – például a Perplexity Brain funkciója – azt tárolja, mit tett az ügynök és hogyan sikerült, beleértve azt is, mi működött és mit javítottál ki, így minden új feladatot jobb kiindulópontról kezd.
MI-asszisztens memóriája | MI-ügynök memóriája | |
Mire emlékszik | Rád | A feladatra és annak előzményeire |
Mire szolgál | Hozzád illő válaszokra | A többlépéses munka folytatására anélkül, hogy elölről kellene kezdeni |
Példa | Emlékszik, hogy a kilométert részesíted előnyben | Emlékszik a maratoni edzéstervedre, az általa végzett módosításokra és az eddig teljesített edzéseidre, így jobban meg tudja tervezni a következő edzésciklusokat |
Az MI-memória összevetése a kontextusablakkal, a tanítási adatokkal és az egyéni utasításokkal
Az MI-memóriát könnyű összekeverni három másik dologgal, amelyek a válaszokat alakítják: a modell kontextusablakával, a tanítási adatokkal és az egyéni utasításokkal. Mindegyik más információt tartalmaz, más ideig marad meg, és más rendszer irányítja.
A kontextusablak az a szövegmennyiség, amelyet egy nagy nyelvi modell (LLM) egyszerre el tud olvasni, és az aktuális beszélgetésre terjed ki. Új csevegés indításakor alaphelyzetbe áll.
Egyes mai modellek egymillió tokenes vagy annál is nagyobb kontextusablakkal rendelkeznek, így technikailag minden beszélgetésbe bemásolhatnád a legfontosabb információidat. Mindennek a feldolgozása azonban késleltetéssel és többletköltséggel jár.
Több tanulmány azt is kimutatta, hogy a kimenet pontossága a bemenet növekedésével csökken, még akkor is, ha a válasz megtalálható a kontextusban.
Az Illinois-i Egyetem és az Amazon 2025-ös tanulmánya még akkor is ezt tapasztalta, amikor a modellek minden releváns részletet fel tudtak idézni: a pontosság 13,9–85%-kal csökkent, ahogy a bemenet 30 000 tokenre nőtt, ami jóval a modellek állított korlátai alatt van. A NoLiMa, az Adobe Research és a müncheni LMU 2025-ös benchmarkja szerint a 13 tesztelt modellből 11 teljesítménye már 32 000 tokennél jelentősen visszaesett, ha a kérdésben és a válaszban nem volt közös kulcsszó. A Chroma 2025. júliusi jelentése 18 modellnél is megfigyelte ezt, többek között akkor is, amikor egy 113 000 tokenes csevegési előzmény alapján válaszoltak.
A tanítási adatok a modell súlyaiba a kiadás előtt beépített információk. A felhasználók nem módosíthatják őket. A fejlesztők finomhangolhatnak egy modellt új adatokon, de ez mérnöki folyamat, nem felhasználói beállítás,
Az egyéni utasítások az asszisztens beállításaiban mentett szabályok, amelyeket te magad írsz és szerkesztesz, hogy testre szabd az MI-asszisztens viselkedését és kimeneteit. Az egyéni utasításokkal például meghatározhatod a válaszok hangnemét és stílusát, vagy azt, hogy az asszisztens milyen forrásokat használhat.
Így viszonyul egymáshoz a négy:
Kontextusablak | MI-memória | Tanítási adatok | Egyéni utasítások | |
Mit tartalmaz | Az aktuális csevegés üzeneteit | Rólad mentett tényeket és preferenciákat | Amit a modell a kiadás előtt megtanult | Általad írt útmutatást |
Meddig marad meg | Csak ebben a csevegésben | Amíg nem frissítik vagy nem törlik | Változatlan, amíg új modell nem jelenik meg | Amíg nem szerkeszted |
Ki irányítja | Te, a modellszolgáltató által megszabott kereteken belül. | Te és az asszisztens | Az MI-vállalat | Te |
Példa | Az egy perccel ezelőtt feltett, tempóval kapcsolatos kérdésed | Hogy a kilométert részesíted előnyben | Hogyan épülnek fel általában a maratoni edzéstervek | Utasítás, hogy az edzésterveket táblázatban formázza, ahol a sorok a heteket, az oszlopok pedig a hét napjait jelölik |
Mit tárol az MI-memória
Az asszisztensek bizonyos részleteket megőriznek rólad, például tényeket, preferenciákat és összefoglalókat, egyesek pedig a korábbi csevegéseidre is támaszkodnak.
- Tények és preferenciák, amelyeket megkérsz, hogy jegyezzen meg: Ezek olyan részletek, amelyek mentésére kifejezetten megkéred az asszisztenst, például: „jegyezd meg, hogy a kilométert részesítem előnyben”. Az asszisztens a kérésedre hozza létre az emléket, és az addig marad meg, amíg nem törlöd, vagy egy későbbi beszélgetés nem frissíti.
- A beszélgetéseidből kiszűrt részletek: Az asszisztens ezeket akkor menti el, ha a beállítás be van kapcsolva. A Perplexity „a felhasználó által feltett kérdések és megadott információk gyakoriságát részesíti előnyben”, így amit gyakran említesz, nagyobb eséllyel marad meg, mint amit csak egyszer. Az emlék addig marad meg, amíg nem frissül, vagy nem törlöd.
- Hivatkozások a korábbi csevegéseidre: Az asszisztens közvetlenül a korábbi beszélgetésekre támaszkodik, nem pedig egy mentett listára. A Perplexity ezt keresési előzményeknek nevezi: ezek a korábbi kérdéseid és válaszaid, amelyek segítségével az új válasz relevánsabb lehet.
Hogyan működik az MI-memória
Az MI-modell semmire sem emlékszik a beszélgetések között. Ezt a munkát az MI-memóriarendszer végzi: külön nyilvántartást vezet rólad, és a releváns részeket minden új beszélgetéshez hozzáadja. A tárolás és a lekérés a háttérben történik, így a modell a kérdéseddel együtt olvassa őket.
A folyamat öt lépésből áll:
- Mentés: Az asszisztens akkor ment el egy emléket, amikor megkéred rá, vagy amikor úgy ítéli meg, hogy egy részletet érdemes megőrizni.
- Tárolás: Az emlékek a modelltől elkülönített adatbázisba kerülnek. Sok rendszerben ez egy vektoradatbázis, így jelentés alapján lehet keresni bennük. A beállításokban látható lista ennek a memóriatárnak egy nézete.
- Lekérés: Amikor üzenetet küldesz, az asszisztens eldönti, mely emlékek relevánsak. Sok rendszer ezt úgy végzi, hogy az üzenetedet és minden egyes emléket beágyazássá – a jelentés numerikus reprezentációjává – alakítja, majd kiválasztja a legközelebbi egyezéseket. Így akkor is fel tudnak idézni egy emléket, ha egyetlen közös szava sincs a kérdéseddel. Az egyszerűbb rendszerek minden mentett emléket betöltenek minden beszélgetésbe.
- Felhasználás: A felidézett emlékek egyszerű szövegként kerülnek a bemenetbe, általában egy olyan utasításblokkba, amelyet a modell az üzeneted előtt olvas el. A modell ugyanúgy dolgozza fel őket, mint a bemenet bármely más szövegét.
- Frissítés és eltávolítás: Az asszisztens tényeket nyer ki a csevegésekből, átkeresi a meglévő emlékeket, és eldönti, hogy újként hozzáadja-e a tényt, frissít-e egy meglévő emléket, összevonja-e egy másikkal, vagy töröl-e egy régi emléket, amely ellentmond az új megállapításoknak. Egyes asszisztensek időbélyeggel látják el az emlékeket, hogy meg tudják különböztetni az újabb információkat a régebbiektől.
Az MI-memória kihívásai és kockázatai
Az MI-memória célja a válaszok minőségének javítása, de a benchmarkok azt mutatják, hogy a memóriából való lekérés nem mindig hozza felszínre a releváns vagy aktuális információkat, különösen nagy adatbázisokból. Emellett biztonsági és adatvédelmi kockázatokkal is jár.
Az MI-memóriával kapcsolatos gyakori megbízhatósági és biztonsági problémák:
- Rosszul alkalmazott emlékek: Egy emlék olyan válaszba is bekerülhet, amelyhez semmi köze. Egy 2026-os tanulmány 18 modellen vizsgálta, hogy az élet egyik területéről mentett emlék beszivárog-e egy másik területre vonatkozó válaszba. A hibaarány mediánja 53% volt. A tanulmány azt is megállapította, hogy ha a memória a felhasználók meggyőződéseit vagy állított szakértelmét tartalmazta, szinte minden modell visszhangozta ezeket, még akkor is, ha a kérdés semleges választ igényelt.
- Elavult emlékek: Az asszisztens továbbra is egy olyan részlet alapján cselekszik, amelyet egy későbbi beszélgetés már érvénytelenné tett, különösen akkor, ha ezt soha nem mondtad ki egyenesen. Egy 2026. májusi benchmarkban, amely azt vizsgálta, észreveszik-e a modellek az ilyen implicit változásokat, a legjobb modell átlagosan 55,2%-ot ért el.
- Memória-túlterhelés: Minél többet kell egy asszisztensnek visszaolvasnia, annál nehezebb kiválasztania, ami számít. A LongMemEval, egy 2024-es benchmark, azt találta, hogy a nagyjából 115 000 tokenes csevegési előzményt olvasó modellek 30–60%-kal rosszabbul teljesítettek, mint azok a modellek, amelyek csak a releváns munkameneteket kapták meg.
- Memóriamérgezés: Hamis információk vagy rejtett utasítások kerülnek az asszisztens memóriájába – például olyan tartalmon keresztül, amelyet megkérsz, hogy olvasson el –, ami elfogult vagy nem biztonságos válaszokhoz, illetve adatszivárgáshoz vezet.
- Adatvédelmi kockázatok: A memória a személyes adatokat azon a csevegésen túl is megőrzi, amelyből származnak, néha tovább, mint gondolnád. A Perplexity például biztonsági és hibakeresési célból akár 30 napig is megőrizheti a törölt emlékek naplóját. Az adatvédelmi jogszabályok a tárolt emlékeket személyes adatnak tekintik, ezért lehetőségednek kell lennie arra, hogy áttekintsd és töröld őket.
Az MI-memória megtekintése, szerkesztése és kikapcsolása
Megnézheted, mit mentett el egy asszisztens, törölheted, kikapcsolhatod a memóriát, vagy használhatsz privát csevegést, amely nem hoz létre emlékeket.
A memória kezelése néhány beállításon múlik. Íme, mire valók, és mikor érdemes használni őket:
Beállítás | Mire való | Mikor érdemes használni |
A mentett elemek megtekintése | Megnyitja a memóriatárat, ahol kereshetsz, szűrhetsz, és áttekintheted az egyes bejegyzéseket. | Ha egy válasz olyan részletet tartalmaz, amelyre nem számítottál. |
Emlék törlése | Eltávolítja a bejegyzést, és az asszisztens a későbbi válaszokban már nem használja (az asszisztensek egy ideig megőrizhetik a törölt emlékek naplóját). | Ha egy emlék téves, elavult vagy érzékeny. |
A memória kikapcsolása | Az asszisztens a jövőbeli válaszokban nem támaszkodik a memóriára (előfordulhat, hogy a már tárolt emlékeket nem törli – ezt ellenőrizd az asszisztensednél). | Ha személyre szabás nélküli válaszokat szeretnél |
A keresési előzmények kikapcsolása | Az asszisztens nem használja a korábbi kérdéseidet és válaszaidat. Ha törölsz egy munkamenetet a keresési előzményeidből, az többé nem befolyásolja a későbbi válaszokat. | Ha a korábbi beszélgetések befolyásolják a válaszokat, érdemes tiszta lappal kezdeni. |
Használj inkognitó csevegést | A memória és a keresési előzmények mindig ki vannak kapcsolva, az itt feltett kérdések pedig soha nem kerülnek megőrzésre, és a memória sem használja fel őket. | Egyszeri vagy érzékeny témákhoz. |
Ha tiszta lappal szeretnél indulni, kapcsold ki a memóriát, és töröld a tárolt adatokat.
Így kezeli a Perplexity a memóriát
A Perplexity memóriája az összes kínált modellel működik.
A Perplexity két forrásból szabja személyre a válaszokat: az emlékekből, vagyis az általad megosztott preferenciákból és adatokból, valamint a keresési előzményeidből. Ha egy emlék befolyásol egy választ, az megjelenik a válasz forrásai között, így láthatod, mely emlékeket használta, és bármelyiket törölheted.
A válaszaidat úgy is személyre szabhatod, hogy megadsz adatokat magadról, illetve egyéni utasításokat állítasz be a projektekhez (minden projektnek saját memóriarétege van).
A Perplexity a magánfelhasználói fiókok esetében felhasználhatja a memória tartalmát a modelljei fejlesztésére (az Enterprise-fiókoknál soha), hacsak ki nem kapcsolod ezt (MI-adatmegőrzés a Beállítások → Preferenciák → Mesterséges intelligencia menüpontban).
A Max és Enterprise Max előfizetők a Brain funkciót is megkapják: ez egy megosztott memóriaréteg, amely a memóriára építve nyomon követi a projektjeidet és a munkádat. Saját kapcsolóval rendelkezik, és figyelmen kívül hagyja az inkognitó munkameneteket.
Próbáld ki a Perplexityt, és nézd meg, hogyan alakítják az emlékek a következő válaszodat.
GYIK az MI-memóriáról
Mit jelent a korlátozott memória a mesterséges intelligenciában?
Az IBM meghatározása szerint a korlátozott memóriájú MI olyan mesterséges intelligencia, amely képes felidézni a múltbeli eseményeket és kimeneteleket, és idővel nyomon követni a helyzeteket, de ezeket az adatokat nem tudja a korábbi tapasztalatok hosszú távú tárában megőrizni. Ez az MI-rendszerek egyik taxonómiájának négy kategóriája közül az egyik, és az IBM a csevegőrobotokat és a virtuális asszisztenseket is ide sorolja.
Az asszisztensmemória egy külső memória, amelyet ezek a rendszerek ráépítenek a modellre. Munkamenetek között is megmarad, így az asszisztens felhasználhatja azokat az adatokat, amelyeket egy korábbi beszélgetésben osztottál meg.
Melyik MI-asszisztensnek van a legjobb memóriája?
Nincs olyan asszisztens, amely mindenki számára a legjobb. A jó memória az, amelyet te irányíthatsz, ezért az MI-eszközöket négy kérdés alapján értékeld: Látod, mit mentett el? Törölhetsz egy emléket attól a csevegéstől függetlenül, amelyből származik? A betanítás a memóriától külön beállítás? Van ideiglenes vagy inkognitó mód, amely nem hoz létre emlékeket?
Tanul-e egy MI-modell abból, amit megjegyez rólad?
A memória felhasználása egy válaszban más folyamat, mint a betanítás. A Perplexity szerint a memóriatáradból kéri le a releváns kontextust, ahelyett hogy az előzményeidet tanítóadatként kezelné. Az, hogy a tartalmaid felhasználhatók-e a modellek fejlesztésére, külön beállítás. A magánfelhasználói fiókok esetében a Perplexity erre a célra felhasználhatja a memória tartalmát, ezt pedig az MI-adatmegőrzés beállítással kapcsolhatod ki.
Mi az, aminek nem szabad bekerülnie az MI-memóriába?
Ne kerüljön az MI-memóriába semmi olyan, amit nem szeretnél, hogy tároljanak, profilt készítsenek belőle rólad, vagy később megismételjék: személyazonossági és pénzügyi adatok, egészségügyi információk, jelszavak, mások adatai, és bármi, ami gyerekekkel kapcsolatos. Kanada Adatvédelmi Biztosának Hivatala (2025. május) és az Egyesült Királyság Nemzeti Kiberbiztonsági Központja (2023. március) azt javasolja, hogy hagyj ki minden olyan promptot, amely problémát okozna, ha nyilvánossá válna.
A szűrők csökkentik az adatvédelmi kockázatokat, de nem garantálják, hogy az egészségügyi vagy pénzügyi adataid egyáltalán ne kerüljenek tárolásra, ezért nézd át a memóriatáradat, és az egyszeri, érzékeny kérdésekhez használd az inkognitó módot.