
Kontextusromlás az AI-ügynököknél: miért veszítenek pontosságukból a hosszú feladatok, és hogyan előzhető meg
Útmutató arról, mi halmozódik fel egy AI-ügynök kontextusában, miért rontja ez a pontosságot, és hogyan állíthat be megbízhatóan működő feladatokat.
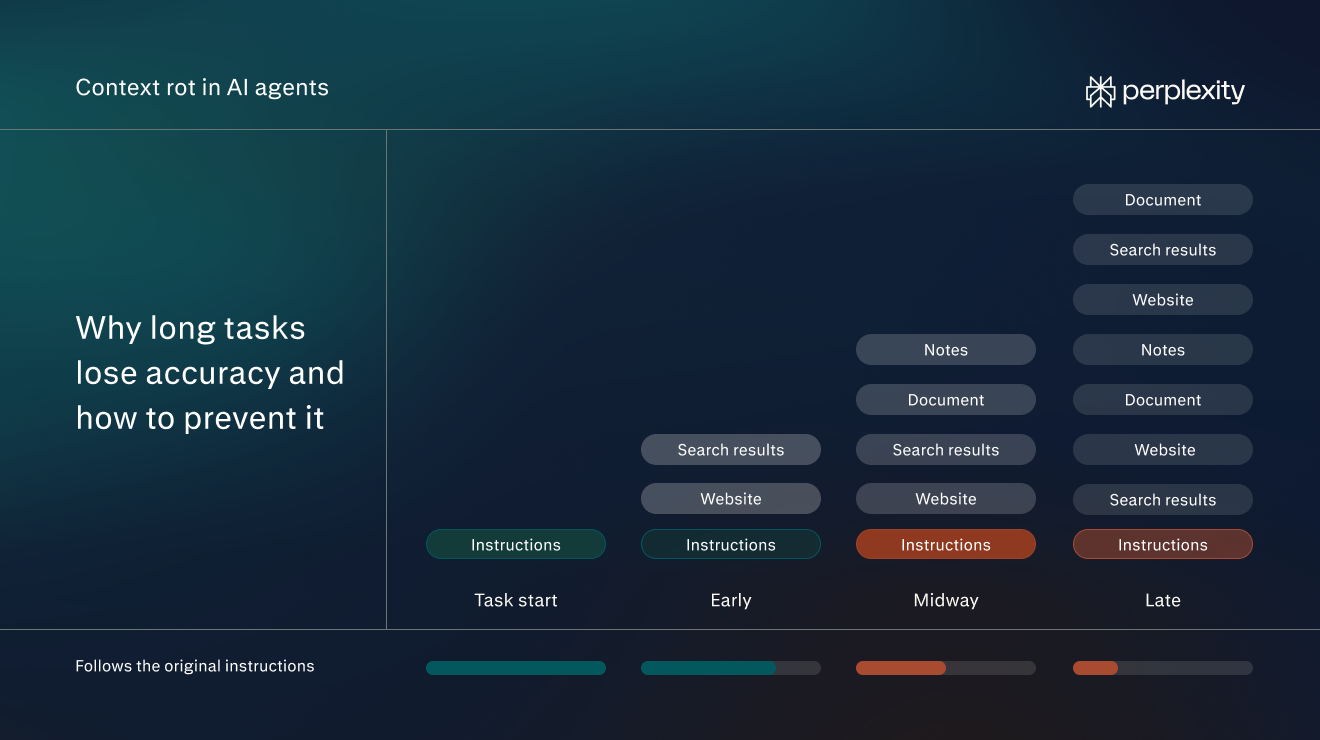
Mit jelent a kontextusromlás az AI-ügynökök esetében
Az AI-ügynököknél a kontextusromlás a pontosság fokozatos csökkenése, amely akkor jelentkezik, amikor egy hosszú feladat során egyre jobban megtelik az ügynök kontextusa.
Az ügynök kontextusa az az információ, amely a modell rendelkezésére áll a következő lépéshez. Tartalmazhat utasításokat, korábbi üzeneteket, keresési találatokat, valamint webhelyekről vagy fájlokból származó szöveget. Munka közben az ügynök további tartalmakat is hozzáadhat.
Tegyük fel például, hogy egy ügynök feladata olyan beszállítók felkutatása, amelyek két héten belül szállítanak. Az elején a kontextusa csak ezt a kérést tartalmazza. A feladat felénél a kontextusban már több tucat beszállítói webhely szövege, több oldalnyi keresési találat, valamint jegyzetek is lesznek arról, hogy az ügynök mely beszállítókat ellenőrizte már.
Annak, hogy egy modell mennyi kontextust képes befogadni, van egy határa (ezt nevezik kontextusablaknak). Az ablak méretét tokenekben mérik; a tokenek kis szövegrészletek, általában egy szó vagy egy szó része. A kontextusromlás a kontextus növekedésével erősödik, ezért leginkább a sok lépésből álló, hosszú feladatoknál fordul elő.
Ahogy a kontextusromlás súlyosbodik, az ügynök egyre pontatlanabbá válik. Előfordulhat, hogy kevésbé követi az eredeti utasításait, figyelmen kívül hagy részleteket, vagy a hasonlónak tűnő információt összetéveszti azzal, amire szüksége van.
Az ügynök például elkezdhet hathetes szállítási idejű beszállítókat is felvenni a listára, pedig azt az utasítást kapta, hogy kéthetes szállítást vállalókat keressen. Az utasítás továbbra is ott van a kontextusában, de már nem befolyásolja az ügynök döntéseit.
A kontextusromlás nem azonos azzal, amikor egyszerűen elfogy a hely a kontextusablakban. Ha egy feladat kontextusa túlnő az ablakon, a tartalom egy része levágódik, vagy a feladat meghiúsul. A kontextusromlás már jóval ezelőtt elkezdődik, amikor még minden belefér.
Nem azonos a kontextusmérgezéssel sem (amikor félrevezető vagy ártalmas információ kerül az ügynök kontextusába). A kontextusromlás olyan ügynöknél is jelentkezhet, amely pontos és hiánytalan információval rendelkezik.
Miért alakul ki a kontextusromlás
A kontextusromlás azért következik be, mert a modell figyelme korlátozott, még akkor is, ha a kontextusablakában bőven van még hely. Az AI-modelleknél a figyelem (attention) az a szakkifejezés, amely azt írja le, hogyan dönti el a modell, hogy a bemenet mely részeire támaszkodjon, miközben a válasz egyes szavait megírja. A kontextus minden része versenyez ezért a figyelemért. Minél több a szöveg, annál kevesebb figyelem jut az egyes részekre.
A Chroma például tanulmányt tett közzé arról, hogy hogyan befolyásolja a bemenet hossza az AI-modelleket. A vizsgálatban az Anthropic, az OpenAI, a Google és az Alibaba 18 modelljét tesztelték. Az egyik tesztben a kutatók egy írási tanácsról szóló mondatot rejtettek el esszék hosszú gyűjteményében. Ezután megkérdezték a modellt, mi volt a tanács.
A tesztet sokszor lefuttatták, és minden alkalommal több esszészöveget adtak hozzá. A mondat és a kérdés soha nem változott. Csak a körülöttük lévő szöveg mennyisége.
Minél több szöveget kellett a modelleknek elolvasniuk, annál rosszabbul teljesítettek. Ez az eredmény a jelentés minden tesztjében érvényesnek bizonyult. A kutatók szerint a pontosság csökkenése még nagyobb lenne a sok lépésből álló valós munkában, amilyen a legtöbb ügynöki feladat is.
Hogyan hathat a kontextusromlás az AI-ügynökökre
A kontextusromlás jellemzően a következő négy módon jelentkezik:
Az eredeti utasítások szem elől tévesztése
A Chroma legegyszerűbb tesztjében a modelleknek egy ismétlődő szavakból álló hosszú karakterláncot kellett pontosan lemásolniuk, amelybe valahol egyetlen eltérő szót szúrtak be. Triviális feladat volt, egyértelmű utasítással. A teljesítmény ennek ellenére minden modellnél romlott, ahogy a szöveg hosszabb lett. Egyes modellek olyan szavakat kezdtek előállítani, amelyek egyáltalán nem szerepeltek a bemenetben.
Egy ügynöki feladatnál a felhasználó jellemzően a feladat elején határoz meg konkrét megkötéseket, például költségkeretet vagy kötelező formátumot. A kontextus növekedésével előfordulhat, hogy az ügynök ezeket egyre kevésbé következetesen alkalmazza. Ennek oka a kontextus teljes hossza, nem pedig az, hogy hol található az utasítás.
A feladat közepéről kimaradó részletek
Egy 2023-as stanfordi tanulmány szerint az AI-modellek akkor használják fel a legmegbízhatóbban az információt, ha az a bemenetük legelején vagy legvégén található. Az egyik tesztben a kutatók 20 dokumentumot adtak a modelleknek, és olyan kérdést tettek fel, amelyre csak az egyik dokumentum adott választ. Ha ez a dokumentum az első vagy az utolsó helyen állt, a modellek általában megtalálták a választ. Ha a dokumentumok közepén volt, sokkal gyakrabban elsiklottak felette. A kutatók ezt pozícióhatásnak nevezik.
Ugyanez a minta érvényes az ügynökökre is. A feladat korábbi szakaszában talált információ egy hosszú beszélgetés közepére kerülhet, ahol egyes modelleknek nehezebb felhasználniuk. A beszállítós példában a végső listáról kimaradhat egy jó beszállító, amelyet az ügynök a feladat közben ellenőrzött.
A hasonló információk összekeverése
A kontextus növekedésével az ügynökök egyre nehezebben ismerhetik fel, mely információk felelnek meg az utasításaiknak. Tegyük fel például, hogy a felhasználó azt kérte az ügynöktől, hogy olyan beszállítókat keressen, amelyek „két héten belül” szállítanak. Egy beszállító webhelyén az áll, hogy a termék „a rendeléstől számított 14 naptári napon belül megérkezik”. Egy rövid feladatnál az ügynök valószínűleg észrevenné, hogy a kettő ugyanazt jelenti. Ha azonban ez az oldal több tucat másik beszállítói oldal között vész el, nagyobb eséllyel siklik el az egyezés felett.
Az is előfordulhat, hogy az ügynök nem releváns találatokat kezd felvenni. Tegyük fel, hogy az ügynök irodaszék-beszállítókat keres. Az egyik beszállító webhelye kéthetes szállítást ígér, de csak az íróasztalokra. A székeinek szállítási ideje hat hét. A webhely ugyanazokat a szavakat használja, mint az utasítás, így az ügynök ennek ellenére felveheti a beszállítót a listájára. Az ilyen információt a kutatók disztraktornak (zavaró elemnek) nevezik. Relevánsnak tűnik, pedig nem az, így versenyez a valóban fontos információval.
A Chroma tanulmánya szerint mindkét probléma súlyosbodott, ahogy a környező szöveg mennyisége nőtt.
Nehezen észrevehető hibák
A kontextusromlás nem vált ki hibaüzenetet. Az ügynök tovább dolgozik, és késznek látszó eredményt ad vissza. Emiatt a hibái könnyen észrevétlenek maradnak.
A Chroma tesztjeiben ezek a hibák kétféle formát öltöttek. Néha a modell magabiztos, de helytelen választ adott. A beszállítókutatási példában az ügynök átadhat egy rendezett, jól formázott beszállítólistát, amelyen szerepel egy olyan beszállító is, amelynek a szállítási feltételeit félreolvasta.
Máskor a modell azt állította, hogy nem talál olyan információt, amely valójában ott volt. Az ügynök például olyan jelentést adhat át, amely szerint egyetlen beszállító sem felel meg a kéthetes határidőnek, holott több is megfelel.
Hogyan állítsa be az ügynöki feladatokat a kontextusromlás csökkentése érdekében
A feladatok helyes beállítása minimálisra csökkenti a kontextusromlás hatását, és a feladat teljes időtartama alatt a lehető legpontosabban tartja az ügynököt. Az alábbi bevált gyakorlatok segíthetnek.
Fogalmazza meg a feladatot megbízásként
Egy világos megbízás kisebb kontextust eredményez. Az ügynök tudja, mikor végzett, így abbahagyja az anyaggyűjtést, amint elég összegyűlt. A konkrét követelmények emellett kézzelfogható szempontot adnak, amelyhez minden oldalt viszonyíthat. Így az ügynök könnyebben kiszúrja a megfelelő információt.
Mielőtt elküld egy feladatot, ellenőrizze, hogy kitér-e a következő három dologra:
- A feladat: mit tegyen és mit hozzon létre az ügynök, például „keress beszállítókat, és állíts össze egy szűkített listát”.
- A követelmények: azok a tények, amelyeket az ügynök nem tud kitalálni, például a költségkeret, a határidő, a szállítási cím, és hogy kinek készül az eredmény.
- A kimenet: a formátum, a hossz és a felépítés, például „egy táblázat a névvel, a székenkénti árral és a szállítási idővel”.
Mindezt összerakva a beszállítókereső feladat lekérdezése így nézhet ki:
„Keress 10 olyan beszállítót, amely két héten belül 40 irodaszéket tud szállítani a chicagói irodánkba, székenként 250 dollárnál alacsonyabb áron. Készíts egy táblázatot a beszállító nevével, a székenkénti árral, a szállítási idővel és a termékoldal linkjével. A lista az irodavezetőnknek készül, aki majd leadja a rendelést.”
Minden feladat legyen fókuszált
Ha egy feladatnak egyetlen világos célja van, a kontextus kicsi marad. A hosszú feladatok ráadásul többe is kerülnek. Minden lépés feldolgozza az addig összegyűjtött összes anyagot, így a felduzzadt kontextus minden lépésnél több kreditet használ fel.
Ha egy projekt több részből áll, bontsa fel:
- Sorolja fel a különálló leszállítandó eredményeket, például egy beszállítókeresést, egy árösszehasonlítást és egy e-mailt a kiválasztott beszállítónak.
- Minden leszállítandó eredményt külön feladatként futtasson.
- Az egyik feladatból a következőbe csak a kész eredményt adja át. Az összehasonlító feladat indításához például töltse fel fájlként a beszállítói táblázatot, ahelyett, hogy abban a szálban folytatná, amelyben az elkészült.
Így az összehasonlító feladat az összes oldal helyett egyetlen táblázattal indul.
Irányítsa az ügynököt a megfelelő forrásokhoz
Minden oldal, amelyet az ügynök elolvas, növeli a kontextusát, beleértve a hasznos rész körüli menüket, hirdetéseket és sablonszövegeket is. Ha közvetlenül megadja az ügynöknek a forrásait, azzal csökkenti ezt a zajt.
A lekérdezéshez csatolva töltse fel azokat a fájlokat, amelyekre a feladat épül, például a jóváhagyott szállítók listáját. Ha az ügynöknek a weben kell keresnie, nevezze meg azokat a webhelyeket, amelyeken érdemes keresni, például két megbízható beszállítói címtárat.
Csatlakoztassa azokat az eszközöket, ahol az információ található. A Perplexity Computerben például nyissa meg az oldalsávon a Csatlakozók menüpontot, és engedélyezze a feladathoz szükséges alkalmazásokat, például a Google Drive-ot vagy a Slacket. Ezután említse meg őket a lekérdezésben: „Használd a Google Drive-unkban lévő székspecifikációkat.” Csak a releváns alkalmazásokat csatlakoztassa, mivel minden csatlakozó elfoglal valamennyit az ügynök kontextusából.
Ha az információ olyan alkalmazásban található, amely nem szerepel a Csatlakozók listáján, előfordulhat, hogy mégis csatlakoztatható. Számos alkalmazás kínál MCP-csatlakozót (Model Context Protocol), amely szabványos módja annak, hogy az AI-eszközök más szoftverekhez kapcsolódjanak. A Computer a beépített csatlakozói mellett ezeket is használhatja. Céges fiókban előfordulhat, hogy először egy rendszergazdának kell engedélyeznie őket.
Kérjen végső ellenőrzést az utasítások alapján
A lekérdezést egy ellenőrző lépéssel zárja, amely megnevezi a legfontosabb megkötéseket:
„Mielőtt befejeznéd, ellenőrizd az összes beszállítót a következő követelmények alapján: két héten belüli szállítás, székenként 250 dollár alatti ár. Jelöld meg azokat, amelyek nem felelnek meg ezeknek a követelményeknek, ahelyett, hogy kihagynád őket.”
A megkötések továbbra is a kontextus elején szerepelnek. Az ellenőrző lépés okot ad az ügynöknek arra, hogy a végső kimenetét összevesse a megkötésekkel, ahelyett, hogy arra hagyatkozna, hogy az utasítások minden lépésen át megtartják a hatásukat.
Ha pedig arra kéri, hogy jelölje meg a problémákat ahelyett, hogy egyszerűen elvetné az érintett találatokat, a hibák könnyebben észrevehetők (például ha elutasít egy beszállítót, amely 14 naptári napon belüli kézbesítést ígér, csak mert nem a „két hét” kifejezést használja).
Tekintse át a munkát ellenőrzőpontoknál
Hosszabb feladatoknál építsen be egy ellenőrzőpontot a lekérdezésbe:
„Először keress 20 lehetséges beszállítót, aztán állj meg. Mielőtt összegyűjtenéd az árakat, jóváhagyom a listát.”
Vesse össze a szűkített listát az eredeti utasításokkal. Ami nem megfelelő, azt javítsa ki egy további üzenetben, majd hagyja, hogy az ügynök folytassa. Az ezen a ponton észrevett hibák nem gyűrűznek tovább az összes további lépésbe.
Indítson új feladatot, ha egy feladat letér a helyes útról
Ha az ügynök a javítások után is ugyanazt a hibát ismétli, indítson új feladatot. Minden javítás további szöveget ad egy amúgy is hosszú kontextushoz. Hozzon létre inkább egy új feladatot. Fogalmazza meg újra az utasításokat, töltse fel az első próbálkozás használható eredményeit, és kezdje újra.
Egyes ügynökök ennek egy változatát automatikusan elvégzik; ezt a folyamatot tömörítésnek nevezik. Ahogy egy feladat egyre hosszabb lesz, az ügynök a régebbi anyagokat – például a korábban elolvasott oldalak teljes szövegét – a talált információk rövid összefoglalójával helyettesíti. A Perplexity Portable Computer is így tömöríti a kontextusát, hogy a modell azon a mennyiségen belül maradjon, amelyet jól tud kezelni.
Akkor is fontos új feladatot indítani, ha megváltozik a cél. Egy beszállítókeresésként indult szálból ne váljon szerződés-felülvizsgálat is.
Alakítsa az ismétlődő utasításokat Skillé
Bizonyos utasítások egy adott típusú feladatnál minden alkalommal előkerülnek, például egy előnyben részesített táblázatformátum, a kerülendő szállítók listája vagy egy szokásos ellenőrző lépés. A Computerben ezeket Skillként lehet elmenteni; a Skill az utasítások újrafelhasználható készlete, amelyet az ügynök minden alkalommal követ. A Skill a többi bevált gyakorlatot is beépíti minden olyan feladatba, amely használja.
Így hozhat létre egyet:
- Válasszon egy gyakran előforduló feladatot, például a beszállítók felkutatását.
- Írja le azokat az utasításokat, amelyeket minden alkalommal megad: a formátumot, az ellenőrzéseket, a használandó vagy kerülendő forrásokat.
- Mentse el őket Skillként. A Markdown formátumban már megírt utasítások közvetlenül importálhatók.
- A későbbi lekérdezésekben nevezze meg a Skillt: „Használd a beszállítókutatási Skillt, hogy székbeszállítókat találj a denveri irodának.”
Hogyan kezeli a Perplexity a kontextust az ügynöki munkában
A Perplexity Computer úgy kezeli a hosszú feladatokat, hogy az egyes modellek kontextusa kicsi és releváns maradjon. A kialakítás három eleme korlátozza, hogy egy modellnek egyszerre mennyit kell elolvasnia.
A munka elosztása alügynökök között
A Computer a kérést feladatokra és részfeladatokra bontja, majd alügynököket hoz létre a végrehajtásukhoz. Minden alügynök a munka egy részén dolgozik, a saját kontextusában. A beszállítós feladatnál az egyik alügynök az árakat kutathatja, míg egy másik a szállítási feltételeket ellenőrzi. Egyiküknek sem kell elolvasnia mindazt, amit a másik elolvasott.
A munka tárolása fájlokban
Minden Computer-feladat saját munkaterületet kap, saját fájlokkal, webböngészővel és eszközökkel. Az ügynök fájlba mentheti a munkáját, például egy folyamatosan bővülő táblázatot az általa már ellenőrzött beszállítókról. Ezt a fájlt aztán csak akkor nyitja meg újra, amikor szüksége van rá.
A releváns szövegrészek kiválasztása a keresési találatokból
A weboldalak tele vannak olyan tartalommal, amelyre a modellnek nincs szüksége, például menükkel, hirdetésekkel, metaadatokkal és más témákról szóló szöveggel. A lekérdezésfüggő kontextustömörítés ezeket eltávolítja. Mielőtt egy oldal eljutna a modellhez, a Perplexity csak a lekérdezéshez kapcsolódó mondatokat tartja meg.
Fedezze fel a Perplexity Computerhez készült tippeket, útmutatókat és példafeladatokat, és ültesse át a gyakorlatba ezeket a lépéseket.
GYIK
Ugyanaz a kontextusromlás, mint a hallucináció?
Nem, de összefüggenek. A hallucináció minden olyan válasz, amely valótlan vagy alátámasztatlan állítást tartalmaz. A kontextusromlás egyike azoknak a körülményeknek, amelyek valószínűbbé teszik a hallucinációkat, csakúgy, mint más hibákat, például a figyelmen kívül hagyott utasításokat és az elsikkadó részleteket.
Megszüntethető-e a kontextusromlás egy jobb lekérdezéssel?
Egy világos lekérdezés azáltal csökkenti a kontextusromlást, hogy fókuszban tartja a feladatot. A kontextus növekedését azonban nem tudja megakadályozni. Egy kellően hosszú feladatnál az ügynök így is több anyagot gyűjt, mint amennyit jól fel tud használni, ezért a munka felosztása és menet közbeni ellenőrzése ugyanolyan fontos, mint maga a lekérdezés.
A kontextusromlás a hagyományos AI-csevegéseket is érinti, nem csak az ügynököket?
Igen. Egy csevegésben a kontextus az eddigi teljes beszélgetés, beleértve minden üzenetet és minden bemásolt vagy feltöltött dokumentumot. Egy órák óta, több témán át futó szál ugyanolyan hibákat okozhat, mint egy hosszú ügynöki feladat. Ha új témához új szálat indít, minden beszélgetés fókuszált marad.
Milyen hosszú lehet egy feladat, mielőtt beállna a kontextusromlás?
Nincs rögzített határ. Ez a modelltől és a feladattól függ. A 260 000 tokenes kontextusablakkal rendelkező, eszközön futó modellek például körülbelül 100 000 token felett kezdenek nehézségekbe ütközni, jóval a korlátjuk előtt. A romlás ráadásul fokozatos, nem hirtelen.