
Come monitorare e controllare la spesa in token del team
Come i team possono visualizzare il proprio utilizzo dei token in dashboard e report, quali tipi di lavoro con l'IA consumano più token e come usare i controlli per ridurlo.
Che cos'è la spesa in token
La spesa in token è il numero di token che un team consuma utilizzando l'IA, insieme al costo di quei token. Un token è un'unità di testo, come una parola, una parte di parola o un segno di punteggiatura, che un modello di IA legge o scrive. In inglese, 1 token corrisponde all'incirca a 4 caratteri. I token non sono standardizzati tra modelli o provider, quindi lo stesso testo può generare un conteggio diverso a seconda dello strumento.
I report di utilizzo in genere suddividono i token in alcune tipologie:
- I token di input sono tutto ciò che il modello legge per una richiesta. Comprendono la query, l'eventuale testo allegato e la cronologia della conversazione che il modello riutilizza dai messaggi precedenti dello stesso thread.
- I token di output sono la risposta scritta dal modello. Spesso costano più dei token di input. Nei prezzi dell'API di Perplexity, alcuni modelli applicano all'output una tariffa sei volte superiore.
- I token di ragionamento sono il testo che un modello genera internamente per elaborare un problema prima di rispondere. Non compaiono nella risposta, quindi una risposta visibile più lunga non significa necessariamente che il modello abbia usato più token nel complesso.
I team che usano strumenti di IA in abbonamento raramente vedono un addebito per token. I token, però, influiscono comunque su ciò che ottengono, perché le attività più impegnative consumano crediti o raggiungono i limiti di utilizzo più rapidamente. I team che creano i propri strumenti basati su un modello di IA in genere pagano invece per token, con una tariffazione a consumo.
Come monitorare la spesa in token
Monitorare la spesa in token con un piano in abbonamento
Gli strumenti in abbonamento di solito non mostrano il conteggio dei token. Molti piani utilizzano invece i crediti, unità prepagate che vengono scalate dal piano man mano che il lavoro procede. I crediti non equivalgono ai token, perché un credito può coprire testo, immagini o altri tipi di lavoro. Tuttavia, le attività che usano più token di solito consumano anche più crediti, per cui i crediti sono l'indicatore più affidabile della spesa in token in un abbonamento. Gli utenti possono monitorare il proprio utilizzo dei crediti e alcuni piani includono anche una dashboard di amministrazione che mostra l'utilizzo dei crediti dell'intero team.
In Perplexity, ad esempio, le normali ricerche non consumano crediti. Li utilizza solo Perplexity Computer, l'assistente che gestisce le attività in più passaggi. Chi usa Computer può vedere quanti crediti ha utilizzato e per cosa. Ogni attività di Computer mostra inoltre il proprio totale di crediti nel menu "Utilizzo" della relativa conversazione.
Nei piani Enterprise, gli amministratori possono vedere quante persone usano Perplexity e quante query eseguono ogni settimana nella dashboard Insights (disponibile per le organizzazioni con 50 o più posti o con almeno un membro Enterprise Max).
Monitorare la spesa in token nei report di utilizzo dell'API
I report di utilizzo del provider dell'API mostrano direttamente il conteggio dei token, di solito suddiviso per tipo di token. La console API Platform di Perplexity, ad esempio, consente agli utenti di monitorare nella pagina Fatturazione metriche come la spesa in token di input, di output e di ragionamento.
Perché la spesa in token è in aumento
Gli agenti eseguono molti passaggi per ogni attività e ogni passaggio è una richiesta separata a un modello. Una singola attività può arrivare a centinaia di migliaia o persino milioni di token.
Anche i modelli di ragionamento si stanno diffondendo sempre di più. Un modello di ragionamento mette per iscritto il proprio processo di pensiero prima di rispondere, e ogni parola di quel processo conta come token. Per questo la stessa richiesta di solito usa più token su un modello di ragionamento che su uno standard, anche se la risposta sullo schermo sembra della stessa lunghezza.
Infine, man mano che sempre più persone e flussi di lavoro usano l'IA in generale, l'utilizzo dei token si accumula. Parte di questa crescita deriva anche dal tokenmaxxing, la pratica per cui gli ingegneri eseguono agenti principalmente per aumentare il proprio conteggio personale di token e salire nelle classifiche interne dei token.
Come ridurre la spesa in token
La maggior parte della spesa elevata in token deriva da alcuni tipi di lavoro che consumano più token di quanto sembri.
Conversazioni lunghe e attività degli agenti
Ogni volta che un modello risponde, di solito rilegge l'intera conversazione fino a quel momento. Ogni nuova richiesta include tutta la cronologia precedente della conversazione più il messaggio attuale dell'utente. Quindi una breve domanda posta alla fine di un thread lungo usa più token della stessa domanda posta in un thread nuovo. Le attività degli agenti funzionano allo stesso modo, perché ogni passaggio aggiunge i propri risultati alla cronologia che il passaggio successivo rilegge.
Cosa fare
- Avvia una nuova conversazione quando cambi argomento. Aprila con un riepilogo di due o tre righe di ciò che, del thread precedente, serve ancora al modello.
- Suddividi le attività lunghe degli agenti in attività più piccole. Esegui ogni parte come attività a sé stante e passa alla parte successiva solo i risultati di cui ha bisogno.
- Verifica se gli strumenti per agenti usati dal team supportano la compattazione del contesto. La compattazione riassume automaticamente le parti meno recenti di un'attività, così il modello deve rileggere meno testo. Se uno strumento la offre come impostazione, attivala.
Gli stessi documenti elaborati più e più volte
Quando qualcuno allega lo stesso file lungo, come un manuale delle policy aziendali o un catalogo prodotti, a molte query distinte, il modello legge l'intero file ogni volta. Ogni lettura conta come token di input.
Cosa fare
- Insegna agli utenti a copiare nella richiesta la sezione pertinente di un manuale o di un catalogo, invece di allegare l'intero file.
- Crea una versione breve dei documenti che il team usa spesso. Un riepilogo di una pagina di una policy lunga può sostituire il documento completo nelle query di routine.
Tentativi ripetuti e loop
Quando una risposta non è quella di cui si aveva bisogno e si esegue di nuovo l'attività, ogni tentativo consuma token. Lo stesso accade quando un agente si blocca ripetendo lo stesso passaggio.
Cosa fare
- Specifica chiaramente l'attività, il risultato e le fonti nella prima richiesta. Ad esempio: "Riassumi in cinque punti elenco i motivi principali per cui i clienti hanno disdetto nel terzo trimestre, utilizzando solo i risultati del sondaggio allegati."
- Controlla i primi passaggi di un'attività di un agente. Se l'agente ripete lo stesso passaggio o la stessa ricerca, interrompilo e riavvialo con una richiesta più circoscritta.
Modelli di grandi dimensioni per attività semplici
I modelli più potenti di solito costano di più per token, quindi le attività di routine come riepiloghi o riformattazioni possono esaurire il budget di un team più velocemente del necessario.
Cosa fare
- Usa il routing dei modelli, che assegna ogni attività a un modello in grado di gestirla. Una breve riscrittura o un riepilogo possono essere affidati a un modello più piccolo ed economico, mentre il modello più potente viene riservato al ragionamento in più passaggi o all'analisi. L'API di Perplexity adotta questo approccio con i suoi preset, che assegnano un modello più piccolo a una ricerca rapida e uno più grande a un'analisi approfondita.
Picchi dopo l'introduzione di nuovi flussi di lavoro
Un nuovo flusso di lavoro automatizzato, o uno strumento distribuito a un intero team, può far aumentare l'utilizzo da un giorno all'altro. Un picco non è di per sé un problema, ma è utile sapere quale lavoro lo ha causato.
Cosa fare
- Prova i nuovi flussi di lavoro prima con un gruppo ristretto. Controlla il loro utilizzo per una o due settimane prima di estendere il flusso di lavoro all'intero team.
- Imposta un budget mensile per ciascun team. Basalo sull'utilizzo di un mese tipico, in modo che un aumento improvviso risalti.
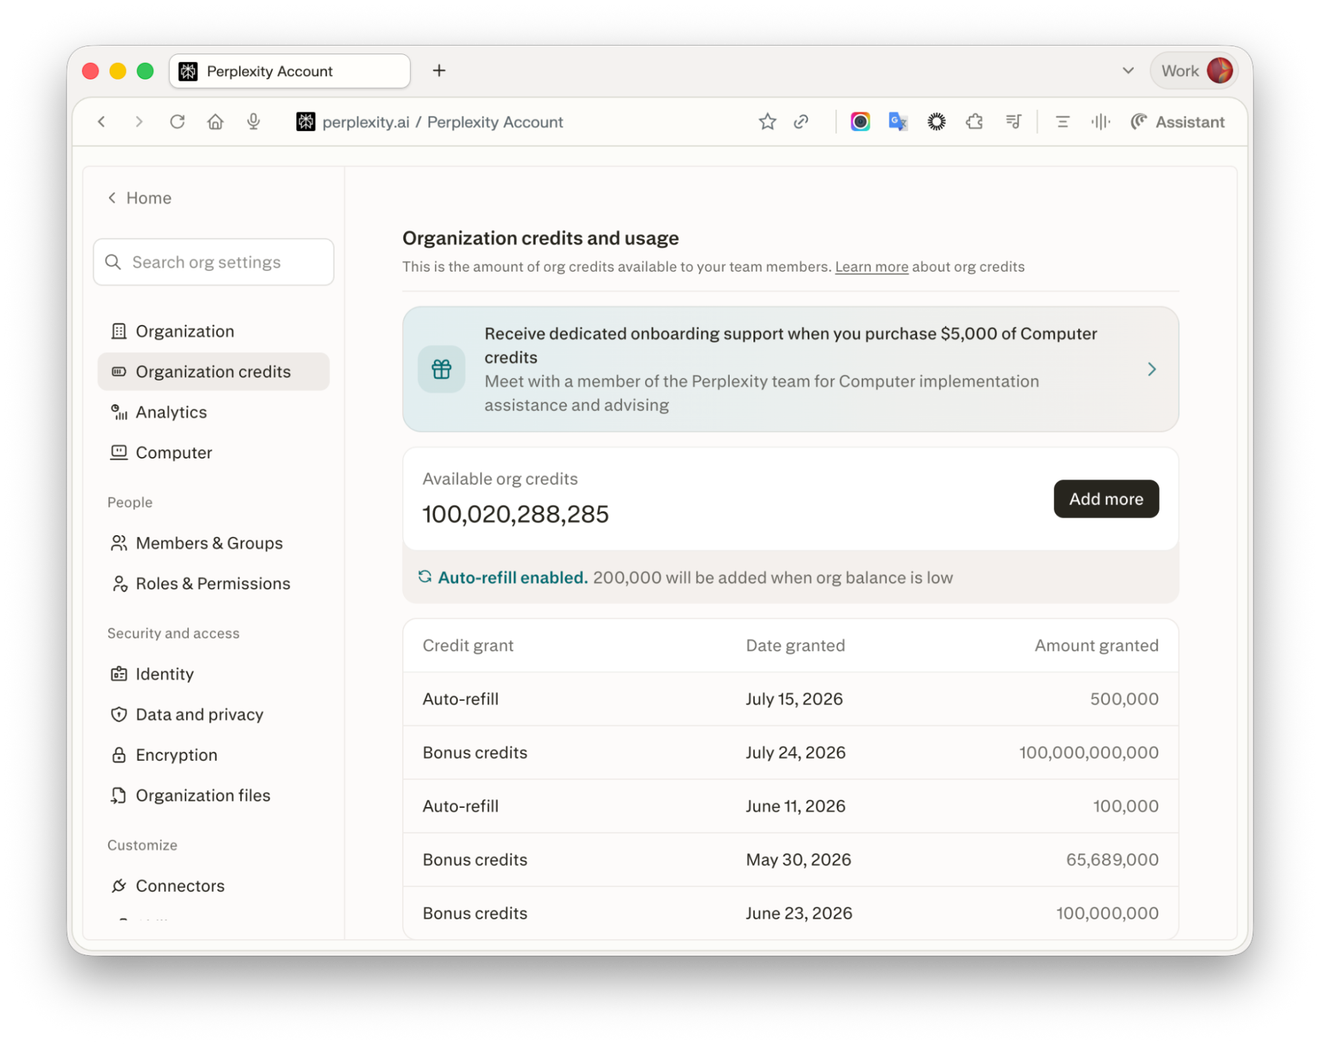
- Disattiva la ricarica automatica. Con la ricarica automatica disattivata, il lavoro si interrompe quando i crediti si esauriscono, anziché acquistare automaticamente altri crediti.
Come ottimizzare la spesa in token in Perplexity
Per l'uso quotidiano
Computer consuma crediti, ma si attiva solo quando lo scegli tu: selezionando l'icona di Computer, lavorando in un progetto che usa Computer come modalità predefinita oppure usando la modalità Work di Comet.
Per tornare alla ricerca normale, seleziona l'icona di Perplexity per passare di nuovo alla modalità Ask. Per vedere l'utilizzo dei crediti, gli utenti possono aprire il tracker all'interno dell'interfaccia di Perplexity.
I team che lavorano nei progetti, gli spazi di lavoro condivisi di Perplexity, possono impostare la modalità predefinita di ciascun progetto su Search o Computer. Un progetto usato soprattutto per ricerche rapide può avere Search come modalità predefinita, così nessuno avvia per errore un'attività di Computer.
Per gli amministratori Enterprise
- Scopri cosa include ogni posto. Gli utenti Enterprise Pro ricevono un'assegnazione mensile di 500 crediti, mentre gli utenti Enterprise Max ne ricevono 15.000. Questi crediti scadono alla fine di ogni ciclo mensile e non vengono trasferiti al ciclo successivo.
- Imposta innanzitutto un limite di utilizzo predefinito. Un limite di utilizzo stabilisce quanti crediti aggiuntivi un membro può prelevare dal pool condiviso una volta esaurita la propria assegnazione.
- Crea limiti con nome per i diversi tipi di utenti. Gli amministratori possono configurare limiti come "Standard", "Power user" e "Collaboratore esterno" e assegnarli a gruppi di utenti o a singoli membri. I gruppi possono essere creati in Perplexity o sincronizzati dal provider di identità dell'azienda. Se una persona appartiene a più gruppi, si applica il limite più alto.
- Usa gli override personali per le eccezioni. Quando una persona ha bisogno di un limite diverso da quello del proprio gruppo, l'override personale ha la precedenza su qualsiasi limite di gruppo o condiviso. È utile, ad esempio, per un breve progetto con molta attività di ricerca, senza dover alzare il limite per un intero team.
- Fissa un tetto alla ricarica automatica. La ricarica automatica rifornisce automaticamente il pool condiviso e prevede un limite mensile di ricarica configurabile, così la spesa non può crescere senza un massimo prestabilito.
- Decidi come i membri possono chiedere più crediti. L'impostazione Consenti ai membri di richiedere più crediti permette a chi raggiunge il proprio limite di chiederne altri a un amministratore, anziché essere bloccato del tutto.
- Controlla l'utilizzo ogni mese. La pagina Crediti dell'organizzazione mostra i crediti assegnati, utilizzati e rimanenti per ciascun membro, insieme ai limiti di gruppo e al saldo del pool. Per le organizzazioni con 50 o più posti o con almeno un membro Enterprise Max, la dashboard Insights aggiunge gli utenti attivi mensili e l'andamento delle query settimanali nel tempo. Per maggiori dettagli, i log di audit registrano l'esecuzione delle attività, l'utilizzo dei connettori, il consumo di crediti e le assegnazioni di crediti.
Per i team che sviluppano con l'API
- Assegna a ogni strumento o team una propria chiave API. Perplexity può mostrare la fatturazione di ciascuna chiave separatamente e chiavi distinte rendono chiaro quale strumento sta generando l'utilizzo.
- Controlla nella pagina di fatturazione quale tipo di token sta aumentando. La pagina mostra i token di input, di output e di ragionamento nel tempo. Un aumento dei token di input di solito indica che uno strumento sta inviando più testo del necessario. Un aumento dei token di ragionamento indica che le attività vengono eseguite su modelli che elaborano i problemi in modo approfondito.
- Usa la Search API quando uno strumento ha bisogno solo dei risultati di ricerca. Restituisce risultati web senza che un modello scriva una risposta e prevede un costo per richiesta, senza costi aggiuntivi basati sui token.
- Avvia gli strumenti per agenti a partire da un preset. I preset di Perplexity adattano la dimensione del modello a quella dell'attività ed evitano di usare i modelli più costosi per le richieste semplici
Lavoro local-first
Alcuni lavori non richiedono affatto un modello cloud a pagamento. Portable Computer è una versione dell'agente di Perplexity che viene eseguita sul computer dell'utente, utilizzando un modello di IA archiviato su quella macchina. Poiché il modello viene eseguito in locale, il lavoro di routine non consuma token a pagamento. Si collega al web, alle app connesse o a un modello cloud più potente solo quando un'attività lo richiede, e prima chiede il permesso all'utente.
Scopri come Perplexity Computer gestisce il lavoro in più passaggi sul web, nei file e negli strumenti collegati.
Domande frequenti
Qual è la differenza tra spesa in token e costi dell'IA?
La spesa in token misura la quantità di lavoro con l'IA svolto da un team, conteggiata in token. I costi dell'IA comprendono tutto ciò che un team paga per usare l'IA, inclusi abbonamenti, crediti aggiuntivi e configurazione. La spesa in token determina la parte a consumo di quella fattura.
Gli utenti in abbonamento pagano per token?
Di solito non direttamente. Gli strumenti in abbonamento misurano l'utilizzo in messaggi, query o crediti, e le attività che usano più token li esauriscono più rapidamente. Su Perplexity, le normali ricerche non consumano affatto crediti: li consumano solo le attività di Computer.
Perché gli agenti di IA usano così tanti token?
Un agente completa un'attività in molti passaggi e ogni passaggio è una richiesta separata che rilegge il lavoro svolto fino a quel momento. Per questo un'attività lunga usa sempre più token a ogni passaggio.
Perché l'utilizzo dei token aumenta all'improvviso?
La maggior parte dei picchi segue un cambiamento nel modo di lavorare di un team, come un nuovo flusso di lavoro automatizzato, uno strumento distribuito a più persone o una lunga attività di un agente. Confrontare la data del picco con i lanci recenti di solito ne rivela la causa. Testare prima i nuovi flussi di lavoro con un gruppo ristretto aiuta a prevenire i picchi.