
AI-minne: hva det er, hvordan det fungerer, og hva det lagrer
En guide til AI-minne: hvordan AI-assistenter lagrer og husker detaljer fra tidligere samtaler, hva de lagrer, hvor minnet slår feil, og hvordan du kan se, redigere eller slå det av.
KI-minne er informasjon som en samtalebasert KI-assistent lagrer fra tidligere samtaler og tar med inn i nye, slik at den kan huske preferansene og konteksten din. Selve modellen beholder ingenting av dette. Assistenten lagrer det separat og legger det til igjen når det er relevant, noe som gir modellen vedvarende kontekst den ellers ville manglet.
Denne veiledningen forklarer hvordan assistenter lagrer og henter frem denne informasjonen, hva de lagrer, hvorfor de noen ganger tar feil, og hvordan du kan se, endre eller slå den av.
Hva er KI-minne?
KI-minne, også kalt vedvarende minne, er en funksjon i KI-assistenter som lagrer informasjon om deg, for eksempel preferanser, fakta og kontekst fra tidligere interaksjoner, som assistenten kan bruke i senere samtaler.
En KI-assistent kan bygge opp denne oversikten ut fra ting du ber den huske, detaljer den fanger opp på egen hånd, og tidligere chatter den kan se tilbake på.
KI-minnelaget gjør det mulig for KI-assistenter å gi personlig tilpassede svar uten at du må dele preferansene dine i hver chat. Hvis du har fortalt en assistent at du trener til et maraton og foretrekker kilometer, får du svar i kilometer på neste spørsmål om tempo uten å måtte gjenta det.
Sammenlignet med å forklare situasjonen din på nytt i hver chat sparer minnet deg for skriving og holder prompten kort, noe som er viktig fordi lange inndata gjør svarene mindre nøyaktige.
Minnet er ikke en utskrift av hver samtale, men en samling viktige fakta om deg. Det vil derfor huske at du foretrekker kilometer. Om du kan finne nøyaktig den treningsplanen den utarbeidet forrige måned, avhenger av om assistenten også kan slå opp i tidligere chatter.
Typer KI-minne
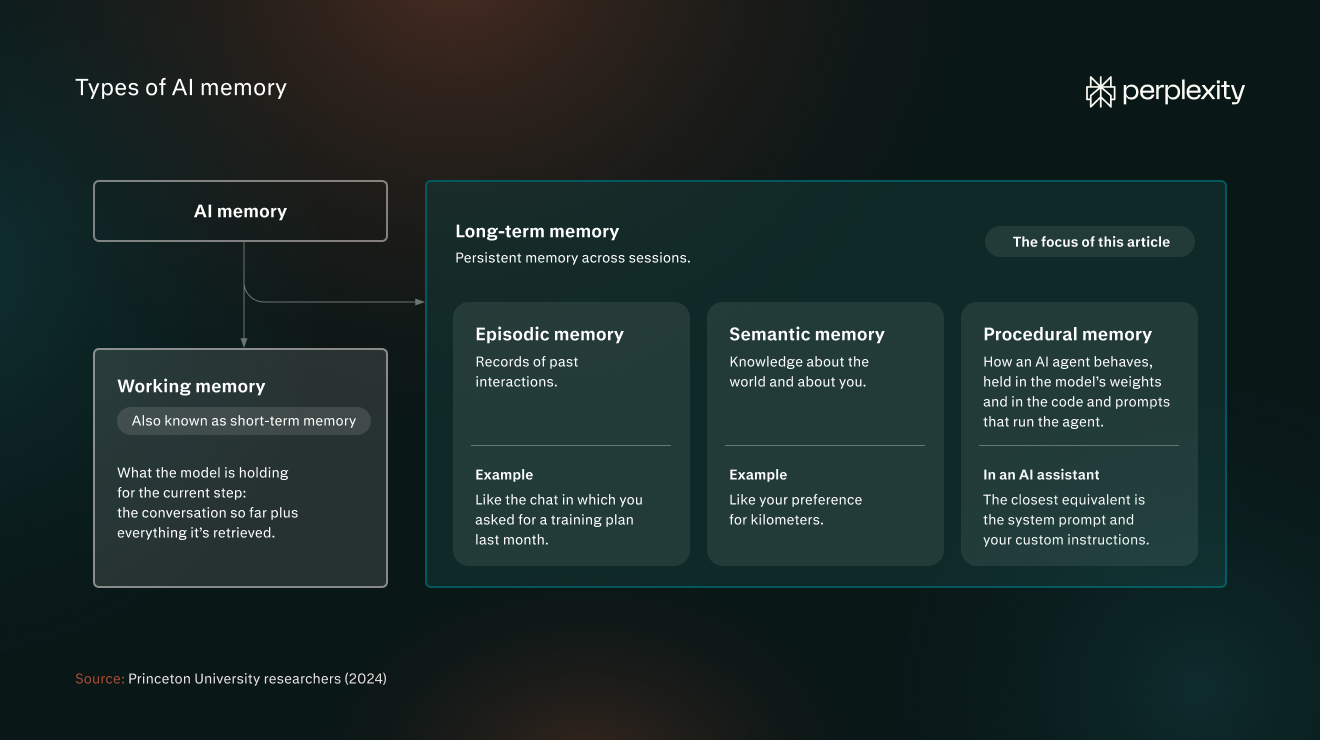
Forskere fra Princeton University (2024) har lånt terminologi fra forskningen på menneskelig hukommelse for å klassifisere typer KI-minnesystemer. Rammeverket deres skiller arbeidsminne fra langtidsminne:
- Arbeidsminne: Det modellen holder på for det nåværende trinnet, altså samtalen så langt pluss alt den har hentet frem. Kalles også korttidsminne.
- Langtidsminne: Vedvarende minne på tvers av økter. Det er denne typen minne denne artikkelen handler om.
Langtidsminne består av tre minnetyper:
- Episodisk minne: Registreringer av tidligere interaksjoner, som chatten der du ba om en treningsplan forrige måned.
- Semantisk minne: Kunnskap om verden og om deg, som at du foretrekker kilometer.
- Prosedurelt minne: Hvordan en KI-agent oppfører seg, innebygd i modellens vekter og i koden og promptene som kjører agenten. I en KI-assistent er det nærmeste motstykket systemprompten og de egendefinerte instruksjonene dine.
Minne i KI-assistenter vs. minne i KI-agenter
Minne i KI-assistenter og minne i KI-agenter er begge langtidsminne. Minne i KI-assistenter er for det meste semantisk minne og lagrer fakta om deg, slik at svarene passer til deg. Agentminne, som Brain fra Perplexity, lagrer hva agenten gjorde og hvordan det gikk, inkludert hva som fungerte og hva du korrigerte, slik at den starter hver nye oppgave fra et bedre utgangspunkt.
Minne i KI-assistenter | Minne i KI-agenter | |
Hva det husker | Deg | Oppgaven og historikken dens |
Hva det brukes til | Svar som passer til deg | Fortsette arbeid i flere trinn uten å begynne på nytt |
Eksempel | Husker at du foretrekker kilometer | Husker maratontreningsplanen din, justeringene den har gjort og øktene du har fullført så langt, slik at den bedre kan planlegge fremtidige treningsblokker |
KI-minne vs. kontekstvinduer, treningsdata og egendefinerte instruksjoner
KI-minne er lett å forveksle med tre andre ting som former et svar: modellens kontekstvindu, treningsdata og egendefinerte instruksjoner. Hver av dem inneholder ulik informasjon, varer ulikt lenge og styres av et annet system.
Et kontekstvindu er mengden tekst en stor språkmodell (LLM) kan lese på én gang, og omfatter den nåværende samtalen. Det tilbakestilles når du starter en ny chat.
Noen av dagens modeller har store kontekstvinduer på en million tokener eller mer, så teknisk sett kunne du limt inn den viktigste informasjonen din i hver samtale. Men å behandle alt dette gir økt ventetid og kostnad.
Flere studier har også funnet at nøyaktigheten i svarene synker etter hvert som inndataene vokser, selv når svaret finnes i konteksten.
En studie fra University of Illinois og Amazon fra 2025 så dette selv når modellene kunne gjengi hver eneste relevante detalj: Nøyaktigheten falt med 13,9–85 % etter hvert som inndataene vokste til 30 000 tokener, langt under modellenes oppgitte grenser. NoLiMa, en referansetest fra 2025 fra Adobe Research og LMU München, fant at 11 av de 13 testede modellene presterte betydelig dårligere allerede ved 32 000 tokener når spørsmålet og svaret ikke hadde noen nøkkelord til felles. Chromas rapport fra juli 2025 så det samme på tvers av 18 modeller, også når de svarte ut fra en chathistorikk på 113 000 tokener.
Treningsdata er informasjonen som er bakt inn i modellens vekter før lansering. Brukere kan ikke endre den. Utviklere kan finjustere en modell på nye data, men det er en teknisk prosess, ikke en brukerinnstilling,
Egendefinerte instruksjoner er regler lagret i assistentens innstillinger som du skriver og redigerer selv for å tilpasse KI-assistentens oppførsel og svar. Du kan for eksempel bruke egendefinerte instruksjoner til å bestemme tonen og stilen i svarene eller hvilke kilder assistenten kan bruke.
Slik skiller de fire seg fra hverandre:
Kontekstvindu | KI-minne | Treningsdata | Egendefinerte instruksjoner | |
Hva det inneholder | Meldingene i den nåværende chatten | Lagrede fakta og preferanser om deg | Det modellen lærte før lansering | Veiledning du skriver selv |
Hvor lenge det varer | Bare denne chatten | Til det oppdateres eller slettes | Fast til en ny modell lanseres | Til du redigerer dem |
Hvem som styrer det | Deg, innenfor grensen modelleverandøren setter. | Deg og assistenten | KI-selskapet | Deg |
Eksempel | Tempospørsmålet du stilte for et minutt siden | At du foretrekker kilometer | Hvordan treningsplaner for maraton vanligvis er bygget opp | Instruksjon om å formatere treningsplaner i et rutenett der radene representerer uker og kolonnene ukedager |
Hva KI-minne lagrer
Assistenter beholder utvalgte detaljer om deg, for eksempel fakta, preferanser og sammendrag, og noen henter også informasjon fra tidligere chatter.
- Fakta og preferanser du ber den huske: Dette er detaljer du uttrykkelig ber assistenten lagre, for eksempel «husk at jeg foretrekker kilometer». Assistenten oppretter minnet når du ber om det, og det varer til du sletter det eller en senere samtale oppdaterer det.
- Detaljer den fanger opp fra samtalene dine: Assistenten lagrer disse når innstillingen er slått på. Perplexity «legger vekt på hvor ofte brukeren stiller spørsmål og gir informasjon», så noe du nevner ofte, har større sjanse for å feste seg enn noe du nevner én gang. Minnet varer til det oppdateres eller du sletter det.
- Henvisninger til tidligere chatter: Assistenten henter informasjon direkte fra tidligere samtaler i stedet for fra en lagret liste. Perplexity kaller dette søkehistorikk: dine tidligere spørsmål og svar, som brukes til å gjøre et nytt svar mer relevant.
Slik fungerer KI-minne
KI-modellen husker ingenting mellom samtaler. Det er KI-minnesystemet som gjør den jobben: Det fører en separat oversikt over deg og legger de relevante delene til i hver nye samtale. Lagring og gjenfinning skjer i bakgrunnen, slik at modellen leser dem sammen med spørsmålet ditt.
Prosessen foregår i fem trinn:
- Lagring: Assistenten lagrer et minne når du ber den om det, eller når den vurderer at en detalj er verdt å ta vare på.
- Oppbevaring: Minnene legges i en database som holdes atskilt fra modellen. I mange systemer er det en vektordatabase, slik at det kan søkes i dem etter betydning. Listen du ser i innstillingene, er en visning av dette minnelageret.
- Gjenfinning: Når du sender en melding, avgjør assistenten hvilke minner som er relevante. Mange systemer gjør dette ved å konvertere meldingen din og hvert minne til embeddinger, altså numeriske representasjoner av betydning, og velge de nærmeste treffene. Slik kan de hente frem et minne selv når det ikke har noen ord til felles med spørsmålet ditt. Enklere systemer laster inn alle lagrede minner i hver samtale.
- Bruk: Minnene som hentes frem, settes inn som ren tekst i inndataene, vanligvis i en blokk med instruksjoner som modellen leser før meldingen din. Modellen behandler dem som all annen tekst i inndataene.
- Oppdatering og fjerning: Assistenten trekker ut fakta fra chatter, søker gjennom eksisterende minner og avgjør om et faktum skal legges til som nytt, oppdatere et eksisterende minne eller slås sammen med et, eller om et gammelt minne som motsier nye funn, skal slettes. Noen assistenter tidsstempler hvert minne for å skille nyere informasjon fra eldre.
Utfordringer og risikoer ved KI-minne
KI-minne er ment å forbedre kvaliteten på svarene, men referansetester viser at gjenfinning fra minnet ikke alltid får frem relevant eller oppdatert informasjon, særlig fra store databaser. Det medfører også sikkerhets- og personvernrisikoer.
Vanlige pålitelighets- og sikkerhetsproblemer knyttet til KI-minne er blant annet:
- Feilbrukte minner: Et minne kan bli trukket inn i et svar det ikke har noe med å gjøre. En studie fra 2026 testet 18 modeller for å se om et lagret minne fra ett livsområde lekket inn i et svar om et annet. Medianfeilraten var 53 %. Studien fant også at når minnet inneholdt brukernes overbevisninger eller påståtte ekspertise, gjentok nesten alle modellene dem, selv om spørsmålet krevde et nøytralt svar.
- Utdaterte minner: Assistenten fortsetter å handle ut fra en detalj etter at en senere samtale har gjort den usann, særlig når du aldri sa det rett ut. I en referansetest fra mai 2026, som testet om modeller legger merke til slike implisitte endringer, oppnådde den beste modellen i snitt 55,2 %.
- Overbelastet minne: Jo mer en assistent må lese gjennom, desto vanskeligere er det å plukke ut det som betyr noe. LongMemEval, en referansetest fra 2024, fant at modeller som leste en chathistorikk på rundt 115 000 tokener, presterte 30 til 60 % dårligere enn modeller som bare fikk de relevante øktene.
- Minneforgiftning: Falsk informasjon eller skjulte instruksjoner havner i en assistents minne, for eksempel gjennom innhold du ber den lese, noe som fører til partiske eller utrygge svar eller datalekkasjer.
- Personvernrisikoer: Minnet tar vare på personlige detaljer utover chatten de kom fra, noen ganger lenger enn du forventer. Perplexity kan for eksempel beholde en logg over slettede minner i opptil 30 dager av sikkerhetshensyn og for feilsøking. Personvernlovgivningen behandler lagrede minner som personopplysninger, så du bør kunne gå gjennom og slette dem.
Slik ser, redigerer og slår du av KI-minne
Du kan se hva en assistent har lagret, slette det, slå av minnet eller bruke en privat chat som ikke oppretter minner.
Minnehåndtering handler om en håndfull kontroller. Her er hva hver av dem gjør, og når du bør bruke dem:
Kontroll | Hva den gjør | Når du bør bruke den |
Se hva som er lagret | Åpner minnebanken din, der du kan søke, filtrere og gå gjennom enkeltoppføringer. | Når et svar inneholder en detalj du ikke forventet. |
Slett et minne | Fjerner oppføringen, og assistenten slutter å bruke den i senere svar (assistenter kan beholde en logg over slettede minner i en periode). | Når et minne er feil, utdatert eller sensitivt. |
Slå av minnet | Hindrer assistenten i å bruke minnet i fremtidige svar (det er ikke sikkert at minner som allerede er lagret, blir slettet – sjekk assistenten din). | Når du vil ha svar uten personlig tilpasning |
Slå av søkehistorikk | Hindrer assistenten i å bruke tidligere spørsmål og svar fra deg. Hvis du sletter en økt fra søkehistorikken, fjernes innflytelsen den har på senere svar. | Når tidligere samtaler styrer svarene, er det lurt å starte på nytt. |
Bruk en inkognitochat | Minne og søkehistorikk er alltid slått av, og spørsmål som stilles der, blir aldri lagret eller brukt i minnet. | For enkeltstående eller sensitive temaer. |
Vil du begynne helt på nytt, kan du slå av minnet og slette det som er lagret.
Slik håndterer Perplexity minne
Minnet i Perplexity fungerer med alle modellene som tilbys.
Perplexity tilpasser svarene ut fra to kilder: minner, som er preferansene og detaljene du deler, og søkehistorikken din. Når et minne påvirker et svar, vises det blant svarets kilder, slik at du kan se hvilke minner som ble brukt, og slette hvilke som helst av dem.
Du kan også tilpasse svarene dine ved å oppgi detaljer om deg selv og ved å gi egendefinerte instruksjoner for prosjekter (hvert prosjekt har sitt eget minnelag).
Perplexity kan bruke minneinnhold til å forbedre modellene sine for forbrukerkontoer (aldri for Enterprise-kontoer) med mindre du slår det av (AI-datalagring under Innstillinger → Preferanser → Kunstig intelligens).
Abonnenter på Max og Enterprise Max får også Brain, et delt minnelag som bygger videre på minnet ved å holde oversikt over prosjektene og arbeidet ditt. Det har sin egen bryter og ignorerer inkognitoøkter.
Prøv Perplexity og se hvordan minner former det neste svaret ditt.
Vanlige spørsmål om AI-minne
Hva er begrenset minne i AI?
IBM definerer AI med begrenset minne som AI som kan huske tidligere hendelser og utfall og overvåke situasjoner over tid, men som ikke kan beholde disse dataene i et langsiktig bibliotek av tidligere erfaringer. Det er én av fire kategorier i en taksonomi over AI-systemer, og IBM plasserer chatboter og virtuelle assistenter i denne kategorien.
Assistentminne er eksternt minne som disse systemene legger til på toppen. Det består på tvers av økter, slik at en assistent kan bruke detaljer du delte i en tidligere samtale.
Hvilken AI-assistent har best minne?
Ingen enkelt assistent er best for alle. Et godt minne er et minne du kan kontrollere, så vurder AI-verktøy ved å stille fire spørsmål: Kan du se hva det har lagret? Kan du slette et minne separat fra chatten det kom fra? Er trening en egen innstilling, atskilt fra minnet? Finnes det en midlertidig modus eller inkognitomodus som ikke oppretter minner?
Lærer en AI-modell av det den husker om deg?
Å bruke minne i et svar er en annen prosess enn trening. Perplexity opplyser at tjenesten henter relevant kontekst fra minnelageret ditt i stedet for å behandle historikken din som treningsdata. Om innholdet ditt kan brukes til å forbedre modeller, er en egen innstilling. På forbrukerkontoer kan Perplexity bruke minneinnhold til dette formålet, og AI-datalagring slår det av.
Hva bør du holde utenfor AI-minnet?
Hold alt du ikke vil ha lagret, brukt til å profilere deg eller gjentatt senere, utenfor AI-minnet: identitets- og økonomiopplysninger, helseopplysninger, passord, informasjon om andre personer og alt som gjelder barn. Canadas personvernombud (mai 2025) og Storbritannias National Cyber Security Centre (mars 2023) anbefaler å unngå enhver ledetekst som ville skapt problemer om den ble offentlig.
Filtre reduserer personvernrisikoen, men garanterer ikke at helse- eller økonomiopplysningene dine ikke blir lagret i det hele tatt, så gå gjennom minnebanken din og bruk inkognito for enkeltstående sensitive spørsmål.