
KI-forskning: viktige artikler og de beste verktøyene for forskere (+ beste praksis)
En guide til KI-forskning – fra banebrytende artikler og ledende institusjoner til de beste KI-verktøyene for forskning og et rammeverk i sju trinn for å bruke dem på en god måte.
Forskning på kunstig intelligens (AI) omfatter to områder: de publiserte funnene til AI-forskere og den praktiske bruken av AI som hjelpemiddel i forskning innen ulike fagfelt.
Den første delen av denne artikkelen er en tidslinje over viktige milepæler i AI-forskningen. Den tar også for seg de viktigste nyere artiklene og gir en oversikt over institusjonene som ligger i front innen feltet.
Den andre delen er en trinnvis veiledning i å bruke AI effektivt som forskningsverktøy, med en rangering av de beste verktøyene og en ærlig gjennomgang av fordeler og ulemper.
En tidslinje over viktige forskningsartikler og milepæler innen AI
Det er praktisk talt umulig å kartlegge alle de viktige AI-forskningsartiklene som er publisert så langt. Feltet har vokst i et enestående tempo det siste tiåret. Ifølge AI Index-rapporten for 2026 fra Stanford University kom det ut 257 890 AI-publikasjoner på verdensbasis i 2024 alene.
Likevel finnes det flere historiske, grunnleggende milepæler, i tillegg til en rekke svært viktige nyere publikasjoner.
En kortfattet tidslinje: 12 grunnleggende forskningsartikler innen AI
- 1943: McCulloch og Pitts publiserer «A Logical Calculus of the Ideas Immanent in Nervous Activity», der de presenterer den første matematiske modellen av hvordan et nervesystem fungerer. Modellen behandler nevroner som funksjoner som mottar inndata og produserer utdata etter logiske regler.
- 1950: Alan Turing publiserer «Computing Machinery and Intelligence» i tidsskriftet Mind. Artikkelen introduserer imitasjonsspillet (vanligvis kalt Turing-testen) som en måte å definere maskinell intelligens på.
- 1956: Dartmouth Summer Research Project, også kalt «Dartmouth-workshopen», etablerer formelt kunstig intelligens som forskningsfelt. Det opprinnelige forslaget fra 1955 ble gjengitt i AI Magazine i 2006.
- 1958: Frank Rosenblatt publiserer «The perceptron: a probabilistic model for information storage and organization in the brain». Han presenterer en grunnleggende læringsmodell basert på et «hypotetisk nervesystem kalt et perceptron».
- 1986: Rumelhart, Hinton og Williams publiserer «Learning representations by back-propagating errors» i Nature. De beskriver en algoritmisk metode kalt tilbakepropagering (backpropagation) for trening av nevrale nettverk med flere lag. Metoden forbedret måten parametere justeres på.
- 1997: Hochreiter og Schmidhuber publiserer «Long Short-Term Memory» i Neural Computation. Artikkelen beskriver en nevral nettverksarkitektur som gjør det mulig for nettverket å beholde informasjon over mye lengre perioder.
- 2009: Forskere publiserer «ImageNet: A large-scale hierarchical image database», som formelt introduserer ImageNet, en database med millioner av merkede bilder for trening og evaluering av AI-systemer.
- 2014: Ian Goodfellow og kolleger publiserer «Generative Adversarial Nets». Artikkelen beskriver et rammeverk som gjør det mulig for AI-systemer å generere realistisk innhold, særlig bilder.
- 2016: Forskere i DeepMind publiserer «Mastering the game of Go with deep neural networks and tree search» i Nature. AlphaGo, AI-systemet som presenteres i artikkelen, slår senere Lee Sedol, en av verdens beste profesjonelle Go-spillere.
- 2017: Forskere i Google publiserer «Attention Is All You Need», som beskriver transformer-arkitekturen som ligger til grunn for de fleste moderne store språkmodeller i dag.
- 2020: Forskere i OpenAI publiserer «Language Models Are Few-Shot Learners». De viser at skalering av språkmodeller (å øke størrelsen på de grunnleggende komponentene uten å endre koden) forbedrer evnen deres til å utføre en rekke oppgaver effektivt.
- 2022: OpenAI lanserer ChatGPT 30. november og bidrar dermed til at samtalebasert generativ AI tas i bred bruk.
Seks viktige nyere utviklinger i AI-forskningen (2025–2026)
- 2025: Forskere i DeepSeek publiserer «DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning». Artikkelen viser at avanserte resonneringsevner kan oppstå gjennom forsterkende læring (RL).
- 2025: Forskere publiserer «s1: Simple Test-Time Scaling». Artikkelen viser at det er mulig å forbedre resonneringsytelsen med relativt beskjedne treningsressurser.
- 2025: Forskere i Google DeepMind publiserer «AlphaEvolve: A coding agent for scientific and algorithmic discovery». AlphaEvolve er et Gemini-drevet system som autonomt utvikler og forbedrer komplekse algoritmer.
- 2025: Google DeepMind kunngjør Genie 3, en verdensmodell som kan generere navigerbare virtuelle miljøer.
- 2026: Forskere i Google DeepMind publiserer «Advancing regulatory variant effect prediction with AlphaGenome» i Nature. Artikkelen introduserer AlphaGenome, en AI-modell som forutsier hvordan endringer i DNA-sekvenser påvirker genfunksjon, og som ventes å få betydelige medisinske bruksområder.
- 2026: Forskere publiserer «Accelerating scientific discovery with Co-Scientist» i Nature. Artikkelen presenterer et AI-system med flere agenter som kan generere og forbedre vitenskapelige hypoteser for å hjelpe forskere med å «oppdage ny, original kunnskap».
En oversikt over de viktigste AI-forskningsinstitusjonene
Forskningsresultatene er fordelt på et bredt spekter av private og offentlige organisasjoner. Dedikerte forskningsinstitutter, hvorav mange er tilknyttet ledende universiteter, står for en stor andel av den nye forskningen. Likevel spiller selskaper og AI-laboratoriene deres en viktig rolle.
KI-laboratorier i næringslivet | Selskaper med KI-fokus |
Google DeepMind Microsoft Research Meta AI (FAIR) NVIDIA Research IBM Research | OpenAI Anthropic DeepSeek Mistral AI SpaceXAI |
Forskningssentre ved universiteter | Uavhengige forskningsinstitutter |
Stanford University (SAIL) MIT (CSAIL) Carnegie Mellon University UC Berkeley (BAIR) Tsinghua University | Allen Institute for AI (Ai2) The Alan Turing Institute Mila (Quebec Artificial Intelligence Institute) Vector Institute Max Planck Institute for Intelligent Systems |
Hvor utbredt er AI som forskningsverktøy?
Både utbredte AI-chatboter (Perplexity, ChatGPT, Claude osv.) og dedikerte plattformer bygget rundt store modeller er mye brukt innen mange forskningstunge fagfelt.
En stor studie fra Microsoft av 5,5 millioner Copilot-økter avdekket en rekke forskningsrelaterte oppgaver innen oppdagelse, syntese og analyse.
Her er de fire viktigste måtene fagfolk bruker AI til forskning på:
- Informasjonsinnhenting: Utforskning i tidlig fase (generelle spørsmål); å finne relevant forskning; hjelp med tekniske spørsmål.
- Analyse: Oppsummering av innhold; sammenstilling, tolkning og presentasjon av data.
- Beslutningstaking og strategiarbeid: Bruke AI til å sammenligne alternativer (for eksempel programvare); finne informasjon som kan underbygge beslutninger.
- Evaluering og diagnostisering: Samle inn informasjon om et system eller program som trenger feilsøking.
Husk at disse oppgavene ikke er begrenset til akademia. Journalister, markedsforskere, advokater, finansanalytikere, helsepersonell og andre er alle eksempler på fagfolk som jevnlig bruker AI til forskning.
Fordeler og ulemper ved å bruke AI i forskning
Selv om det ikke er tvil om at AI har fått stor utbredelse som forskningsverktøy, har det pågått en seriøs debatt om fordelene og ulempene. Mye av kritikken har dreid seg om det tilsynelatende uoverkommelige problemet med hallusinasjoner.
Siden det ofte står mye på spill i forskning, er det viktig at fagfolk av alle slag forstår hvor AI-forskningsverktøy utmerker seg, og hvor de kommer til kort.
Fordeler
- Repetitive forskningsoppgaver som litteraturscreening og datarensing kan automatiseres helt eller delvis.
- Ikke-spesialister kan få tilgang til teknisk informasjon utenfor sitt eget fagområde.
- Forskere kan raskt teste forskningshypoteser i tidlig fase ved å kjøre AI-simuleringer.
- AI er nyttig for å utfordre antakelser og legge frem evidensbaserte alternativer, selv til godt gjennomarbeidede standpunkter.
Ulemper
- Hallusinasjoner er fortsatt et betydelig problem, og sikkerhetsmekanismer løser det ikke fullt ut.
- Nyanser i informasjonen kan være svært viktige i forskning på høyere nivå, og LLM-er forenkler ofte komplekse emner for mye.
- Det er påvist at overdreven avhengighet av AI svekker kritisk tenkning og evnen til selvstendig analyse.
- Selv om AI er god til å samle informasjon, er den ikke uttømmende og kan gå glipp av viktige informasjonskilder og studier.
Eksempel på AI som forskningsverktøy med Perplexitys funksjon for akademisk søk
La oss se på hvordan en enkel forskningsprosess kan se ut. Perplexity er et populært verktøy blant forskere fordi det gir tilgang til flere tredjepartsmodeller med hver sine styrker, i tillegg til grundige verktøy for søk på nettet og i akademiske kilder.
I dette eksemplet ber jeg GPT 6.1-Sol om hjelp med markedsundersøkelser for en produktlansering rettet mot generasjon Z. Den gir meg et sammendrag av nyere forskning, sammen med en lenke til kildene og en indikator for pålitelighet.
Deretter ber jeg den om å lage en graf over markedsføringspreferansene til generasjon Z basert på data den henter fra nettet. Jeg kan også laste opp mine egne data hvis jeg ønsker det.
Disse resultatene må gjennomgås og faktasjekkes. Likevel viser dette enkle eksemplet hvordan en prosess som lett kunne ha tatt flere timer, kan komprimeres til minutter.
Beste AI for forskning: De beste verktøyene for forskere
AI-forskningsverktøy kan deles inn i to brede kategorier: generelle chatboter med forskningsfunksjoner og dedikerte plattformer for hjelp med akademisk forskning.
De fleste fagfolk som driver ikke-akademisk forskning, vil oppleve at et generelt AI-verktøy passer dem best. For akademikere er det store likheter mellom de største leverandørene. Hvilket verktøy du velger, vil trolig avhenge av omfanget av oppgaven og preferanser når det gjelder mindre funksjoner.
Generelle KI-verktøy
- Perplexity: Gir tilgang til flere modeller fra tredjepartsleverandører og integrasjoner med et bredt utvalg av eksterne tjenester. Funksjonene omfatter akademisk forskning, dypgående forskning, kildehenvisninger og dataanalyse.
- ChatGPT, Claude og Gemini: Som de ledende KI-verktøyene på massemarkedet, med funksjoner for profesjonelle og bedrifter, tilbyr alle disse et lignende sett med forskningsverktøy. Funksjonene omfatter nettsøk, dypgående forskning, dokumentanalyse, dataanalyse og multimodale egenskaper. De tilbyr også integrasjoner med eksterne applikasjoner og tjenester.
Dedikerte forskningsverktøy
- Semantic Scholar: Dette er en gratis akademisk søkemotor utviklet av Allen Institute for AI (Ai2). Den ligner mye på Google Scholar, men har flere KI-funksjoner. Den er den underliggende kilden til akademisk litteratur for mange KI-verktøy, men er ikke et spesialisert verktøy i seg selv.
- Elicit og SciSpace: Disse verktøyene hjelper til i søkefasen av akademisk forskning og har fått ros for funksjonene sine for screening og syntese. Forskere bruker dem til å hente ut strukturert informasjon og oppsummere funn på tvers av store mengder studier. SciSpace er tilgjengelig som en integrasjon i ChatGPT.
- ResearchRabbit og Connected Papers: Begge disse er verktøy for litteraturgjennomgang som er høyt ansett for funksjonene sine for visuell kartlegging. De er laget for mer langsiktige prosjekter og litteraturgjennomganger, der det viktigste er å finne lignende forskning og kartlegge sammenhenger mellom artikler. De krever mye menneskelig innsats og tilsyn.
- Scite og Consensus: Verktøy som ResearchRabbit og Connected Papers er rettet mot å finne relevant litteratur og skaffe oversikt over et fagområde. Scite og Consensus fokuserer derimot på målrettet evaluering: De hjelper brukerne med å avgjøre om en bestemt påstand støttes av det nåværende kunnskapsgrunnlaget. De har ofte bredere funksjoner for litteraturgjennomgang, men disse er ikke hovedfokuset.
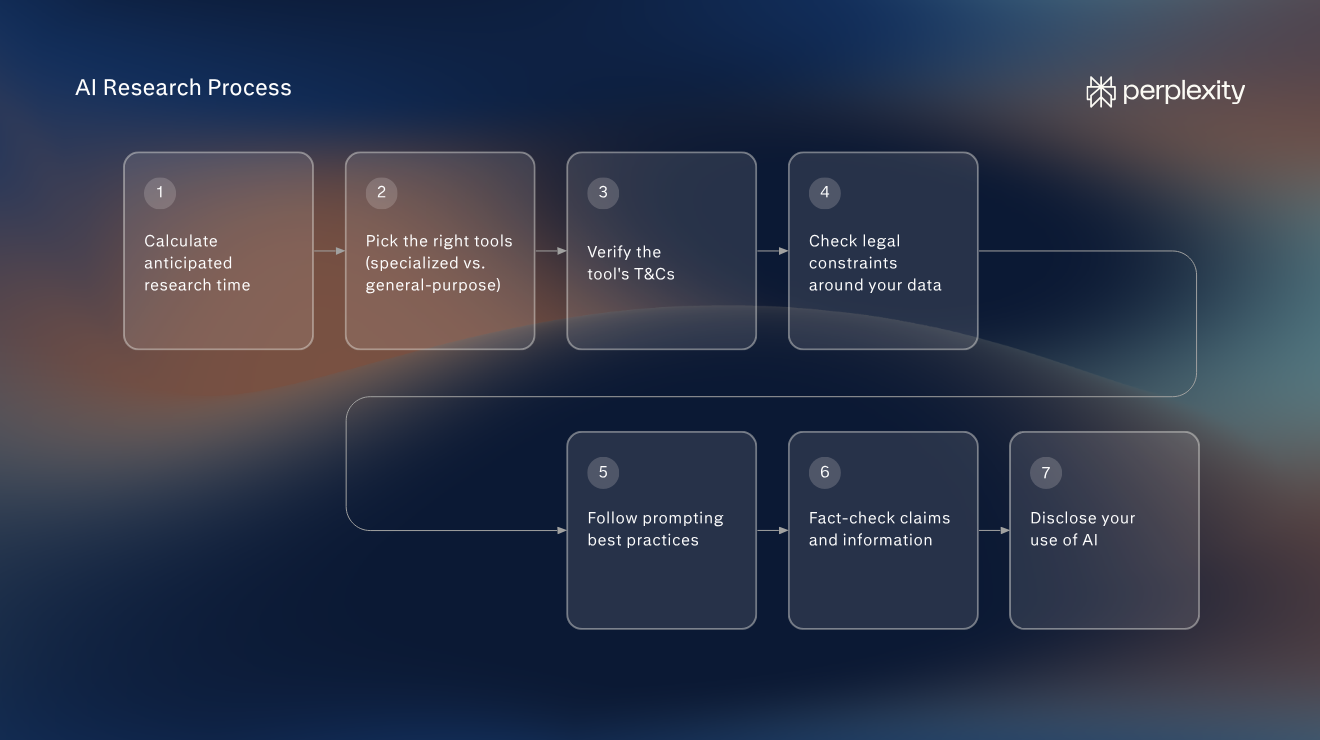
Slik bruker du KI som forskningsverktøy: et rammeverk i sju trinn
Nøkkelen til å bruke KI effektivt som forskningsverktøy er å se på den som et supplement til og ikke en erstatning for de eksisterende prosessene dine. Det er også viktig å ta hensyn til juridiske begrensninger, særlig når du laster opp sensitive data.
1. Beregn forventet tidsbruk
Planlegg forskningsprosessen med konvensjonelle metoder. Spør deg deretter hvor KI kan ta seg av oppgaver innen kildesøk, syntese og analyse.
Beregn hvor lang tid det vil ta å skrive prompter og verifisere funnene. KI kan fort spare deg for timer eller dager på store litteraturgjennomganger. Men for mindre, avgrensede spørsmål er det lite å vinne sammenlignet med et manuelt søk.
2. Velg riktige verktøy (spesialiserte eller generelle)
Finn ut om en spesialisert forskningsplattform gir noen fordeler sammenlignet med en generell assistent som Perplexity. Vær oppmerksom på de enkelte forskningsfunksjonene og dekningen innen ditt fagområde.
Hvis du velger et dedikert verktøy, bør du ta et som er laget for akkurat dine oppgaver. Verktøy som Elicit støtter for eksempel strukturerte litteraturgjennomganger, mens Scite analyserer hvordan akademiske artikler blir sitert.
3. Kontroller at verktøyets vilkår tillater bruken du har planlagt
Det er to ting du bør være oppmerksom på når du ser på en leverandørs vilkår og betingelser. For det første hvordan dine data brukes, og om de holdes fullstendig konfidensielle. For det andre vilkårene for eierskap til resultatene.
Ikke gå ut fra at et betalt abonnement automatisk gir datakonfidensialitet eller ubegrensede bruksrettigheter.
4. Sjekk om det finnes juridiske begrensninger for dataene dine
Vil det du legger inn, inneholde sensitive data, opphavsrettsbeskyttede dokumenter, konfidensiell forretningsinformasjon eller upubliserte funn?
Det er viktig å sjekke at du har lov til å gi disse til en språkmodell (LLM). Det kan gjelde ulike begrensninger, fra databestemmelser i din jurisdiksjon til interne retningslinjer i selskapet. Du må kanskje finne ut hvordan en bestemt verktøyleverandør lagrer data, og hvor lenge. Det kan være nødvendig å bruke en godkjent bedriftsplattform.
5. Følg beste praksis når du skriver prompter
Det er en kunst å sette sammen gode forskningsprompter. Formuler forskningsspørsmålet tydelig, gi relevant kontekst, og angi utdataformatet. For komplekse forskningsoppgaver kan det være nødvendig å dele opp spørsmålet i delprompter.
Be om tydelige referanser til alle kilder som er brukt, selv om de ikke er merket i svaret. Dette er viktig, fordi et KI-generert svar ikke nødvendigvis inneholder kildehenvisninger til alle kildene som er brukt.
6. Faktasjekk alle data, tekniske påstander og aktuell informasjon
Det er avgjørende å kontrollere påstander mot originalkildene. Dette kan være forskningsartikler, primærforskning, offisiell statistikk eller teknisk dokumentasjon. Vær spesielt oppmerksom på tallmateriale, datoer, sitater og tidssensitiv informasjon som kan være utdatert.
Når du forsker, bør du ikke gå ut fra at en påstand er riktig – eller at kilden i det hele tatt finnes – bare fordi en kilde er sitert. Ved kompleks forskning er det i denne fasen du kontrollerer at nyansene i påstander og sammendrag er korrekte.
7. Opplys om bruken av KI
Sett deg inn i kravene til åpenhet om KI-bruk hos arbeidsgiveren din, den akademiske institusjonen din eller den relevante fagorganisasjonen. Der finner du informasjon om i hvilken grad du må opplyse om bruk av KI.
Fagfelt med strenge regler og bransjenormer krever gjerne mer detaljert åpenhet. Før oversikt over KI-assisterte aktiviteter (plattformene har vanligvis et revisjonsspor).
Er det etisk å bruke KI i forskning, og hva skjer videre?
Forskningsassistanse har blitt et av de viktigste bruksområdene for KI, og det er lett å forstå hvorfor. KI kan håndtere store mengder kompleks informasjon, automatisere tidkrevende, repetitive oppgaver og fungere som en sparringspartner for ideer og hypoteser på et tidlig stadium.
Det gjenstår likevel utfordringer. Særlig er etisk bruk av KI i forskning for tiden en av de mest aktive og omstridte debattene ved akademiske institusjoner.
Hyppigheten av hallusinasjoner henger sammen med hvor komplekst emnet er, og mange ledende ingeniører ser på dem som et vanskelig problem som ikke kan løses helt. I tillegg er det kjent at KI-bruk svekker tenkeferdighetene, som er helt avgjørende for fagfolk som arbeider med kompleks forskning.
Organisasjoner kan også forby KI-bruk av hensyn til personvern og immaterielle rettigheter eller på grunn av bekymringer knyttet til sensitive data. Og åpenhet er fortsatt viktig, slik at fagfellevurderere og kolleger kan forstå hvordan KI ble brukt i forskningsprosessen.
KI kommer til å bli en stadig mer naturlig del av hverdagen, både privat og i offentligheten. Derfor er det svært sannsynlig at tydeligere regler for forskningsintegritet og kildeangivelse vil fortsette å utvikle seg og bli mer nyanserte.