
Kontekstforfall i AI-agenter: hvorfor lange oppgaver mister nøyaktighet, og hvordan du kan forhindre det
En veiledning om hva som bygger seg opp i konteksten til en AI-agent, hvorfor det svekker nøyaktigheten, og hvordan du setter opp oppgaver som forblir pålitelige.
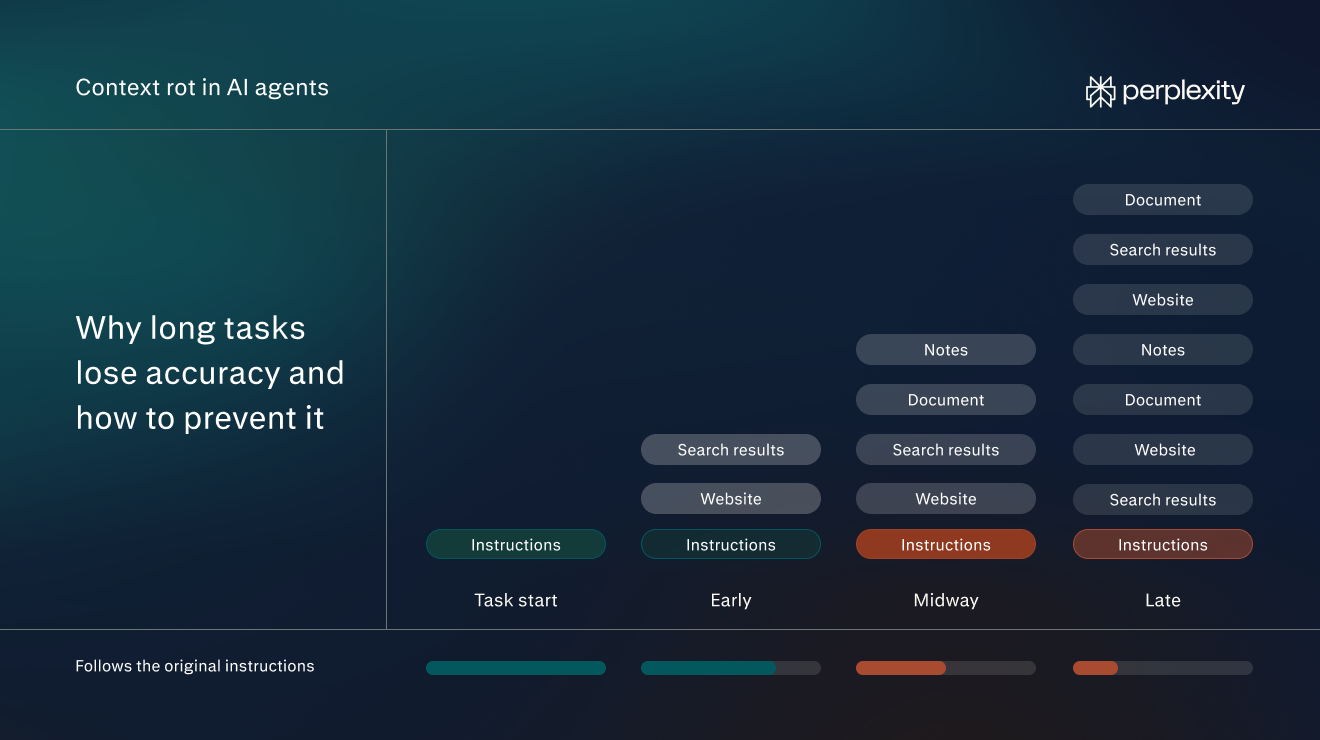
Hva kontekstforfall betyr for AI-agenter
Kontekstforfall i AI-agenter er det gradvise tapet av nøyaktighet som inntreffer etter hvert som agentens kontekst fylles opp under en lang oppgave.
En agents kontekst er informasjonen modellen har tilgjengelig for neste steg. Den kan omfatte instruksjoner, tidligere meldinger, søkeresultater og tekst fra nettsteder eller filer. Etter hvert som agenten arbeider, kan den legge til mer.
Si for eksempel at en agent har som oppgave å finne leverandører som leverer innen to uker. I starten inneholder konteksten bare denne forespørselen. Midtveis i oppgaven vil konteksten også inneholde teksten fra dusinvis av leverandørnettsteder, flere sider med søkeresultater og notater om hvilke leverandører agenten allerede har sjekket.
Det er en grense for hvor mye kontekst en modell kan romme (kalt kontekstvinduet). Vinduet måles i tokens, som er små tekstbiter, vanligvis et ord eller en del av et ord. Kontekstforfallet øker etter hvert som konteksten vokser, og derfor oppstår det oftest i lange oppgaver med mange steg.
Etter hvert som kontekstforfallet forverres, blir agenten mindre nøyaktig. Den kan følge de opprinnelige instruksjonene mindre nøye, overse detaljer eller forveksle informasjon som ligner, med det den faktisk trenger.
Agenten kan for eksempel begynne å ta med leverandører som bruker seks uker, selv om den ble bedt om å finne levering innen to uker. Instruksjonen ligger fortsatt i konteksten, men den styrer ikke lenger agentens valg.
Kontekstforfall er ikke det samme som at det rett og slett blir tomt for plass i kontekstvinduet. Når konteksten til en oppgave vokser forbi vinduet, blir materiale kuttet bort, eller oppgaven mislykkes. Kontekstforfall begynner lenge før det, mens alt fortsatt får plass.
Det er heller ikke det samme som kontekstforgiftning (når villedende eller skadelig informasjon havner i agentens kontekst). En agent med nøyaktig og fullstendig informasjon kan likevel oppleve kontekstforfall.
Hvorfor kontekstforfall oppstår
Kontekstforfall oppstår fordi en modells oppmerksomhet er begrenset, selv når kontekstvinduet har god plass igjen. I AI-modeller er oppmerksomhet det tekniske begrepet for hvordan en modell avgjør hvilke deler av inndataene den skal trekke på når den skriver hvert ord i et svar. Alle deler av konteksten konkurrerer om denne oppmerksomheten. Jo mer tekst det er, desto mindre oppmerksomhet får hver del.
Chroma publiserte for eksempel en studie av hvordan inndatalengde påvirker AI-modeller. Den testet 18 modeller fra Anthropic, OpenAI, Google og Alibaba. I én test gjemte forskerne en setning om skriveråd i en lang samling essays. Deretter spurte de modellen hva rådet var.
De kjørte testen mange ganger og la til mer essaytekst hver gang. Setningen og spørsmålet endret seg aldri. Bare mengden tekst rundt dem gjorde det.
Jo mer tekst modellene måtte lese, desto dårligere presterte de. Dette funnet gjaldt for alle testene i rapporten. Forskerne anslår at fallet i nøyaktighet ville vært enda større i reelt arbeid som krever mange steg, slik de fleste agentoppgaver gjør.
Hvordan kontekstforfall kan påvirke AI-agenter
Kontekstforfall viser seg vanligvis på én av fire måter:
Tap av oversikt over de opprinnelige instruksjonene
Chromas enkleste test ba modellene kopiere en lang rekke gjentatte ord nøyaktig, med ett avvikende ord satt inn et sted. Det var en triviell oppgave med en eksplisitt instruksjon. Likevel falt ytelsen for alle modellene etter hvert som teksten ble lengre. Noen modeller begynte å produsere ord som ikke fantes i inndataene i det hele tatt.
I en agentoppgave setter brukeren vanligvis bestemte begrensninger i starten av oppgaven, for eksempel et budsjett eller et påkrevd format. Agenten kan bruke dem mindre konsekvent etter hvert som konteksten vokser. Årsaken er den samlede lengden på konteksten, ikke hvor instruksjonen står.
Detaljer fra midten av oppgaven blir oversett
AI-modeller bruker informasjon mest pålitelig når den står helt i begynnelsen eller helt på slutten av inndataene, ifølge en studie fra Stanford fra 2023. I én test ga forskerne modellene et sett med 20 dokumenter og stilte et spørsmål som bare ett av dem besvarte. Når dette dokumentet kom først eller sist, fant modellene vanligvis svaret. Når det lå midt i settet, gikk de glipp av det langt oftere. Forskerne kaller dette en posisjonseffekt.
Det samme mønsteret gjelder for agenter. Informasjon som ble funnet tidligere i en oppgave, kan havne midt i en lang samtale, der noen modeller har vanskeligere for å bruke den. I leverandøreksempelet kan den endelige listen utelate en god leverandør som agenten sjekket underveis i oppgaven.
Forveksling av lignende informasjon
Etter hvert som konteksten vokser, kan agenter bli dårligere til å gjenkjenne hvilken informasjon som passer instruksjonene. Si for eksempel at brukeren ba agenten finne leverandører som sender varer «innen to uker». Nettstedet til en leverandør sier «ankommer innen 14 kalenderdager etter bestilling». I en kort oppgave ville en agent sannsynligvis oppdaget at dette betyr det samme. Begravd blant dusinvis av andre leverandørsider er det mer sannsynlig at den går glipp av samsvaret.
Agenten kan også begynne å ta med resultater som ikke er relevante. Si at agenten leter etter leverandører av kontorstoler. Nettstedet til én leverandør lover levering innen to uker, men bare for skrivebord. Stolene tar seks uker. Nettstedet bruker de samme ordene som instruksjonen, så agenten kan likevel legge leverandøren til på listen. Forskere kaller slik informasjon en distraktor. Den ser relevant ut, men er det ikke, og konkurrerer derfor med informasjonen som betyr noe.
Chromas studie fant at begge problemene ble verre etter hvert som mengden omkringliggende tekst økte.
Feil som er vanskelige å oppdage
Kontekstforfall utløser ingen feilmelding. Agenten fortsetter å arbeide og leverer resultater som ser ferdige ut. Det gjør feilene lette å overse.
I Chromas tester tok disse feilene to former. Noen ganger ga en modell et selvsikkert svar som var feil. I eksempelet med leverandørundersøkelsen kan agenten levere en ryddig, godt formatert leverandørliste som inneholder en leverandør der den har misforstått leveringsvilkårene.
Andre ganger sa en modell at den ikke fant informasjon som faktisk var der. Agenten kan for eksempel levere en rapport som sier at ingen leverandører oppfyller kravet om levering innen to uker, selv om flere gjør det.
Slik setter du opp agentoppgaver for å redusere kontekstforfall
Når du setter opp oppgaver riktig, minimerer du virkningen av kontekstforfall og holder agenten så nøyaktig som mulig gjennom hele oppgaven. Følgende beste praksis kan hjelpe.
Skriv oppgaven som et oppdrag
Et tydelig oppdrag holder konteksten mindre. Agenten vet når den er ferdig, så den slutter å samle inn materiale når den har nok. Konkrete krav gir den også noe håndfast å sjekke hver side mot. Det gjør det lettere for agenten å finne riktig informasjon.
Før du sender en oppgave, bør du kontrollere at den dekker tre ting:
- Oppgaven: hva agenten skal gjøre og produsere, for eksempel «finn leverandører og returner en kortliste».
- Kravene: fakta agenten ikke kan gjette seg til, for eksempel budsjettet, fristen, leveringsadressen og hvem resultatet er til.
- Resultatet: format, lengde og struktur, for eksempel «en tabell med navn, pris per stol og leveringstid».
Satt sammen kan forespørselen for leverandøroppgaven se slik ut:
«Finn 10 leverandører som kan levere 40 kontorstoler til kontoret vårt i Chicago innen to uker, for under 250 dollar per stol. Returner en tabell med leverandørnavn, pris per stol, leveringstid og en lenke til produktsiden. Listen er til kontorsjefen vår, som skal legge inn bestillingen.»
Hold hver oppgave fokusert
Én oppgave med ett tydelig mål holder konteksten liten. Lange oppgaver koster også mer. Hvert steg behandler alt som er samlet inn så langt, så en oppblåst kontekst bruker flere kreditter i hvert steg.
Har du et prosjekt med flere deler, kan du dele det opp:
- List opp de enkelte leveransene, for eksempel et leverandørsøk, en prissammenligning og en e-post til den valgte leverandøren.
- Kjør hver leveranse som en egen oppgave.
- Send bare det ferdige resultatet fra én oppgave videre til den neste. Last for eksempel opp leverandørtabellen som en fil for å starte sammenligningsoppgaven, i stedet for å fortsette i tråden som produserte den.
Sammenligningsoppgaven starter da med én tabell i stedet for alle sidene.
Pek agenten mot de riktige kildene
Hver side agenten leser, legger til i konteksten, inkludert menyene, annonsene og standardteksten rundt den nyttige delen. Når du gir agenten kildene direkte, reduseres denne støyen.
Last opp filer som oppgaven er avhengig av, for eksempel listen over godkjente leverandører, ved å legge dem ved forespørselen. Oppgi nettstedene som er verdt å søke i når agenten må søke på nettet, for eksempel to pålitelige leverandørkataloger.
Koble til verktøyene der informasjonen ligger. I Perplexity Computer kan du for eksempel åpne Koblinger i sidepanelet og aktivere appene oppgaven trenger, slik som Google Drive eller Slack. Nevn dem deretter i forespørselen: «Bruk stolspesifikasjonene i Google Drive-en vår.» Koble bare til relevante apper, siden hver kobling tar opp noe av agentens kontekst.
Hvis informasjonen ligger i en app som ikke står på listen over Koblinger, kan det likevel være mulig å koble den til. Mange apper tilbyr en MCP-kobling (Model Context Protocol), en standardisert måte for AI-verktøy å koble seg til annen programvare på. Computer kan bruke disse sammen med de innebygde koblingene. I en bedriftskonto kan det hende at en administrator må aktivere dem først.
Be om en avsluttende kontroll mot instruksjonene
Avslutt forespørselen med et gjennomgangssteg som nevner de viktigste begrensningene:
«Før du avslutter, kontroller hver leverandør mot disse kravene: levering innen to uker, under 250 dollar per stol. Merk alle som ikke oppfyller kravene, i stedet for å utelate dem.»
Begrensningene står fortsatt i starten av konteksten. Gjennomgangssteget gir agenten en grunn til å sammenligne det endelige resultatet med begrensningene, i stedet for å stole på at instruksjonene beholder innflytelsen sin gjennom hvert steg.
Samtidig blir feil lettere å oppdage når du ber agenten merke problemer i stedet for bare å fjerne resultatene (for eksempel at den avviser en leverandør som lover ankomst innen 14 kalenderdager, fordi leverandøren ikke bruker ordene «to uker»).
Gå gjennom arbeidet ved kontrollpunkter
For lengre oppgaver bør du bygge et kontrollpunkt inn i forespørselen:
«Start med å finne 20 aktuelle leverandører, og stopp deretter. Jeg bekrefter listen før du henter inn priser.»
Kontroller kortlisten mot de opprinnelige instruksjonene. Rett opp det som ikke stemmer i en oppfølging, og la deretter agenten fortsette. Feil som fanges opp på dette tidspunktet, blir ikke med videre i hvert steg som følger.
Start en ny oppgave når en oppgave sporer av
Hvis agenten gjentar den samme feilen etter rettelser, bør du starte en ny oppgave. Hver rettelse legger til mer tekst i en kontekst som allerede er lang. Opprett heller en ny oppgave. Gjenta instruksjonene, last opp eventuelle gode resultater fra det første forsøket, og begynn på nytt.
Noen agenter gjør en variant av dette automatisk, en prosess som kalles komprimering. Når en oppgave blir lang, erstatter agenten eldre materiale, for eksempel fullteksten av sider den leste tidlig, med et kort sammendrag av det den fant. Perplexitys Portable Computer komprimerer konteksten sin på denne måten, slik at modellen holder seg innenfor mengden den kan håndtere godt.
Det er også viktig å starte en ny oppgave hvis målet endres. En tråd som begynte som et leverandørsøk, bør ikke også bli en kontraktsgjennomgang.
Gjør gjentatte instruksjoner om til en Skill
Noen instruksjoner går igjen i alle oppgaver av en bestemt type, for eksempel et foretrukket tabellformat, en liste over leverandører som skal unngås, eller et standard gjennomgangssteg. I Computer kan disse lagres som en Skill, et gjenbrukbart sett med instruksjoner som agenten følger hver gang. En Skill bygger de andre beste praksisene inn i hver oppgave som bruker den.
Slik setter du opp en:
- Velg en oppgave som går igjen ofte, for eksempel leverandørundersøkelser.
- Skriv ned instruksjonene du gir hver gang: formatet, kontrollene og kildene som skal brukes eller unngås.
- Lagre dem som en Skill. Instruksjoner som allerede er skrevet i Markdown, kan importeres direkte.
- Nevn Skill-en i fremtidige forespørsler: «Bruk Skill-en for leverandørundersøkelser til å finne stolleverandører til kontoret i Denver.»
Hvordan Perplexity håndterer kontekst i agentarbeid
Perplexity Computer håndterer lange oppgaver på måter som holder konteksten til hver modell liten og relevant. Tre deler av utformingen begrenser hvor mye en modell må lese om gangen.
Fordeling av arbeidet på underagenter
Computer deler en forespørsel opp i oppgaver og deloppgaver og oppretter deretter underagenter som utfører dem. Hver underagent arbeider med én del av jobben i sin egen kontekst. I leverandøroppgaven kan én underagent undersøke priser mens en annen sjekker leveringsvilkår. Ingen av dem trenger å lese alt den andre har lest.
Arbeidet lagres i filer
Hver Computer-oppgave får sitt eget arbeidsområde med egne filer, egen nettleser og egne verktøy. Agenten kan lagre arbeidet sitt i en fil, for eksempel en løpende tabell over leverandørene den har sjekket. Deretter åpner den filen igjen bare når den trenger den.
Utvalg av relevante avsnitt fra søkeresultater
Nettsider er fulle av materiale modellen ikke trenger, for eksempel menyer, annonser, metadata og tekst om andre emner. Forespørselsbevisst kontekstkomprimering fjerner dette. Før en side når modellen, beholder Perplexity bare setningene som er relevante for forespørselen.
Utforsk tips, veiledninger og eksempeloppgaver for Perplexity Computer for å sette disse stegene ut i praksis.
Vanlige spørsmål
Er kontekstforfall det samme som hallusinasjon?
Nei, men de henger sammen. En hallusinasjon er ethvert svar som påstår noe som er usant eller udokumentert. Kontekstforfall er en av faktorene som gjør hallusinasjoner mer sannsynlige, sammen med andre feil som ignorerte instruksjoner og oversette detaljer.
Kan en bedre forespørsel løse kontekstforfall?
En tydelig forespørsel reduserer kontekstforfall ved å holde oppgaven fokusert. Den kan likevel ikke hindre konteksten i å vokse. I en lang nok oppgave samler agenten fortsatt inn mer enn den kan utnytte godt, og derfor er det like viktig å dele opp arbeidet og kontrollere det underveis som selve forespørselen.
Påvirker kontekstforfall også vanlige AI-chatter, ikke bare agenter?
Ja. I en chat er konteksten hele samtalen så langt, inkludert alle meldinger og eventuelle dokumenter som er limt inn eller lastet opp i den. En tråd som har pågått i timevis på tvers av flere emner, kan gi de samme feilene som en lang agentoppgave. Hvis du starter en ny tråd for et nytt emne, holder du hver samtale fokusert.
Hvor lang kan en oppgave bli før kontekstforfall inntreffer?
Det finnes ikke noe fast punkt. Det avhenger av modellen og oppgaven. Modeller som kjører på enheten, med kontekstvinduer på 260 000 tokens, begynner for eksempel å slite når de passerer rundt 100 000 tokens, godt under grensen sin. Nedgangen er dessuten gradvis snarere enn brå.