
Slik sporer og kontrollerer du teamets tokenforbruk
Hvordan team kan se tokenbruken sin i dashbord og rapporter, hvilke typer KI-arbeid som bruker flest tokener, og hvordan de kan bruke kontroller til å redusere den.
Hva er tokenforbruk
Tokenforbruk er antallet tokener et team bruker med KI, og hva disse tokenene koster. Et token er en tekstenhet, for eksempel et ord, en del av et ord eller et skilletegn, som en KI-modell leser eller skriver. På engelsk tilsvarer 1 token omtrent 4 tegn. Tokener er ikke standardisert på tvers av modeller eller leverandører, så den samme teksten kan gi ulikt antall i ulike verktøy.
Bruksrapporter deler vanligvis tokener inn i noen få typer:
- Inndatatokener er alt modellen leser for en forespørsel. Det omfatter spørringen, eventuell vedlagt tekst og samtalehistorikk som modellen gjenbruker fra tidligere i samme tråd.
- Utdatatokener er svaret modellen skriver. De koster ofte mer enn inndatatokener. I Perplexitys API-priser koster utdata seks ganger så mye for enkelte modeller.
- Resonneringstokener er tekst en modell genererer internt for å jobbe seg gjennom et problem før den svarer. De vises ikke i svaret, så et lengre synlig svar betyr ikke nødvendigvis at en modell har brukt flere tokener totalt.
Team som bruker KI-verktøy via et abonnement, ser sjelden en kostnad per token. Tokener påvirker likevel hva de får, siden tyngre oppgaver bruker opp kreditter eller når bruksgrensene raskere. Team som bygger egne verktøy på en KI-modell, betaler vanligvis per token i stedet, med bruksbasert prising.
Slik sporer du tokenforbruk
Spore tokenforbruk i et abonnement
Abonnementsverktøy viser vanligvis ikke antall tokener. I stedet bruker mange abonnementer kreditter, forhåndsbetalte enheter som trekkes fra etter hvert som arbeidet utføres. Kreditter er ikke det samme som tokener, siden én kreditt kan dekke tekst, bilder eller annet arbeid. Men oppgaver som bruker flere tokener, bruker som regel også flere kreditter, så de er den beste pekepinnen på tokenforbruket i et abonnement. Brukere kan spore sitt eget kredittforbruk, og noen abonnementer har også et administratordashbord som viser kredittforbruket for hele teamet.
I Perplexity bruker for eksempel vanlige søk ikke kreditter. Det er bare Perplexity Computer, assistenten som håndterer oppgaver i flere trinn, som bruker dem. De som bruker Computer, kan se hvor mange kreditter de har brukt og hva de har brukt dem på. Hver Computer-oppgave viser også sitt eget kredittforbruk i «Bruk»-menyen i samtalen.
I Enterprise-abonnementer kan administratorer se hvor mange som bruker Perplexity og hvor mange spørringer de kjører hver uke, i Insights-dashbordet (tilgjengelig for organisasjoner med 50 eller flere lisenser, eller minst ett Enterprise Max-medlem).
Spore tokenforbruk i API-bruksrapporter
Bruksrapportene fra API-leverandøren viser antall tokener direkte, vanligvis fordelt på type token. I konsollen for Perplexitys API-plattform kan brukere for eksempel følge med på målinger som forbruk av inndata-, utdata- og resonneringstokener på faktureringssiden.
Hvorfor tokenforbruket øker
Agenter kjører mange trinn per oppgave, og hvert trinn er en separat forespørsel til en modell. Én oppgave kan fort komme opp i flere hundre tusen eller til og med millioner av tokener.
Resonneringsmodeller blir også stadig vanligere. En resonneringsmodell skriver ut tankegangen sin før den svarer, og hvert ord av dette telles som tokener. Den samme forespørselen bruker derfor vanligvis flere tokener på en resonneringsmodell enn på en standardmodell, selv om svaret på skjermen ser like langt ut.
Og etter hvert som flere personer og arbeidsflyter tar i bruk KI, øker tokenbruken samlet sett. Noe av veksten skyldes også «tokenmaxxing», der utviklere kjører agenter hovedsakelig for å øke sitt personlige tokenantall og klatre på interne topplister for tokenbruk.
Slik reduserer du tokenforbruket
Det meste av høyt tokenforbruk kommer fra noen få typer arbeid som bruker flere tokener enn det ser ut til.
Lange samtaler og agentoppgaver
Hver gang en modell svarer, leser den vanligvis hele samtalen så langt på nytt. Hver nye forespørsel inkluderer all tidligere samtalehistorikk pluss den nåværende meldingen fra brukeren. Et kort spørsmål sent i en lang tråd bruker derfor flere tokener enn det samme spørsmålet i en ny tråd. Agentoppgaver fungerer på samme måte, fordi hvert trinn legger resultatene sine til historikken som neste trinn leser på nytt.
Hva du kan gjøre
- Start en ny samtale når temaet endres. Innled den med et sammendrag på to eller tre linjer av det modellen fortsatt trenger fra den gamle tråden.
- Del opp lange agentoppgaver i mindre oppgaver. Kjør hver del som en egen oppgave, og send bare videre de resultatene neste del trenger.
- Sjekk om teamets agentverktøy bruker kontekstkomprimering. Komprimering oppsummerer eldre deler av en oppgave automatisk, slik at modellen leser mindre på nytt. Hvis et verktøy tilbyr dette som en innstilling, bør du slå den på.
De samme dokumentene behandlet om og om igjen
Når noen legger ved den samme lange filen, for eksempel en retningslinjehåndbok eller en produktkatalog, i mange separate spørringer, leser modellen hele filen hver gang. Hver lesing telles som inndatatokener.
Hva du kan gjøre
- Lær opp brukerne til å kopiere den relevante delen av en håndbok eller katalog inn i forespørselen i stedet for å legge ved hele filen.
- Lag en kortversjon av dokumenter teamet bruker ofte. Et sammendrag på én side av lange retningslinjer kan erstatte hele dokumentet i rutinemessige spørringer.
Nye forsøk og løkker
Når et svar ikke er det noen trengte, og de kjører oppgaven på nytt, bruker hvert forsøk tokener. Det samme skjer når en agent blir sittende fast og gjentar det samme trinnet.
Hva du kan gjøre
- Angi oppgaven, resultatet og kildene tydelig i den første forespørselen. For eksempel: «Oppsummer hovedgrunnene til at kunder sa opp i 3. kvartal, kun basert på de vedlagte undersøkelsesresultatene, i fem kulepunkter.»
- Sjekk de første trinnene i en agentoppgave. Hvis agenten gjentar det samme trinnet eller søket, stopper du den og starter på nytt med en smalere forespørsel.
Store modeller på enkle oppgaver
Mer avanserte modeller koster vanligvis mer per token, så rutinearbeid som sammendrag eller omformatering kan bruke opp teamets budsjett raskere enn nødvendig.
Hva du kan gjøre
- Bruk modellruting, som tilordner hver oppgave til en modell som kan håndtere den. En kort omskriving eller et sammendrag kan gå til en mindre og billigere modell, mens den mest avanserte modellen holdes av til resonnering eller analyse i flere trinn. Perplexitys API bruker denne tilnærmingen med forhåndsinnstillingene sine, som tildeler en mindre modell til et raskt oppslag og en større modell til grundig analyse.
Brukstopper etter nye arbeidsflyter
En ny automatisert arbeidsflyt, eller et verktøy som rulles ut til et helt team, kan øke bruken over natten. En topp er ikke et problem i seg selv, men det er verdt å vite hvilket arbeid som forårsaket den.
Hva du kan gjøre
- Test nye arbeidsflyter med en liten gruppe først. Sjekk bruken deres i en uke eller to før du ruller ut arbeidsflyten til hele teamet.
- Sett et månedlig budsjett for hvert team. Baser det på bruken i en typisk måned, slik at et hopp skiller seg ut.
- Slå av automatisk påfylling. Når automatisk påfylling er av, stopper arbeidet når kredittene er brukt opp, i stedet for at flere kreditter kjøpes automatisk.
Slik optimaliserer du tokenforbruket i Perplexity
Til daglig bruk
Computer bruker kreditter, men kjører bare når du velger det, enten ved å velge Computer-ikonet, jobbe i et prosjekt som bruker Computer som standard, eller bruke Work-modus i Comet.
For å gå tilbake til vanlig søk velger du Perplexity-ikonet for å bytte tilbake til Spør-modus. For å se kredittforbruket kan brukere åpne kredittoversikten i Perplexity-grensesnittet.
Team som jobber i prosjekter, Perplexitys delte arbeidsområder, kan sette standardmodusen for hvert prosjekt til Søk eller Computer. Et prosjekt som hovedsakelig brukes til raske undersøkelser, kan ha Søk som standard, slik at ingen starter en Computer-oppgave ved et uhell.
For Enterprise-administratorer
- Vit hva hver lisens inkluderer. Enterprise Pro-brukere får en månedlig tildeling på 500 kreditter, og Enterprise Max-brukere får 15 000 kreditter. Disse utløper ved slutten av hver månedlige periode og overføres ikke.
- Angi en standard bruksgrense først. En bruksgrense begrenser hvor mange ekstra kreditter et medlem kan hente fra den delte potten når medlemmets egen tildeling er brukt opp.
- Opprett navngitte grenser for ulike typer brukere. Administratorer kan sette opp grenser som «Standard», «Superbruker» og «Konsulent» og tilordne dem til brukergrupper eller enkeltmedlemmer. Grupper kan opprettes i Perplexity eller synkroniseres fra bedriftens identitetsleverandør. Hvis noen tilhører mer enn én gruppe, gjelder den høyeste grensen.
- Bruk personlige overstyringer for unntak. Når én person trenger en annen grense enn gruppen sin, har en personlig overstyring forrang fremfor alle gruppegrenser og delte grenser. Det er nyttig for et kort prosjekt med omfattende undersøkelser, uten å heve grensen for et helt team.
- Sett et tak på automatisk påfylling. Automatisk påfylling fyller på den delte potten automatisk. Den har en konfigurerbar månedlig påfyllingsgrense, slik at forbruket ikke kan vokse uten et fastsatt maksimum.
- Bestem hvordan medlemmer ber om mer. Innstillingen «Tillat medlemmer å be om flere kreditter» lar personer som når grensen sin, be en administrator om flere i stedet for å bli stoppet helt.
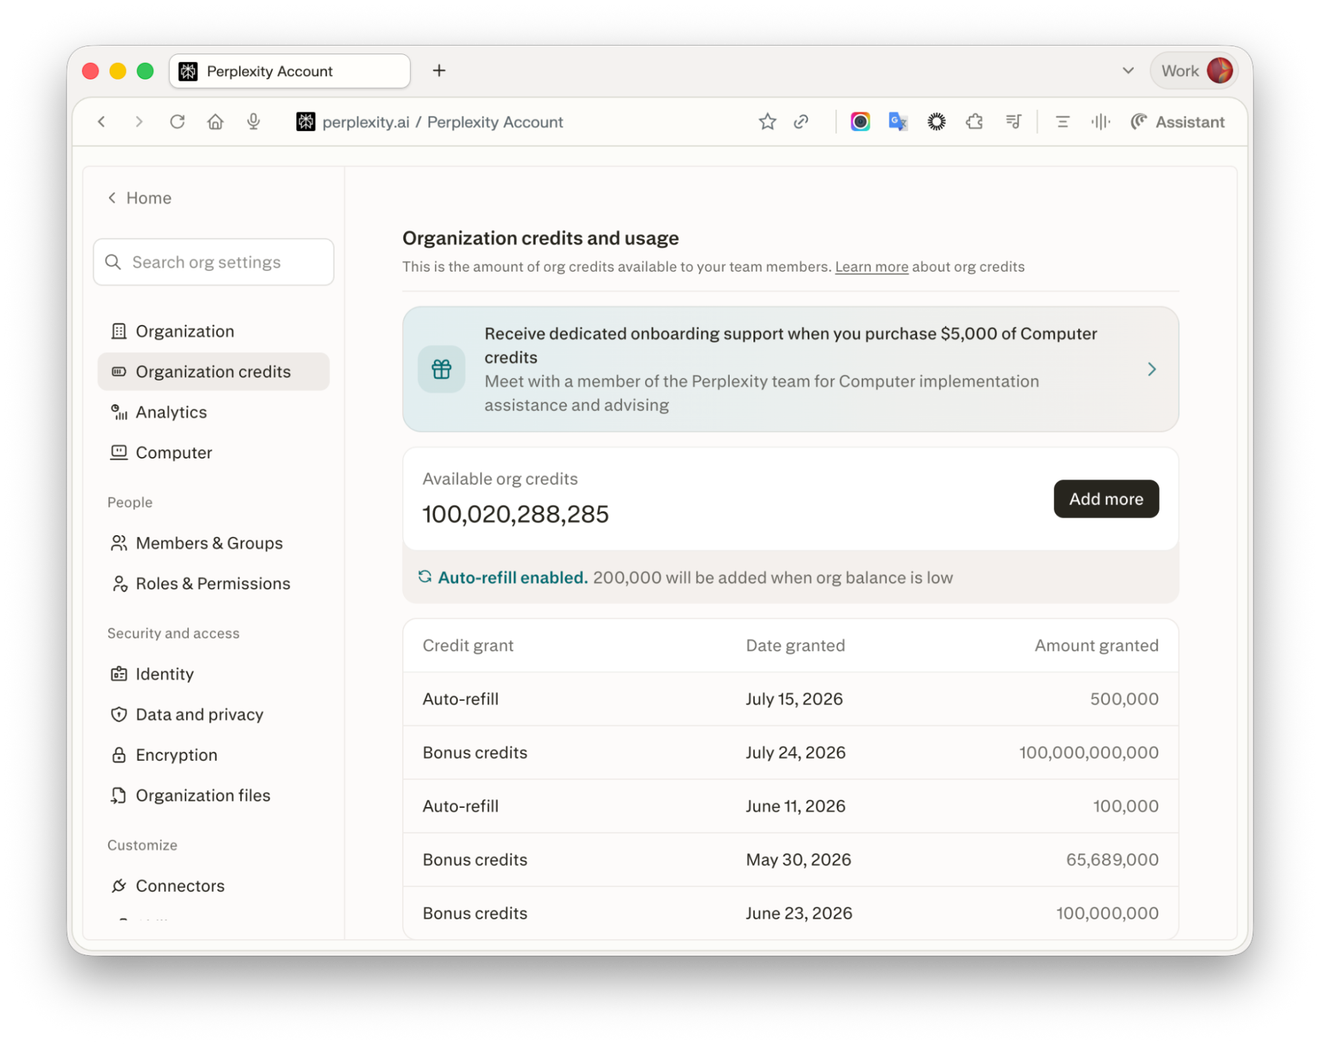
- Gå gjennom bruken hver måned. Siden Organisasjonskreditter viser tildelte, brukte og gjenværende kreditter for hvert medlem, sammen med gruppegrenser og saldoen i potten. For organisasjoner med 50 eller flere lisenser, eller minst ett Enterprise Max-medlem, viser Insights-dashbordet i tillegg månedlig aktive brukere og ukentlige spørringer over tid. For flere detaljer registrerer revisjonslogger oppgavekjøring, bruk av koblinger, kredittforbruk og tildeling av kreditter.
For team som bygger på API-et
- Gi hvert verktøy eller team sin egen API-nøkkel. Perplexity kan vise fakturering for hver nøkkel separat, og separate nøkler gjør det tydelig hvilket verktøy som driver bruken.
- Sjekk på faktureringssiden hvilken type token som øker. Den viser inndata-, utdata- og resonneringstokener over tid. Økende inndatatokener betyr vanligvis at et verktøy sender mer tekst enn det trenger. Økende resonneringstokener betyr at oppgaver kjører på modeller som tenker grundig gjennom problemer.
- Bruk Search API når et verktøy bare trenger søkeresultater. Det returnerer nettresultater uten at en modell skriver et svar, og det faktureres per forespørsel uten ekstra tokenbaserte kostnader.
- Start agentverktøy fra en forhåndsinnstilling. Perplexitys forhåndsinnstillinger tilpasser modellens størrelse til oppgavens størrelse og holder enkle forespørsler unna de dyreste modellene
Lokalt først
Noe arbeid trenger ikke en betalt skymodell i det hele tatt. Portable Computer er en versjon av Perplexitys agent som kjører på brukerens egen datamaskin, med en KI-modell som er lagret på den maskinen. Fordi modellen kjører lokalt, bruker ikke rutinearbeid betalte tokener. Den går bare ut på nettet, til tilkoblede apper eller til en kraftigere skymodell når en oppgave krever det, og spør brukeren først.
Utforsk hvordan Perplexity Computer håndterer arbeid i flere trinn på tvers av nettet, filer og tilkoblede verktøy.
Vanlige spørsmål
Hva er forskjellen mellom tokenforbruk og KI-kostnader?
Tokenforbruk måler hvor mye KI-arbeid et team gjør, målt i tokener. KI-kostnader omfatter alt et team betaler for å bruke KI, inkludert abonnementer, ekstra kreditter og oppsett. Tokenforbruket styrer den bruksbaserte delen av regningen.
Betaler abonnementsbrukere per token?
Vanligvis ikke direkte. Abonnementsverktøy måler bruk i meldinger, spørringer eller kreditter, og oppgaver som bruker flere tokener, bruker disse opp raskere. I Perplexity bruker vanlige søk ingen kreditter i det hele tatt; det er bare Computer-oppgaver som gjør det.
Hvorfor bruker KI-agenter så mange tokener?
En agent fullfører en oppgave i mange trinn, og hvert trinn er en separat forespørsel som leser arbeidet så langt på nytt. En lang oppgave bruker derfor flere tokener for hvert trinn den tar.
Hvorfor øker tokenbruken plutselig?
De fleste topper følger en endring i hvordan et team jobber, for eksempel en ny automatisert arbeidsflyt, et verktøy som rulles ut til flere personer, eller en lang agentoppgave. Ved å sammenligne datoen for toppen med nylige lanseringer finner du vanligvis årsaken. Å teste nye arbeidsflyter med en liten gruppe først bidrar til å forhindre topper.