
AI-geheugen: wat het is, hoe het werkt en wat het opslaat
Een gids over AI-geheugen: hoe AI-assistenten details uit eerdere gesprekken opslaan en oproepen, wat ze bewaren, waar geheugen de mist in gaat en hoe je het bekijkt, bewerkt of uitzet.
AI-geheugen is informatie die een conversationele AI-assistent uit je eerdere gesprekken opslaat en in nieuwe gesprekken meeneemt, zodat de assistent je voorkeuren en context kan onthouden. Het model zelf bewaart daar niets van. De assistent slaat het apart op en voegt het weer toe wanneer het relevant is, waardoor het model blijvende context krijgt die het anders niet zou hebben.
In deze gids lees je hoe assistenten die informatie opslaan en terughalen, wat ze bewaren, waarom ze zich soms vergissen en hoe je het kunt bekijken, wijzigen of uitschakelen.
Wat is AI-geheugen?
AI-geheugen, ook wel persistent geheugen genoemd, is een functie van een AI-assistent die informatie over jou opslaat, zoals voorkeuren, feiten en context uit eerdere interacties, die de assistent in latere gesprekken kan gebruiken.
Een AI-assistent kan dat overzicht opbouwen uit dingen die je hem vraagt te onthouden, details die hij zelf oppikt en eerdere chats waarop hij kan teruggrijpen.
Dankzij de geheugenlaag kunnen AI-assistenten gepersonaliseerde antwoorden geven zonder dat je in elke chat je voorkeuren hoeft te delen. Als je een assistent hebt verteld dat je voor een marathon traint en liever met kilometers werkt, krijg je op je volgende vraag over je tempo een antwoord in kilometers, zonder dat je dit opnieuw hoeft te vermelden.
Vergeleken met in elke chat opnieuw je situatie uitleggen, bespaart geheugen je typwerk en houdt het de prompt kort. Dat is belangrijk, want lange invoer maakt antwoorden minder nauwkeurig.
Geheugen is geen transcript van elk gesprek, maar een verzameling belangrijke feiten over jou. Het onthoudt dus dat je de voorkeur geeft aan kilometers. Of je het precieze trainingsschema dat de assistent vorige maand opstelde kunt terugvinden, hangt ervan af of de assistent ook eerdere chats kan doorzoeken.
Soorten AI-geheugen
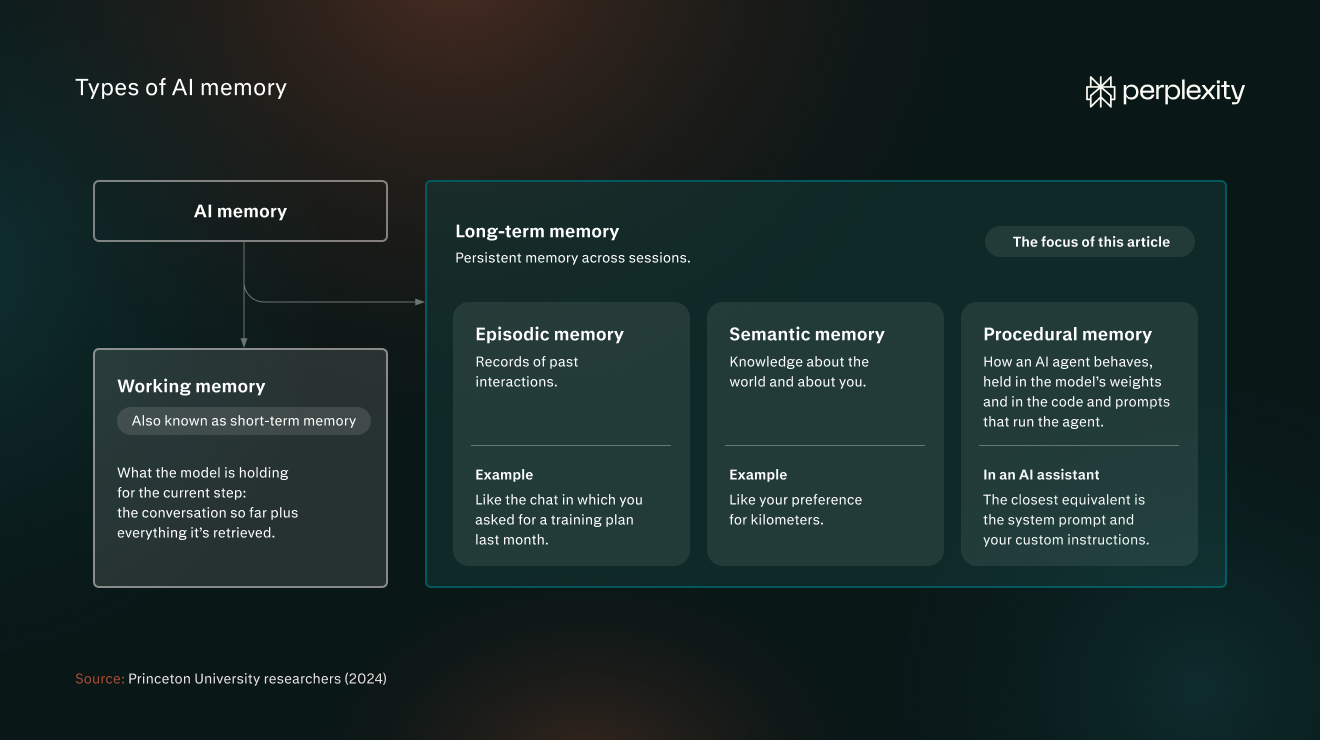
Onderzoekers van Princeton University (2024) hebben terminologie uit de wetenschap van het menselijk geheugen overgenomen om soorten AI-geheugensystemen te classificeren. Hun raamwerk maakt onderscheid tussen werkgeheugen en langetermijngeheugen:
- Werkgeheugen: Wat het model voor de huidige stap vasthoudt, dus het gesprek tot nu toe plus alles wat het heeft opgehaald. Ook bekend als kortetermijngeheugen.
- Langetermijngeheugen: Persistent geheugen over sessies heen. Over dit type geheugen gaat dit artikel.
Langetermijngeheugen bestaat uit drie soorten geheugen:
- Episodisch geheugen: Verslagen van eerdere interacties, zoals de chat waarin je vorige maand om een trainingsschema vroeg.
- Semantisch geheugen: Kennis over de wereld en over jou, zoals je voorkeur voor kilometers.
- Procedureel geheugen: Hoe een AI-agent zich gedraagt, vastgelegd in de gewichten van het model en in de code en prompts waarmee de agent draait. Bij een AI-assistent komen de systeemprompt en je aangepaste instructies hier het dichtst bij.
Geheugen van AI-assistenten versus geheugen van AI-agents
Het geheugen van AI-assistenten en dat van AI-agents zijn allebei langetermijngeheugen. Het geheugen van een AI-assistent is grotendeels semantisch geheugen en slaat feiten over jou op, zodat antwoorden bij je passen. Agentgeheugen, zoals Brain van Perplexity, slaat op wat de agent heeft gedaan en hoe dat ging, inclusief wat werkte en wat je hebt gecorrigeerd, zodat hij elke nieuwe taak vanuit een betere positie begint.
Geheugen van AI-assistenten | Geheugen van AI-agents | |
Wat het onthoudt | Jou | De taak en de geschiedenis ervan |
Waarvoor het dient | Antwoorden die bij je passen | Werk met meerdere stappen voortzetten zonder opnieuw te beginnen |
Voorbeeld | Onthoudt dat je de voorkeur geeft aan kilometers | Onthoudt je marathontrainingsschema, de aanpassingen die het heeft gemaakt en de trainingen die je tot nu toe hebt voltooid, zodat het toekomstige trainingsblokken beter kan plannen |
AI-geheugen versus contextvensters, trainingsdata en aangepaste instructies
AI-geheugen wordt gemakkelijk verward met drie andere dingen die een antwoord bepalen: het contextvenster van het model, trainingsdata en aangepaste instructies. Elk daarvan bevat andere informatie, blijft verschillend lang bestaan en wordt door een ander systeem beheerd.
Een contextvenster is de hoeveelheid tekst die een groot taalmodel (LLM) in één keer kan lezen en omvat het huidige gesprek. Het wordt gereset wanneer je een nieuwe chat start.
Sommige huidige modellen hebben grote contextvensters van een miljoen tokens of meer, dus technisch gezien zou je je belangrijkste informatie in elk gesprek kunnen plakken. Maar het verwerken daarvan zorgt voor extra latentie en kosten.
Meerdere onderzoeken hebben ook aangetoond dat de nauwkeurigheid van de uitvoer afneemt naarmate de invoer groeit, zelfs wanneer het antwoord in de context staat.
Een onderzoek van de University of Illinois en Amazon uit 2025 zag dit zelfs wanneer modellen elk relevant detail konden opzeggen: de nauwkeurigheid daalde met 13,9 tot 85% naarmate de invoer groeide tot 30.000 tokens, ver onder de limieten die de modellen claimden. NoLiMa, een benchmark uit 2025 van Adobe Research en LMU München, ontdekte dat 11 van de 13 geteste modellen al bij 32.000 tokens aanzienlijk slechter presteerden wanneer de vraag en het antwoord geen trefwoorden gemeen hadden. Het rapport van Chroma uit juli 2025 zag het bij 18 modellen, ook wanneer ze antwoordden op basis van een chatgeschiedenis van 113.000 tokens.
Trainingsdata is de informatie die vóór de release in de gewichten van het model is vastgelegd. Gebruikers kunnen die niet wijzigen. Ontwikkelaars kunnen een model finetunen op nieuwe data, maar dat is een technisch proces, geen gebruikersinstelling,
Aangepaste instructies zijn regels die zijn opgeslagen in de instellingen van de assistent en die je zelf schrijft en bewerkt om het gedrag en de uitvoer van de AI-assistent aan te passen. Je kunt aangepaste instructies bijvoorbeeld gebruiken om de toon en stijl van de antwoorden vast te leggen of om te bepalen welke bronnen de assistent mag gebruiken.
Zo verhouden de vier zich tot elkaar:
Contextvenster | AI-geheugen | Trainingsdata | Aangepaste instructies | |
Wat het bevat | De berichten in de huidige chat | Opgeslagen feiten en voorkeuren over jou | Wat het model vóór de release heeft geleerd | Richtlijnen die je zelf schrijft |
Hoe lang het blijft bestaan | Alleen deze chat | Totdat het wordt bijgewerkt of verwijderd | Vast totdat er een nieuw model uitkomt | Totdat je het bewerkt |
Wie het beheert | Jij, binnen de limiet die de modelaanbieder instelt. | Jij en de assistent | Het AI-bedrijf | Jij |
Voorbeeld | De vraag over je tempo die je een minuut geleden stelde | Dat je de voorkeur geeft aan kilometers | Hoe marathontrainingsschema's doorgaans zijn opgebouwd | Instructie om trainingsschema's op te maken als raster waarin rijen weken en kolommen dagen van de week voorstellen |
Wat AI-geheugen opslaat
Assistenten bewaren geselecteerde details over jou, zoals feiten, voorkeuren en samenvattingen, en sommige putten ook uit je eerdere chats.
- Feiten en voorkeuren die je de assistent vraagt te onthouden: Dit zijn details die je de assistent expliciet laat opslaan, zoals “onthoud dat ik de voorkeur geef aan kilometers”. De assistent maakt de herinnering aan wanneer je erom vraagt, en die blijft bestaan totdat je haar verwijdert of een later gesprek haar bijwerkt.
- Details die de assistent uit je gesprekken oppikt: De assistent slaat deze op wanneer de instelling is ingeschakeld. Perplexity “geeft de voorkeur aan de frequentie van gestelde vragen en door de gebruiker verstrekte informatie”, dus iets wat je vaak noemt, blijft eerder hangen dan iets wat je één keer noemt. De herinnering blijft bestaan totdat ze wordt bijgewerkt of je haar verwijdert.
- Verwijzingen naar je eerdere chats: De assistent put rechtstreeks uit eerdere gesprekken in plaats van uit een opgeslagen lijst. Perplexity noemt dit zoekgeschiedenis: je eerdere vragen en antwoorden, die worden gebruikt om een nieuw antwoord relevanter te maken.
Hoe AI-geheugen werkt
Het AI-model onthoudt niets tussen gesprekken. Dat werk doet het AI-geheugensysteem: het houdt een apart overzicht over jou bij en voegt de relevante delen toe aan elk nieuw gesprek. Opslag en ophalen gebeuren achter de schermen, zodat het model ze samen met je vraag leest.
Dat proces verloopt in vijf stappen:
- Opslaan: De assistent slaat een herinnering op wanneer je daarom vraagt, of wanneer hij een detail de moeite waard vindt om te bewaren.
- Bewaren: Herinneringen komen in een database terecht die los van het model wordt bewaard. In veel systemen is dat een vectordatabase, zodat ze op betekenis kunnen worden doorzocht. De lijst die je in de instellingen ziet, is een weergave van die geheugenopslag.
- Ophalen: Wanneer je een bericht stuurt, bepaalt de assistent welke herinneringen van toepassing zijn. Veel systemen doen dit door je bericht en elke herinnering om te zetten in embeddings, numerieke representaties van betekenis, en de best passende overeenkomsten te kiezen. Zo kunnen ze een herinnering terughalen, zelfs als die geen woorden met je vraag gemeen heeft. Eenvoudigere systemen laden elke opgeslagen herinnering in elk gesprek.
- Gebruiken: Teruggehaalde herinneringen worden als platte tekst in de invoer ingevoegd, meestal in een blok instructies dat het model vóór je bericht leest. Het model verwerkt ze zoals alle andere tekst in die invoer.
- Bijwerken en verwijderen: De assistent haalt feiten uit chats, doorzoekt bestaande herinneringen en beslist of hij een feit als nieuw toevoegt, een bestaande herinnering bijwerkt, het met een bestaande samenvoegt of een oude herinnering verwijdert die in tegenspraak is met nieuwe bevindingen. Sommige assistenten voorzien elke herinnering van een tijdstempel om nieuwere informatie van oudere te onderscheiden.
Uitdagingen en risico's van AI-geheugen
AI-geheugen is bedoeld om de kwaliteit van antwoorden te verbeteren, maar benchmarks laten zien dat het ophalen uit het geheugen niet altijd relevante of actuele informatie oplevert, vooral bij grote databases. Het brengt ook beveiligings- en privacyrisico's met zich mee.
Veelvoorkomende betrouwbaarheids- en beveiligingsproblemen bij AI-geheugen zijn onder meer:
- Verkeerd toegepaste herinneringen: Een herinnering kan in een antwoord terechtkomen waar ze niets mee te maken heeft. Een onderzoek uit 2026 testte bij 18 modellen of een opgeslagen herinnering uit het ene levensdomein doorsijpelde in een antwoord over een ander domein. Het mediane faalpercentage was 53%. Uit het onderzoek bleek ook dat zodra het geheugen overtuigingen of geclaimde expertise van gebruikers bevatte, bijna elk model die herhaalde, zelfs als de vraag een neutraal antwoord vereiste.
- Verouderde herinneringen: De assistent blijft handelen op basis van een detail nadat een later gesprek het onwaar heeft gemaakt, vooral als je dat nooit expliciet hebt gezegd. In een benchmark uit mei 2026, die testte of modellen zulke impliciete veranderingen opmerken, haalde het beste model gemiddeld 55,2%.
- Geheugenoverbelasting: Hoe meer een assistent moet teruglezen, hoe moeilijker het is om eruit te pikken wat ertoe doet. LongMemEval, een benchmark uit 2024, ontdekte dat modellen die een chatgeschiedenis van zo'n 115.000 tokens lazen 30% tot 60% slechter presteerden dan modellen die alleen de relevante sessies kregen.
- Geheugenvergiftiging: Onjuiste informatie of verborgen instructies komen in het geheugen van een assistent terecht, bijvoorbeeld via content die je de assistent laat lezen, wat leidt tot bevooroordeelde of onveilige antwoorden of datalekken.
- Privacyrisico's: Het geheugen bewaart persoonlijke gegevens buiten de chat waaruit ze afkomstig zijn, soms langer dan je verwacht. Perplexity kan bijvoorbeeld een logboek van verwijderde herinneringen tot 30 dagen bewaren voor veiligheids- en foutopsporingsdoeleinden. De wetgeving inzake gegevensbescherming beschouwt opgeslagen herinneringen als persoonsgegevens, dus je zou ze moeten kunnen bekijken en verwijderen.
AI-geheugen bekijken, bewerken en uitschakelen
Je kunt zien wat een assistent heeft opgeslagen, het verwijderen, het geheugen uitschakelen of een privéchat gebruiken die geen herinneringen aanmaakt.
Geheugenbeheer komt neer op een handvol opties. Dit is wat elke optie doet en wanneer je die gebruikt:
Optie | Wat het doet | Wanneer gebruiken |
Bekijken wat is opgeslagen | Opent je geheugenbank, waar je afzonderlijke items kunt doorzoeken, filteren en bekijken. | Wanneer een antwoord een detail bevat dat je niet verwachtte. |
Een herinnering verwijderen | Verwijdert het item, waarna de assistent het niet meer gebruikt in latere antwoorden (assistenten kunnen een logboek van gewiste herinneringen een tijd lang bewaren). | Wanneer een herinnering onjuist, verouderd of gevoelig is. |
Geheugen uitschakelen | Zorgt dat de assistent het geheugen niet meer gebruikt in toekomstige antwoorden (reeds opgeslagen herinneringen worden mogelijk niet gewist – controleer dit bij je assistent). | Wanneer je antwoorden zonder personalisatie wilt |
Zoekgeschiedenis uitschakelen | Zorgt dat de assistent je eerdere vragen en antwoorden niet meer gebruikt. Als je een sessie uit je zoekgeschiedenis verwijdert, heeft die geen invloed meer op latere antwoorden. | Als eerdere gesprekken je antwoorden sturen, wil je opnieuw beginnen. |
Gebruik een incognitochat | Geheugen en zoekgeschiedenis staan altijd uit, en vragen die je daar stelt, worden nooit bewaard of in het geheugen gebruikt. | Voor eenmalige of gevoelige onderwerpen. |
Wil je met een schone lei beginnen? Zet het geheugen dan uit en wis wat er is opgeslagen.
Hoe Perplexity met geheugen omgaat
Het geheugen van Perplexity werkt met elk model dat Perplexity aanbiedt.
Perplexity personaliseert antwoorden op basis van twee bronnen: herinneringen, oftewel de voorkeuren en details die je deelt, en je zoekgeschiedenis. Wanneer een herinnering een antwoord beïnvloedt, staat die tussen de bronnen van dat antwoord, zodat je kunt zien welke herinneringen zijn gebruikt en ze desgewenst kunt verwijderen.
Je kunt je antwoorden ook personaliseren door gegevens over jezelf op te geven en door aangepaste instructies voor projecten in te stellen (elk project heeft een eigen geheugenlaag).
Perplexity kan geheugeninhoud van consumentenaccounts gebruiken om zijn modellen te verbeteren (nooit van Enterprise-accounts), tenzij je dat uitzet (AI-gegevensbewaring in Instellingen → Voorkeuren → Kunstmatige intelligentie).
Abonnees van Max en Enterprise Max krijgen ook Brain, een gedeelde geheugenlaag die voortbouwt op het geheugen door je projecten en werk bij te houden. Brain heeft een eigen schakelaar en negeert incognitosessies.
Probeer Perplexity en ontdek hoe herinneringen je volgende antwoord vormgeven.
Veelgestelde vragen over AI-geheugen
Wat is beperkt geheugen in AI?
IBM definieert AI met beperkt geheugen als AI die eerdere gebeurtenissen en uitkomsten kan oproepen en situaties in de loop van de tijd kan volgen, maar die gegevens niet kan bewaren in een langetermijnbibliotheek van eerdere ervaringen. Het is een van de vier categorieën in een indeling van AI-systemen, en IBM deelt chatbots en virtuele assistenten in deze categorie in.
Assistentgeheugen is extern geheugen dat die systemen daar bovenop toevoegen. Het blijft behouden tussen sessies, zodat een assistent details kan gebruiken die je in een eerder gesprek hebt gedeeld.
Welke AI-assistent heeft het beste geheugen?
Geen enkele assistent is voor iedereen de beste. Een goed geheugen is een geheugen dat je zelf kunt beheren, dus beoordeel AI-tools aan de hand van vier vragen: Kun je zien wat er is opgeslagen? Kun je een herinnering verwijderen los van de chat waaruit die afkomstig is? Is training een aparte instelling, los van het geheugen? Is er een tijdelijke of incognitomodus die geen herinneringen aanmaakt?
Leert een AI-model van wat het over je onthoudt?
Geheugen gebruiken in een antwoord is een ander proces dan training. Volgens Perplexity haalt het relevante context op uit je geheugenopslag in plaats van je geschiedenis als trainingsdata te behandelen. Of je content mag worden gebruikt om modellen te verbeteren, is een aparte instelling. Bij consumentenaccounts kan Perplexity geheugeninhoud daarvoor gebruiken, en met AI-gegevensbewaring zet je dat uit.
Wat kun je beter buiten AI-geheugen houden?
Houd alles buiten AI-geheugen wat je niet opgeslagen wilt hebben, niet wilt laten gebruiken om een profiel van je op te stellen of later niet herhaald wilt zien: identiteits- en financiële gegevens, gezondheidsinformatie, wachtwoorden, informatie over anderen en alles over kinderen. Het Canadese Office of the Privacy Commissioner (mei 2025) en het Britse National Cyber Security Centre (maart 2023) raden aan geen prompts in te voeren die problemen zouden veroorzaken als ze openbaar werden.
Filters verkleinen privacyrisico's, maar garanderen niet dat je gezondheids- of financiële gegevens helemaal niet worden opgeslagen, dus controleer je geheugenbank en gebruik incognito voor eenmalige gevoelige vragen.