
Contextverval bij AI-agents: waarom lange taken aan nauwkeurigheid inboeten en hoe je dat voorkomt
Een gids over wat zich ophoopt in de context van een AI-agent, waarom dat de nauwkeurigheid schaadt en hoe je taken opzet die betrouwbaar blijven.
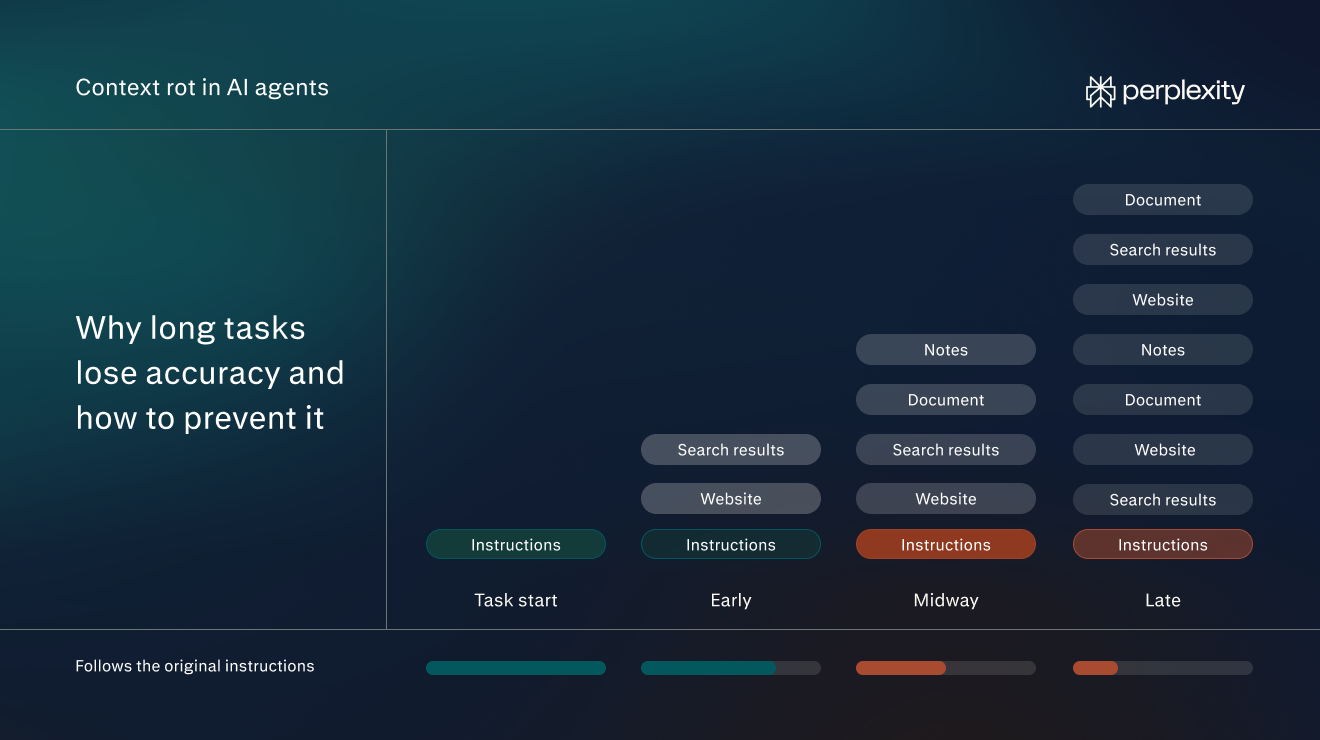
Wat contextverval betekent voor AI-agents
Contextverval bij AI-agents is het geleidelijke verlies van nauwkeurigheid dat optreedt naarmate de context van een agent zich tijdens een lange taak vult.
De context van een agent is de informatie die het model beschikbaar heeft voor zijn volgende stap. Die kan instructies, eerdere berichten, zoekresultaten en tekst uit websites of bestanden bevatten. Terwijl de agent werkt, kan hij er meer aan toevoegen.
Stel bijvoorbeeld dat een agent de taak heeft om leveranciers te vinden die binnen twee weken leveren. Aan het begin bevat de context alleen dat verzoek. Halverwege de taak bevat de context ook de tekst van tientallen websites van leveranciers, meerdere pagina's met zoekresultaten en aantekeningen over welke leveranciers de agent al heeft gecontroleerd.
Er is een grens aan hoeveel context een model kan bevatten (het zogeheten contextvenster). Dat venster wordt gemeten in tokens: kleine stukjes tekst, meestal een woord of een deel van een woord. Contextverval neemt toe naarmate de context groeit. Daarom treedt het vooral op bij lange taken met veel stappen.
Naarmate het contextverval erger wordt, wordt de agent minder nauwkeurig. Hij volgt zijn oorspronkelijke instructies misschien minder nauwgezet, ziet details over het hoofd of verwart informatie die erop lijkt met wat hij nodig heeft.
De agent kan bijvoorbeeld leveranciers gaan opnemen die zes weken nodig hebben, terwijl hem is opgedragen leveranciers te vinden die binnen twee weken leveren. De instructie staat nog steeds in zijn context, maar bepaalt de keuzes van de agent niet meer.
Contextverval is niet hetzelfde als simpelweg geen ruimte meer hebben in het contextvenster. Als de context van een taak groter wordt dan het venster, wordt materiaal afgekapt of mislukt de taak. Contextverval begint al ruim vóór dat punt, terwijl alles nog past.
Het is ook niet hetzelfde als contextvergiftiging (wanneer misleidende of schadelijke informatie in de context van de agent terechtkomt). Een agent met juiste, volledige informatie kan nog steeds last krijgen van contextverval.
Waarom contextverval optreedt
Contextverval ontstaat doordat de aandacht van een model beperkt is, zelfs als er nog ruimte over is in het contextvenster. Bij AI-modellen is aandacht de technische term voor de manier waarop een model bepaalt op welke delen van zijn invoer het zich baseert bij het schrijven van elk woord van een antwoord. Alle delen van de context concurreren om die aandacht. Hoe meer tekst er is, hoe minder aandacht elk deel krijgt.
Chroma publiceerde bijvoorbeeld een onderzoek naar hoe de lengte van de invoer AI-modellen beïnvloedt. Daarin werden 18 modellen van Anthropic, OpenAI, Google en Alibaba getest. In één test verstopten de onderzoekers een zin met schrijfadvies in een lange verzameling essays. Daarna vroegen ze het model wat het advies was.
Ze voerden de test vele keren uit en voegden elke keer meer essaytekst toe. De zin en de vraag bleven altijd hetzelfde. Alleen de hoeveelheid tekst eromheen veranderde.
Hoe meer tekst de modellen moesten lezen, hoe slechter ze presteerden. Die bevinding gold voor elke test in het rapport. De onderzoekers voorspellen dat de daling in nauwkeurigheid nog groter zou zijn bij echt werk dat veel stappen vergt, zoals de meeste agenttaken.
Hoe contextverval AI-agents kan beïnvloeden
Contextverval uit zich doorgaans op een van vier manieren:
De oorspronkelijke instructies uit het oog verliezen
In de eenvoudigste test van Chroma moesten modellen een lange reeks herhaalde woorden exact kopiëren, waarin ergens één afwijkend woord was ingevoegd. Het was een triviale taak met een expliciete instructie. Toch gingen alle modellen slechter presteren naarmate de tekst langer werd. Sommige modellen begonnen woorden te produceren die helemaal niet in de invoer stonden.
Bij een agenttaak stelt de gebruiker aan het begin doorgaans specifieke voorwaarden, zoals een budget of een vereist formaat. Naarmate de context groeit, past de agent die mogelijk minder consequent toe. De oorzaak is de totale lengte van de context, niet de plek waar de instructie staat.
Gemiste details uit het midden van een taak
Volgens een onderzoek van Stanford uit 2023 gebruiken AI-modellen informatie het betrouwbaarst wanneer die helemaal aan het begin of helemaal aan het einde van hun invoer staat. In één test gaven de onderzoekers modellen een set van 20 documenten en stelden ze een vraag waarop slechts één daarvan het antwoord gaf. Als dat document als eerste of als laatste kwam, vonden de modellen meestal het antwoord. Stond het in het midden van de set, dan misten ze het veel vaker. Onderzoekers noemen dit een positie-effect.
Hetzelfde patroon geldt voor agents. Informatie die eerder in een taak is gevonden, kan midden in een lang gesprek terechtkomen, waar sommige modellen meer moeite hebben om die te gebruiken. In het leveranciersvoorbeeld kan de uiteindelijke lijst een goede leverancier missen die de agent halverwege de taak heeft gecontroleerd.
Vergelijkbare informatie door elkaar halen
Naarmate de context groeit, kunnen agents slechter worden in het herkennen van welke informatie bij hun instructies past. Stel bijvoorbeeld dat de gebruiker de agent heeft gevraagd leveranciers te vinden die “binnen twee weken” verzenden. Op de website van een leverancier staat “wordt binnen 14 kalenderdagen na bestelling geleverd”. Bij een korte taak ziet een agent waarschijnlijk dat dit hetzelfde betekent. Bedolven onder tientallen andere leverancierspagina's is de kans groter dat hij de overeenkomst mist.
Het kan ook zijn dat de agent resultaten gaat opnemen die niet relevant zijn. Stel dat de agent leveranciers van bureaustoelen zoekt. De website van een leverancier belooft levering binnen twee weken, maar alleen voor bureaus. De stoelen hebben zes weken nodig. De website gebruikt dezelfde woorden als de instructie, dus de agent zet de leverancier misschien toch op zijn lijst. Onderzoekers noemen zulke informatie een afleider. Die lijkt relevant, maar is het niet, en concurreert zo met de informatie die ertoe doet.
Uit het onderzoek van Chroma bleek dat beide problemen erger werden naarmate de hoeveelheid omringende tekst toenam.
Fouten die moeilijk te ontdekken zijn
Contextverval leidt niet tot een foutmelding. De agent blijft werken en levert output op die af lijkt. Daardoor worden de fouten gemakkelijk over het hoofd gezien.
In de tests van Chroma namen deze fouten twee vormen aan. Soms gaf een model vol overtuiging een antwoord dat fout was. In het voorbeeld van het leveranciersonderzoek kan de agent een nette, goed opgemaakte leverancierslijst opleveren met daarin een leverancier waarvan hij de leveringsvoorwaarden verkeerd heeft gelezen.
Andere keren zei een model dat het informatie niet kon vinden die er wel degelijk was. De agent kan bijvoorbeeld een rapport opleveren waarin staat dat geen enkele leverancier aan de limiet van twee weken voldoet, terwijl meerdere dat wel doen.
Hoe je agenttaken opzet om contextverval te beperken
Door taken goed op te zetten, beperk je de impact van contextverval en blijft de agent gedurende de hele taak zo nauwkeurig mogelijk. De volgende best practices kunnen daarbij helpen.
Formuleer de taak als een opdracht
Een duidelijke opdracht houdt de context kleiner. De agent weet wanneer hij klaar is, dus stopt hij met het verzamelen van materiaal zodra hij genoeg heeft. Specifieke vereisten geven hem bovendien iets concreets om elke pagina aan te toetsen. Zo kan de agent de juiste informatie makkelijker herkennen.
Controleer voordat je een taak verstuurt of die drie dingen bevat:
- De taak: wat de agent moet doen en opleveren, zoals “zoek leveranciers en lever een shortlist op”.
- De vereisten: de feiten die de agent niet kan raden, zoals het budget, de deadline, het afleveradres en voor wie het resultaat bedoeld is.
- De output: het formaat, de lengte en de structuur, zoals “een tabel met naam, prijs per stoel en levertijd”.
Samengevoegd kan de query voor de leverancierstaak er zo uitzien:
“Zoek 10 leveranciers die binnen twee weken 40 bureaustoelen kunnen leveren aan ons kantoor in Chicago, voor minder dan $ 250 per stoel. Lever een tabel op met de naam van de leverancier, de prijs per stoel, de levertijd en een link naar de productpagina. De lijst is voor onze officemanager, die de bestelling plaatst.”
Houd elke taak gefocust
Eén taak met één duidelijk doel houdt de context klein. Lange taken kosten bovendien meer. Bij elke stap wordt alles verwerkt wat tot dan toe is verzameld, dus een opgeblazen context verbruikt bij elke stap meer credits.
Splits een project met meerdere onderdelen op:
- Maak een lijst van de afzonderlijke deliverables, bijvoorbeeld een zoektocht naar leveranciers, een prijsvergelijking en een e-mail aan de gekozen leverancier.
- Voer elke deliverable uit als een aparte taak.
- Geef alleen het eindresultaat van de ene taak door aan de volgende. Upload bijvoorbeeld de leverancierstabel als bestand om de vergelijkingstaak te starten, in plaats van verder te gaan in de draad waarin die tabel is gemaakt.
De vergelijkingstaak begint dan met één tabel in plaats van met alle pagina's.
Wijs de agent op de juiste bronnen
Elke pagina die de agent leest, vergroot zijn context, inclusief de menu's, advertenties en standaardteksten rond het nuttige deel. Door de agent zijn bronnen rechtstreeks te geven, beperk je die ruis.
Upload de bestanden waarvan de taak afhankelijk is, zoals de lijst met goedgekeurde leveranciers, door ze aan de query toe te voegen. Noem de websites die het doorzoeken waard zijn wanneer de agent op het web moet zoeken, zoals twee betrouwbare leveranciersgidsen.
Koppel de tools waarin de informatie staat. Open bijvoorbeeld in Perplexity Computer Connectors in de zijbalk en schakel de apps in die de taak nodig heeft, zoals Google Drive of Slack. Noem ze daarna in de query: “Gebruik de stoelspecificaties in onze Google Drive.” Koppel alleen relevante apps, want elke connector neemt een deel van de context van de agent in beslag.
Als de informatie in een app staat die niet in de lijst met Connectors voorkomt, is het misschien toch mogelijk om die te koppelen. Veel apps bieden een MCP-connector (Model Context Protocol), een standaardmanier om AI-tools op andere software aan te sluiten. Computer kan deze naast zijn ingebouwde connectors gebruiken. Bij een bedrijfsaccount moet een beheerder ze mogelijk eerst inschakelen.
Vraag om een laatste controle aan de hand van de instructies
Sluit de query af met een controlestap waarin de belangrijkste voorwaarden worden genoemd:
“Controleer voordat je afrondt elke leverancier aan de hand van deze vereisten: levering binnen twee weken, minder dan $ 250 per stoel. Markeer leveranciers die niet aan die vereisten voldoen in plaats van ze weg te laten.”
De voorwaarden staan nog steeds aan het begin van de context. De controlestap geeft de agent een reden om zijn uiteindelijke output met de voorwaarden te vergelijken, in plaats van erop te vertrouwen dat de instructies bij elke stap hun invloed behouden.
Door de agent te vragen problemen te markeren in plaats van die resultaten gewoon weg te laten, zijn fouten bovendien makkelijker te ontdekken (zoals het afwijzen van een leverancier die levering binnen 14 kalenderdagen belooft, omdat die niet de woorden “twee weken” gebruikt).
Controleer het werk bij controlepunten
Bouw bij langere taken een controlepunt in de query in:
“Begin met het zoeken van 20 kandidaat-leveranciers en stop dan. Ik bevestig de lijst voordat je prijzen verzamelt.”
Controleer de shortlist aan de hand van de oorspronkelijke instructies. Corrigeer alles wat niet klopt in een vervolgbericht en laat de agent daarna verdergaan. Fouten die je op dit punt opmerkt, werken niet door in alle stappen die volgen.
Start een nieuwe taak als een taak ontspoort
Als de agent na correcties dezelfde fout blijft maken, start dan een nieuwe taak. Elke correctie voegt meer tekst toe aan een context die al lang is. Maak in plaats daarvan een nieuwe taak. Herhaal de instructies, upload eventuele goede output van de eerste poging en begin opnieuw.
Sommige agents doen automatisch een variant hiervan, een proces dat compactie heet. Wanneer een taak lang wordt, vervangt de agent ouder materiaal, zoals de volledige tekst van pagina's die hij al vroeg heeft gelezen, door een korte samenvatting van wat hij heeft gevonden. Portable Computer van Perplexity compacteert zijn context op deze manier, zodat het model binnen de hoeveelheid blijft die het goed aankan.
Het is ook belangrijk om een nieuwe taak te starten als het doel verandert. Een draad die begon als een zoektocht naar leveranciers, moet niet ook een contractbeoordeling worden.
Maak van herhaalde instructies een Skill
Sommige instructies komen terug bij elke taak van een bepaald type, zoals een voorkeursformaat voor tabellen, een lijst met leveranciers die je wilt vermijden of een standaardcontrolestap. In Computer kun je deze opslaan als Skill: een herbruikbare set instructies die de agent elke keer volgt. Een Skill verwerkt de andere best practices in elke taak die de Skill gebruikt.
Zo stel je er een in:
- Kies een taak die vaak terugkomt, zoals leveranciersonderzoek.
- Schrijf de instructies op die je elke keer geeft: het formaat, de controles en de bronnen die je wel of niet wilt gebruiken.
- Sla ze op als Skill. Instructies die al in Markdown zijn geschreven, kun je rechtstreeks importeren.
- Noem de Skill in toekomstige query's: “Gebruik de Skill voor leveranciersonderzoek om stoelleveranciers te vinden voor het kantoor in Denver.”
Hoe Perplexity omgaat met context bij agentwerk
Perplexity Computer handelt lange taken af op manieren die de context van elk model klein en relevant houden. Drie onderdelen van het ontwerp beperken hoeveel een model tegelijk moet lezen.
Werk verdelen over subagents
Computer splitst een verzoek op in taken en subtaken en maakt vervolgens subagents aan om die uit te voeren. Elke subagent werkt in een eigen context aan één deel van de klus. Bij de leverancierstaak kan de ene subagent prijzen onderzoeken terwijl een andere de leveringsvoorwaarden controleert. Geen van beide hoeft alles te lezen wat de andere heeft gelezen.
Werk in bestanden bewaren
Elke taak in Computer krijgt een eigen werkruimte, met eigen bestanden, een eigen webbrowser en eigen tools. De agent kan zijn werk opslaan in een bestand, zoals een doorlopende tabel van de leveranciers die hij heeft gecontroleerd. Dat bestand opent hij pas weer wanneer hij het nodig heeft.
Relevante passages uit zoekresultaten selecteren
Webpagina's staan vol met materiaal dat het model niet nodig heeft, zoals menu's, advertenties, metadata en tekst over andere onderwerpen. Querybewuste contextcompressie haalt dat eruit. Voordat een pagina het model bereikt, bewaart Perplexity alleen de zinnen die betrekking hebben op de query.
Bekijk tips, handleidingen en voorbeeldtaken voor Perplexity Computer om deze stappen in de praktijk te brengen.
Veelgestelde vragen
Is contextverval hetzelfde als hallucinatie?
Nee, maar ze hangen wel samen. Een hallucinatie is elk antwoord waarin iets onjuists of ongefundeerds wordt beweerd. Contextverval is een van de omstandigheden die hallucinaties waarschijnlijker maken, net als andere fouten, zoals genegeerde instructies en gemiste details.
Kan een betere query contextverval oplossen?
Een duidelijke query vermindert contextverval doordat de taak gefocust blijft. De query kan echter niet voorkomen dat de context groeit. Bij een taak die lang genoeg is, verzamelt de agent nog steeds meer dan hij goed kan gebruiken. Daarom zijn het opsplitsen van het werk en het tussentijds controleren ervan net zo belangrijk als de query zelf.
Heeft contextverval ook invloed op gewone AI-chats, en niet alleen op agents?
Ja. In een chat is de context het hele gesprek tot nu toe, inclusief elk bericht en alle documenten die erin zijn geplakt of geüpload. Een draad die al uren loopt en meerdere onderwerpen bestrijkt, kan dezelfde fouten opleveren als een lange agenttaak. Door voor een nieuw onderwerp een nieuwe draad te starten, blijft elk gesprek gefocust.
Hoe lang kan een taak worden voordat contextverval optreedt?
Er is geen vast punt. Het hangt af van het model en de taak. On-device-modellen met contextvensters van 260.000 tokens krijgen bijvoorbeeld al moeite boven ongeveer 100.000 tokens, ruim onder hun limiet. De achteruitgang verloopt bovendien geleidelijk en niet plotseling.