
Zo houd je het tokenverbruik van je team bij en onder controle
Hoe teams hun tokengebruik kunnen zien in dashboards en rapporten, welke soorten AI-werk de meeste tokens gebruiken en hoe ze dat met beheeropties kunnen verminderen.
Wat is tokenverbruik
Tokenverbruik is het aantal tokens dat een team met AI verbruikt, en wat die tokens kosten. Een token is een eenheid tekst, zoals een woord, een deel van een woord of een leesteken, die een AI-model leest of schrijft. In het Engels is 1 token ongeveer 4 tekens. Tokens zijn niet gestandaardiseerd tussen modellen of aanbieders, dus dezelfde tekst kan in verschillende tools een ander aantal tokens opleveren.
Gebruiksrapporten delen tokens meestal op in een paar soorten:
- Inputtokens zijn alles wat het model voor een verzoek leest. Dat omvat de vraag, eventuele bijgevoegde tekst en de gespreksgeschiedenis die het model hergebruikt uit eerdere berichten in dezelfde draad.
- Outputtokens zijn het antwoord dat het model schrijft. Ze kosten vaak meer dan inputtokens. Bij de API-prijzen van Perplexity rekenen sommige modellen zes keer zoveel voor output.
- Redeneertokens zijn tekst die een model intern genereert om een probleem te doorgronden voordat het antwoordt. Ze verschijnen niet in het antwoord, dus een langer zichtbaar antwoord betekent niet per se dat een model in totaal meer tokens heeft gebruikt.
Teams die AI-tools via een abonnement gebruiken, zien zelden kosten per token. Toch bepalen tokens wat ze krijgen, want zwaardere taken verbruiken sneller credits of bereiken eerder gebruikslimieten. Teams die hun eigen tools op een AI-model bouwen, betalen doorgaans juist per token, volgens gebruiksgebaseerde prijzen.
Zo houd je tokenverbruik bij
Tokenverbruik bijhouden bij een abonnement
Abonnementstools tonen meestal geen tokenaantallen. In plaats daarvan gebruiken veel abonnementen credits: vooraf betaalde eenheden die een abonnement verbruikt naarmate er werk wordt gedaan. Credits zijn niet hetzelfde als tokens, want één credit kan tekst, afbeeldingen of ander werk dekken. Maar taken die meer tokens gebruiken, verbruiken meestal ook meer credits, dus credits zijn de beste graadmeter voor tokenverbruik bij een abonnement. Gebruikers kunnen hun eigen creditverbruik bijhouden, en sommige abonnementen bevatten ook een beheerdersdashboard dat het creditverbruik van het hele team toont.
In Perplexity gebruiken gewone zoekopdrachten bijvoorbeeld geen credits. Alleen Perplexity Computer, de assistent die taken met meerdere stappen afhandelt, gebruikt ze. Gebruikers van Computer kunnen zien hoeveel credits ze hebben gebruikt en waaraan. Elke Computer-taak toont ook een eigen credittotaal in het menu "Gebruik" van het bijbehorende gesprek.
Bij Enterprise-abonnementen kunnen beheerders in het Insights-dashboard zien hoeveel mensen Perplexity gebruiken en hoeveel zoekopdrachten ze per week uitvoeren (beschikbaar voor organisaties met 50 of meer licenties, of ten minste één Enterprise Max-lid).
Tokenverbruik bijhouden in API-gebruiksrapporten
De gebruiksrapporten van de API-aanbieder tonen tokenaantallen rechtstreeks, meestal uitgesplitst per soort token. In de API Platform-console van Perplexity kunnen gebruikers bijvoorbeeld op de pagina Facturering statistieken bijhouden zoals het verbruik van input-, output- en redeneertokens.
Waarom tokenverbruik groeit
Agents voeren per taak veel stappen uit, en elke stap is een afzonderlijk verzoek aan een model. Eén taak kan oplopen tot honderdduizenden of zelfs miljoenen tokens.
Ook redeneermodellen worden steeds gebruikelijker. Een redeneermodel schrijft zijn denkproces uit voordat het antwoordt, en elk woord daarvan telt als tokens. Hetzelfde verzoek gebruikt bij een redeneermodel dus meestal meer tokens dan bij een standaardmodel, ook al lijkt het antwoord op het scherm even lang.
Tot slot loopt het tokengebruik op naarmate meer mensen en workflows AI in het algemeen gebruiken. Een deel van die groei komt ook door tokenmaxxing, waarbij engineers agents vooral draaien om hun persoonlijke tokenaantallen op te drijven en hoger te eindigen op interne tokenranglijsten.
Zo verminder je tokenverbruik
Hoog tokenverbruik komt meestal voort uit een paar soorten werk die meer tokens gebruiken dan het lijkt.
Lange gesprekken en agenttaken
Elke keer dat een model antwoordt, leest het meestal het hele gesprek tot dan toe opnieuw. Elk nieuw verzoek bevat de volledige eerdere gespreksgeschiedenis plus het huidige bericht van de gebruiker. Een korte vraag laat in een lange draad gebruikt dus meer tokens dan dezelfde vraag in een nieuwe draad. Agenttaken werken op dezelfde manier, omdat elke stap zijn resultaten toevoegt aan de geschiedenis die de volgende stap opnieuw leest.
Wat je eraan kunt doen
- Begin een nieuw gesprek wanneer het onderwerp verandert. Open het met een samenvatting van twee of drie regels van alles uit de oude draad wat het model nog nodig heeft.
- Splits lange agenttaken op in kleinere. Voer elk deel uit als afzonderlijke taak en geef alleen de resultaten door die het volgende deel nodig heeft.
- Controleer of de agenttools van het team contextcompactie gebruiken. Compactie vat oudere delen van een taak automatisch samen, zodat het model minder opnieuw hoeft te lezen. Als een tool dit als instelling aanbiedt, schakel het dan in.
Dezelfde documenten die steeds opnieuw worden verwerkt
Wanneer iemand hetzelfde lange bestand, zoals een beleidshandboek of een productcatalogus, aan veel afzonderlijke zoekopdrachten toevoegt, leest het model elke keer het hele bestand. Elke leesbeurt telt mee als inputtokens.
Wat je eraan kunt doen
- Leer gebruikers om het relevante gedeelte van een handboek of catalogus in het verzoek te kopiëren in plaats van het hele bestand bij te voegen.
- Maak een verkorte versie van documenten die het team vaak gebruikt. Een samenvatting van één pagina van een lang beleidsdocument kan bij routinematige zoekopdrachten het volledige document vervangen.
Herhaalpogingen en lussen
Wanneer een antwoord niet is wat iemand nodig had en die persoon de taak opnieuw uitvoert, kost elke poging tokens. Hetzelfde gebeurt wanneer een agent vastloopt en steeds dezelfde stap herhaalt.
Wat je eraan kunt doen
- Beschrijf in het eerste verzoek duidelijk de taak, het gewenste resultaat en de bronnen. Bijvoorbeeld: "Vat de belangrijkste redenen samen waarom klanten in Q3 opzegden, uitsluitend op basis van de bijgevoegde enquêteresultaten, in vijf opsommingspunten."
- Controleer de eerste paar stappen van een agenttaak. Als de agent dezelfde stap of zoekopdracht herhaalt, stop de agent dan en begin opnieuw met een specifieker verzoek.
Grote modellen voor eenvoudige taken
Krachtigere modellen kosten meestal meer per token, waardoor routinewerk zoals samenvattingen of opmaakwijzigingen het budget van een team sneller kan opmaken dan nodig is.
Wat je eraan kunt doen
- Gebruik modelroutering, waarbij elke taak wordt gekoppeld aan een model dat die taak aankan. Een korte herschrijving of samenvatting kan naar een kleiner, goedkoper model gaan, terwijl het krachtigste model wordt gereserveerd voor redeneringen of analyses in meerdere stappen. De API van Perplexity volgt deze aanpak met presets, die een kleiner model toewijzen aan een snelle zoekvraag en een groter model aan een grondige analyse.
Pieken na nieuwe workflows
Een nieuwe geautomatiseerde workflow, of een tool die voor een heel team wordt uitgerold, kan het gebruik van de ene op de andere dag doen stijgen. Een piek is op zich geen probleem, maar het is goed om te weten welk werk die heeft veroorzaakt.
Wat je eraan kunt doen
- Test nieuwe workflows eerst met een kleine groep. Controleer hun gebruik een week of twee voordat je de workflow voor het hele team uitrolt.
- Stel voor elk team een maandbudget in. Baseer het op het gebruik in een doorsnee maand, zodat een sprong opvalt.
- Schakel automatisch bijvullen uit. Als automatisch bijvullen is uitgeschakeld, stopt het werk wanneer de credits op zijn, in plaats van dat er automatisch meer credits worden gekocht.
Zo optimaliseer je tokenverbruik in Perplexity
Voor dagelijks gebruik
Computer gebruikt credits, maar draait alleen wanneer je daarvoor kiest: door het Computer-pictogram te selecteren, door te werken in een project dat standaard Computer gebruikt, of door de Work-modus van Comet te gebruiken.
Selecteer het Perplexity-pictogram om terug te schakelen naar de modus Vragen en weer gewoon te zoeken. Gebruikers kunnen hun creditverbruik bekijken door de tracker in de Perplexity-interface te openen.
Teams die werken in projecten, de gedeelde werkruimten van Perplexity, kunnen de standaardmodus van elk project instellen op Zoeken of Computer. Een project dat vooral voor snel onderzoek wordt gebruikt, kan standaard op Zoeken staan, zodat niemand per ongeluk een Computer-taak start.
Voor Enterprise-beheerders
- Zorg dat je weet wat elke licentie omvat. Enterprise Pro-gebruikers ontvangen maandelijks 500 credits en Enterprise Max-gebruikers 15.000 credits. Deze credits vervallen aan het einde van elke maandcyclus en worden niet meegenomen naar de volgende maand.
- Stel eerst een standaardgebruikslimiet in. Een gebruikslimiet bepaalt hoeveel extra credits een lid maximaal uit de gedeelde pool kan halen zodra de eigen toewijzing op is.
- Maak limieten met een naam aan voor verschillende soorten gebruikers. Beheerders kunnen limieten instellen zoals "Standaard", "Poweruser" en "Externe medewerker", en die toewijzen aan gebruikersgroepen of individuele leden. Groepen kunnen uit Perplexity komen of worden gesynchroniseerd vanuit de identiteitsprovider van het bedrijf. Als iemand tot meer dan één groep behoort, geldt de hoogste limiet.
- Gebruik persoonlijke overrides voor uitzonderingen. Wanneer één persoon een andere limiet nodig heeft dan de rest van de groep, gaat een persoonlijke override voor op elke groepslimiet of gedeelde limiet. Dat is handig voor een kort project met veel onderzoek, zonder de limiet voor een heel team te verhogen.
- Stel een plafond in voor automatisch bijvullen. Automatisch bijvullen vult de gedeelde pool automatisch aan. Het heeft een configureerbare maandelijkse aanvullimiet, zodat de uitgaven niet onbeperkt kunnen groeien.
- Bepaal hoe leden om meer credits kunnen vragen. Met de instelling Leden toestaan meer credits aan te vragen kunnen mensen die hun limiet bereiken een beheerder om meer credits vragen, in plaats van meteen te worden tegengehouden.
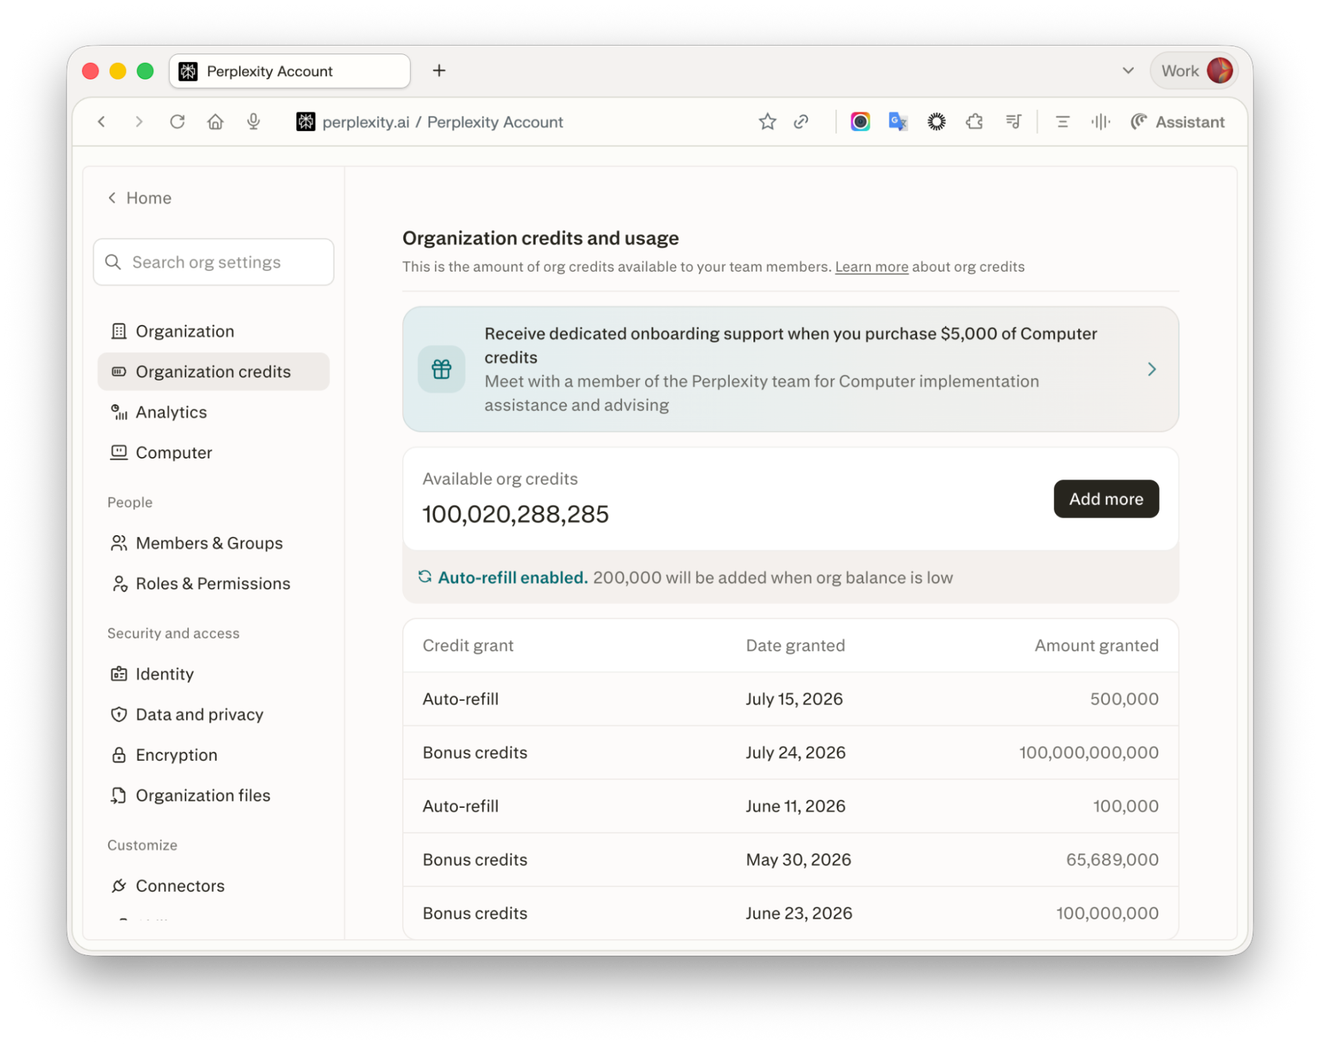
- Controleer het gebruik elke maand. De pagina Organisatiecredits toont per lid de toegekende, gebruikte en resterende credits, samen met de groepslimieten en het saldo van de pool. Voor organisaties met 50 of meer licenties, of ten minste één Enterprise Max-lid, toont het Insights-dashboard daarnaast maandelijks actieve gebruikers en wekelijkse zoekopdrachten in de loop van de tijd. Voor meer details registreren auditlogs de uitvoering van taken, het gebruik van connectors, het creditverbruik en toegekende credits.
Voor teams die op de API bouwen
- Geef elke tool of elk team een eigen API-sleutel. Perplexity kan de facturering per sleutel apart weergeven, en met afzonderlijke sleutels is duidelijk welke tool het gebruik veroorzaakt.
- Controleer op de pagina Facturering welk soort token toeneemt. Daar zie je input-, output- en redeneertokens in de loop van de tijd. Stijgende inputtokens betekenen meestal dat een tool meer tekst verstuurt dan nodig is. Stijgende redeneertokens betekenen dat taken draaien op modellen die uitgebreid over problemen nadenken.
- Gebruik de Search API wanneer een tool alleen zoekresultaten nodig heeft. Die retourneert webresultaten zonder dat een model een antwoord schrijft, en rekent per verzoek af zonder extra kosten op basis van tokens.
- Start agenttools vanuit een preset. De presets van Perplexity stemmen de omvang van het model af op de omvang van de taak en houden eenvoudige verzoeken weg bij de duurste modellen.
Local-first werken
Voor sommig werk is helemaal geen betaald cloudmodel nodig. Portable Computer is een versie van de agent van Perplexity die op iemands eigen computer draait, met een AI-model dat op dat apparaat is opgeslagen. Omdat het model lokaal draait, verbruikt routinewerk geen betaalde tokens. Het maakt alleen verbinding met het web, gekoppelde apps of een krachtiger cloudmodel wanneer een taak dat vereist, en vraagt de gebruiker dan eerst om toestemming.
Ontdek hoe Perplexity Computer werk in meerdere stappen afhandelt op het web, in bestanden en met gekoppelde tools.
Veelgestelde vragen
Wat is het verschil tussen tokenverbruik en AI-kosten?
Tokenverbruik meet hoeveel AI-werk een team doet, uitgedrukt in tokens. AI-kosten omvatten alles wat een team betaalt om AI te gebruiken, inclusief abonnementen, extra credits en implementatie. Tokenverbruik bepaalt het gebruiksgebaseerde deel van die rekening.
Betalen abonnementsgebruikers per token?
Meestal niet rechtstreeks. Abonnementstools houden het gebruik bij in berichten, zoekopdrachten of credits, en taken die meer tokens gebruiken, putten die sneller uit. In Perplexity gebruiken gewone zoekopdrachten helemaal geen credits; alleen Computer-taken doen dat.
Waarom gebruiken AI-agents zoveel tokens?
Een agent voert een taak uit in veel stappen, en elke stap is een afzonderlijk verzoek dat het werk tot dan toe opnieuw leest. Een lange taak gebruikt daardoor bij elke stap meer tokens.
Waarom piekt het tokengebruik plotseling?
De meeste pieken volgen op een verandering in de manier waarop een team werkt, zoals een nieuwe geautomatiseerde workflow, een tool die voor meer mensen wordt uitgerold of een lange agenttaak. Door de datum van de piek te vergelijken met recente lanceringen wordt de oorzaak meestal duidelijk. Nieuwe workflows eerst met een kleine groep testen helpt pieken te voorkomen.